

worker_threads ile CPU-Bound İş: Worker, MessageChannel, Transferable'lar, Worker Pool (Piscina) ve cluster'dan Farkı

Node.js'te CPU-bound iş, event loop'u dondurmamak için worker_threads'e ve tercihen Piscina gibi bir worker pool'a taşınır; büyük veri kopyalanmak yerine ArrayBuffer olarak transfer edilir, worker'dan yalnız özet döner. Gerçek çıktılarla 947 ms donan event loop'a karşı 11 ms, 11 ms'lik kopyaya karşı sıfır kopyalı transfer, transfer edilemeyen pool Buffer'ı, Atomics'siz kaybolan sayaç ve her işte yeni worker'ın 40 kat yavaşlığı.
Sürüm notu: Bu yazıdaki örnekler Node.js 26.13.1 (LTS), Piscina 5.3.2 ve TypeScript 7.0.2 ile çalıştırılmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'un (bir online kitapçı) tedarikçileri tüm kataloglarını 500.000 satırlık, 26 MB'lık CSV (noktalı virgülle ayrılmış değerler) dosyaları olarak gönderiyor. Bu dosyayı bir worker thread'e iki kez gönderiyoruz: bir kez normal, bir kez transferList ile:
import { readFile } from "node:fs/promises";
import { once } from "node:events";
import { Worker } from "node:worker_threads";

// labs/21/make-catalog.ts'in ürettiği 26 MB'lık katalog, bir worker'a iki kez gönderiliyor
const worker = new Worker(new URL("./echo-worker.ts", import.meta.url));

for (const mode of ["copy", "transfer"] as const) {
    const bytes = (await readFile("labs/21/out/catalog-500k.csv")).buffer as ArrayBuffer;
    const started = performance.now();
    worker.postMessage(bytes, mode === "transfer" ? [bytes] : []);
    const [received] = await once(worker, "message");
    console.log(`${mode.padEnd(8)}: worker got ${received} bytes in ${(performance.now() - started).toFixed(1)} ms, main thread still has ${bytes.byteLength} bytes`);
}
await worker.terminate();
İki gönderim ne kadar sürer, gönderimden sonra ana thread'de kaç byte kalır?
copy    : worker got 26720752 bytes in 11.1 ms, main thread still has 26720752 bytes
transfer: worker got 26720752 bytes in 0.0 ms, main thread still has 0 bytes
Normal postMessage 26 MB'ı kopyaladı: 11 ms ve iki kat bellek. Transfer ise kopyalamadı; ArrayBuffer'ın sahipliği worker'a geçti ve ana thread'deki değişken 0 byte'a düştü. Worker'lar aynı process'te çalışır ama aynı heap'i paylaşmaz; aralarında veri ya kopyalanır ya da sahipliği devredilir. Bu yazıda CPU'yu yoran işi 06'daki gibi event loop'tan uzaklaştırmanın yolunu ayrıntılı görüyoruz: Worker, mesajlaşma, transferable'lar, SharedArrayBuffer, Piscina ile worker pool ve cluster'dan farkı.
Neden Worker? Event Loop'u Bloklayan İş
06'da gördüğümüz kural: JavaScript kodun tek bir thread'de çalışır, senkron bir hesaplama sürerken başka hiçbir request'e cevap verilmez. 08'deki parseCatalogCsv 500.000 satırı bu makinede yaklaşık 270 ms'de ayrıştırıyor. Dört tedarikçi aynı anda yüklerse ne olur? Ana thread'de ve dört worker'lık bir pool'da ölçtük:
async function measure(label: string, work: () => Promise<unknown>): Promise<void> {
    const histogram = monitorEventLoopDelay({ resolution: 1 });
    histogram.enable();
    // Histogram bir sonraki tick'e kadarki boşluğu ölçebilmek için önce bir tick görmeli
    await delay(20);
    const started = performance.now();
    await work();
    const elapsed = performance.now() - started;
    // Döngünün bir tur daha dönmesi, histogram'ın timer'ı az önce biten duraklamayı kaydedebilsin diye
    await delay(20);
    histogram.disable();
    console.log(`${label}: 4 catalogs in ${Math.round(elapsed)} ms, longest event loop stall ${Math.round(histogram.max / 1e6)} ms`);
}

await measure("main thread", async () => {
    for (let i = 0; i < 4; i++) {
        parseCatalogCsv(file.toString("utf8"));
    }
});
await measure("worker pool", () => Promise.all(Array.from({ length: 4 }, () => pool.parse(Buffer.from(file)))));
main thread: 4 catalogs in 946 ms, longest event loop stall 947 ms
worker pool: 4 catalogs in 279 ms, longest event loop stall 11 msAna thread'de dört katalog 946 ms sürdü ve event loop'un en uzun duraklaması 947 ms oldu: bu sürede /health dahil hiçbir istek cevaplanmadı. Pool'da aynı iş 279 ms'de bitti, çünkü dört katalog paralel ayrıştırıldı; event loop en fazla 11 ms durdu. O 11 ms'in kaynağı da ana thread'de yaptığımız Buffer.from(file) kopyaları. C#'ta aynı işi Task.Run ya da Parallel.ForEach ile ThreadPool'a verirdin (C# Asenkron serisinin 12. yazısı); Node'da karşılığı worker thread.
async yazmak bu işi çözmez: async bir fonksiyonun içindeki senkron döngü yine ana thread'de çalışır (06'daki "async fonksiyon = başka thread" yanılgısı). Worker yalnız CPU-bound iş için anlamlı: ayrıştırma, sıkıştırma, resim işleme, büyük hesaplamalar. Dosya ve ağ I/O'su zaten libuv'da ve işletim sisteminde asenkron yürüyor; onu worker'a taşımak yalnız mesajlaşma maliyeti ekler.
Worker, workerData ve postMessage
new Worker(file) yeni bir thread başlatır; o thread'in kendi V8 (Node'un JavaScript engine'i) isolate'i, kendi heap'i ve kendi event loop'u vardır. Başlangıç verisi workerData ile, sonraki mesajlar postMessage ve parentPort ile gider. Mesajlar structured clone algoritmasıyla kopyalanır: object, array, Map, Date, typed array'ler geçer, fonksiyonlar ve class instance'larının prototype'ı geçmez. 05'teki type stripping worker dosyalarında da çalışıyor; worker'ı .ts dosyasından başlatıyoruz.
Kopyanın bedelinden kaçmanın yolu transfer: postMessage(value, [arrayBuffer]). Önce Tahmin Et'te gördüğümüz gibi ArrayBuffer'ın sahipliği karşı tarafa geçer. Bir tuzak var: küçük Buffer'lar Node'un paylaşılan buffer pool'undan kesilir ve altlarındaki ArrayBuffer başka Buffer'lara da ait:
// Küçük bir Buffer, Node'un paylaşılan buffer pool'undan kesilir; ArrayBuffer'ı başka Buffer'lara da aittir
const isbn = Buffer.from("9780441172719");
console.log(`byteOffset ${isbn.byteOffset}, buffer ${isbn.buffer.byteLength} bytes for ${isbn.length} bytes of data`);
const { port1, port2 } = new MessageChannel();
try {
    port1.postMessage(isbn, [isbn.buffer as ArrayBuffer]);
} catch (err) {
    console.log(`${(err as Error).name}: ${(err as Error).message}`);
byteOffset 552, buffer 65600 bytes for 13 bytes of data
DataCloneError: Cannot transfer object of unsupported type.13 byte'lık ISBN (kitapların uluslararası standart numarası), 65.600 byte'lık bir ArrayBuffer'ın 552. byte'ından başlıyor ve Node bu ArrayBuffer'ın transfer edilmesine izin vermiyor. Transfer edilseydi aynı pool'u kullanan bütün Buffer'lar bozulurdu. Bookstore'un pool'u bu yüzden yalnız belleğinin tamamına sahip olan Buffer'ı transfer ediyor, diğerlerini önce kopyalıyor.
SharedArrayBuffer ve Atomics
Transfer veriyi taşır, paylaşmaz. Gerçekten aynı belleği paylaşmak için SharedArrayBuffer var: iki thread aynı byte'ları görür. Ama paylaşılan bellek, C#'tan bildiğin yarışları da getirir. Dört worker tek bir sayaca bir milyonar kez ekliyor:
import { workerData } from "node:worker_threads";

const { shared, mode } = workerData as { shared: Int32Array; mode: string };
for (let i = 0; i < 1_000_000; i++) {
    if (mode === "atomics") {
        // Okuma, ekleme ve yazma bölünmez tek bir adımda
        Atomics.add(shared, 0, 1);
    } else {
        // Oku, ekle, yaz: arada başka bir thread yazabilir
        shared[0]++;
    }
}
plain : 1,109,490 (expected 4,000,000)
atomics: 4,000,000 (expected 4,000,000)Düz ++ ile dört milyon yerine 1,1 milyon çıktı: okuma, ekleme ve yazma ayrı adımlar ve thread'ler birbirinin yazdığını eziyor. Atomics.add bu üç adımı bölünmez tek bir işlem yapıyor; C#'taki Interlocked.Increment. Node'da SharedArrayBuffer'a nadiren ihtiyaç duyarsın; ilerleme sayacı ya da büyük, salt okunur bir tabloyu paylaşmak gibi durumlar dışında mesajlaşma daha basit ve daha güvenli.
Bookstore: Worker Pool ile Katalog Doğrulama
Her request için yeni bir Worker başlatmak ilk akla gelen çözüm, ama pahalı:
new Worker per task: 756 ms for 50 tasks
one warm pool thread: 18 ms for 50 tasks
Her worker'ın başlaması (isolate, module'lerin yüklenmesi, type stripping) yaklaşık 15 ms sürdü; hazırda bekleyen tek bir thread aynı 50 işi 18 ms'de bitirdi. Çözüm bir worker pool: thread'ler bir kez başlar ve işleri sırayla alır. Node'da yerleşik bir pool yok; en yaygın paket Piscina (Node.js ekibinden geliştiricilerin yazdığı bir library). Bookstore'un pool'u:
// Process başına tek pool, başlangıçta oluşturulur: thread'ler her request için başlamak yerine hazır bekler
export function createCatalogParsePool(options: { maxThreads?: number } = {}): CatalogParsePool {
    const pool = new Piscina<CatalogParseTask, CatalogParseResult>({
        filename: new URL("../workers/catalogParseWorker.ts", import.meta.url).href,
        minThreads: 1,
        // Ana thread'in event loop'una bir çekirdek bırak
        maxThreads: options.maxThreads ?? Math.max(1, availableParallelism() - 1),
        idleTimeout: 60_000,
        // Dolu kuyruk, yüklemeleri bellekte biriktirmek yerine yeni işi reddeder
        maxQueue: 16,
    });
    return {
        parse: (csv, signal) => {
            // Kopyalama, transfer et: ArrayBuffer worker'a geçer. Küçük bir Buffer, transfer edilemeyen
            // Node'un iç pool'unu paylaşıyor olabilir; bu yüzden yalnız belleğinin tamamına sahip Buffer olduğu gibi taşınır
            const owned = csv.byteOffset === 0 && csv.byteLength === csv.buffer.byteLength;
            const bytes = (owned ? csv.buffer : csv.buffer.slice(csv.byteOffset, csv.byteOffset + csv.byteLength)) as ArrayBuffer;
            // "as never": piscina 5.3'ün TransferList tipi, @types/node 26'daki postMessage'ın yanlış overload'ını çıkarıyor
            return pool.run({ csv: bytes }, { transferList: [bytes] as never, signal });
        },
        close: () => pool.close(),
    };
}
Ayarların her birinin bir nedeni var. maxThreads çekirdek sayısından bir eksik; ana thread'in event loop'una bir çekirdek kalsın. Bir şey daha: Piscina'nın README'sine göre idleTimeout varsayılan olarak sıfır, yani boşta kalan worker hemen kapanıyor; 60 saniye vererek sık gelen işlerde thread'leri sıcak tutuyoruz. maxQueue dolu bir kuyruğa yeni iş eklemek yerine hata veriyor; 64 MB'lık yüklemelerin bellekte birikmesinden iyidir. TypeScript tarafında bir pürüz çıktı: Piscina 5.3'ün transferList tipi, @types/node 26'daki postMessage'ın yanlış overload'ını çıkarıyor ve dizi kabul etmiyor; runtime'da sorun olmadığı için as never ile geçtik.
Worker tarafı tek bir fonksiyon:
// Hatalar ana thread'e dönerken class'larını ve property'lerini kaybeder, bu yüzden sonuç düz veri
export type CatalogParseResult =
    | { ok: true; imported: number; skipped: number; errors: string[]; parseMs: number }
    | { ok: false; reason: string };

export default function parseCatalog({ csv }: CatalogParseTask): CatalogParseResult {
    const started = performance.now();
    let result;
    try {
        result = parseCatalogCsv(new TextDecoder().decode(csv));
    } catch (err) {
        return { ok: false, reason: (err as Error).message };
    }
    // Yalnız bir özet döner: yarım milyon Book object'i ana thread'e kopyalanırdı
    return {
        ok: true,
        imported: result.books.length,
        skipped: result.errors.length,
        errors: result.errors.slice(0, 20),
        parseMs: Math.round(performance.now() - started),
    };
}
İki karar dikkat çekiyor. Birincisi, worker 499.500 Book object'ini değil, yalnız bir özet dönüyor; dönüş değeri de structured clone ile kopyalanır ve yarım milyon object'i kopyalamak, ayrıştırmanın kendisi kadar sürebilir. İkincisi, hatalı bir başlık exception değil veri olarak dönüyor. Bunu denedik: worker'da name ve code property'si olan özel bir hata class'ı fırlattığımızda ana thread'e yalnız message'ı taşıyan düz bir Error ulaştı; class'ı, name'i ve code'u kayboldu. Thread sınırında hata türüne göre karar vereceksen sonucu veri olarak dön.
Route, StoreStaff rolüyle POST /api/catalog/validate; body text/csv olarak 64 MB'a kadar kabul ediliyor ve request'in sinyali (07) pool'a veriliyor. Piscina'nın dokümanına göre çalışmakta olan bir iş iptal edilirse onu çalıştıran worker durduruluyor; client bağlantıyı kapatınca CPU boşuna yanmıyor. Testler gerçek thread'lerle çalışıyor:
✔ validates a catalog upload for store staff (9.892375ms)
✔ answers 400 for a wrong header and 403 for customers (2.436833ms)
▶ catalog parse pool (real worker threads)
  ✔ parses on a worker and moves the bytes there (18.101292ms)
  ✔ returns a format error as data (0.511083ms)
  ✔ stops a running task when the caller aborts (24.74975ms)
✔ catalog parse pool (real worker threads) (46.780292ms)
ℹ tests 5
ℹ pass 5
ℹ fail 0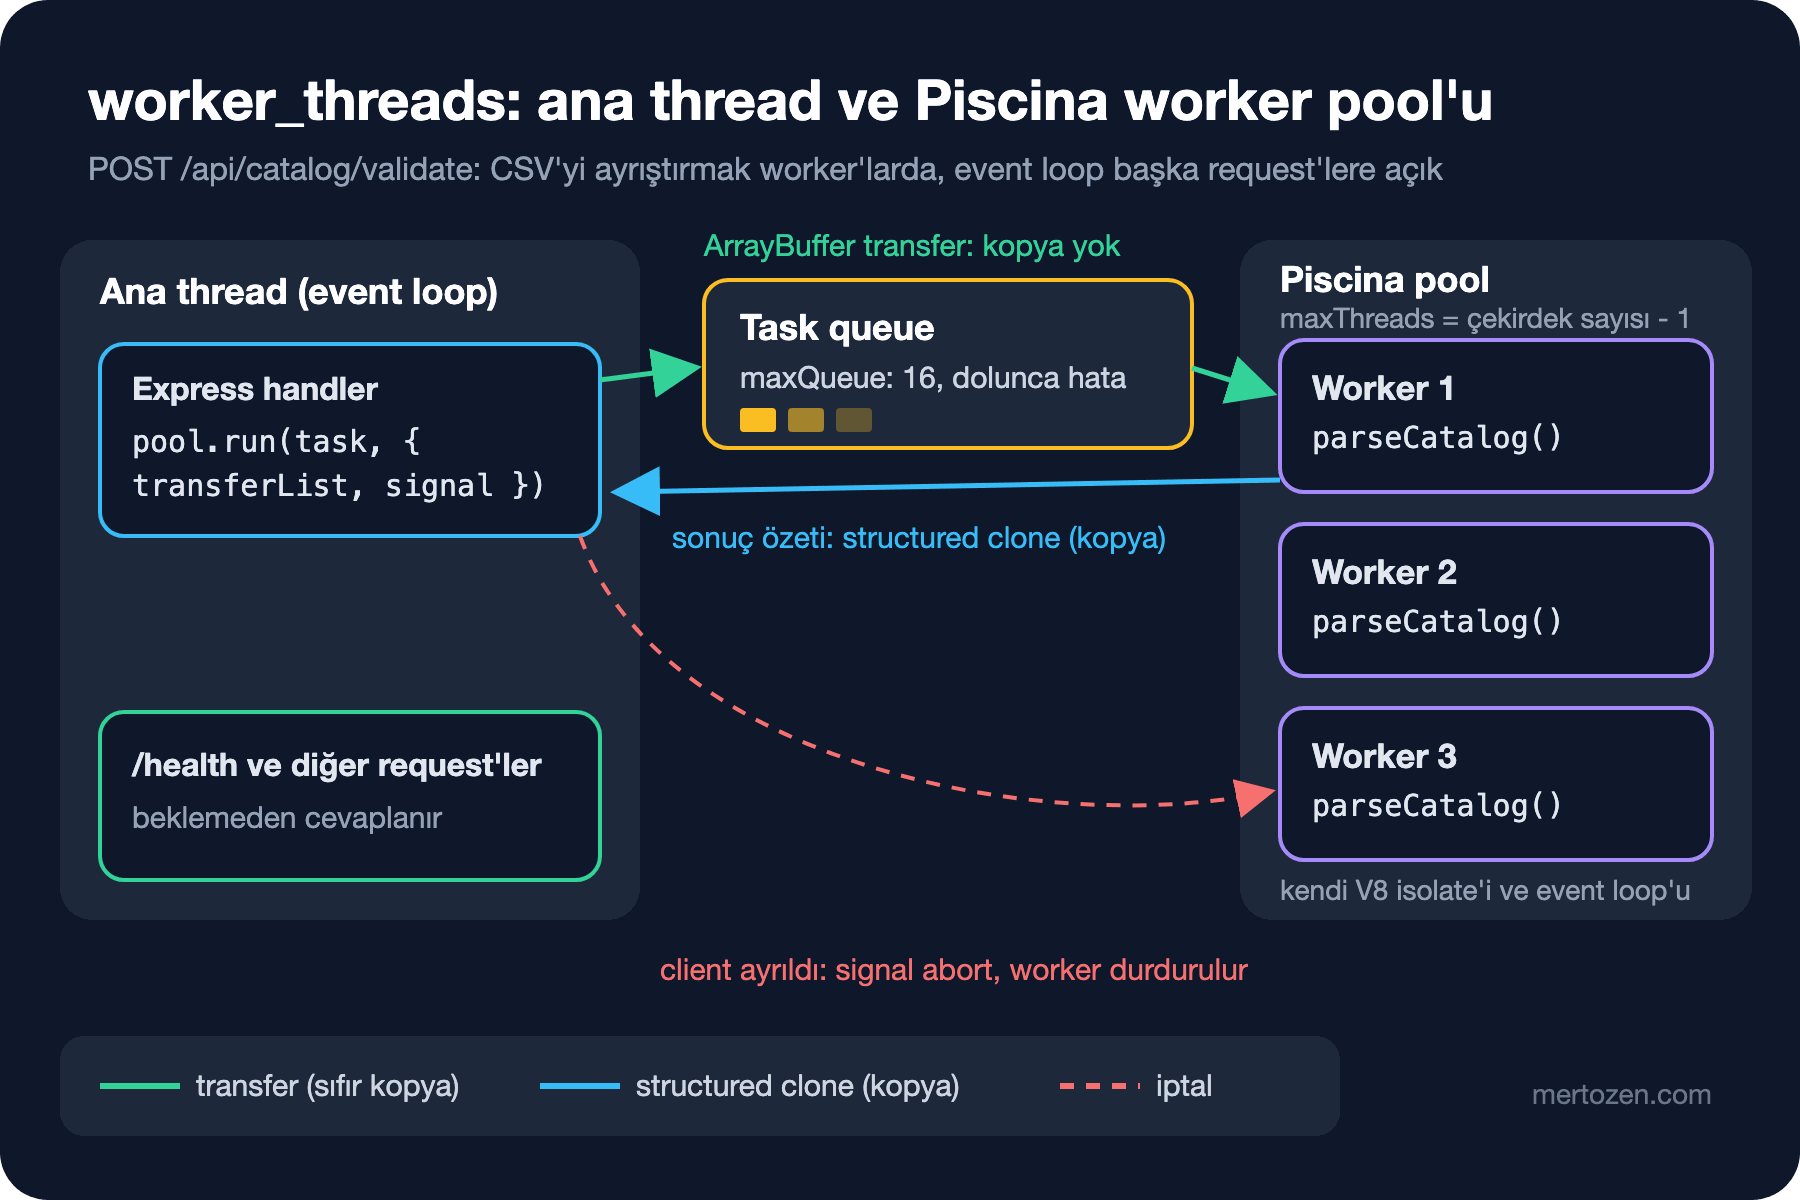
Shutdown sırasına da pool'u ekledik: 18'deki closeAfterServer listesinde catalogPool.close() var; sunucu yeni request almayı bıraktıktan sonra pool çalışan işleri bitirip thread'leri kapatıyor.
worker_threads mı, cluster mı?
14'te cluster module'ünü ve container başına tek process modelini gördük. İkisi farklı sorunları çözüyor:
| Konu | cluster / birden çok process | worker_threads |
|---|---|---|
| Ne paralelleşir | Request'ler: her process ayrı bir API kopyası | Tek bir request içindeki CPU işi |
| Bellek | Process başına ayrı; paylaşım yok | Aynı process; heap ayrı, SharedArrayBuffer ile paylaşım mümkün |
| Yakalanmamış hata | Yalnız o process çöker | Worker durur, hata ana thread'e error event'i olarak gelir |
| Container'da | Genelde orchestrator replikası tercih edilir | Bir container içinde de anlamlı |
| .NET karşılığı | Birden çok instance, load balancer arkasında | Task.Run, Parallel.ForEach |
Bookstore için karar: ölçeği replikalarla, request içindeki ağır işi worker pool'la çözmek. Birini diğerinin yerine kullanmak işe yaramaz; on replika da olsa her biri 500.000 satırı kendi event loop'unda ayrıştırırken donar.
Üretimde Dikkat
Thread sayısını container'ın CPU sınırına göre ayarla; maxThreads'i config'den okumak, ortamın gerçek CPU kotasını açıkça yazmanın en kısa yolu. Worker'lar 20'deki scrypt ile aynı libuv thread pool'unu değil kendi thread'lerini kullanır; ikisinin toplamı çekirdek sayısını aşmasın.
Bellek: her worker'ın kendi heap'i var. Transfer edilen 26 MB worker'da ayrıştırılırken string'e ve object'lere dönüşür; dört paralel iş, dört kat tepe bellek demek. maxQueue ve body limiti bu yüzden birlikte düşünülmeli. Pool'un queueSize ve utilization değerlerini 14'teki gibi metric olarak yayınla.
Sık Düşülen Tuzaklar
Her request'te yeni worker başlatmak. Başlangıç maliyeti, işin kendisinden pahalı olabilir; pool kullan.
Büyük object'leri kopyalayarak göndermek ya da geri almak. ArrayBuffer'ı transfer et, geriye yalnız bir özet dön.
I/O işini worker'a taşımak. Dosya okumak ve HTTP çağırmak zaten asenkron; kazanç yok, mesajlaşma maliyeti var.
Worker'dan özel hata class'ı beklemek. Piscina ile denediğimizde thread sınırında yalnız message kaldı; sonucu veri olarak dön.
Paylaşılan Buffer'ı transfer etmek. Küçük Buffer'lar Node'un pool'undan gelir; DataCloneError alırsın.
Küçük Bir Deneme
★☆☆ labs/21/blocking.ts'i maxThreads: 1 ve maxThreads: 8 ile çalıştır. Toplam süre ve event loop duraklaması nasıl değişiyor?
★★☆ Pool'a ilerleme bilgisi ekle: bir MessageChannel oluştur, port2'yi task'ın içinde transfer et, worker her 100.000 satırda port.postMessage(rowCount) göndersin; ana thread bunu log'a yazsın.
★★★ Worker'ın geçerli kitapları da dönmesini istiyorsun ama yarım milyon object'i kopyalamadan. Kitapları sabit uzunluklu kayıtlar olarak bir ArrayBuffer'a yaz, Piscina.move() ile transfer ederek dön ve ana thread'de oku. Süreyi structured clone'lu sürümle karşılaştır.
Serinin son yazısında veri erişimine dönüyoruz: node:sqlite, pg, Kysely ve Prisma ile aynı sorguyu dört şekilde yazıp hangisinin ne zaman uygun olduğuna bakacağız.