

System.IO.Pipelines: PipeReader, PipeWriter ve ReadOnlySequence ile Kopyasız Parse
System.IO.Pipelines, satırların iki buffer'a bölünmesi, buffer büyütme ve kopyalama gibi işleri üstlenip veriyi string'e çevirmeden parse etmeni sağlar; doğru kullanımın anahtarı AdvanceTo(consumed, examined) kuralıdır. Bookstore'un NDJSON sipariş akışını PipeReader ile parse edip Channel'a aktarıyor, backpressure'ı ve StreamReader ile farkı BenchmarkDotNet ile gerçek sayılarla gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve BenchmarkDotNet 0.15.8 ile derlenip denenmiştir.
Önce Tahmin Et
Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) sipariş servisi, depo sisteminden NDJSON (Newline Delimited JSON; her satırında ayrı bir JSON değeri bulunan metin formatı) formatında bir sipariş akışı alıyor. Bir geliştirici akışı şöyle parse etmiş:
byte[] buffer = new byte[4096];
int n;
while ((n = await stream.ReadAsync(buffer)) > 0)
{
    foreach (string piece in Encoding.UTF8.GetString(buffer, 0, n).Split('\n', StringSplitOptions.RemoveEmptyEntries))
    {
        var order = JsonSerializer.Deserialize<Order>(piece);
    }
}Read'in dönüş değerine bakılıyor, buffer pool'lanmasa da yeniden kullanılıyor, ilk yazıda konuştuğumuz hatalar yok. 20.000 siparişlik bir akışta bu kod kaç siparişi doğru okur? Testte neden fark edilmemiş olabilir?
İkinci soru: aynı işi StreamReader.ReadLineAsync ile yapan kodu System.IO.Pipelines'a çevirirsen JSON parse dahil toplam süre ne kadar kısalır? Yarıya mı iner, onda birine mi, yoksa neredeyse hiç mi değişmez?
Bu yazıda System.IO.Pipelines'ı bu iki sorunun etrafında ele alıyoruz. Kodlar serinin repo'sunda Bookstore.IO.Pipelines console uygulaması ve Bookstore.IO.Benchmarks projesinde:
dotnet run --project src/Bookstore.IO.Pipelines -- naive
dotnet run -c Release --project benchmarks/Bookstore.IO.Benchmarks -- --filter "*NdjsonBenchmarks*"
Stream ile Protokol Parse Etmenin Klasik Hataları
Yukarıdaki kodu çalıştıralım:
Naive: 18,344 parsed, 3,312 JsonException, expected 20,0001.656 sipariş kayboldu. Sebebi, bir satırın iki ReadAsync çağrısına bölünmesi. 4 KB'lık buffer'ın sonu nadiren bir satır sonuna denk gelir; satırın ilk yarısı bir buffer'da, ikinci yarısı sonrakinde kalır ve iki parça da tek başına geçersiz JSON'dur. Testte genelde birkaç küçük sipariş gönderilir, hepsi ilk buffer'a sığar ve hata görünmez.
Düzeltmenin klasik yolu, bir sonraki okumaya kadar yarım kalan byte'ları saklamak, satır buffer'dan büyükse buffer'ı büyütmek, büyüttükçe kopyalamak, kopyaları azaltmak için pool kullanmak ve tüketilen kısmı buffer'ın başına kaydırmaktır. Her protokol parser'ında aynı muhasebe kodu tekrar yazılır ve hataların çoğu bu koddan çıkar. StreamReader.ReadLine bu işi bizim yerimize yapar, ama bedeli her satırı bir string'e çevirmektir: UTF (Unicode Transformation Format; Unicode karakterlerini byte'a çeviren kodlama ailesi) ailesinden UTF-8 ile gelen byte'lar, .NET string'lerinin kullandığı UTF-16 karakterlere dönüştürülür, kopyalanır ve satır başına bir allocation yapılır.
System.IO.Pipelines, ASP.NET Core ekibinin Kestrel'i yazarken çıkardığı bu buffer yönetimini tek bir yerde toplar. Modern .NET'te shared framework'ün parçası; ayrıca bir NuGet paketi eklemene gerek yok.
Pipe, PipeReader ve PipeWriter
Bir Pipe iki uçtan oluşur: veriyi yazan PipeWriter ve okuyan PipeReader. Yazan taraf belleği kendisi ayırmaz, pipe'tan ister:
Memory<byte> memory = pipe.Writer.GetMemory(size); // en az size byte
data.AsSpan(offset, size).CopyTo(memory.Span);
pipe.Writer.Advance(size);                          // bu kadarını yazdım
FlushResult flush = await pipe.Writer.FlushAsync(); // okuyana görünür yap
GetMemory istediğinden büyük bir buffer verebilir ve iki çağrı aynı buffer'ı döndürmek zorunda değil. Advance'ten sonra eski buffer'a yazmak yasak; yeni bir GetMemory gerekir. FlushAsync ise yazılan veriyi okuyucuya açar.
Elinde zaten bir Stream varsa (dosya, network, HTTP body) bir pipe kurmana gerek yok; PipeReader.Create(stream) stream'i okuyup kendi pool'lu buffer'larına dolduran bir reader verir. Varsayılan ayarlar şöyle:
var reader = PipeReader.Create(new MemoryStream(data), new StreamPipeReaderOptions(bufferSize: 4096));
long count = await NdjsonOrders.ReadWithPipeReaderAsync(reader, _ => ValueTask.CompletedTask);

var defaults = PipeOptions.Default;
Console.WriteLine($"PipeOptions.Default: pause {defaults.PauseWriterThreshold:N0}, resume {defaults.ResumeWriterThreshold:N0}, " +
                  $"minimum segment {defaults.MinimumSegmentSize:N0}");
PipeReader: 20,000 orders parsed
PipeOptions.Default: pause 65,536, resume 32,768, minimum segment 4,096Aynı 20.000 sipariş, aynı 4 KB'lık buffer'larla eksiksiz okundu. Nasıl olduğuna bakalım.
ReadAsync, SequenceReader ve AdvanceTo Kuralı
PipeReader.ReadAsync bir ReadResult döner. İçindeki Buffer bir ReadOnlySequence<byte>: tek parça bir array değil, pool'dan gelen birden fazla segmentin bağlı listesi. Önceki okumada işlenmeden kalan byte'lar ile yeni gelenler bu sequence'ta yan yana durur; kopyalama yok. NDJSON reader'ımızın tamamı:
public static async Task<long> ReadWithPipeReaderAsync(PipeReader reader, Func<Order, ValueTask> onOrder,
    CancellationToken ct = default)
{
    long count = 0;
    try
    {
        while (true)
        {
            ReadResult result = await reader.ReadAsync(ct);
            ReadOnlySequence<byte> buffer = result.Buffer;

            try
            {
                while (TryReadLine(ref buffer, out ReadOnlySequence<byte> line))
                {
                    if (line.IsEmpty) continue;
                    await onOrder(ParseOrder(line));
                    count++;
                }

                if (buffer.Length > MaxLineLength)
                {
                    throw new InvalidDataException($"Line longer than {MaxLineLength} bytes.");
                }

                if (result.IsCompleted)
                {
                    if (!buffer.IsEmpty)
                    {
                        // Son satırın sonunda '\n' yok.
                        await onOrder(ParseOrder(buffer));
                        count++;
                        buffer = buffer.Slice(buffer.End);
                    }
                    break;
                }
            }
            finally
            {
                // consumed: parse edilmemiş ilk byte'tan öncesi; examined: baktığımız her şey.
                reader.AdvanceTo(buffer.Start, buffer.End);
            }
        }
    }
    finally
    {
        await reader.CompleteAsync();
    }
    return count;
}

private static bool TryReadLine(ref ReadOnlySequence<byte> buffer, out ReadOnlySequence<byte> line)
{
    var sequenceReader = new SequenceReader<byte>(buffer);
    if (sequenceReader.TryReadTo(out line, (byte)'\n'))
    {
        buffer = buffer.Slice(sequenceReader.Position);
        return true;
    }
    line = default;
    return false;
}

private static Order ParseOrder(ReadOnlySequence<byte> line)
{
    if (line.IsSingleSegment)
    {
        return JsonSerializer.Deserialize<Order>(line.FirstSpan)!;
    }
    // Satır iki buffer segmentine yayılmış: Utf8JsonReader kopyalamadan okur.
    var jsonReader = new Utf8JsonReader(line);
    return JsonSerializer.Deserialize<Order>(ref jsonReader)!;
}SequenceReader<byte>, sequence'ın segment sınırlarını senin yerine yönetir: TryReadTo \n'yi hangi segmentte bulursa bulsun, satırı yine bir ReadOnlySequence<byte> olarak verir. Satır tek segmentteyse JSON'u doğrudan span'den parse ediyoruz; iki segmente yayılmışsa Utf8JsonReader'ın sequence alan constructor'ı devreye giriyor. İki durumda da satır string'e çevrilmiyor. SequenceReader ve Utf8JsonReader ref struct oldukları için await içeren bir method'da yaşayamaz; bu yüzden ikisini de ayrı senkron yardımcı method'lara koyduk. Ref struct kuralları C# İleri Seviye serisinin Span yazısında.
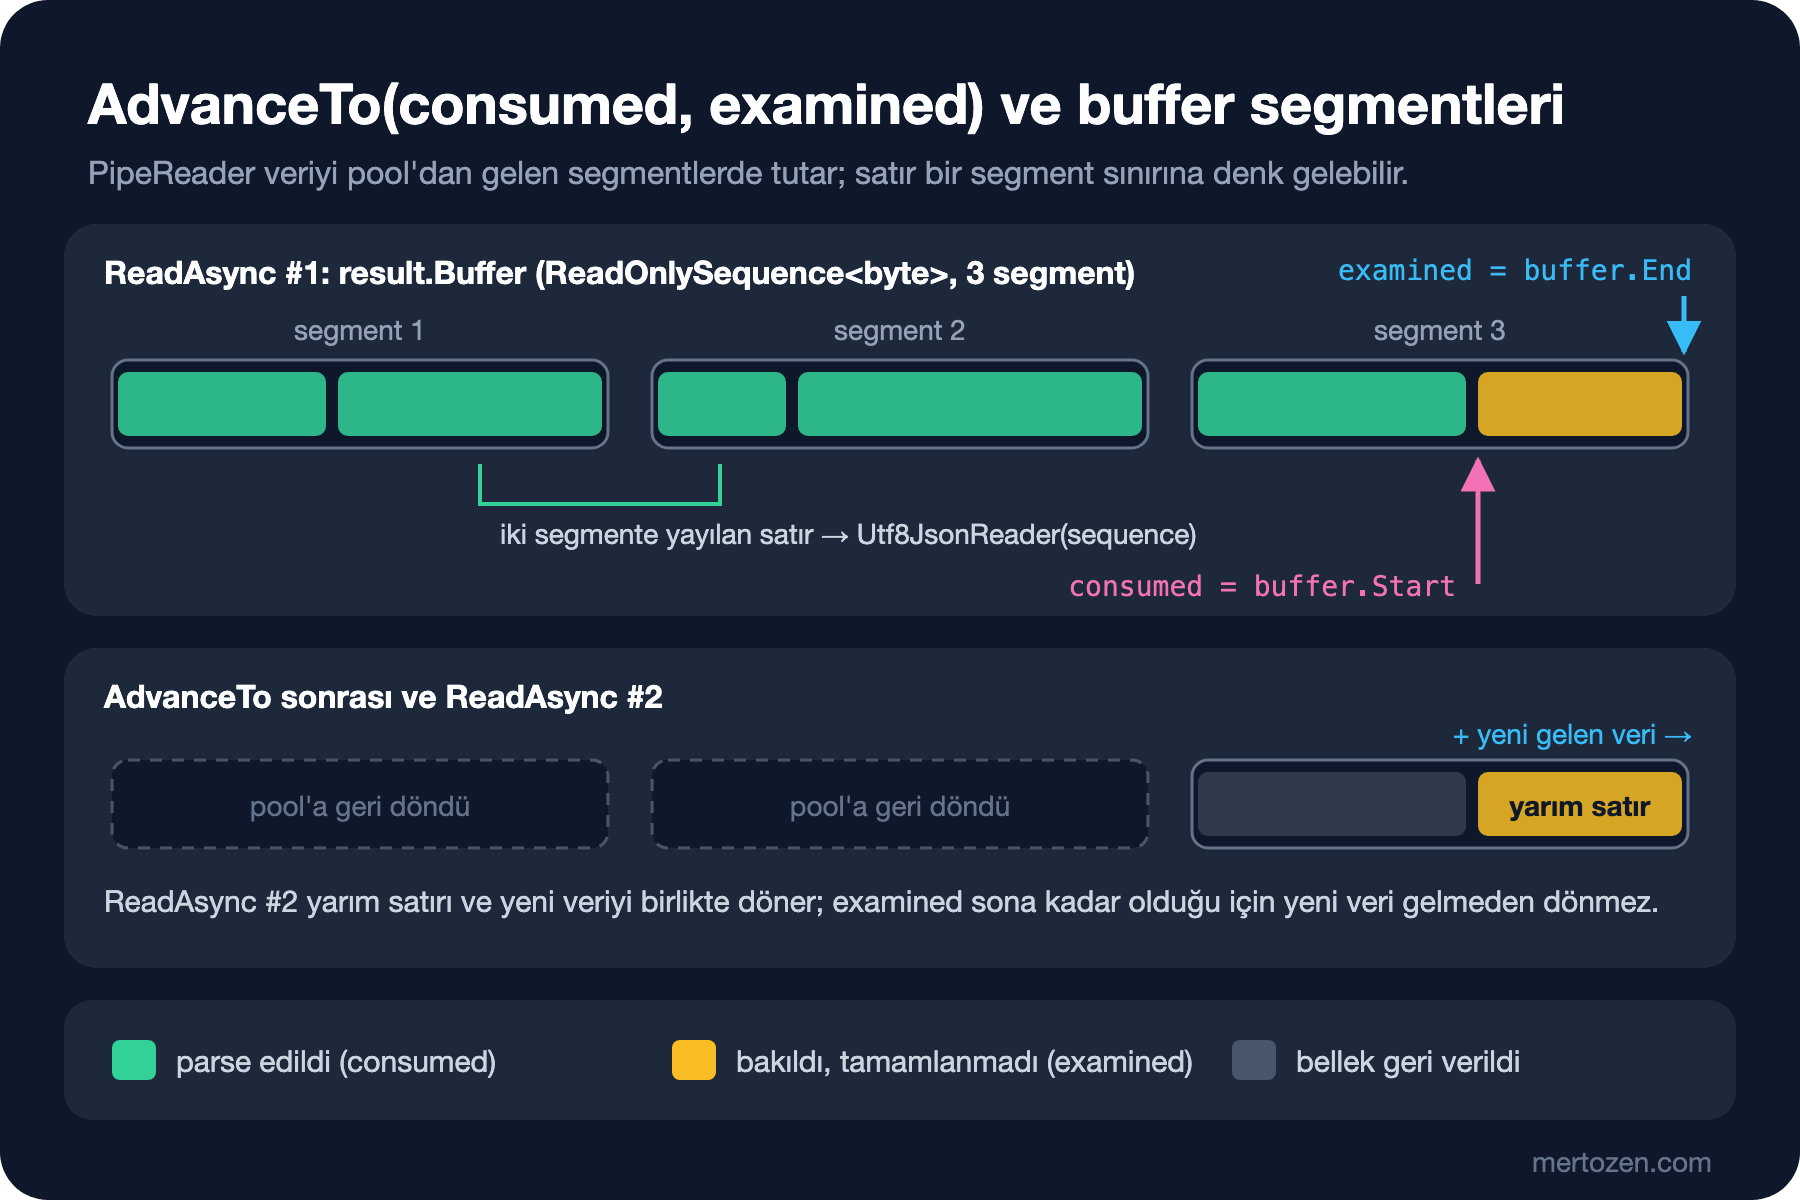
Yazının en önemli satırı reader.AdvanceTo(buffer.Start, buffer.End). İlk argüman consumed: bu noktadan önceki byte'larla işin bitti, pipe o belleği pool'a geri verebilir. İkinci argüman examined: buraya kadarına baktın ve işine yarayacak bir şey bulamadın. TryReadLine her başarılı satırdan sonra buffer'ı satırın sonrasına kaydırdığı için döngü bittiğinde buffer.Start yarım kalan satırın başını, buffer.End verinin sonunu gösterir. Sonraki ReadAsync yarım satırı ve yeni gelen veriyi birlikte döner. Examined'ı sona kadar verdiğimiz için de yeni veri gelmeden dönmez; aynı yarım satıra tekrar tekrar bakan bir busy loop oluşmaz.
Bu iki argümanı yanlış vermek Pipelines'ta en sık yapılan hata ve sonuçları sert. Examined'ı consumed ile aynı verirsen ve yeni bir satır bulamamışsan, ReadAsync aynı veriyle hemen geri döner ve CPU'yu yakan bir döngüye girersin. Consumed'u hiç ilerletmezsen pipe veriyi tutmaya devam eder ve bellek büyür. AdvanceTo'dan sonra eski ReadOnlySequence'ı kullanmak ise pool'a dönmüş belleği okumak demektir. MaxLineLength kontrolü de bilerek orada: satır sonu hiç gelmeyen bir akış (bozuk ya da kötü niyetli bir istemci), bu kontrol olmasa pipe'ı OutOfMemoryException'a kadar büyütür.
Son ayrıntı result.IsCompleted. Yazan taraf işini bitirdiğinde bu true olur, ama buffer'da hâlâ işlenmemiş veri olabilir. IsCompleted'ı görür görmez döngüden çıkmak son satırı kaybettirir; önce buffer'ı işle, sonra çık.
Backpressure: PauseWriterThreshold ve ResumeWriterThreshold
Yazan taraf okuyandan hızlıysa veri pipe'ta birikir. Pipe bunu iki eşikle sınırlar: okunmamış veri PauseWriterThreshold'u aştığında FlushAsync tamamlanmamış bir ValueTask döner ve yazıcı bekler; okuyucu tüketip veri ResumeWriterThreshold'un altına inince yazıcı devam eder. İki ayrı eşik, yazıcının her birkaç byte'ta bir durup kalkmasını önler. Hızlı bir üretici ile her 500 siparişte 1 ms bekleyen yavaş bir tüketiciyi aynı pipe'a bağladık:
var pipe = new Pipe(new PipeOptions(pauseWriterThreshold: 64 * 1024, resumeWriterThreshold: 32 * 1024));

// Hızlı üretici: her seferinde 8 KB, pipe izin verdiği kadar hızlı.
for (int offset = 0; offset < data.Length; offset += 8192)
{
    int size = Math.Min(8192, data.Length - offset);
    data.AsSpan(offset, size).CopyTo(pipe.Writer.GetSpan(size));
    pipe.Writer.Advance(size);
    Interlocked.Add(ref written, size);

    ValueTask<FlushResult> flush = pipe.Writer.FlushAsync();
    if (!flush.IsCompleted) pauses++;
    maxBuffered = Math.Max(maxBuffered, Interlocked.Read(ref written) - Interlocked.Read(ref consumed));
    await flush;
}
await pipe.Writer.CompleteAsync();
20,000 orders, 6,808,653 bytes
Writer paused 104 times, max buffered 65,963 bytes6,8 MB'lık veri aktı ama pipe'ta aynı anda en fazla 66 KB'a yakın veri durdu; yazıcı 104 kez bekletildi. Bellek kullanımını üreticinin hızı değil, eşikler belirledi. Tüketilen byte'ları saymak için okuyucuyu AdvanceTo'yu izleyen küçük bir PipeReader decorator'ıyla sardık; kodu repo'da.
Aynı model ASP.NET Core'un içinde. Kestrel, HTTP request body'sini HttpRequest.BodyReader olarak bir PipeReader, response'u HttpResponse.BodyWriter olarak bir PipeWriter şeklinde de sunar. Yukarıdaki ReadWithPipeReaderAsync'i hiç değiştirmeden bir minimal API endpoint'inde context.Request.BodyReader ile çağırabilirsin; istemci hızlı yazarken senin işlemen yavaşsa backpressure TCP bağlantısına kadar yansır. Dosya upload ve download'ın ayrıntıları ASP.NET Core Web API serisinin Dosya Yükleme ve İndirme yazısında.
Pipe'tan Channel'a: Siparişleri İşçilere Dağıtmak
Parse tek bir okuyucu tarafından yapılmak zorunda; PipeReader thread-safe değil. Siparişlerle yapılacak iş (stok düşmek, ciro toplamak, veritabanına yazmak) ise paralel yürüyebilir. İkisini bounded bir Channel<Order> ile bağladık: parse eden taraf WriteAsync ile yazıyor, üç tüketici ReadAllAsync ile okuyor.
var channel = Channel.CreateBounded<Order>(new BoundedChannelOptions(1_000)
{
    SingleWriter = true,
    FullMode = BoundedChannelFullMode.Wait
});

await using var file = new FileStream(path, FileMode.Open, FileAccess.Read, FileShare.Read, 0, FileOptions.Asynchronous);
long count = await NdjsonOrders.ReadWithPipeReaderAsync(PipeReader.Create(file),
    order => channel.Writer.WriteAsync(order));
channel.Writer.Complete();
await Task.WhenAll(consumers);
100,000 orders in 554 ms
Pending 17,803,934.30 TRY
Paid 17,872,047.00 TRY
Shipped 17,790,512.50 TRY
Delivered 17,814,535.30 TRY
Cancelled 17,744,557.60 TRYBurada iki ayrı backpressure zinciri art arda çalışıyor. Tüketiciler yavaşlarsa channel 1.000 siparişte dolar, WriteAsync bekler. Parser beklediği sürece AdvanceTo çağrılmaz, pipe dolar ve PipeReader.Create'in arkasındaki dosya okuması da durur. Bellek kullanımı uçtan uca sınırlı kalır. FileStream'i bufferSize: 0 ile açmamızın sebebi de bu: PipeReader zaten kendi buffer'larını yönetiyor, araya bir 4 KB'lık kopya daha girmesine gerek yok. Channel'ların bounded/unbounded farkı ve FullMode seçenekleri C# Asenkron serisinin Channels yazısında.
Ölçüm: StreamReader ve PipeReader
İkinci sorunun cevabı için BenchmarkDotNet ile 10.000 siparişlik bir NDJSON'u bellekten okuduk. Dört senaryo var: iki yöntemle tam parse (JSON'dan Order'a) ve iki yöntemle yalnız satırlara bölme.
[MemoryDiagnoser]
public class NdjsonBenchmarks
{
    [Benchmark(Baseline = true)]
    public Task<long> StreamReader() =>
        NdjsonOrders.ReadWithStreamReaderAsync(new MemoryStream(_data), Sum);

    [Benchmark]
    public Task<long> PipeReader() =>
        NdjsonOrders.ReadWithPipeReaderAsync(System.IO.Pipelines.PipeReader.Create(new MemoryStream(_data)), Sum);

    // StreamReaderLinesOnly ve PipeReaderLinesOnly: JSON yok, yalnız satır sayma.
}
| Method | Orders | Mean | Error | StdDev | Ratio | Gen0 | Gen1 | Allocated | Alloc Ratio |
|---------------------- |------- |-----------:|---------:|---------:|------:|----------:|--------:|-----------:|------------:|
| StreamReader | 10000 | 9,117.7 us | 29.64 us | 26.28 us | 1.00 | 2609.3750 | 15.6250 | 21875416 B | 1.000 |
| PipeReader | 10000 | 8,630.2 us | 48.50 us | 37.87 us | 0.95 | 1687.5000 | - | 14138080 B | 0.646 |
| StreamReaderLinesOnly | 10000 | 841.0 us | 7.57 us | 6.71 us | 0.09 | 926.7578 | 14.6484 | 7759448 B | 0.355 |
| PipeReaderLinesOnly | 10000 | 280.6 us | 2.50 us | 2.22 us | 0.03 | - | - | 560 B | 0.000 |Tablo dürüst bir cevap veriyor. Yalnız satırlara bölmede fark çok büyük: StreamReader 7,7 MB allocation yapıp 841 µs harcarken PipeReader 560 byte ile 281 µs'de bitiriyor. Ama işin içine JSON'dan nesne üretmek girince toplam süre yalnız yüzde 5 kısalıyor. Çünkü asıl maliyet artık satırı bulmak değil, her satırdan bir Order, bir List<OrderItem> ve string property'ler üretmek. Allocation'daki yüzde 35'lik düşüş, aradan çıkan satır string'leri; kalan 14 MB nesnelerin kendisi.
Bu yüzden Pipelines'a geçmeden önce darboğazın nerede olduğunu ölç. Parse ettiğin veriyi nesneye çevirmeden işleyebiliyorsan (bir alanı okuyup toplamak, filtrelemek, başka bir yere byte olarak aktarmak) kazanç büyüktür. Her satırdan zaten bir nesne grafiği üretiyorsan kazanç sınırlıdır. Mutlak sayılar bir geliştirici makinesinden; senin donanımında farklı çıkar, oranlar ise benzer kalır. BenchmarkDotNet'in kurulumu ve sonuçların okunması C# İleri Seviye serisinin performans yazısında.
.NET 10: JsonSerializer Doğrudan PipeReader'dan Okuyor
.NET 10 öncesinde JsonSerializer yazma tarafında PipeWriter'ı destekliyordu, okuma tarafında ise PipeReader'ı önce AsStream() ile stream'e çevirmek gerekiyordu. .NET 10 ile DeserializeAsync ve DeserializeAsyncEnumerable doğrudan PipeReader alıyor. topLevelValues: true parametresiyle birleşince NDJSON için kendi parser'ını yazmana gerek kalmayabilir:
var reader = PipeReader.Create(new MemoryStream(data));
await foreach (var order in JsonSerializer.DeserializeAsyncEnumerable<Order>(reader, topLevelValues: true))
{
    count++;
    total += order!.Total;
}
DeserializeAsyncEnumerable(PipeReader): 20,000 orders, 17,919,106.90 TRYtopLevelValues: true, akışı tek bir JSON array'i değil, arka arkaya gelen JSON değerleri olarak okur; aradaki satır sonları boşluk sayılır. Elle yazdığımız reader'ın getirdiği şey kontrol: satır uzunluğu sınırı, bozuk bir satırı atlayıp devam edebilmek, satır numarasıyla hata raporlamak. Bunlara ihtiyacın yoksa hazır API daha az kod demek. DeserializeAsyncEnumerable'ın stream ile kullanımını ve büyük JSON'u sabit bellekle okumayı serinin System.Text.Json yazılarında ayrıntılı ele alacağız. .NET 11'in Pipe'taki lock contention (aynı kilit için bekleyen thread'lerin birbirini yavaşlatması) iyileştirmesi ise serinin .NET 11 yazısında.
Üretimde Dikkat
Ne zaman kullanmamalı: küçük dosyalar, satır sayısı birkaç bin olan import'lar, gece bir kez çalışan bir job. Bu durumlarda File.ReadLinesAsync ya da StreamReader yeterli, okunması kolay ve hata yapma ihtimali düşük. Pipelines'ın asıl yeri yüksek hacimli ağ protokolleri, sürekli akan veri ve allocation'ın gerçekten ölçülmüş bir sorun olduğu sıcak yollar.
Her zaman bir mesaj boyutu sınırı koy. MaxLineLength olmadan, satır sonu göndermeyen tek bir istemci servisin belleğini doldurabilir. Sınırı aşan durumda bağlantıyı kapat ya da satırı atlayıp hata say; sessizce büyümeye izin verme.
Okuyucuyu ve yazıcıyı her durumda tamamla. CompleteAsync çağrılmazsa pipe'ın segmentleri pool'a dönmez. Exception ile çıkılıyorsa CompleteAsync(exception) ile karşı tarafa hatayı bildir; yazıcı tarafı FlushResult.IsCompleted'ı görüp durabilsin.
Ölçerken GC (garbage collector; kullanılmayan belleği geri toplayan runtime bileşeni) sayılarına bak. Tablodaki Gen0 sütunu, her 1.000 işlemde kaç kez Gen0 toplaması yapıldığını gösteriyor; PipeReaderLinesOnly'de bu sıfır. Yük altındaki bir serviste daha az GC, daha düşük ve daha kararlı gecikme demek.
Sık Düşülen Tuzaklar
AdvanceTo'yu yanlış argümanlarla çağırmak. Hiçbir şey parse edemediğinde examined'ı buffer.End ver; aksi hâlde ReadAsync aynı veriyle hemen döner ve döngü CPU'yu yakar. Her ReadAsync'ten sonra tam olarak bir AdvanceTo çağır; finally bloğu bunun en güvenli yeri.
IsCompleted'ı görünce buffer'ı işlemeden çıkmak. Yazan taraf son veriyle birlikte tamamlanmış olabilir. Önce kalan satırları işle, sonra çık.
AdvanceTo'dan sonra ReadOnlySequence'ı kullanmak. Satırı başka bir task'a vereceksen önce kopyala ya da (bizim yaptığımız gibi) nesneye çevir; sequence'ın kendisini channel'a yazmak, pool'a dönmüş belleği paylaşmak demek.
Aynı PipeReader'ı birden fazla task'tan okumak. Reader ve writer thread-safe değil. Tek bir okuyucu parse etsin, işi channel ile dağıt.
Ölçmeden geçmek. Tablodaki gibi, nesne üreten bir parse'ta kazanç küçük olabilir. Kodun karmaşıklığını artırmadan önce kendi verinle bir benchmark yaz.
Küçük Bir Deneme
★☆☆ split komutunda StreamPipeReaderOptions'ın bufferSize'ını 512'ye indir. Sonuç değişiyor mu? ParseOrder'a, satırın kaç kez Utf8JsonReader yoluna düştüğünü sayan bir sayaç ekle ve 512 ile 4096'yı karşılaştır.
★★☆ ReadWithPipeReaderAsync'i, bozuk JSON içeren bir satırda durmak yerine satır numarasıyla hatayı kaydedip devam edecek şekilde değiştir. Test için akışın ortasına {"OrderNumber": gibi yarım bir satır koy.
★★★ Tam parse yerine yalnız Status ve Items içindeki UnitPrice/Quantity değerlerini Utf8JsonReader ile okuyup ciroyu nesne üretmeden hesaplayan üçüncü bir yöntem yaz ve benchmark'a ekle. Süre ve allocation hangi satıra yaklaşıyor?
Şimdiye kadar JSON'u hep varsayılan ayarlarla kullandık. Bir sonraki yazıda System.Text.Json'ın ayarlarına giriyoruz: JsonSerializerOptions.Web, naming policy'ler, required ve constructor ile deserialization, .NET 10'un Strict ayarları, duplicate property'nin neden güvenlik riski olduğu ve PaymentMethod hiyerarşisi üzerinden polymorphism.