

.NET'te Stream Modeli: Read'in Az Byte Dönmesi, Decorator Zinciri ve leaveOpen
Stream.Read istediğin kadar değil, o an hazır olan kadar byte döner; sabit uzunluklu veri için ReadExactly kullanmak gerekir. Bookstore sipariş export'unu FileStream, GZipStream ve CryptoStream zinciriyle yazıp okuyor; dispose sırasını, leaveOpen'ı, ArrayPool ile kopyalamayı ve kendi Stream'ini yazmayı gerçek çıktılarla gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ile derlenip denenmiştir.
Önce Tahmin Et
Bir export dosyasının başında 16 byte'lık sabit bir header var: 4 byte sihirli değer, 2 byte sürüm, 8 byte kayıt sayısı, 2 byte flag. Dosyayı ağdan okuyorsun ve şunu yazıyorsun:
var header = new byte[16];
stream.Read(header, 0, header.Length);
long count = BinaryPrimitives.ReadInt64LittleEndian(header.AsSpan(6));
Testlerde her şey yolunda. Üretimde arada bir kayıt sayısı saçma bir değer çıkıyor. Neden?
İkinci soru: sipariş export'unu GZipStream ile sıkıştırıp yazan kod, bir hata yüzünden stream'i dispose etmeden çıkıyor. Ertesi gün aynı dosyayı .NET'teki GZipStream ile açıyorsun. Exception alır mısın?
Üçüncüsü: GZipStream'i bir MemoryStream'in üzerine kurdun, using bloğu bitti, şimdi ms.Position = 0 yapıp sonucu okumak istiyorsun. Ne olur?
Üç sorunun da cevabı Stream sınıfının contract'ında. Bu seride .NET'te dosya, stream ve serialization konularını sırayla ele alacağız; ilk durak, her şeyin üzerine kurulduğu bu soyutlama.
Yazıdaki her örnek serinin repo'sundaki Bookstore.IO.Streams console uygulamasında bir komut. Çalıştırmak için .NET 10 SDK yeterli; komut adları capabilities, short-read, export, truncated, leave-open, counting ve memory:
dotnet run --project src/Bookstore.IO.Streams -- capabilities
dotnet run --project src/Bookstore.IO.Streams -- short-read
Stream Contract'ı: Can* Property'leri, Position ve Length
File.ReadAllText, Path.Combine ve Encoding gibi temel kullanımı C# Temelleri serisinin Dosya ve Konsol yazısında gördük. Burada bir kat aşağı iniyoruz. Stream bir byte dizisinin soyutlamasıdır, ama her stream her şeyi yapamaz. Ne yapabildiğini üç property söyler: CanRead, CanWrite, CanSeek. Örnekleri sitedeki serilerin ortak örnek uygulaması Bookstore'dan (bir online kitapçı) alacağız. Önce elimizdeki stream'lere bakalım:
Stream[] streams =
[
    new MemoryStream(),
    file,
    new BufferedStream(file),
    new GZipStream(new MemoryStream(), CompressionLevel.Fastest),
    client.GetStream() // TcpClient'tan gelen NetworkStream
];

foreach (var s in streams)
{
    string length;
    try { length = s.Length.ToString(); }
    catch (NotSupportedException) { length = "NotSupportedException"; }
    Console.WriteLine($"{s.GetType().Name,-16} {s.CanRead,-8} {s.CanWrite,-9} {s.CanSeek,-8} {length}");
}
Stream CanRead CanWrite CanSeek Length
MemoryStream True True True 0
FileStream True True True 0
BufferedStream True True True 0
GZipStream False True False NotSupportedException
NetworkStream True True False NotSupportedExceptionSıkıştırma modunda açılmış bir GZipStream yalnız yazılabilir; okunamaz, ileri geri gidilemez ve uzunluğu yoktur. NetworkStream iki yönlüdür ama yine seek edilemez. Kural şu: CanSeek false ise Length, Position, Seek ve SetLength NotSupportedException fırlatır. "Stream'in boyutunu al, o kadar byte'lık array aç" diye başlayan her kod, ağdan ya da sıkıştırılmış veriden okuduğu gün kırılır.
Bu yüzden bir method parametre olarak Stream alıyorsa, ihtiyacını baştan kontrol etmesi iyi olur. Seek gerektiren bir işlem için if (!stream.CanSeek) kontrolü yapıp ya anlamlı bir exception fırlat ya da veriyi geçici bir dosyaya kopyalayıp onunla çalış.
Read Az Byte Dönebilir: ReadExactly ve ReadAtLeast
İlk sorunun cevabı burada. Read(buffer, 0, 16) "16 byte oku" demek değildir; "en fazla 16 byte oku, kaç tane okuduğunu söyle" demektir. Contract yalnız şunu garanti eder: stream bitmediyse en az 1 byte döner, bittiyse 0 döner. Bunu gerçek bir TCP bağlantısıyla gösterelim. Gönderen taraf 16 byte'lık header'ı iki parça hâlinde, arada 50 ms bekleyerek yolluyor:
byte[] header = CreateHeader(120_000);
for (int round = 0; round < 2; round++)
{
    await ns.WriteAsync(header.AsMemory(0, 7));
    await Task.Delay(50);
    await ns.WriteAsync(header.AsMemory(7));
}
await ns.WriteAsync(header.AsMemory(0, 10)); // yarım kalmış üçüncü header
Okuyan taraf önce klasik Read'i, sonra .NET 7 ile gelen ReadExactly ve ReadAtLeast'i deniyor:
int n = stream.Read(buffer, 0, buffer.Length);
Console.WriteLine($"Read returned {n} of {buffer.Length} bytes");
stream.ReadExactly(buffer, n, buffer.Length - n); // ilk header'ı tamamla

stream.ReadExactly(buffer);
long count = BinaryPrimitives.ReadInt64LittleEndian(buffer.AsSpan(6));
Console.WriteLine($"ReadExactly: magic={Encoding.ASCII.GetString(buffer, 0, 4)}, records={count}");

await sender; // gönderen bağlantıyı kapattı

int got = stream.ReadAtLeast(buffer, buffer.Length, throwOnEndOfStream: false);
Console.WriteLine($"ReadAtLeast(throwOnEndOfStream: false) returned {got}");

try
{
    stream.ReadExactly(buffer);
}
catch (EndOfStreamException ex)
{
    Console.WriteLine($"{ex.GetType().Name}: {ex.Message}");
}
Read returned 7 of 16 bytes
ReadExactly: magic=BKEX, records=120000
ReadAtLeast(throwOnEndOfStream: false) returned 10
EndOfStreamException: Unable to read beyond the end of the stream.Read o an gelmiş olan 7 byte'ı döndü. Header'ın geri kalanı buffer'da sıfır olarak kaldığı için kayıt sayısı yanlış okunurdu; testte veri tek seferde geldiği için bunu hiç görmezdin. ReadExactly istenen sayı dolana kadar okumaya devam eder, stream erken biterse EndOfStreamException fırlatır. ReadAtLeast ise "en az şu kadar" der; throwOnEndOfStream: false ile stream bittiğinde exception yerine okuyabildiği kadarını döner. Yarım kalmış son header'da 10 byte döndü.
Bu yalnız ağ için geçerli değil. .NET 6'dan itibaren GZipStream, DeflateStream ve CryptoStream de istenen buffer dolana kadar beklemiyor, o an üretebildiği kadar byte'ı döndürüyor. Microsoft bunu bir breaking change olarak duyurdu. .NET Framework'ten taşınan ve Read'in dönüş değerine bakmayan kod, sıkıştırılmış dosyalarda bu yüzden bozulabilir. Sabit uzunlukta bir yapı okuyorsan ReadExactly, async kodda ReadExactlyAsync kullan; uzunluk belli değilse dönüş değerine göre döngü kur.
İyi haber, derleyicinin artık bunu yakalaması. Yazının başındaki kodu NetworkStream ile .NET 10 SDK'da derlediğinde CA2022 analyzer'ı varsayılan olarak uyarı verir:
warning CA2022: Avoid inexact read with 'System.Net.Sockets.NetworkStream.Read(byte[], int, int)'Bu uyarıyı bastırma; projede TreatWarningsAsErrors açıksa build'i durdurur, ki istediğimiz de bu.
Decorator Zinciri: FileStream, GZipStream ve CryptoStream
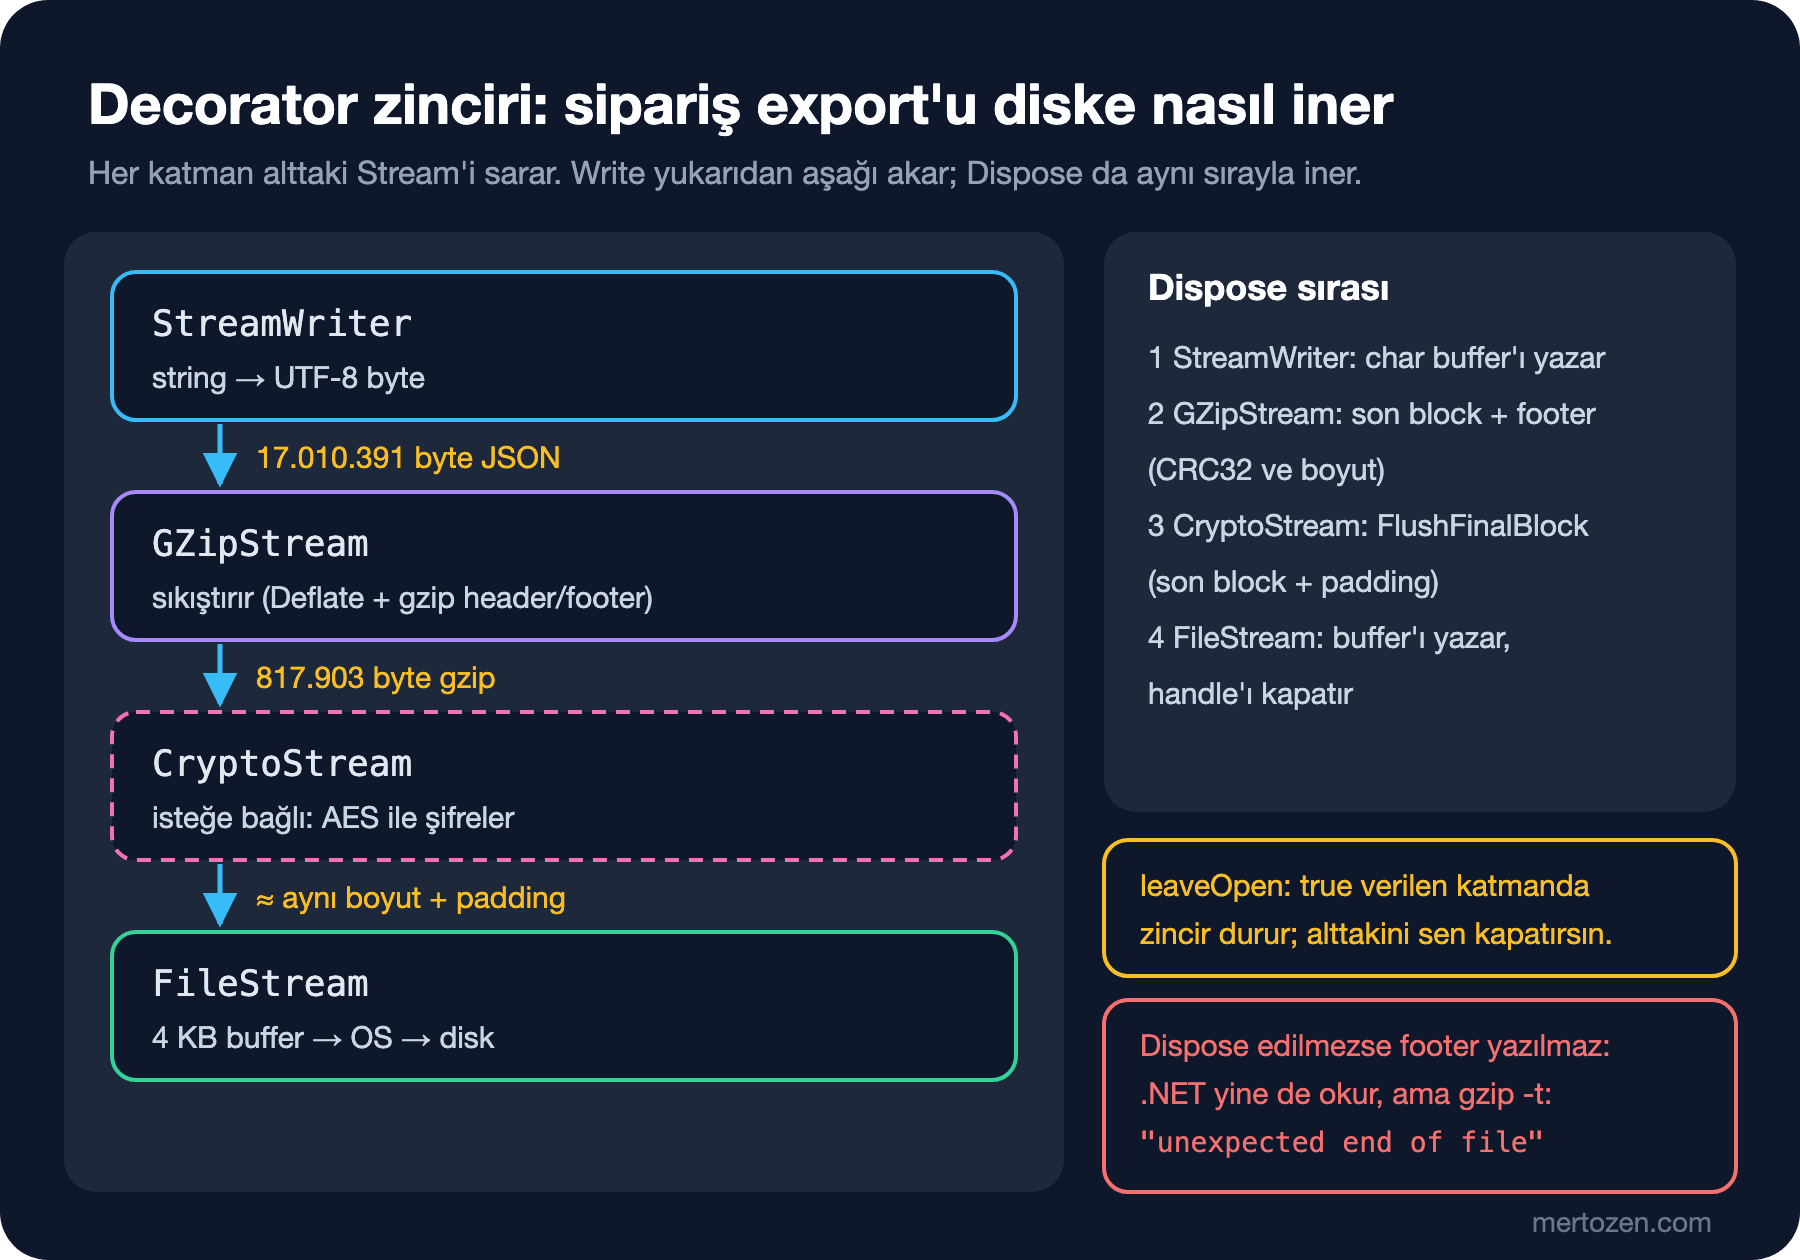
GZipStream kendi başına bir yere yazmaz; constructor'da aldığı başka bir stream'i sarar. CryptoStream, BufferedStream ve StreamWriter da aynı şekilde çalışır. Bu, Design Patterns serisinin Decorator Pattern yazısında anlattığımız yapının .NET'teki en bilinen örneği: her katman alttaki stream'e bir davranış ekler ve dışarıya yine Stream olarak görünür. Bookstore'un aylık sipariş export'u bu zincirle yazılıyor; her sipariş bir JSON satırı:
public static async Task WriteAsync(string path, IEnumerable<Order> orders, CancellationToken ct = default)
{
    await using var file = new FileStream(path, FileMode.Create, FileAccess.Write, FileShare.None,
        bufferSize: 4096, useAsync: true);
    await using var gzip = new GZipStream(file, CompressionLevel.Optimal);
    await using var writer = new StreamWriter(gzip, new UTF8Encoding(encoderShouldEmitUTF8Identifier: false));

    foreach (var order in orders)
    {
        await writer.WriteLineAsync(JsonSerializer.Serialize(order).AsMemory(), ct);
    }
}

public static async IAsyncEnumerable<Order> ReadAsync(string path,
    [EnumeratorCancellation] CancellationToken ct = default)
{
    await using var file = new FileStream(path, FileMode.Open, FileAccess.Read, FileShare.Read,
        bufferSize: 4096, useAsync: true);
    await using var gzip = new GZipStream(file, CompressionMode.Decompress);
    using var reader = new StreamReader(gzip, Encoding.UTF8);

    while (await reader.ReadLineAsync(ct) is { } line)
    {
        yield return JsonSerializer.Deserialize<Order>(line)!;
    }
}
Okuma tarafı aynı zincirin tersi. 100.000 siparişi yazıp geri okuduğumuzda:
Written: 1,633,057 bytes in 319 ms
Read back: 100,000 orders, total 89,025,586.70 TRY in 395 ms
Expected:  100,000 orders, total 89,025,586.70 TRY
Örnek veri çok tekrarlı olduğu için sıkıştırma oranı yüksek; gerçek veride oran daha düşük olur. Asıl önemli nokta, zincirin hiçbir katmanında dosyanın tamamının bellekte durmaması. Async okuma tarafındaki IAsyncEnumerable ve await foreach'in ayrıntısı C# Asenkron serisinde var.
Zincire şifreleme eklediğinde sıra önemli hâle gelir. Sıkıştırma tekrar eden byte'ları bulup kısaltarak çalışır; iyi şifrelenmiş veri ise rastgele görünür ve içinde tekrar yoktur. Aynı siparişleri iki sırayla yazıp çıkan byte'ları saydık:
// writer -> gzip -> crypto -> hedef
var crypto = new CryptoStream(target, aes.CreateEncryptor(), CryptoStreamMode.Write);
top = new GZipStream(crypto, CompressionLevel.Optimal);

// writer -> crypto -> gzip -> hedef
var gzip = new GZipStream(target, CompressionLevel.Optimal, leaveOpen: true);
top = new CryptoStream(gzip, aes.CreateEncryptor(), CryptoStreamMode.Write);
gzip -> AES: 1,633,072 bytes
AES -> gzip: 34,002,279 bytesÖnce sıkıştırıp sonra şifrelediğimizde dosya 1,6 MB; ters sırada 34 MB, yani ham JSON'dan bile büyük. Kural basit: önce sıkıştır, sonra şifrele. Anahtar yönetimi ve hangi şifreleme modunun seçileceği bu yazının konusu değil; buradaki AES (Advanced Encryption Standard; yaygın kullanılan simetrik şifreleme algoritması) örneği yalnız zincirin sırasını göstermek için var.
Dispose Sırası ve leaveOpen
Zincirdeki her katman, varsayılan olarak dispose edildiğinde altındaki stream'i de dispose eder. StreamWriter kapanırken önce kendi char buffer'ını yazar, sonra GZipStream'i kapatır. GZipStream son sıkıştırılmış block'u ve gzip footer'ını (CRC32 ve orijinal boyut) yazar, sonra FileStream'i kapatır. Bu sıranın bir adımı atlanırsa ne olduğunu görelim. 2.000 siparişi bir MemoryStream'e sıkıştırıp her aşamada byte sayısına baktık:
var ms = new MemoryStream();
var gzip = new GZipStream(ms, CompressionLevel.Optimal);
gzip.Write(payload);
byte[] notFlushed = ms.ToArray();
gzip.Flush();
byte[] flushedOnly = ms.ToArray();
gzip.Dispose();
Without Flush/Dispose: 30,671 bytes in MemoryStream
After Flush: 33,088 bytes
After Dispose: 33,098 bytes
not flushed: 624,660 of 675,471 bytes, no exception
flushed, not disposed: 675,471 of 675,471 bytes, no exception
disposed: 675,471 of 675,471 bytes, no exceptionDispose edilmeyen stream'in son block'u hiç yazılmamış: 675.471 byte'lık verinin 624.660 byte'ı geri geliyor. Kötü olan, bizim denememizde .NET 10'un GZipStream'inin bunu fark etmemesi; eksik veriyi exception fırlatmadan döndürdü. Aynı byte'ları dosyaya yazıp gzip -t ile test ettiğimizde ise iki bozuk dosya da yakalandı:
gzip: not-flushed.gz: unexpected end of file
gzip: flushed.gz: unexpected end of file
Flush verinin tamamını yazar ama footer'ı yazmaz; bu dosyayı .NET okur, Linux'taki gzip, Python'un gzip module'ü ya da muhasebenin kullandığı başka bir araç reddeder. Yani "kendi testimde açılıyor" demek, dosyanın sağlam olduğunu göstermez. Export'un sonunda dispose sırasını garanti et ve mümkünse kayıt sayısını ya da bir checksum'ı ayrıca sakla.
Bazen alttaki stream'in kapanmasını istemezsin. En sık örnek MemoryStream: sıkıştırmayı bitirip sonucu okumak istersin.
var ms = new MemoryStream();
using (var gzip = new GZipStream(ms, CompressionLevel.Fastest))
{
    gzip.Write(data);
}
ms.Position = 0; // ObjectDisposedException

var ms2 = new MemoryStream();
using (var gzip = new GZipStream(ms2, CompressionLevel.Fastest, leaveOpen: true))
{
    gzip.Write(data);
}
ms2.Position = 0; // sorun yok
leaveOpen: false -> ObjectDisposedException: Cannot access a closed Stream.
leaveOpen: true -> 41 bytes, Position reset to 0leaveOpen: true zinciri o katmanda keser: GZipStream kendi footer'ını yazar ama ms2'ye dokunmaz, onu kapatmak artık senin işin. StreamWriter, StreamReader, CryptoStream, BinaryWriter gibi sarıcıların hepsinde bu parametre var. Bir küçük ayrıntı: MemoryStream.ToArray() dispose edildikten sonra da çalışır, ama Position, Read ve Write çalışmaz.
CopyToAsync, Buffer Boyutu ve ArrayPool
Bir stream'i diğerine aktarmanın en kısa yolu CopyToAsync. Varsayılan buffer boyutu 81.920 byte; seek edilebilen stream'lerde .NET bunu kalan byte sayısıyla sınırlar, böylece 2 KB'lık bir dosya için 80 KB buffer açılmaz. 81.920'nin seçilme sebebi, 85.000 byte'ın üzerindeki array'lerin Large Object Heap'e (LOH; büyük nesnelerin ayrı tutulduğu ve daha seyrek toplanan heap bölgesi) düşmesi; runtime kaynak kodundaki yorum da bunu söylüyor.
Kopyalama sırasında satır sayma, hash hesaplama ya da ilerleme bildirme gibi bir iş yapacaksan döngüyü kendin yazarsın. O durumda buffer'ı her seferinde new ile açmak yerine ArrayPool<byte>.Shared'dan kirala:
public static async Task<long> CopyWithPooledBufferAsync(Stream source, Stream destination,
    int bufferSize = 81_920, CancellationToken ct = default)
{
    byte[] buffer = ArrayPool<byte>.Shared.Rent(bufferSize);
    long total = 0;
    try
    {
        int n;
        while ((n = await source.ReadAsync(buffer.AsMemory(0, bufferSize), ct)) > 0)
        {
            await destination.WriteAsync(buffer.AsMemory(0, n), ct);
            total += n;
        }
    }
    finally
    {
        ArrayPool<byte>.Shared.Return(buffer);
    }
    return total;
}
ArrayPool.Rent(81920) returned 131,072 bytes
Copied 817,903 bytes with a pooled bufferRent istediğinden büyük bir array dönebilir; 81.920 istedik, 131.072 geldi. Bu yüzden döngüde buffer.Length değil bufferSize kullanıyoruz ve yazarken her zaman n kadar byte gönderiyoruz. Return'ü finally'ye koymak da şart; exception'da array'i geri vermezsen pool işini yapamaz. Memory<byte> ve Span<byte>'in kuralları C# İleri Seviye serisinin Span yazısında anlatıldı.
Kendi Stream'ini Yazmak: CountingStream
Yukarıdaki sıkıştırma oranlarını nasıl ölçtük? Zincire, içinden geçen byte'ları sayan küçük bir decorator ekleyerek:
public sealed class CountingStream(Stream inner, bool leaveOpen = false) : Stream
{
    public long BytesRead { get; private set; }
    public long BytesWritten { get; private set; }

    public override bool CanRead => inner.CanRead;
    public override bool CanWrite => inner.CanWrite;
    public override bool CanSeek => false;

    public override long Length => throw new NotSupportedException();
    public override long Position
    {
        get => throw new NotSupportedException();
        set => throw new NotSupportedException();
    }

    public override int Read(byte[] buffer, int offset, int count) => Read(buffer.AsSpan(offset, count));

    public override int Read(Span<byte> buffer)
    {
        int n = inner.Read(buffer);
        BytesRead += n;
        return n;
    }

    public override Task<int> ReadAsync(byte[] buffer, int offset, int count, CancellationToken ct) =>
        ReadAsync(buffer.AsMemory(offset, count), ct).AsTask();

    public override async ValueTask<int> ReadAsync(Memory<byte> buffer, CancellationToken ct = default)
    {
        int n = await inner.ReadAsync(buffer, ct).ConfigureAwait(false);
        BytesRead += n;
        return n;
    }

    // Write, Write(ReadOnlySpan), WriteAsync(byte[]) ve WriteAsync(ReadOnlyMemory) aynı şekilde
    // inner'a yazıp BytesWritten'ı artırır.

    public override void Flush() => inner.Flush();
    public override Task FlushAsync(CancellationToken ct) => inner.FlushAsync(ct);

    public override long Seek(long offset, SeekOrigin origin) => throw new NotSupportedException();
    public override void SetLength(long value) => throw new NotSupportedException();

    private bool _disposed;

    protected override void Dispose(bool disposing)
    {
        if (disposing && !_disposed)
        {
            _disposed = true;
            if (!leaveOpen)
            {
                inner.Dispose();
            }
        }
        base.Dispose(disposing);
    }

    public override async ValueTask DisposeAsync()
    {
        if (!_disposed)
        {
            _disposed = true;
            if (!leaveOpen)
            {
                await inner.DisposeAsync().ConfigureAwait(false);
            }
        }
        await base.DisposeAsync().ConfigureAwait(false);
    }
}Stream'den türettiğinde derleyicinin zorunlu tuttuğu abstract üyeler şunlar: üç Can* property'si, Length, Position, Flush, Read(byte[], int, int), Write(byte[], int, int), Seek ve SetLength. Yalnız bunları yazarsan stream çalışır ama yavaş çalışır. Base class'taki Read(Span<byte>), ArrayPool'dan bir array kiralayıp senin array'li Read'ini çağırır ve sonucu kopyalar. ReadAsync(Memory<byte>) da array tabanlı overload'a düşer, o da senin senkron Read'ini thread pool'da çalıştırır. Yani async görünen çağrı aslında bir thread'i bloklar. Bu yüzden span ve memory alan overload'ları, async olanlarla birlikte mutlaka override et; array'li olanları onlara yönlendir.
Can* property'lerinin dürüst olması da önemli. CountingStream seek desteklemediğini açıkça söylüyor; CopyToAsync gibi method'lar bu bilgiye göre davranıyor. Zincire yerleştirdiğimizde ölçüm şöyle çıktı:
var file = new FileStream(path, FileMode.Create, FileAccess.Write, FileShare.None, 4096, useAsync: true);
var compressed = new CountingStream(file);
var gzip = new GZipStream(compressed, CompressionLevel.Optimal);
var raw = new CountingStream(gzip);
JSON bytes into gzip: 17,010,391
gzip bytes into file: 817,903
File length on disk: 817,903Üretimde Dikkat
Stream'lerle ilgili en pahalı hata, işi kolaylaştırmak için her şeyi bir MemoryStream'e yazmak. 200.000 siparişi önce MemoryStream'e, sonra doğrudan dosyaya yazıp GC.GetTotalAllocatedBytes ile ölçtük:
MemoryStream: Length 68,001,648, Capacity 134,217,728, allocated 487,690,760 bytes
FileStream:   allocated 223,744,736 bytes
68 MB'lık veri için MemoryStream 128 MB'lık bir array tutuyor; kapasite her dolduğunda iki katına çıktığı için arada 64, 32, 16 MB'lık array'ler de açılıp çöpe gitti. İki satır arasındaki 264 MB'lık fark bu büyüme. Dosya tarafındaki 224 MB ise her sipariş için üretilen JSON string'lerinden geliyor; onu da serinin System.Text.Json yazılarında stream'e doğrudan serialize ederek düşüreceğiz. Ayrıca MemoryStream bir byte[] üzerine kurulu olduğu için 2 GB civarında bir üst sınırı var. 5 GB'lık bir export'u bellekte toplayamazsın; zinciri dosyaya ya da response'a doğrudan bağla.
Ölçerken iki şeye bak: process'in working set'i ve GC'nin (garbage collector; kullanılmayan belleği geri toplayan runtime bileşeni) ne sıklıkta çalıştığı. Büyük dosyaları sabit bellekle işlemeyi ve bunu nasıl izleyeceğini serinin büyük dosyalar yazısında ayrıntılı ele alacağız.
Hata durumunu da düşün. Export yarıda bir exception ile kesilirse await using blokları yine çalışır ve gzip footer'ı yazılır; elinde geçerli görünen ama eksik kayıtlı bir dosya kalır. Bu yüzden export'u önce geçici bir ada yazıp başarıyla bittiğinde asıl ada taşımak gerekir. Bu atomik yazma tekniğini bir sonraki yazıda göreceğiz.
Sık Düşülen Tuzaklar
Read'in dönüş değerini görmezden gelmek. Testte veri hep tek parça geldiği için hata görünmez; üretimde ağ gecikmesi ya da sıkıştırılmış veri işin içine girdiğinde ortaya çıkar. Sabit uzunluk için ReadExactly, gerisi için dönüş değerine bakan döngü.
Sıkıştırma stream'ini dispose etmeden byte'ları kullanmak. ms.ToArray()'i using bloğunun içinde çağırmak en sık görülen şekli. Sonucu almadan önce GZipStream'in kapandığından emin ol; leaveOpen: true tam bu iş için var.
Zincirde bir katmanı iki kez sahiplenmek. Hem StreamWriter'ı hem de altındaki FileStream'i ayrı ayrı using ile açmak çoğu zaman zararsızdır, çünkü ikinci dispose bir şey yapmaz. Ama ters sırayla kapatırsan (önce FileStream), StreamWriter buffer'ını kapalı bir stream'e yazmaya çalışır ve exception alırsın.
Seek edilemeyen stream'de Length ya da Position kullanmak. Upload edilen dosyanın stream'i, GZipStream ve NetworkStream bunu desteklemez. Önce CanSeek'e bak.
Kendi stream'inde yalnız abstract üyeleri yazmak. Çalışır ama her async çağrı bir thread'i bloklar ve her span çağrısı ekstra kopya yapar.
Küçük Bir Deneme
★☆☆ ShortReadAsync örneğinde gönderen tarafı header'ı 16 ayrı parça hâlinde, her byte'tan sonra 10 ms bekleyerek yazacak şekilde değiştir. Read kaç byte dönüyor, ReadExactly sonucu değişiyor mu?
★★☆ CountingStream'e okunan byte'lar üzerinden SHA (Secure Hash Algorithm; kriptografik hash fonksiyonlarından oluşan bir aile) ailesinden SHA-256 hash'ini hesaplayan bir özellik ekle (IncrementalHash kullanabilirsin). Export'u yazarken hash'i hesapla, okurken tekrar hesapla ve karşılaştır; dosyanın son 100 byte'ını silip farkı gör.
★★★ Export'un başına bu yazıdaki 16 byte'lık BKEX header'ını ekle: kayıt sayısını yazmak için önce sıkıştırılmamış header alanını sıfırla, export bitince FileStream'de 6. byte'a seek edip gerçek sayıyı yaz. Bu, GZipStream'in leaveOpen parametresi olmadan neden mümkün değil?
Bu yazıda FileStream'i hep aynı parametrelerle açtık. Bir sonraki yazıda bu parametrelerin ne yaptığına bakıyoruz: FileStreamOptions, Windows ve Linux'ta gerçek async I/O'nun farkı, RandomAccess ile offset tabanlı okuma ve yarım kalmayan dosya yazmak için atomik değiştirme.