

Büyük Dosyalar ve Memory-Mapped File'lar: Sabit Bellekle Gigabyte'larca Veri İşlemek
Büyük bir dosyayı sabit bellekle işlemek yetmez, allocation'ı da sıfıra indirmek gerekir: 5 GB'lık sipariş log'unda File.ReadLines 54 MB bellekle ama 35 GB allocation ile 14,5 saniye sürerken, kiralık buffer ve byte parser ile aynı iş 2,5 saniyede bitti. Dosyayı satır sınırına hizalı offset aralıklarına bölüp Channel ile paralel işlemeyi, memory-mapped file'ın ne zaman hızlandırdığını ve working set'e etkisini gerçek ölçümlerle gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve dotnet-counters 10.0 ile derlenip denenmiştir.
Önce Tahmin Et
Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) sipariş service'i her sipariş event'ini tek satırlık bir log'a yazıyor. Yıl sonunda dosya 5 GB, 101 milyon satır. Muhasebe günlük ciroyu istiyor ve ilk yazılan kod şu:
foreach (string line in File.ReadLines(path))
{
    string[] parts = line.Split(',');
    if (parts[2] is "Pending" or "Cancelled") continue;
    var day = DateOnly.ParseExact(parts[0].AsSpan(0, 10), "yyyy-MM-dd", CultureInfo.InvariantCulture);
    totals[day] = totals.GetValueOrDefault(day) + decimal.Parse(parts[3], CultureInfo.InvariantCulture);
}
File.ReadLines dosyayı satır satır okuduğu için process'in belleği sabit kalır. Peki bu döngü bitene kadar toplam kaç byte allocation yapılır: 5 GB'tan az mı, çok mu?
İkinci soru: aynı işi dosyayı memory-mapped file olarak açıp yapıyoruz. Process'in working set'i (process'in o an fiziksel bellekte tuttuğu sayfaların toplamı) kaç MB'a çıkar?
Üçüncüsü: dosyayı parçalara bölüp 4 worker ile okumak 0,58 saniye sürüyor. 8 worker ile kaç saniye sürer?
Bu yazı serinin önceki yazılarındaki her şeyi tek bir soruda birleştiriyor: dosya belleğe sığmadığında ya da sığsa bile sığdırmamamız gerektiğinde ne yaparız? Örnekler Bookstore.IO.LargeFiles console uygulamasında; ölçümler Release build ile:
dotnet run -c Release --project src/Bookstore.IO.LargeFiles -- generate 5
dotnet run -c Release --project src/Bookstore.IO.LargeFiles -- revenue streamreader
101,214,575 lines, 5,000,000,009 bytes in 3.5 s
2026-01-01T00:00:00Z,BS-000000001,Cancelled,1427.79
2026-01-01T00:00:00Z,BS-000000002,Delivered,805.58
2026-01-01T00:00:00Z,BS-000000003,Paid,183.38Sabit Bellek Prensibi ve Allocation'ın Bedeli
Büyük dosya işlemenin ilk kuralı, belleğin dosya boyutuyla değil, işlenen en büyük parçanın boyutuyla orantılı olması. File.ReadAllText ya da File.ReadAllLines bu kuralı çiğner; File.ReadLines çiğnemez. Yukarıdaki kodun sonucu:
streamreader   14.45 s  allocated  35,461.7 MB  peak working set      54 MB  gen0  4445  gen2   0
  293 days, total 85,019,891,247.66 TRY, 2026-01-01: 290,294,127.20 TRY
İlk sorunun cevabı: 35 GB, dosyanın yedi katı. Working set 54 MB'ta sabit kaldı, yani "sabit bellek" hedefi tuttu; ama her satır için bir satır string'i, dört alan string'i ve bir array üretildi. .NET string'leri UTF (Unicode Transformation Format; Unicode karakterlerini byte'a çeviren kodlama ailesi) ailesinden UTF-16 ile tutulduğu için 49 byte'lık bir satır bellekte iki kat yer kaplıyor. Bunların hepsi gen0'da (garbage collector'ın en genç, en sık toplanan bölgesi) ölüyor, bu yüzden 4.445 gen0 toplaması oldu ve hiç gen2 olmadı. Ucuz ama bedava değil: 14 saniyenin büyük kısmı bu object'leri üretip toplamakla geçiyor.
Bu tabloyu çalışan bir process'ten dışarıdan görmek için dotnet-counters kullanılır. Aynı komutu counter toplayarak çalıştırdık; çalışmanın ortasından bir ölçüm:
dotnet-counters collect --format csv -o counters.csv --refresh-interval 2 --counters System.Runtime -- dotnet bin/Release/net10.0/Bookstore.IO.LargeFiles.dll revenue streamreaderdotnet.gc.heap.total_allocated (By / 2 sec),Rate,5315120000
dotnet.gc.collections ({collection} / 2 sec)[gc.heap.generation=gen0],Rate,636
dotnet.gc.collections ({collection} / 2 sec)[gc.heap.generation=gen2],Rate,0
dotnet.gc.pause.time (s / 2 sec),Rate,0.036371000000000014
dotnet.process.memory.working_set (By),Metric,63717376İki saniyede 5,3 GB allocation ve 636 gen0 toplaması, ama working set 64 MB. "Bellek sorunu yok" görünen bir job'ın CPU'sunu neden yediğini bu satırlar anlatır. dotnet-counters ve diğer teşhis araçlarının ayrıntılı kullanımı .NET'te Profiling ve Diagnostics serisinde.
LOH ve kiralık buffer'lar
String'lerden kurtulmak için veriyi byte olarak büyük parçalar hâlinde okuyacağız. Ama büyük buffer'ın da bir tuzağı var: 85.000 byte ve üstündeki object'ler LOH'a (Large Object Heap; büyük object'lerin ayrı tutulduğu ve yalnız gen2 ile toplanan heap bölgesi) gider. Her parça için yeni bir 1 MB'lık array açmakla ArrayPool'dan kiralamak arasındaki fark:
new byte[1 MB]  5,000 x:   75 ms, allocated 5,000 MB, gen2 collections 1666
ArrayPool.Rent  5,000 x:    3 ms, allocated     1 MB, gen2 collections 0
Her 1 MB'lık array LOH'a düştü ve 5.000 tekrar 1.666 gen2 toplamasına yol açtı. Gen2 toplaması bütün heap'i tarar; gerçek bir uygulamada heap büyükse her biri fark edilir bir duraklama demek. ArrayPool<byte>.Shared ise aynı buffer'ı tekrar tekrar verdi. Serinin Stream modeli yazısında CopyToAsync için yaptığımız şeyin büyük dosyadaki karşılığı bu.
Tek Thread, Sabit Buffer, String Yok
İkinci yaklaşım dosyayı 1 MB'lık parçalarla okuyor, her parçadaki tam satırları byte olarak parse ediyor, parçanın sonundaki yarım satırı buffer'ın başına taşıyıp bir sonraki okumaya ekliyor:
byte[] buffer = ArrayPool<byte>.Shared.Rent(bufferSize);
try
{
    using var file = new FileStream(path, FileMode.Open, FileAccess.Read, FileShare.Read, bufferSize: 0, FileOptions.SequentialScan);
    int carry = 0, read;
    while ((read = file.Read(buffer, carry, buffer.Length - carry)) > 0)
    {
        int length = carry + read;
        int consumed = LineParser.AccumulateLines(buffer.AsSpan(0, length), cents);
        // Yarım kalan satırı buffer'ın başına taşı.
        carry = length - consumed;
        buffer.AsSpan(consumed, carry).CopyTo(buffer);
    }
}
finally
{
    ArrayPool<byte>.Shared.Return(buffer);
}
bufferSize: 0, FileStream'in kendi iç buffer'ını kapatır; zaten büyük parçalar okuduğumuz için ikinci bir kopya gereksiz. FileOptions.SequentialScan işletim sistemine dosyanın baştan sona okunacağını söyler. Satır parser'ı string üretmez; alanları virgüllerin yerinden bulur, tarihi ve tutarı doğrudan byte'lardan sayıya çevirir ve günlük toplamları kuruş cinsinden bir long[]'de tutar:
public static void Accumulate(ReadOnlySpan<byte> line, long[] centsPerDay)
{
    int c1 = line.IndexOf((byte)',');
    int c2 = c1 + 1 + line[(c1 + 1)..].IndexOf((byte)',');
    int c3 = c2 + 1 + line[(c2 + 1)..].IndexOf((byte)',');
    ReadOnlySpan<byte> status = line[(c2 + 1)..c3];
    if (status.SequenceEqual("Pending"u8) || status.SequenceEqual("Cancelled"u8)) return;

    int year = Digits(line[..4]), month = Digits(line.Slice(5, 2)), day = Digits(line.Slice(8, 2));
    int dayIndex = new DateOnly(year, month, day).DayNumber - FirstDayNumber;
    centsPerDay[dayIndex] += ParseCents(line[(c3 + 1)..]);
}
chunked 2.47 s allocated 1.0 MB peak working set 43 MB gen0 0 gen2 0
293 days, total 85,019,891,247.66 TRY, 2026-01-01: 290,294,127.20 TRYAynı sonuç, 5,8 kat hızlı, 35 GB yerine 1 MB allocation ve sıfır GC (garbage collector; kullanılmayan object'lerin belleğini geri toplayan runtime bileşeni) toplaması. Kuruş cinsinden long kullanmak bilinçli bir seçim: decimal toplama long toplamadan pahalıdır ve iki ondalıklı para için kayıpsızdır. Parser'ın bir bedeli de var: formatı kesin biliyor olmalısın. Tutar her zaman iki ondalıklı mı, tarih her zaman UTC (Coordinated Universal Time; saat dilimlerinin referans aldığı evrensel saat) ve yyyy-MM-dd ile mi başlıyor? Bu varsayımları kendi dosyanda doğrula ve bozuk satırı sessizce yanlış toplamak yerine reddeden kontroller ekle. Span<T> ve ref struct kuralları C# İleri Seviye serisinin Span yazısında.
Paralel İşleme: Offset Aralıkları ve Channel
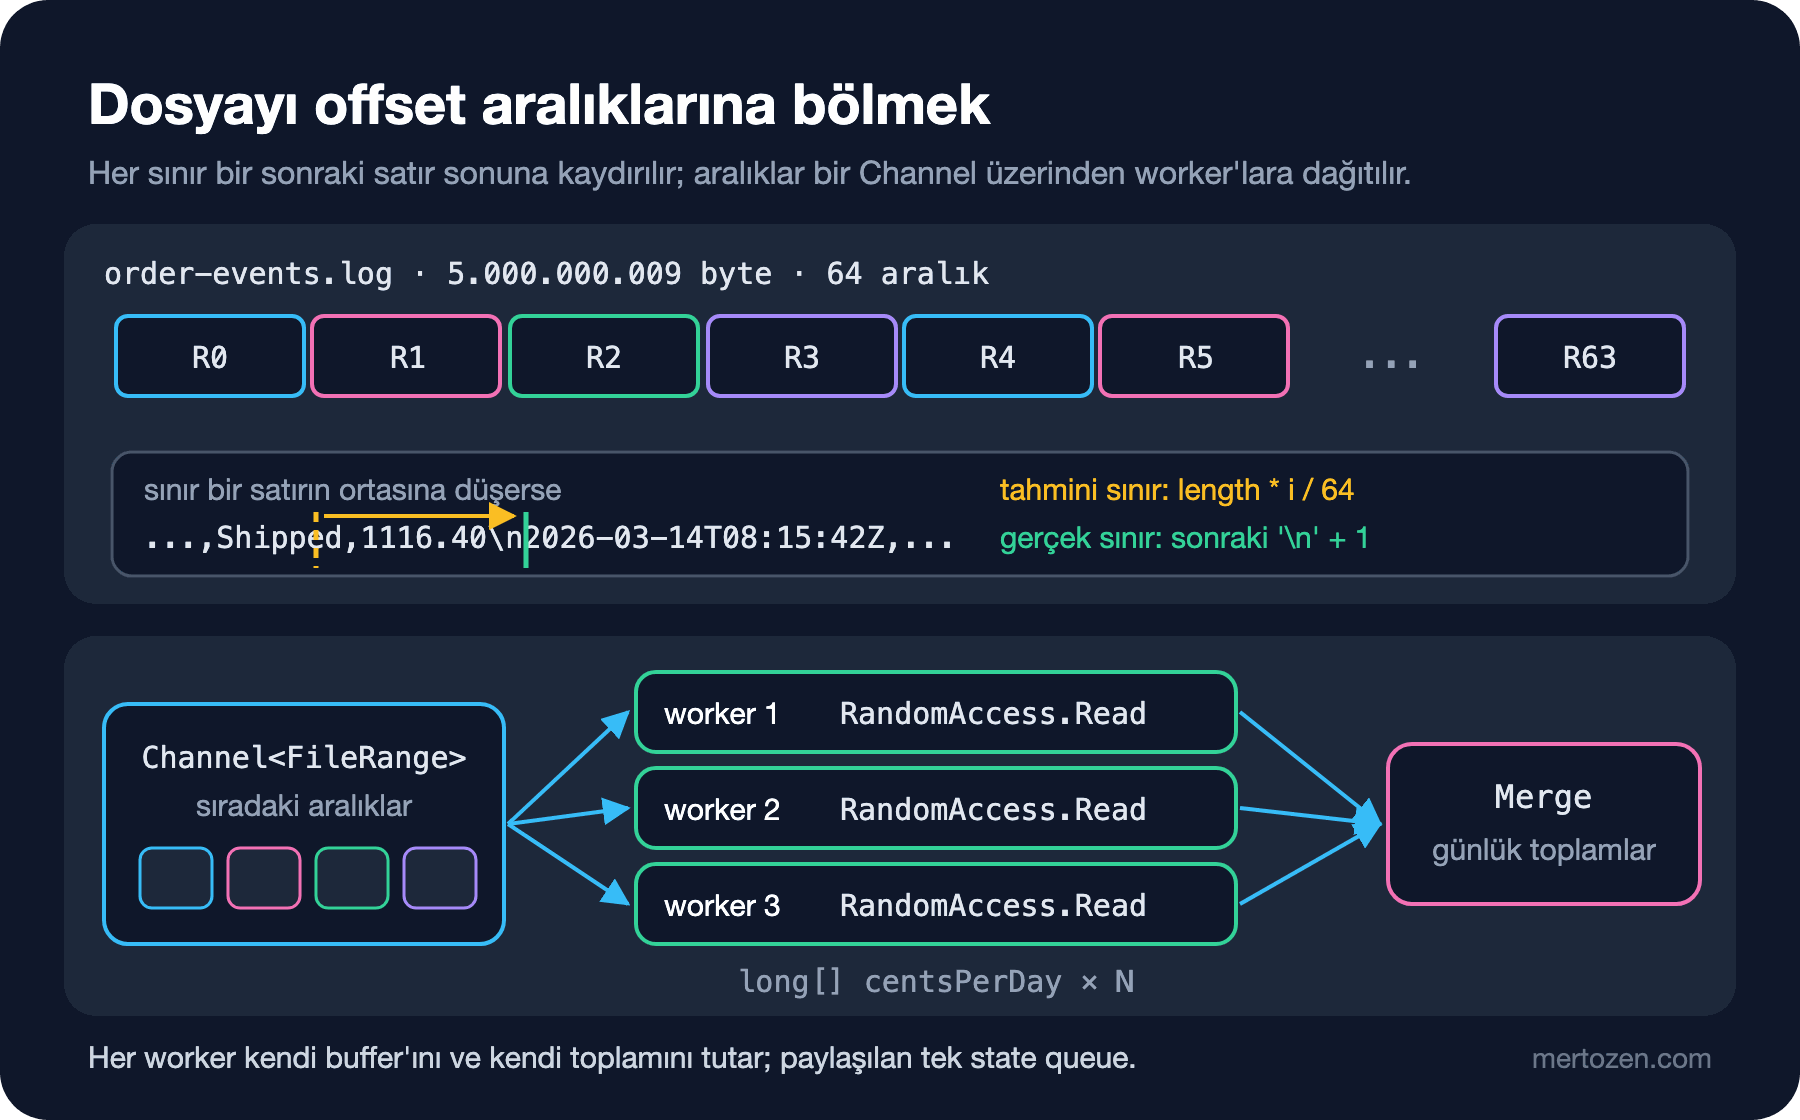
Tek thread saniyede 2 GB parse ediyor. Daha hızlı gitmek için dosyayı parçalara bölüp birden çok core'a dağıtabiliriz. Sorun şu: length * i / 64 gibi bir offset neredeyse her zaman bir satırın ortasına düşer. Çözüm, her tahmini sınırdan sonraki ilk \n'i bulup sınırı onun hemen arkasına kaydırmak:
public static IReadOnlyList<FileRange> Split(SafeFileHandle handle, int count)
{
    long length = RandomAccess.GetLength(handle);
    var boundaries = new List<long> { 0 };
    Span<byte> probe = stackalloc byte[256];
    for (int i = 1; i < count; i++)
    {
        long guess = length * i / count;
        int read = RandomAccess.Read(handle, probe, guess);
        int newline = probe[..read].IndexOf((byte)'\n');
        long boundary = guess + newline + 1;
        if (boundary > boundaries[^1]) boundaries.Add(boundary);
    }
    boundaries.Add(length);
    return [.. boundaries.Zip(boundaries.Skip(1), (start, end) => new FileRange(start, end))];
}
256 byte'lık prob, en uzun satırdan uzun olduğu sürece yeterli; satır uzunluğu bilinmeyen bir dosyada prob'u büyütmen ya da döngüyle okumaya devam etmen gerekir. Aralıkları worker sayısından fazla (64) tutup bir Channel'a koyuyoruz; her worker işi biten aralığın yerine queue'daki sıradaki aralığı alıyor. Böylece aralıklardan biri yavaş işlense bile diğer worker'lar boşta beklemez. Her worker serinin FileStream yazısında gördüğümüz RandomAccess.Read'i kullanıyor: offset tabanlı olduğu için worker'lar aynı handle'ı paylaşabilir, kimse Position'ı değiştirmez:
long[][] partials = await Task.WhenAll(Enumerable.Range(0, workers).Select(_ => Task.Run(async () =>
{
    var cents = new long[LineParser.Days];
    byte[] buffer = ArrayPool<byte>.Shared.Rent(1 << 20);
    try
    {
        await foreach (FileRange range in queue.Reader.ReadAllAsync())
        {
            long offset = range.Start;
            int carry = 0;
            while (offset < range.End)
            {
                int toRead = (int)Math.Min(buffer.Length - carry, range.End - offset);
                int read = RandomAccess.Read(handle, buffer.AsSpan(carry, toRead), offset);
                offset += read;
                int length = carry + read;
                int consumed = LineParser.AccumulateLines(buffer.AsSpan(0, length), cents);
                carry = length - consumed;
                buffer.AsSpan(consumed, carry).CopyTo(buffer);
            }
        }
    }
    finally
    {
        ArrayPool<byte>.Shared.Return(buffer);
    }
    return cents;
})));
Worker'lar arasında paylaşılan tek şey queue. Her worker kendi buffer'ını ve kendi long[]'ini tutuyor; sonuçlar en sonda toplanıyor. Lock yok, Interlocked yok. Channel'ın ayrıntıları C# Asenkron serisinin Channels yazısında.
MemoryMappedFile: Dosyayı Belleğe Map Etmek
Memory-mapped file, dosyanın içeriğini process'in sanal adres alanına yerleştirir: dosyanın 3 milyarıncı byte'ı, bir pointer'ın 3 milyar ilerisidir. Okuma bir system call ile yapılmaz; bir sayfaya ilk dokunduğunda işletim sistemi bir page fault (erişilen sayfanın bellekte olmadığını bildiren ve işletim sisteminin onu yüklemesini tetikleyen kesme) ile o sayfayı dosyadan getirir. Veri bir buffer'a kopyalanmaz, page cache'teki sayfaları doğrudan görürsün. İki türü var: diskteki bir dosyaya bağlı persisted map'ler (CreateFromFile) ve dosyası olmayan, process'ler arası paylaşılan bellek için kullanılan non-persisted map'ler (CreateNew). Okuma için iki tür view var: sıralı erişim için CreateViewStream, rastgele erişim için CreateViewAccessor. En hızlı yol accessor'ın pointer'ını alıp üzerine span kurmak:
using var map = MemoryMappedFile.CreateFromFile(path, FileMode.Open, mapName: null, capacity: 0, MemoryMappedFileAccess.Read);
using MemoryMappedViewAccessor view = map.CreateViewAccessor(0, 0, MemoryMappedFileAccess.Read);
byte* basePointer = null;
view.SafeMemoryMappedViewHandle.AcquirePointer(ref basePointer);
try
{
    byte* start = basePointer + view.PointerOffset;
    var partials = new long[ranges.Count][];
    Parallel.For(0, ranges.Count, new ParallelOptions { MaxDegreeOfParallelism = workers }, i =>
    {
        FileRange range = ranges[i];
        var cents = new long[LineParser.Days];
        var span = new ReadOnlySpan<byte>(start + range.Start, checked((int)(range.End - range.Start)));
        LineParser.AccumulateLines(span, cents);
        partials[i] = cents;
    });
    return Merge(partials);
}
finally
{
    view.SafeMemoryMappedViewHandle.ReleasePointer();
}
Kod unsafe, bu yüzden projede AllowUnsafeBlocks açık. Span'in uzunluğu int olduğu için tek bir span en fazla 2 GB'ı gösterebilir; 5 GB'lık dosyayı aralıklara bölmemiz bu sınırı da çözüyor. PointerOffset'i eklemeyi unutma: view, sayfa sınırına hizalandığı için istediğin offset'ten biraz önce başlayabilir. AcquirePointer'ı her zaman ReleasePointer ile kapat.
Ölçüm: Dört Yaklaşım
Dört yaklaşımı bir geliştirici makinesinde, ayrı process'lerde ve aynı 5 GB'lık dosya üzerinde çalıştırdık. Hepsi aynı sonucu verdi: 293 gün ve toplam 85.019.891.247,66 TRY (Türk lirasının uluslararası para kodu).
streamreader   14.45 s  allocated  35,461.7 MB  peak working set      54 MB  gen0  4445  gen2   0
chunked         2.47 s  allocated       1.0 MB  peak working set      43 MB  gen0     0  gen2   0
parallel x1     2.31 s  allocated       1.1 MB  peak working set      46 MB  gen0     0  gen2   0
parallel x2     0.95 s  allocated       2.1 MB  peak working set      47 MB  gen0     0  gen2   0
parallel x4     0.58 s  allocated       4.1 MB  peak working set      50 MB  gen0     1  gen2   1
parallel x8     0.58 s  allocated       8.1 MB  peak working set      54 MB  gen0     1  gen2   1
mmap x1         2.16 s  allocated       0.2 MB  peak working set   4,811 MB  gen0     0  gen2   0
mmap x2         0.94 s  allocated       0.2 MB  peak working set   4,727 MB  gen0     0  gen2   0
mmap x4         0.48 s  allocated       0.2 MB  peak working set   4,785 MB  gen0     0  gen2   0
mmap x8         0.37 s  allocated       0.2 MB  peak working set   4,701 MB  gen0     0  gen2   0
Önce bir uyarı: bu sayılar dosya işletim sisteminin page cache'indeyken alındı. Ölçümlerden önce dosyayı bir kez okuduk; 5 GB'ı 0,58 saniyede okumak saniyede 8,6 GB demek ve bu hız diskten değil, RAM'den geliyor. Dosya cache'te değilse ilk okumada diskin hızı belirleyici olur. Darboğazın disk mi CPU mu olduğunu anlamanın pratik yolu: aynı modu iki kez üst üste çalıştır. İlk ve ikinci koşu arasındaki fark diskin payıdır; ikinci koşu tek thread'de zaten yavaşsa iş CPU'dadır ve paralellik işe yarar. Tek thread saniyede 2 GB parse edebiliyorken diskin saniyede 500 MB okuyabildiği bir sunucuda 8 worker hiçbir şey kazandırmaz.
Üçüncü sorunun cevabı tabloda: 8 worker, 4 worker kadar sürdü. Bu noktadan sonra darboğaz parse değil, büyük olasılıkla RandomAccess.Read'in her okumada veriyi page cache'ten bizim buffer'ımıza kopyalaması. Memory-mapped sürümde bu kopya yok ve 8 worker'da 0,37 saniyeye indi. Tek thread'de ise fark küçük: mmap x1 2,16, chunked 2,47 saniye.
İkinci sorunun cevabı son sütunda: memory-mapped sürümlerde working set 4,7 GB. Dokunulan her sayfa process'in working set'ine sayılıyor. Bunlar dosyadan geldiği için işletim sistemi bellek sıkışınca onları atabilir, bu yüzden "4,7 GB sızıntı" değil. Ama container'da çalışan bir job'da memory limit'i ve izleme alarmlarını ilgilendirir: aynı iş chunked ile 43 MB görünürken mmap ile 4,7 GB görünür ve kimse sebebini bilmezse alarm çalar.
Rastgele erişim: mmap'in asıl iyi olduğu yer
Tek geçişli sıralı okumada memory-mapped file'ın getirdiği fark sınırlı. Asıl kazancı aynı dosyanın farklı yerlerine tekrar tekrar gittiğin işlerde: bir index'ten kayıt bulmak, bir binary search, aynı veriyi birden çok kez taramak. Dosyanın rastgele yerlerinden bir milyon kez 64 byte okuduk:
randomaccess 1,000,000 random reads in 465 ms (465 ns/read), checksum 59100920
mmap         1,000,000 random reads in 187 ms (187 ns/read), checksum 59100920
RandomAccess.Read her okumada bir system call yapıyor; mmap'te sayfa bir kez belleğe geldikten sonra okuma sıradan bir bellek erişimi. Bu ölçümde 2,5 kat fark var ve dosya cache'te olmasaydı ikisi de diske gideceği için fark daralırdı.
Process'ler arası paylaşım ve sınırlar
Map'e bir ad verip (CreateNew("bookstore-orders", ...), OpenExisting) iki process'in aynı belleği görmesini sağlamak yalnız Windows'ta çalışıyor; Linux ve macOS'ta ad verilmiş map PlatformNotSupportedException: Named maps are not supported. ile reddediliyor. Bu platformlarda aynı diskteki dosyayı iki process'in ayrı ayrı CreateFromFile ile açması aynı sayfaları paylaşmalarını sağlar. 32-bit bir process'te adres alanı küçük olduğu için (Microsoft'un dokümantasyonu map için kullanılabilir alanı 2 GB olarak veriyor) 5 GB'lık bir dosyayı tek view ile açamazsın; parça parça view oluşturman gerekir. 64-bit'te bu sınır pratikte yok.
Üretimde Dikkat
Önce ölç, sonra paralelleştir. Tek thread'li byte parser çoğu durumda yeterli: 5 GB 2,5 saniyede. Paralellik ancak CPU darboğazsa ve disk o hızı verebiliyorsa işe yarar; diski darboğaz olan bir sunucuda yalnız karmaşıklık ekler.
Ara toplamları worker'a özel tut. Paylaşılan bir Dictionary'ye lock ile yazmak, paralelliğin bütün kazancını lock'a harcar. Her worker kendi sonucunu üretsin, en sonda birleştir.
Formatı doğrula. Hızlı parser'lar formatı varsayar. Satır sayısını, toplam byte'ı ya da bir checksum'ı dosyanın sonundaki bir özet satırıyla karşılaştırmak, bozuk ya da yarım kalmış bir dosyayı yanlış raporlamadan yakalar.
Memory-mapped dosyanın değişmeyeceğinden emin ol. Başka bir process dosyayı sen okurken kısaltırsa, map'in artık dosyada olmayan bir sayfasına erişmek Linux'ta process'i sinyalle sonlandırabilir. Yalnız yazımı bitmiş, değişmeyecek dosyaları map et; log'un hâlâ yazılan son parçasını değil.
Working set'i doğru oku. mmap kullanan bir service'in working set'i dosya sayfalarını da içerir. İzleme panelinde GC heap'ini ve working set'i ayrı göster.
Sık Düşülen Tuzaklar
File.ReadAllLines ya da ReadAllText ile büyük dosya açmak. 5 GB'lık bir dosya UTF-16 string olarak 10 GB'ın üstüne çıkar; process ya OutOfMemoryException alır ya da makineyi swap'e sokar.
"Bellek sabit" diye allocation'ı görmezden gelmek. File.ReadLines working set'i sabit tuttu ama 35 GB allocation yaptı. GC'nin yaptığı iş CPU süresidir.
Büyük buffer'ı her seferinde yeniden ayırmak. 85.000 byte üstü her array LOH'a düşer; döngü içinde new byte[1 MB] gen2 toplamalarını tetikler. ArrayPool kullan, finally'de geri ver.
Parçalara bölerken satır sınırını unutmak. Ortadan bölünen bir satır iki worker'da da hatalı parse edilir ya da hiç sayılmaz. Sınırı bir sonraki satır sonuna hizala ve toplam satır sayısını tek thread'li sonuçla karşılaştırarak test et.
mmap'in her durumda hızlı olduğunu varsaymak. Tek geçişli sıralı okumada fark küçüktü; asıl kazanç rastgele ve tekrar eden erişimde. Kendi iş yükünle ölç.
Küçük Bir Deneme
★☆☆ chunked modunu 64 KB, 1 MB ve 16 MB buffer ile çalıştır. Süre nerede doyuma ulaşıyor? 16 MB'lık buffer'ı ArrayPool<byte>.Shared'den kiralamak hâlâ havuzdan mı geliyor?
★★☆ LineParser'a doğrulama ekle: tutarın tam iki ondalıklı olduğunu ve tarihin geçerli olduğunu kontrol et, bozuk satırları say. Log'a elle üç bozuk satır ekleyip parallel ve chunked modlarının aynı hata sayısını verdiğini doğrula. Doğrulama süreyi ne kadar uzatıyor?
★★★ Günlük ciroya ek olarak müşteri bazında ilk 10'u çıkar (bu log'da müşteri yok; sipariş numarasının son hanesini müşteri gibi kullanabilirsin). Worker'a özel sonuçları birleştirirken neyi değiştirmen gerekti? ConcurrentDictionary ile tek paylaşılan sözlük kullanan bir sürümle süreyi karşılaştır.
Böylece serinin .NET 10 bloğunu bitirdik: stream'ler, dosyalar, Pipelines, JSON, XML, CSV (Comma-Separated Values; değerleri ayırıcıyla sıralayan düz metin formatı), arşivler ve büyük dosyalar. Bir sonraki yazıda geriye dönüp bakıyoruz: .NET 6'dan .NET 10'a I/O ve serialization'da neler değişti, her madde için kısa bir önce ve sonra örneğiyle.