

Performance Testing Türleri ve Hedefler: Load, Stress, Spike, Soak, Breakpoint ve SLO'dan Kabul Kriterine
Her performance test türü ayrı bir soruya cevap verir: smoke script'in çalıştığını, average load normal günü, stress zirveyi, spike ani sıçramayı, soak saatler sonrasını, breakpoint kapasite sınırını gösterir. Kabul kriterini SLO'dan yük, süre ve sınırlarla türetiyor, Little's Law ile sanal kullanıcı sayısını hesaplıyor ve Bookstore üzerinde closed model'in yavaşlayan sistemde yükü kendiliğinden azaltıp sorunu gizlediğini gerçek k6 koşularıyla gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ile derlenip denenmiştir; yük testleri k6 2.4.0 ile, Bookstore.Api ve SQL Server 2025 Docker Compose üzerinde çalıştırılmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) kampanya haftasına hazırlanıyor. Ekipten Emre, kitap detayı endpoint'ine k6 ile 500 VU (virtual user; k6'nın script'i kendi döngüsünde tekrar tekrar koşan sanal kullanıcısı) veriyor; her kullanıcı cevabı alınca ortalama bir saniye düşünüp yeni bir kitaba bakıyor. Rapor şöyle: "500 kullanıcıda hata yok, p95 944 ms." Ayşe aynı API'yi, aynı makinede, saniyede 500 yeni istek gelecek şekilde test ediyor. Sence onun raporu Emre'ninkinden daha iyi mi çıkar, daha kötü mü, yoksa aynı mı?
İkinci soru: API sağlıklıyken, saniyede 500 isteği karşılamak için k6'nın kaç sanal kullanıcı açması gerekir? 500 mü, 50 mi, daha az mı? İki sorunun cevabı da bu yazıda gerçek koşularla geliyor. Ama önce performance testing'in hangi sorulara cevap verdiğini netleştirelim, çünkü yanlış soruya verilen doğru sayı da yanıltır.
Her Test Türü Bir Soruya Cevap Verir
Functional testler "doğru mu çalışıyor?" diye sorar. Test türlerinin genel haritası Test Stratejisi serisinin ilk yazısında ("Neden Test Yazarız?"). Performance testing'in sorusu ise başka: bu yükte, bu sürede ve bu hata oranıyla çalışıyor mu? "Load test yaptık" demek tek başına bir şey anlatmaz. Hangi yükte, ne kadar süre ve neyi görmek için yapıldığı söylenmelidir. Bu yüzden türleri yük profiline göre ayırıyoruz:
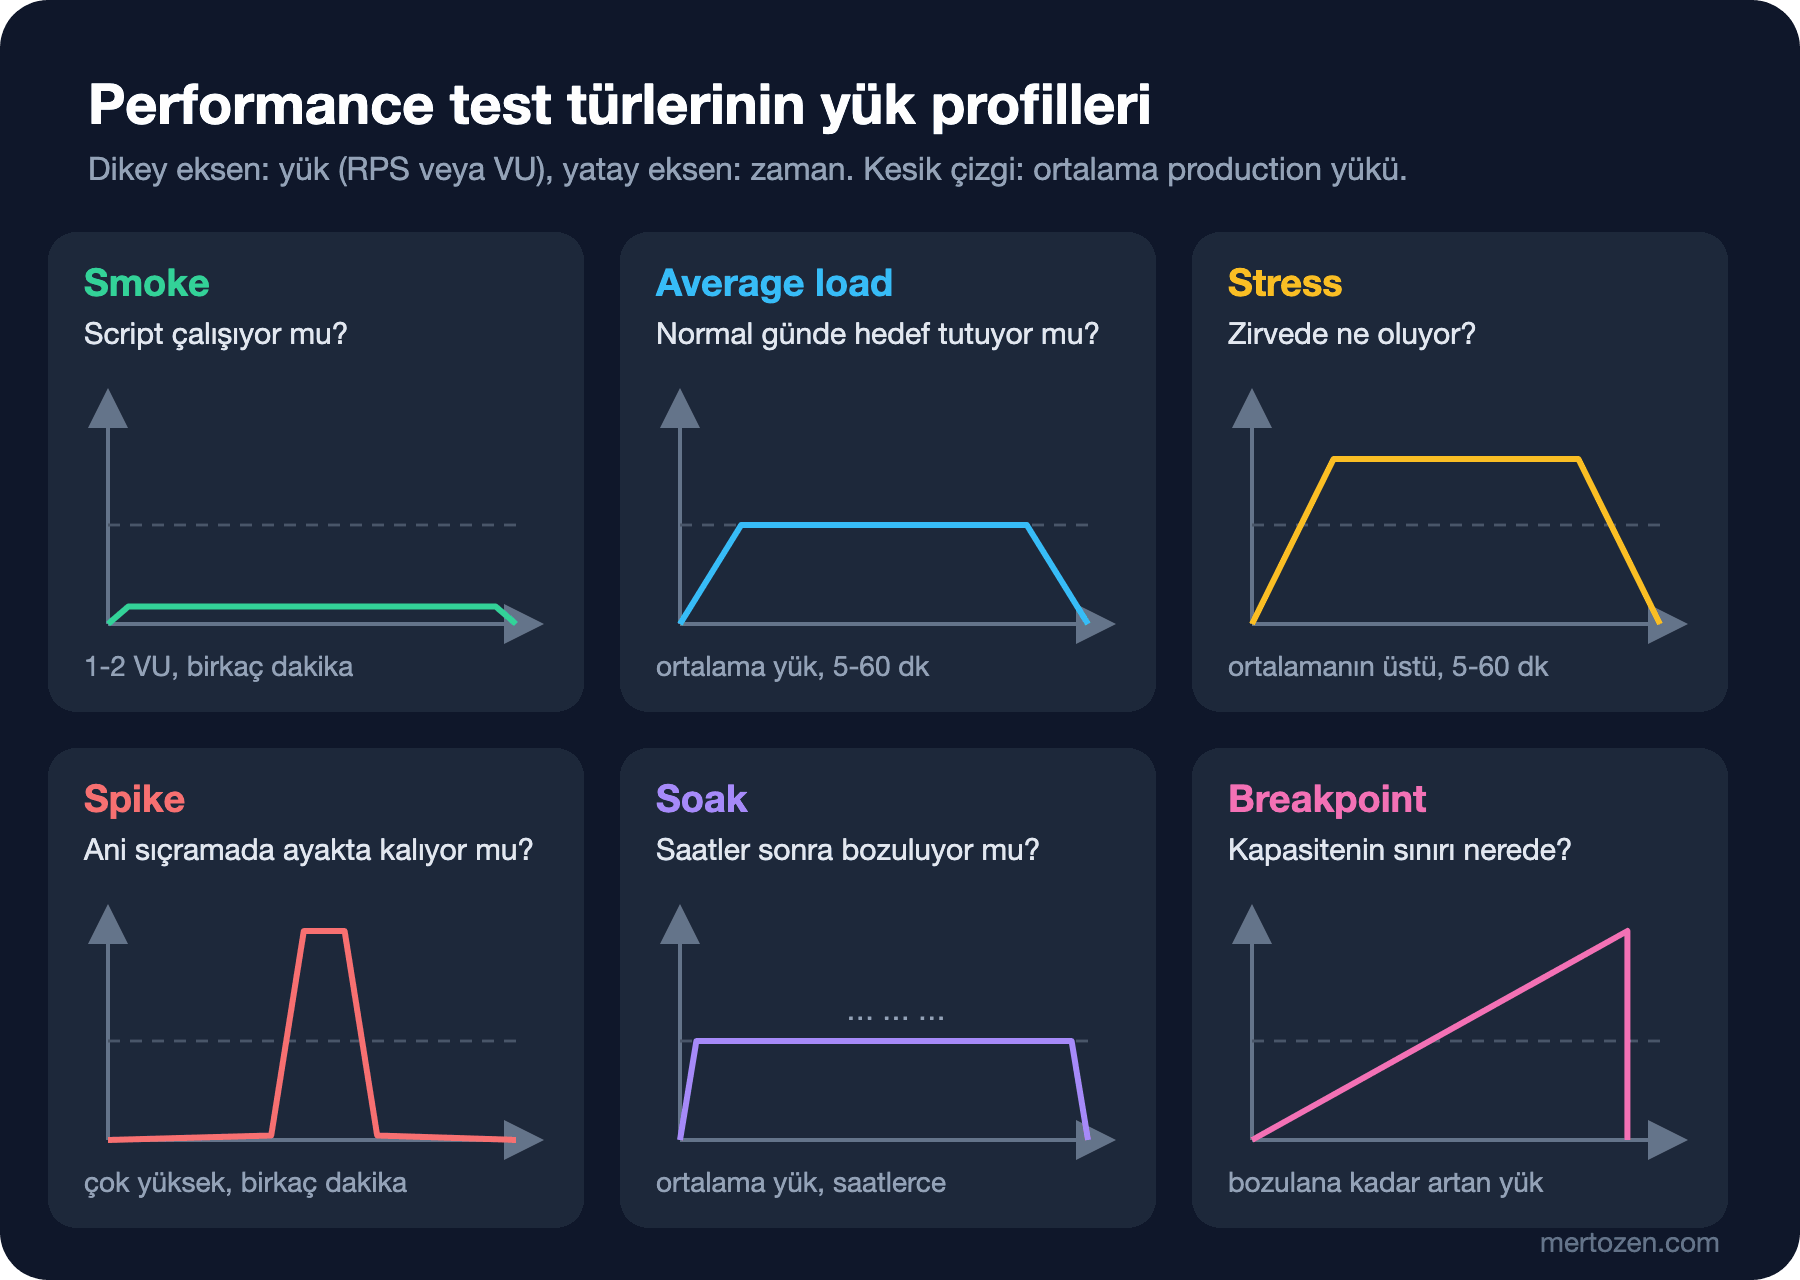
Smoke test, script'in ve ortamın çalışıp çalışmadığını sorar: bir iki sanal kullanıcı, birkaç iterasyon. Amaç ölçmek değil; URL yanlış mı, test verisi yüklenmiş mi, token alınabiliyor mu, onu görmek. Uzun bir testi başlatmadan önce her zaman koşulur ve her pull request'te (PR) koşacak kadar ucuzdur. Bookstore için ilk script'imiz bu:
import http from 'k6/http';
import { check, group, sleep } from 'k6';

// Smoke test: 1 VU, birkaç iterasyon. Soru: script ve sistem çalışıyor mu?
const BASE_URL = __ENV.BASE_URL || 'http://localhost:5080';

export const options = {
    vus: 1,
    iterations: 10,
    thresholds: {
        http_req_failed: ['rate==0'],
        checks: ['rate==1'],
    },
};

export default function () {
    let isbn;
    group('browse', () => {
        const list = http.get(`${BASE_URL}/api/books?pageSize=12`);
        check(list, { 'list is 200': (r) => r.status === 200 });
        isbn = list.json('items.0.isbn');
        const book = http.get(`${BASE_URL}/api/books/${isbn}`, { tags: { name: 'GET /api/books/{isbn}' } });
        check(book, { 'book is 200': (r) => r.status === 200 });
    });
    group('checkout', () => {
        const cart = http.post(`${BASE_URL}/api/carts`, null);
        check(cart, { 'cart is 201': (r) => r.status === 201 });
        const cartId = cart.json('id');
        const params = { headers: { 'Content-Type': 'application/json' } };
        const item = http.put(`${BASE_URL}/api/carts/${cartId}/items/${isbn}`, JSON.stringify({ quantity: 1 }),
            { ...params, tags: { name: 'PUT /api/carts/{id}/items/{isbn}' } });
        check(item, { 'item is 200': (r) => r.status === 200 });
        const order = http.post(`${BASE_URL}/api/orders`,
            JSON.stringify({ cartId, customerName: 'Ada Lovelace', customerEmail: 'ada@example.com' }), params);
        check(order, { 'order is 201': (r) => r.status === 201 });
    });
    sleep(1);
}
█ THRESHOLDS
checks
✓ 'rate==1' rate=100.00%
http_req_failed
✓ 'rate==0' rate=0.00%
█ TOTAL RESULTS
checks_total.......: 50 4.707097/s
checks_succeeded...: 100.00% 50 out of 50
...
http_req_duration..............: avg=11.92ms min=1.77ms med=7.85ms max=80.48ms p(90)=11.28ms p(95)=53.63msSmoke'un süre değerlerine bakıp karar verme: 50 istekte p95, birkaç yavaş istekle oynar. Smoke'tan beklenen tek cevap "evet, çalışıyor".
Average load test, normal bir günde hedeflerin tutup tutmadığını sorar: production'daki ortalama yükü 5-60 dakika verirsin. Stress test aynı soruyu zirve için sorar: kampanya akşamındaki gibi ortalamanın iki üç katı. Spike test yükün saniyeler içinde sıçradığı anı dener, örneğin bir push bildirimi ya da televizyon reklamı sonrası. Burada asıl görmek istediğin autoscaling'in, connection pool'un ve queue'ların ani yüke nasıl tepki verdiği ve yük inince sistemin toparlanıp toparlanmadığı. Soak test ortalama yükü saatlerce verir; kısa testte görünmeyen sorunları arar: memory leak, connection pool'un yavaş yavaş tükenmesi, dolan disk, süresi dolan token. Memory leak'in heap üzerinde nasıl bulunacağı ".NET'te Profiling ve Diagnostics" serisinin "Memory Leak Avı: dotnet-gcdump, Heap Snapshot Karşılaştırma ve Yaygın Leak Pattern'leri" yazısında. Breakpoint test ise yükü sistem bozulana kadar artırır ve kapasitenin sınırını bulur. Bu sınırı doğru okumak için gereken throughput-latency eğrisini 06'da çiziyoruz. Bir VU'nun gerçek bir kullanıcıya denk olup olmadığı ise, birazdan göreceğimiz gibi, workload model'e bağlı.
| Tür | Cevapladığı soru | Yük ve süre | Ne zaman |
|---|---|---|---|
| Smoke | Script ve ortam çalışıyor mu? | 1-2 VU, dakikalar | Her PR'da, her testten önce |
| Average load | Normal günde hedefler tutuyor mu? | Ortalama yük, 5-60 dk | Kısa sürümü PR'da, tamamı nightly |
| Stress | Zirvede ne oluyor? | Ortalamanın 2-3 katı, 5-60 dk | Kampanya ve büyük release öncesi |
| Spike | Ani sıçramada ayakta kalıyor ve toparlanıyor mu? | Çok yüksek, birkaç dakika | Planlı, autoscaling değişince |
| Soak | Saatler sonra bozuluyor mu? | Ortalama yük, saatlerce | Haftalık ya da release öncesi |
| Breakpoint | Kapasitenin sınırı nerede? | Bozulana kadar artan yük | Seyrek, mimari değişince |
Kabul Kriterini SLO'dan Türetmek
"Hızlı olsun" kabul kriteri değildir. Kriterin kaynağı ürünün zaten taahhüt ettiği hedef olmalı: SLO (Service Level Objective; servisin belirli bir süre boyunca tutturmayı hedeflediği ölçülebilir seviye). Bookstore'un katalog için SLO'su şu olsun: kitap detayı isteklerinin yüzde 95'i 300 ms'nin altında ve hatalı cevap oranı yüzde 0,5'in altında. SLO'nun nasıl seçildiği ve error budget'ın nasıl hesaplandığı ilerideki SRE (Site Reliability Engineering; servis güvenilirliğini mühendislik yöntemleriyle yönetme yaklaşımı) ve Production Incident'ları serisinin "SLO ve Error Budget: Hedef Belirlemek, Nine'ların Matematiği ve Error Budget Policy" yazısının konusu. Bize lazım olan şu: SLO bir yük söylemez. "p95 300 ms altında" cümlesi, saniyede 5 istekte de 5.000 istekte de aynı cümledir.
Bu yüzden kabul kriteri üç parçalıdır: hangi yükte (RPS, yani saniyedeki istek sayısı, ve trafik karışımı), ne kadar süre ve hangi sınırlar. Yük tahmini kapasite hesabından gelir. Günlük ziyaretçiden saniyedeki isteğe nasıl gidildiği System Design serisinin "Back-of-the-Envelope Estimation" yazısında. Bookstore için kampanya haftası tahmini kitap detayında saniyede 200 istek olsun. Kriter şöyle yazılır: "Saniyede 200 istekte, 10 dakika boyunca, kitap detayının p95'i 300 ms'nin altında ve hata oranı yüzde 0,5'in altında." k6'da bu cümlenin son kısmı threshold olur:
export const options = {
    scenarios: { [MODEL]: scenarios[MODEL] },
    // SLO'dan türeyen kabul kriteri: p95 300 ms altında, hata yüzde 0,5 altında.
    thresholds: {
        http_req_duration: ['p(95)<300'],
        http_req_failed: ['rate<0.005'],
    },
};
Threshold aşılırsa k6 testi başarısız sayar ve 99 exit code'u ile çıkar; CI'da gate olarak kullanacağımız davranış bu (04). Yük ve süre ise scenario'da durur. Bir de şunu unutma: SLO production'da haftalar boyunca ölçülür, load test ise tek bir koşulda tek bir koşudur. Testi geçmek SLO'yu tutacağının kanıtı değildir. Söylediği şey, bu yükte ve bu ortamda hedefle çelişen bir şey görmediğimizdir. Testte hedefe sınırdan geçiyorsan production'da error budget'ı ilk yoğun günde harcarsın; bu yüzden test sınırlarını SLO'dan biraz sıkı tutmak yaygın bir tercih.
Little's Law: Kaç Sanal Kullanıcı Gerekir?
Yükü "saniyede 200 istek" diye tanımladık ama k6'ya genellikle sanal kullanıcı sayısı söylenir. İkisini bağlayan kural kuyruk teorisinden gelir: Little's Law (John Little'ın 1961'de ispatladığı L = λW eşitliği). Kararlı çalışan bir sistemde, içeride aynı anda bulunan iş sayısı (L), birim zamanda gelen iş sayısı (λ) ile bir işin içeride geçirdiği ortalama sürenin (W) çarpımına eşittir. Load test diline çevirirsek: eşzamanlı kullanıcı = throughput × bir iterasyonun süresi.
Bir kullanıcı istek atıyor, cevabı yaklaşık 50 ms'de alıyor ve bir saniye düşünüyorsa, bir iterasyon 1,05 saniye sürer. Saniyede 200 istek için 200 × 1,05 = 210 sanal kullanıcı gerekir. Hesabı gerçek koşuyla kontrol ettim: 500 sanal kullanıcı, her biri cevaptan sonra 0,5 ile 1,5 saniye arasında rastgele bekliyor. k6'nın ölçtüğü ortalama iterasyon süresi 1 saniye, throughput saniyede 491 istek; formülün beklediği 500/1 = 500'e çok yakın. Aradaki küçük fark, test başlarken kullanıcıların aynı anda devreye girmesinden geliyor.
Tahmin sorusunun ikinci cevabı da buradan çıkıyor. Kullanıcılar düşünmeden, saniyede 500 istek sabit hızla gelirse ve sağlıklı API bir isteği ortalama 1,4 ms'de cevaplarsa, içeride aynı anda bulunan istek sayısı 500 × 0,0014 = 0,7 olur. k6 da tam bunu gösterdi: 500 RPS'lik testte en fazla 1 VU kullandı. Sanal kullanıcı sayısı bir girdi değil, sonuç: throughput ile sürenin çarpımı. Sistem yavaşladığında aynı throughput için daha çok eşzamanlı kullanıcı gerekir. Bir sonraki bölümün konusu tam olarak bu.
Closed ve Open Workload Model
Yükü iki şekilde tanımlayabilirsin. Closed model'de sabit sayıda kullanıcı vardır; her biri cevabı bekler, düşünür, sonra yeni isteğini atar. Yeni istek ancak önceki bitince gelir. Open model'de ise istekler sistemden bağımsız bir hızla gelir: saniyede 500 kişi siteye girer, sunucu yavaş diye dışarıda kimse beklemez. k6'da closed model constant-vus ve ramping-vus gibi VU tabanlı executor'larla, open model constant-arrival-rate ve ramping-arrival-rate ile kurulur. İkisini aynı script'te karşılaştırdım:
const scenarios = {
    closed: {
        executor: 'constant-vus',
        vus: Number(__ENV.VUS || 200),
        duration: DURATION,
    },
    open: {
        executor: 'constant-arrival-rate',
        rate: Number(__ENV.RATE || 200),
        timeUnit: '1s',
        duration: DURATION,
        preAllocatedVUs: 50,
        maxVUs: Number(__ENV.MAX_VUS || 1000),
    },
};

export function setup() {
    const res = http.get(`${BASE_URL}/api/books?pageSize=50`);
    return { isbns: res.json('items').map((b) => b.isbn) };
}

export default function (data) {
    const isbn = data.isbns[Math.floor(Math.random() * data.isbns.length)];
    const res = http.get(`${BASE_URL}/api/books/${isbn}`, { tags: { name: 'GET /api/books/{isbn}' } });
    check(res, { 'status is 200': (r) => r.status === 200 });
    if (MODEL === 'closed') {
        // Closed model: kullanıcı cevabı bekler, 0,5-1,5 x THINK saniye düşünür, sonra yeni isteği atar.
        sleep(THINK_TIME * (0.5 + Math.random()));
    }
}
Bookstore.Api Release build olarak, 2 CPU ve 1 GB bellek sınırıyla container'da çalışıyor. Önce sağlıklı hâliyle iki modeli birer dakika koşturdum, sonra container'ın CPU sınırını 0,25'e indirip, yani sistemi bilerek yavaşlatıp aynı iki testi tekrarladım:
k6 run -e MODEL=closed -e VUS=500 models.js
k6 run -e MODEL=open -e RATE=500 models.js

docker update --cpus 0.25 $(docker compose ps -q api)
k6 run -e MODEL=closed -e VUS=500 models.js
k6 run -e MODEL=open -e RATE=500 models.js| Koşu | Throughput | p50 | p95 | dropped_iterations | En fazla VU |
|---|---|---|---|---|---|
| Sağlıklı, closed (500 VU) | 491/sn | 1,18 ms | 2,97 ms | yok | 500 |
| Sağlıklı, open (500/sn) | 500/sn | 1,16 ms | 2,14 ms | 0 | 1 |
| Yavaş, closed (500 VU) | 406/sn | 47 ms | 944 ms | yok | 500 |
| Yavaş, open (500/sn) | 479/sn | 16 ms | 1,51 s | 834 | 827 |
Sistem sağlıklıyken iki model aynı şeyi söylüyor. Fark sistem yavaşlayınca çıkıyor. Closed testte sistem yavaşladıkça kullanıcılar cevabı daha uzun bekledi, ortalama iterasyon 1,21 saniyeye çıktı ve k6 kendiliğinden daha az istek gönderdi: 500/1,21 = 413, ölçülen 406. Yani "500 kullanıcıyla test ettik" diyen rapor, sunucunun aslında yüzde 17 daha az yük gördüğünü söylemiyor. Yük, sorunun büyüklüğüyle orantılı olarak kendini azalttı ve p95 944 ms'de kaldı.
Open testte gelen hız sabit kaldı. Cevaplar geciktikçe aynı anda içeride bekleyen istek sayısı büyüdü; k6 bunlar için 827 VU açtı ve 834 iterasyonu hiç başlatamadı (dropped_iterations). p95 1,51 saniye. Ayşe'nin raporu daha kötü çıktı, çünkü gerçeğe daha yakın: kampanya akşamında siteye girenler API yavaş diye gelmeyi ertelemez. İlk tahmin sorusunun cevabı bu. Aynı koşudaki threshold sonucu da şöyle görünüyor:
  █ THRESHOLDS

    http_req_duration
    ✗ 'p(95)<300' p(95)=1.51s

    http_req_failed
    ✓ 'rate<0.005' rate=0.00%
...
    dropped_iterations.............: 834    13.699946/s
    vus............................: 827    min=0          max=827
    vus_max........................: 876    min=50         max=876
level=error msg="thresholds on metrics 'http_req_duration' have been crossed"
Closed model'in yerini bilmek de gerekiyor. Kullanıcı sayısının gerçekten sabit olduğu sistemlerde doğru model odur: 50 kişilik bir çağrı merkezinin kullandığı iç uygulama, sabit sayıda worker'ı olan bir batch işi, bağlantı havuzu sınırlı bir istemci. Bookstore'un katalog ve checkout trafiği gibi dışarıdan gelen trafikte ise open model kullan. Closed model'in yavaşlamayı ölçümden saklaması literatürde coordinated omission olarak da anılır; percentile'lara etkisini 06'da ayrıntılı ölçüyoruz.
Test Ortamı: Production'a Ne Kadar Benzemeli?
Sonucu production için anlamlı kılan şey ortamdır. Bookstore'un load test ortamı iki container'lık bir Compose dosyası: SQL Server ve Release build edilmiş API. API'nin CPU ve bellek sınırı production'daki container'la aynı tutulur. Sınırsız bir container'da alınan sonuç, iki CPU'lu pod hakkında bir şey söylemez:
  api:
    build:
      context: .
      dockerfile: src/Bookstore.Api/Dockerfile
    environment:
      ConnectionStrings__BookstoreDb: "Server=sql;Database=BookstoreDb;User Id=sa;Password=${SA_PASSWORD};TrustServerCertificate=True"
      Database__MigrateOnStartup: "true"
      ASPNETCORE_HTTP_PORTS: "8080"
    ports:
      - "${API_PORT:-5080}:8080"
    depends_on:
      sql:
        condition: service_healthy
    cpus: ${API_CPUS:-2}
    mem_limit: 1g
# PowerShell
$env:SA_PASSWORD = "<strong-password>"
docker compose up -d --build
k6 run load/k6/smoke.jsBu yazıdaki sayılar tek bir makinede, k6 ile API aynı donanımı paylaşırken alındı. Mutlak değerler makineye özel; senin makinende farklı çıkar. Taşınabilir olan oranlar ve davranış: closed model'in yükü kendiliğinden azaltması, open model'de kuyruğun büyümesi. Production'a benzerlikte dört şeye bak: aynı build ve configuration (Debug build ya da açık bırakılmış Debug log seviyesi sonucu bozar), aynı kaynak sınırları, production'a yakın veri boyutu (bir sonraki yazının konusu) ve izolasyon. Paylaşılan bir test ortamında başka bir ekibin testi senin sonucunu bozar. Bu testlerin sırasında makinede başka container'lar da çalışıyordu; tekrarlanabilir sayı istiyorsan ortamı yalnız kullan ya da en azından testi birkaç kez tekrarla.
Bir kural daha: sahibi olmadığın bir sisteme izinsiz yük gönderme. Bookstore'un ödeme sağlayıcısı, e-posta servisi, CDN'i (Content Delivery Network; içeriği kullanıcıya yakın sunuculardan dağıtan ağ) ya da bir partner API'si senin test ortamın değil. Onların sandbox ortamları da yük testi için değil, entegrasyon testi için. Bu bağımlılıkları stub ile değiştirmeyi 02'de yapıyoruz. Bulutta çalışan kendi sistemine yük verirken de sağlayıcının kullanım koşullarını kontrol et; bazı sağlayıcılar belirli test türleri için önceden haber vermeni ister.
Üretimde Dikkat
Hangi testin ne zaman koşacağını baştan planla, yoksa ya hiç koşmazlar ya da her şey her PR'da koşar ve pipeline yavaşlar. İşe yarayan bir düzen: smoke ve bir iki dakikalık average load her PR'da; tam average load nightly; stress ve spike kampanya ve büyük release öncesi; soak haftalık; breakpoint mimari değiştiğinde. Sonuçları saklamak ve karşılaştırmak için JSON çıktısını kullanmayı 03'te, CI entegrasyonunu 04'te kuruyoruz.
Production'da load test mümkün ama ayrı bir karar. Gerçek kullanıcıyla aynı kaynakları paylaşırsın, test verisi gerçek raporlara karışabilir, ödeme ve e-posta gibi yan etkiler gerçek olur. Yapılacaksa düşük trafik saatinde, kademeli, durdurma kriteri tanımlanmış (örneğin hata oranı yüzde 1'i geçince abortOnFail) ve ilgili ekiplere haber verilmiş olmalı.
Son olarak yük üreten makineyi de izle. k6'nın kendisi CPU'yu doldurursa ölçtüğün gecikme, istemcinin isteği geç göndermesinden gelir. Bu tuzağı 03'te ayrıca ele alıyoruz.
Sık Düşülen Tuzaklar
- Yük söylemeden süre hedefi koymak: "p95 300 ms altında" kriterine hangi RPS'te ve hangi trafik karışımıyla bakılacağı yazılmalı.
- Dışarıdan gelen trafiği closed model ile test etmek: sistem yavaşladıkça yük kendiliğinden düşer ve sorun küçük görünür.
- Arrival-rate testinde
dropped_iterations'ı okumamak: başlatılamayan her iterasyon, sistemin karşılayamadığı bir kullanıcıdır. - VU sayısını kapasite sanmak: "1.000 kullanıcıyı kaldırıyor" cümlesi, think time ve iterasyon süresi bilinmeden bir şey söylemez.
- Kaynak sınırı olmayan bir ortamda ölçüp sonucu production'a taşımak.
- Smoke testin süre değerlerinden karar çıkarmak.
- Ödeme sağlayıcısı gibi üçüncü taraf bir sisteme, sandbox bile olsa, izinsiz yük göndermek.
Küçük Bir Deneme
★☆☆ Smoke testi çalıştır, sonra iterations'ı 10'dan 100'e çıkar. p95 nasıl değişti? Smoke'tan neden süre kararı çıkarılmaması gerektiğini kendi sayılarınla göster.
★★☆ models.js'te closed model'i THINK=0 ile (düşünme süresi olmadan) 20 VU ile koştur. Little's Law'a göre throughput, VU sayısının ortalama istek süresine bölümü olmalı. Ölçtüğün http_reqs ile hesabını karşılaştır.
★★★ API'nin CPU sınırını 0,5'e indir ve open model'de RATE'i 100'den başlayıp 100'er artırarak dropped_iterations'ın ilk görüldüğü hızı bul. Aynı sınırda closed model'de kaç VU ile aynı throughput'a ulaşıyorsun? İki sayıyı Little's Law ile bağla.
Bu yazıdaki testler hep tek bir endpoint'e ve 20 kitaplık bir kataloğa gitti; gerçek trafik böyle değil. Bir sonraki yazıda Bookstore'un trafik karışımını, think time'ı, 40.000 kitaplık test verisini, cache durumunu ve ödeme sağlayıcısını taklit eden stub'ı kurarak workload model'i gerçeğe yaklaştırıyoruz.