

Sonuçları Yorumlamak: Percentile'lar, Coordinated Omission, Throughput-Latency Eğrisi ve Bottleneck'i Bulmak
Load test sonucunu doğru okumak için ortalamaya değil percentile'lara bakmak, percentile'ları ortalamamak, coordinated omission'dan kaçınmak için open model kullanmak, kapasiteyi throughput-latency eğrisinin dirseğinde aramak ve darboğazı USE yöntemiyle bulmak gerekir. Bookstore API'sini 5 saniye dondurup closed modelin p99'u 8 ms, open modelin 4,2 saniye gösterdiğini ölçüyor, eğrinin çöküşünü connection pool ve SQL Server wait'lerine kadar izliyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ile derlenip denenmiştir; yük testleri k6 2.4.0 ile, Bookstore.Api ve SQL Server 2025 Docker Compose üzerinde çalıştırılmış, runtime ölçümleri dotnet-counters 10.0.750501 ile alınmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'un (bir online kitapçı) API'si kampanya akşamında 5 saniye donuyor; bir GC (garbage collector; kullanılmayan object'leri temizleyen runtime bileşeni) duraklaması, bir VM taşınması ya da bir log dosyasının diske yazılması olabilir. İki ekip aynı dakikayı ölçüyor. Birinin testinde 20 sanal kullanıcı cevap bekleyip yeni istek atıyor (closed model), diğerinde saniyede 200 istek sabit hızla geliyor (open model). Sence iki testin p99'u birbirine yakın mı çıkar? İkinci soru: k6'nın her 10 saniye için verdiği p99 değerlerinin ortalamasını alırsan bir dakikanın p99'unu bulur musun? Üçüncüsü: API'nin CPU'su yüzde 30'larda gezinirken sistem saniyede 125 isteğe düşüp 34 saniyelik p95 verebilir mi? Bu yazıda sayıları doğru okumayı gerçek ölçümlerle konuşuyoruz.
Ortalama Neden Yanıltır?
Yukarıdaki donma deneyinin open model sonucu şöyle: ortalama 180,5 ms, ortanca (p50) 0,47 ms, p95 1,54 saniye, en yavaş istek 5,13 saniye. Ortalama hiçbir isteği anlatmıyor. İsteklerin büyük çoğunluğu yarım milisaniyede dönüyor, 700 kadarı ise saniyeler sürüyor. Ortalama bu iki grubun arasında, kimsenin yaşamadığı bir yere düşüyor. Cevap süresi dağılımları neredeyse hiçbir zaman simetrik değildir: uzun bir sağ kuyrukları vardır ve kullanıcıyı rahatsız eden şey o kuyruktur.
Percentile, dağılımı bir noktadan okumanın yolu: p95 = 1,54 saniye, isteklerin yüzde 95'inin bu sürede ya da daha kısa sürede tamamlandığı anlamına gelir. p50 tipik isteği, p95 ve p99 kuyruğu, max ise tek bir isteği anlatır. Max'e tek başına güvenme; bir koşudan diğerine en çok oynayan sayıdır. Kuyruğun önemini sayfa başına istek sayısı artırır. Bir sayfa 20 API çağrısı yapıyorsa, her çağrının yüzde 1 olasılıkla yavaş olduğu bir sistemde sayfaların yaklaşık yüzde 18'inde en az bir yavaş çağrı olur (1 eksi 0,99'un 20. kuvveti, yaklaşık 0,18). p99 bu yüzden "100 kullanıcıdan birinin sorunu" değildir.
Percentile'ların Ortalaması Alınmaz
Aynı koşunun her 10 saniyesi için p99'u ayrı ayrı hesapladım:
open p99 per 10s: [1.3, 1.1, 1.6, 5057.6, 2.3, 2926.6, 1.2] avg= 1141.7 overall= 4230.6Pencerelerin p99'larının ortalaması 1.141,7 ms; bütün isteklerin gerçek p99'u 4.230,6 ms. Fark rastlantı değil. Percentile sıralamaya dayanır ve iki dağılımın p99'undan birleşik dağılımın p99'u hesaplanamaz. Dashboard'larda dakikalık p99'ları saatlik ortalamaya çevirmek ya da 04'teki iki runner pod'unun p95'lerinin ortalamasını almak aynı hatadır. Doğru yol dağılımın kendisini saklamak ve birleştirmektir. Histogram bunu yapar: değerleri bucket'lara sayar ve iki histogramın bucket'ları toplanabilir. HdrHistogram (High Dynamic Range Histogram; Gil Tene'nin geniş bir değer aralığını sabit hassasiyetle tutan histogram kütüphanesi) bu iş için yaygın kullanılan bir yapı. k6'nın OpenTelemetry output'unun gönderdiği histogram'lar da (04) aynı sebeple toplanabilir.
Coordinated Omission'ı Ölçmek
Coordinated omission terimi Gil Tene'ye ait. Kısaca şunu anlatır: closed bir yük üreticisi, sistem yavaşladığında yeni istek göndermeyi bekletir. Böylece yavaş anı yaşayacak olan istekler hiç gönderilmez, ölçümden düşer. Bunu 01'de throughput üzerinde görmüştük; burada percentile'lara etkisini ölçüyorum. Senaryo:
import http from 'k6/http';
import { check, sleep } from 'k6';

// Coordinated omission deneyi: aynı ~200 istek/sn önce closed, sonra open model olarak;
// testin ortasında API birkaç saniye donduruluyor (docker pause).
// Kullanım: k6 run -e MODEL=closed pause.js   |   k6 run -e MODEL=open pause.js
const BASE_URL = __ENV.BASE_URL || 'http://localhost:5080';
const MODEL = __ENV.MODEL || 'open';
const isbns = ['9780441172719', '9780261102217', '9780141439587', '9780451524935', '9780060850524'];

const scenarios = {
    // 20 kullanıcı, her biri cevaptan sonra 100 ms bekler: API hızlıyken ~200 istek/sn.
    closed: { executor: 'constant-vus', vus: 20, duration: '60s' },
    open: { executor: 'constant-arrival-rate', rate: 200, timeUnit: '1s', duration: '60s', preAllocatedVUs: 50, maxVUs: 2000 },
};

export const options = { scenarios: { [MODEL]: scenarios[MODEL] } };

export default function () {
    const isbn = isbns[Math.floor(Math.random() * isbns.length)];
    const res = http.get(`${BASE_URL}/api/books/${isbn}`, { tags: { name: 'GET /api/books/{isbn}' } });
    check(res, { 'book 200': (r) => r.status === 200 });
    if (MODEL === 'closed') {
        sleep(0.1);
    }
}
k6 run -e MODEL=closed pause.js
# test başladıktan 30 sn sonra, ikinci bir terminalde:
docker pause $(docker compose ps -q api); Start-Sleep 5; docker unpause $(docker compose ps -q api)== closed
http_req_duration..............: avg=10.76ms min=194µs med=1.14ms max=4.98s p(90)=2ms p(95)=2.65ms p(99)=8.1ms
http_reqs......................: 10717 178.428909/s
== open
http_req_duration..............: avg=180.54ms min=165µs med=468µs max=5.13s p(90)=1.69ms p(95)=1.54s p(99)=4.23s
http_reqs......................: 11510 191.82379/s
dropped_iterations.............: 491 8.182926/s| Ölçüm | İstek | 1 sn'den yavaş | p95 | p99 |
|---|---|---|---|---|
| Closed model | 10.717 | 20 | 2,65 ms | 8,1 ms |
| Closed model, düzeltilmiş | 11.597 | - | 1.763,6 ms | 4.428,4 ms |
| Open model | 11.510 | 702 | 1,54 s | 4,23 s |
İlk tahmin sorusunun cevabı: iki test aynı 5 saniyelik donmayı yaşadı, ama closed testin p99'u 8 ms, open testinki 4,2 saniye. Closed testte donma anında 20 kullanıcının 20 isteği bekledi; diğer kullanıcılar zaten cevap beklediği için yeni istek gelmedi. 10.717 isteğin yalnız 20'si yavaş, yani binde 2; p99'a bile girmiyor. Open testte ise donma süresince her saniye 200 istek gelmeye devam etti; 702 istek 1 saniyeden uzun sürdü. Gerçek kullanıcılar ikinci testteki gibi davranır.
Closed testin sonucunu düzeltmek mümkün. HdrHistogram'ın yaklaşımı şu: her sanal kullanıcı normalde 112 ms'de bir istek gönderiyordu (cevap süresi artı 100 ms bekleme). 4.980 ms süren bir istek, o sürede gönderilmesi gereken ama gönderilmeyen istekler olduğunu da söyler: 4.868 ms, 4.756 ms… diye 112 ms'lik adımlarla azalan sentetik değerler eklenir. Ben bu düzeltmeyi k6'nın CSV (virgülle ayrılmış düz metin) çıktısına küçük bir Python script'iyle uyguladım. Düzeltilmiş p99 4.428 ms çıktı; open testin 4.230 ms'sine çok yakın. k6 bu düzeltmeyi yapmaz. Doğru çözüm düzeltme değil, baştan open model kullanmak; düzeltme yalnızca elinde closed bir testin sonucu varsa ne kaçırdığını tahmin etmeye yarar.
Coordinated omission'ı fark etmenin yolları: closed testte throughput'un düşüp düşmediğine bak (178/sn ile 191/sn arasındaki fark burada kayıp istekler), max ile p99 arasındaki uçuruma bak (5 saniyelik max, 8 ms'lik p99 ile birlikte şüphelidir), ve sunucu tarafı metric'leri istemci tarafıyla karşılaştır. Bunun tersi de olur: sunucunun kendi histogram'ı isteği uygulamaya girdikten sonra ölçer; kuyrukta beklenen süre orada görünmez. Profiling serisinin "Diagnose, Fix, Prove" vakasında sunucunun p99'u 6 ms, k6'nınki 537 ms çıkmıştı.
Throughput-Latency Eğrisi ve Dirsek
Kapasitenin sınırını bulmanın yolu, gelen hızı basamak basamak artırıp her basamakta gerçekleşen throughput'u ve süreleri kaydetmek. 01'deki breakpoint testinin ölçülü hali bu:
const stages = [];
for (let i = 0; i < STEPS; i++) {
    const rate = START + i * STEP;
    stages.push({ target: rate, duration: '1s' });          // bir sonraki hıza geç
    stages.push({ target: rate, duration: STEP_DURATION }); // o hızda kal
}

export const options = {
    scenarios: {
        steps: {
            executor: 'ramping-arrival-rate',
            startRate: START,
            timeUnit: '1s',
            preAllocatedVUs: 50,
            maxVUs: 2000,
            stages,
        },
    },
};

export default function () {
    // Her isteğe farklı bir query string: output cache atlanır, her istek API'ye ve veritabanına ulaşır.
    const isbn = isbns[Math.floor(Math.random() * isbns.length)];
    const res = http.get(`${BASE_URL}/api/books/${isbn}?run=${__VU}-${__ITER}`, { tags: { name: 'GET /api/books/{isbn}' } });
    check(res, { 'book 200': (r) => r.status === 200 });
}
k6 run -e START=100 -e STEP=100 -e STEPS=10 -e STEP_DURATION=20s --out csv=steps.csv steps.jsAPI 0,5 CPU ile sınırlı; her isteğe farklı bir query string ekleyerek output cache'i bilerek devre dışı bıraktım, çünkü burada ölçmek istediğim origin'in kapasitesi. Her basamağın ilk 6 saniyesini atıp kalanını k6'nın CSV çıktısından hesapladım:
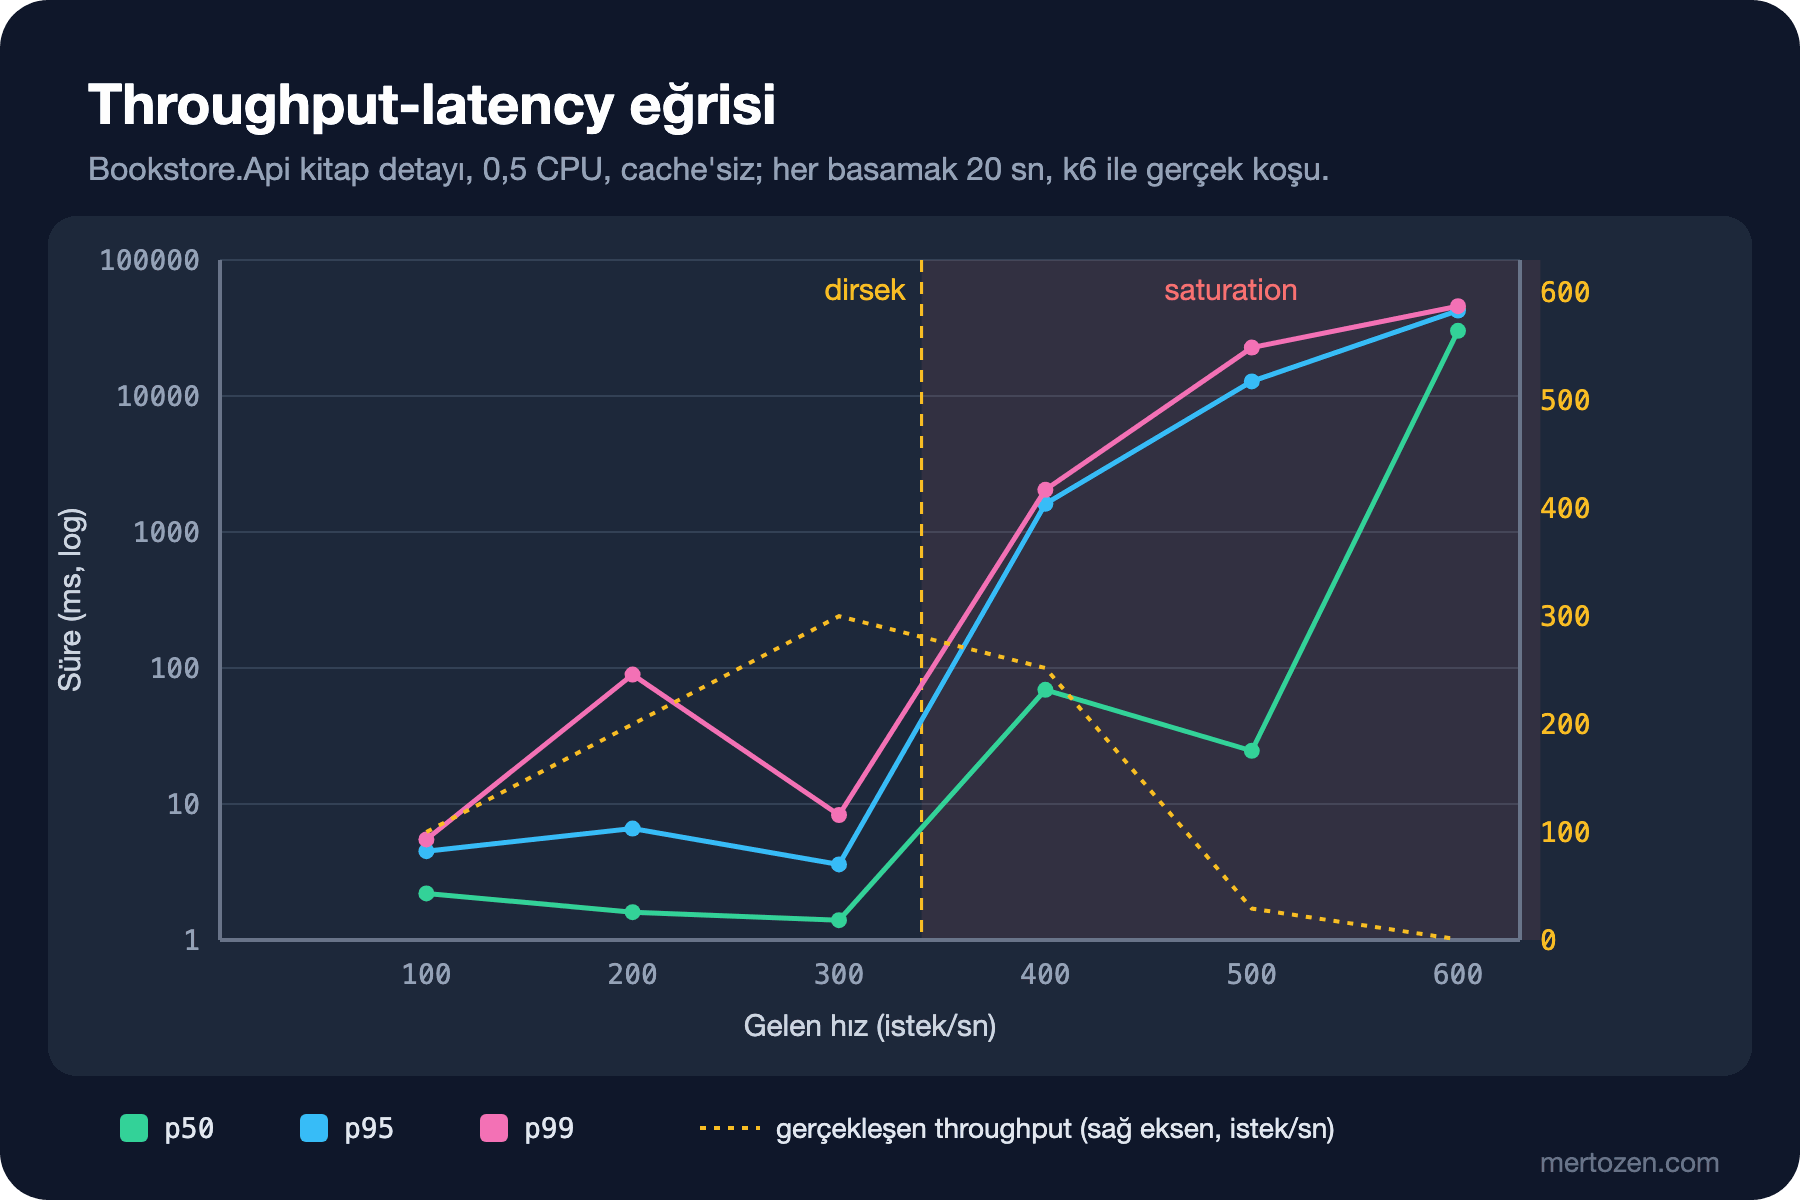
Eğrinin iki bölgesi var. Saniyede 300 isteğe kadar gerçekleşen throughput gelen hızı takip ediyor ve süreler düz: p50 1,4-2,2 ms, p95 4-7 ms. 200'deki 89 ms'lik p99 tek bir basamaktaki birkaç yavaş isteğin etkisi. 400'de tablo değişiyor: sistem saniyede yalnız 252 istek tamamlayabiliyor, 1.094 iterasyon başlatılamıyor, p95 1,6 saniyeye fırlıyor. 300 ile 400 arasındaki bu noktaya dirsek (knee) deniyor. Dirseğin ötesinde gelen hız kapasiteyi aştığı için kuyruk sınırsız büyür; Little's Law'a göre süre bekleyen iş sayısıyla birlikte artmaya devam eder. Bu koşuda daha kötüsü oldu: 500 ve 600'de throughput artmak yerine neredeyse sıfıra indi. Sistem yalnız yavaşlamadı, çöktü. Bunun sebebini bir sonraki bölümde buluyoruz.
Kapasite planı için okuma şu: production'da dirseğin altında, aradaki farkı ani yük için bırakarak çalış. Bu sistemde saniyede 300 istek sorunsuz, 400 değil; hedef yükü 200-250 civarında tutmak ve autoscaling'i bu seviyeye göre ayarlamak makul. Kapasite hesabının kendisi System Design serisinin "Back-of-the-Envelope Estimation" yazısında.
USE Yöntemiyle Darboğazı Bulmak
USE yöntemi (Utilization, Saturation, Errors; Brendan Gregg'in sistem kaynaklarını tek tek tarama yöntemi) her kaynak için üç soru sorar: ne kadar meşgul (utilization), iş bekliyor mu (saturation), hata var mı (errors). Kaynak listesi Bookstore için şöyle: API container'ının CPU'su, .NET thread pool, SqlClient connection pool'u ve SQL Server. Saniyede 400 isteklik yükü 40 saniye tekrar verip bu kaynakları aynı anda ölçtüm. Aşağıdaki çıktı, k6 özetinin, cgroup sayaçlarının, dotnet-counters CSV'sinin ve SQL Server wait istatistiklerinin (test öncesi ve sonrası sys.dm_os_wait_stats farkı) benim derlediğim hâli. API container'ını dotnet-counters içeren bir Docker target'ıyla başlattım (Dockerfile'daki diag aşaması):
$env:API_TARGET = "diag"; $env:API_CPUS = "0.5"
docker compose up -d --build api

docker compose exec api /tools/dotnet-counters collect -p 1 --refresh-interval 5 --format csv -o /tmp/c.csv `
    --duration 00:00:35 --counters System.Runtime,Microsoft.AspNetCore.Hosting,Microsoft.Data.SqlClient.EventSource
docker compose exec api cat /sys/fs/cgroup/cpu.stat
k6: target=400 rps=125 p50=1750.76 p95=34375.32 dropped=11279 vus=2000
cpu.stat: cpu=0.14 throttled=19%
time cpu active.req pool.in.use
14:11:24 0.20 1638 78
14:11:29 0.10 2000 81
14:11:34 0.08 2000 83
14:11:39 0.01 2000 86
14:11:44 0.02 2000 88
wait THREADPOOL 1420267 ms 7604 waits
wait RESOURCE_SEMAPHORE_QUERY_COMPILE 1961056 ms 776 waits
wait CMEMTHREAD 454818 ms 599 waits| Kaynak | Utilization | Saturation | Errors |
|---|---|---|---|
| API CPU (0,5 limit) | ortalama 0,14 CPU, zaman içinde 0,01'e iniyor | periyotların yüzde 19'unda throttle | yok |
| .NET thread pool | düşük | queue pratikte boş | yok |
| HTTP istekleri | - | 2.000 aktif istek (k6'nın tavanı) | timeout'lar |
| SqlClient connection pool | 100'lük havuzun 78-88'i kullanımda | bağlantı bekleyen istekler | "Timeout expired ... obtaining a connection from the pool" |
| SQL Server | container CPU'su yüksek | THREADPOOL ve RESOURCE_SEMAPHORE_QUERY_COMPILE wait'leri | - |
Üçüncü tahmin sorusunun cevabı tabloda. API'nin CPU'su boşta bekliyor; darboğaz API'de değil. İstekler veritabanını beklerken connection pool'daki bağlantıları tutuyor, havuz doluyor, yeni gelen istekler bağlantı için kuyruğa giriyor ve SqlClient'ın 15 saniyelik bekleme süresi dolunca hata alıyor. Bu bölümdeki testler boyunca API log'unda bu hata 33 bin kez geçti. SQL Server tarafındaki THREADPOOL wait'i, SQL Server'ın gelen işleri çalıştıracak worker thread bulamadığını gösteriyor; yani kaynak SQL Server'ın kendisi. Bu makinede SQL Server container'ı başka iş yükleriyle aynı CPU'yu paylaşıyordu ve testler sırasında makinenin load average değeri 10 civarındaydı. 500-600 basamaklarındaki çöküşün mekanizması bu: veritabanı yavaşlayınca pool tükeniyor, pool tükenince istekler zaman aşımına uğruyor ve throughput sıfıra iniyor. Wait istatistiklerinin nasıl okunacağı SQL Server Derinlemesine serisinin "Teşhis Metodolojisi" yazısında, kodun içindeki hot path'i bulmak ".NET'te Profiling ve Diagnostics" serisinde.
USE'un değeri sırasında: önce her kaynağın üç sorusunu hızlıca cevaplarsın, sonra yalnız şüpheli kaynağa derinlemesine bakarsın. Bu örnekte API'yi profile etmeye başlasaydım boşta bekleyen bir process'te hot path arayacaktım.
Run'ları Karşılaştırmak
Aynı basamaklı testi farklı zamanlarda tekrarladığımda 200 istek/sn basamağı bir koşuda p95 6,6 ms, başka bir koşuda 17 saniye verdi. Kod ve configuration aynıydı; değişen, makinedeki diğer iş yükleriydi. 01'deki yavaş closed model testi de iki koşuda p95 1,49 s ve 944 ms çıkmıştı. Bu bir istisna değil, ölçümün doğası. Karşılaştırma yaparken şu kurallara uy: her koşuyu en az üç kez tekrarla ve aralığı raporla, tek bir koşunun sayısını değil. Koşular arasında ortamı sıfırla (cache, veritabanı, container). Karşılaştırdığın iki koşu aynı ortamda, aynı veriyle, yakın zamanda yapılmış olsun. Ortam notunu sonuçla birlikte sakla. Bir rapor şablonu da işe yarar:
- Hedef: hangi soruya cevap aranıyor ve kabul kriteri (SLO'dan türeyen threshold'lar).
- Yük: workload model, hız, süre, open ya da closed model, test verisi.
- Ortam: commit, build, kaynak limitleri, veri boyutu, yük üreticisinin konumu, aynı anda çalışan diğer işler.
- Sonuç: endpoint bazında p50/p95/p99, hata oranı, dropped iterations; kaç tekrar ve aralık.
- Darboğaz: USE taramasının sonucu ve kanıtı.
- Aksiyon: ne değişecek ve bir sonraki koşuda neyle doğrulanacak.
Üretimde Dikkat
Production dashboard'larında da aynı kurallar geçerli: ortalama yerine percentile göster, percentile'ları zaman içinde ortalama; histogram metric'lerinden hesapla. Sunucu tarafı süre metric'inin kuyrukta bekleyen süreyi görmediğini unutma; istemci tarafı ölçüm (sentetik test, real user monitoring) ile birlikte oku. Alarm eşiklerini dirseğe göre koy: utilization yüzde 70'i geçtiğinde değil, saturation sinyalleri (thread pool queue, connection pool'da bekleyenler, dropped_iterations) görünmeye başladığında harekete geçmek daha doğru sonuç verir.
Sık Düşülen Tuzaklar
- Ortalama süreyi raporlamak ve kuyruğu görmemek.
- Dakikalık p99'ların ortalamasını almak ya da runner'ların p95'lerini ortalamak.
- Closed model testte max ile p99 arasındaki uçurumu görmezden gelmek.
- Throughput düşerken "süreler iyi" demek: çöken bir sistemde tamamlanan az sayıdaki istek hızlı olabilir.
- Darboğazı aramaya CPU'su yüksek görünen process'ten başlamak; USE ile her kaynağa sırayla bak.
- Tek koşunun sayısını kesin sonuç gibi raporlamak; tekrar sayısını ve aralığı yaz.
Küçük Bir Deneme
★☆☆ pause.js'i closed modelde 20 yerine 200 VU (virtual user; k6'nın sanal kullanıcısı) ve 1 saniye düşünme süresiyle çalıştır. Donma sırasında yavaş istek sayısı ve p99 nasıl değişti?
★★☆ steps.js'i output cache açıkken (query string'i kaldırarak) aynı basamaklarla koştur. Dirsek nereye kaydı? Cache'in hit oranını 02'deki yöntemle ölç.
★★★ API'de connection pool'u Max Pool Size=20 ile küçült ve basamaklı testi tekrarla. Dirsek ve çöküş noktası nasıl değişti? USE tablosunu yeniden doldur ve havuz boyutunun doğru değerini tartış.
Load test, sistemin bütününün nasıl davrandığını gösterir. Bazen sorun tek bir method'un birkaç yüz nanosaniye yavaşlamasıdır ve bunu load test'in gürültüsünde görmek mümkün değildir. Serinin son yazısında BenchmarkDotNet'in ileri kullanımına geçiyoruz: parametreler, baseline, diagnoser'lar, .NET 10 ile .NET 11'i karşılaştırmak ve CI'da regresyon yakalamak.