

Hardware Memory Model: Reordering, Store Buffer, Cache Coherence ve Sequential Consistency
Modern CPU'lar sequential consistency vermez: store buffer bir okumanın kendinden önceki yazıyı geçmesine izin verir ve ARM64 bundan da fazlasını yeniden sıralar. ARM64'te klasik store buffering testinde 10 milyon turun 5,3 milyonunda iki thread'in de 0 okuduğunu, message passing testinde bayrağın tutardan önce göründüğünü ölçüyor, cache coherence'ın neden bunu engellemediğini ve x64'ün hangi sonuçları yasakladığını Intel kılavuzundan gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ile derlenip denenmiştir; testler xUnit v3 4.0.3 ile yazıldı. Çıktılar ARM64 (Arm'ın 64-bit işlemci mimarisi) üzerinde alınmıştır; x64 için söylenenler Intel'in yazılım geliştirici kılavuzuna ve .NET memory model spec'ine dayanır, x64'te ölçüm yapılmadı.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'da (bir online kitapçı) iki thread var ve paylaştıkları iki int alan başlangıçta 0. Birinci thread önce X = 1 yazıyor, sonra Y'yi okuyor. İkinci thread önce Y = 1 yazıyor, sonra X'i okuyor. Lock yok, volatile yok, düz alan erişimi. İki thread'in de 0 okuması mümkün mü? Kâğıt üzerinde her iki thread de okumadan önce yazıyor; kim önce okursa okusun, en az biri diğerinin yazdığı 1'i görmeli gibi duruyor.
İkinci soru: sipariş servisi önce sipariş tutarını yazıyor, sonra "hazır" bayrağını kaldırıyor. Kargo thread'i bayrağı görünce tutarı okuyor. Bayrağı 1, tutarı 0 görmesi mümkün mü? Bu iki deneyi ARM64'te 10'ar milyon kez çalıştırdım. Sayılara bakmadan önce bir tahmin yaz; ardından aynı kodun Windows'taki x64 makinende neden farklı davranacağını konuşacağız.
Üçüncü yazıda Peterson algoritmasının volatile ile bile bozulduğunu görmüş, sebebini "sequential consistency varsayımı" diye bir cümleyle geçmiştik. Bu yazıda o cümleyi açıyoruz.
Sequential Consistency: Programcının Sezgisi
Leslie Lamport 1979'daki "How to Make a Multiprocessor Computer That Correctly Executes Multiprocess Programs" makalesinde, çok işlemcili bir bilgisayarın doğru sayılması için bir ölçüt tanımladı. Kendi cümlelerimizle: bütün thread'lerin bellek işlemleri tek bir sıraya dizilmiş gibi olmalı ve bu sırada her thread'in işlemleri kendi programındaki sırayla yer almalı. Yani çalıştırmayı, thread'lerin adımlarının bir deste kart gibi karıştırılıp arka arkaya konmasıyla açıklayabiliyorsan, o çalıştırma sequentially consistent'tır.
İlk yazıdaki interleaving'ler tam bu modeldi: iki thread'in adımlarını her olası sırayla yan yana koymuştuk. Bu modelde baştaki sorunun cevabı net. İlk adım ya X = 1 ya da Y = 1 olmak zorunda; hangisi önce gelirse gelsin, daha sonra yapılan iki okumadan biri o 1'i görür. İki thread'in de 0 okuduğu bir sıra yok.
Lamport'un makalesinin asıl söylediği ise şu: işlemciyi tek başına hızlandıran optimizasyonlar, birden çok işlemci bir araya geldiğinde bu sezgiyi bozabilir. Bugünkü CPU'ların hiçbiri varsayılan olarak sequential consistency vermez. Neden vermediğini görmek için deneye bakalım.
Store Buffering Litmus Testi
Memory model'leri incelemek için kullanılan küçük programlara litmus testi deniyor: iki üç thread, her birinde birkaç bellek işlemi ve "bu sonuç mümkün mü?" sorusu. Baştaki soru literatürde SB (store buffering; yazının store buffer'da bekletilmesinden adını alır) adıyla bilinir. Laboratuvar projesine her yazıda olduğu gibi yeni bir klasör ekledim, Hardware/:
// Paylaşılan iki int, aynı cache line'a düşmesinler diye aralarında 128 byte var
[StructLayout(LayoutKind.Explicit, Size = 256)]
public struct Cells
{
    [FieldOffset(0)] public int X;
    [FieldOffset(128)] public int Y;
}

// Store buffering (SB): kendi hücreni yaz, sonra diğerini oku
public sealed class StoreBufferingPlain : LitmusTest
{
    public override string Name => "SB plain";

    [MethodImpl(MethodImplOptions.NoInlining | MethodImplOptions.AggressiveOptimization)]
    public override int Thread0()
    {
        Shared.X = 1;
        return Shared.Y;
    }

    [MethodImpl(MethodImplOptions.NoInlining | MethodImplOptions.AggressiveOptimization)]
    public override int Thread1()
    {
        Shared.Y = 1;
        return Shared.X;
    }
}
AggressiveOptimization ile method'lar doğrudan optimize edilmiş kodla derleniyor; böylece her koşuda aynı makine kodunu ölçüyoruz ve tiered compilation'ın ara aşamaları sonucu karıştırmıyor. İki thread'in bu iki satırı gerçekten aynı anda çalıştırması için LitmusRunner üçüncü bir thread'i koordinatör yapıyor: her turda hücreleri sıfırlıyor, iki worker'ın beklediği tur numarasını artırıyor, ikisi de bitince okunan değerleri sayıyor.
for (int round = 1; round <= rounds; round++)
{
    test.Reset();
    Volatile.Write(ref _done, 0);
    Volatile.Write(ref _go, round); // iki worker bu değeri bekliyor
    while (Volatile.Read(ref _done) != 2) { }
    outcomes[_r0, _r1]++;
}
Aynı testin iki varyantını da ekledim: okuma ve yazmaları Volatile.Read/Volatile.Write ile yapan StoreBufferingVolatile ve yazmayla okuma arasına Interlocked.MemoryBarrier() koyan StoreBufferingFenced.
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- litmus-sb 10000000SB plain r0=0,r1=0: 5,314,715 0,1: 4,874 1,0: 4,680,409 1,1: 2 (1972 ms)
SB Volatile.Read/Write r0=0,r1=0: 11,272 0,1: 10,957 1,0: 4,638,867 1,1: 5,338,904 (2172 ms)
SB full fence r0=0,r1=0: 0 0,1: 12,402 1,0: 5,466,604 1,1: 4,520,994 (2074 ms)Düz erişimde 10 milyon turun 5.314.715'inde iki thread de 0 okudu; yani en sık görülen sonuç, sequential consistency'nin imkânsız saydığı sonuç. Volatile sürümünde bu sayı 11.272'ye düştü ama sıfır olmadı. Full fence ile sıfır. İkinci koşuda sayılar farklıydı (düz erişimde 5.557.821, Volatile'da 62.894), fence'li sürüm yine 0'dı.
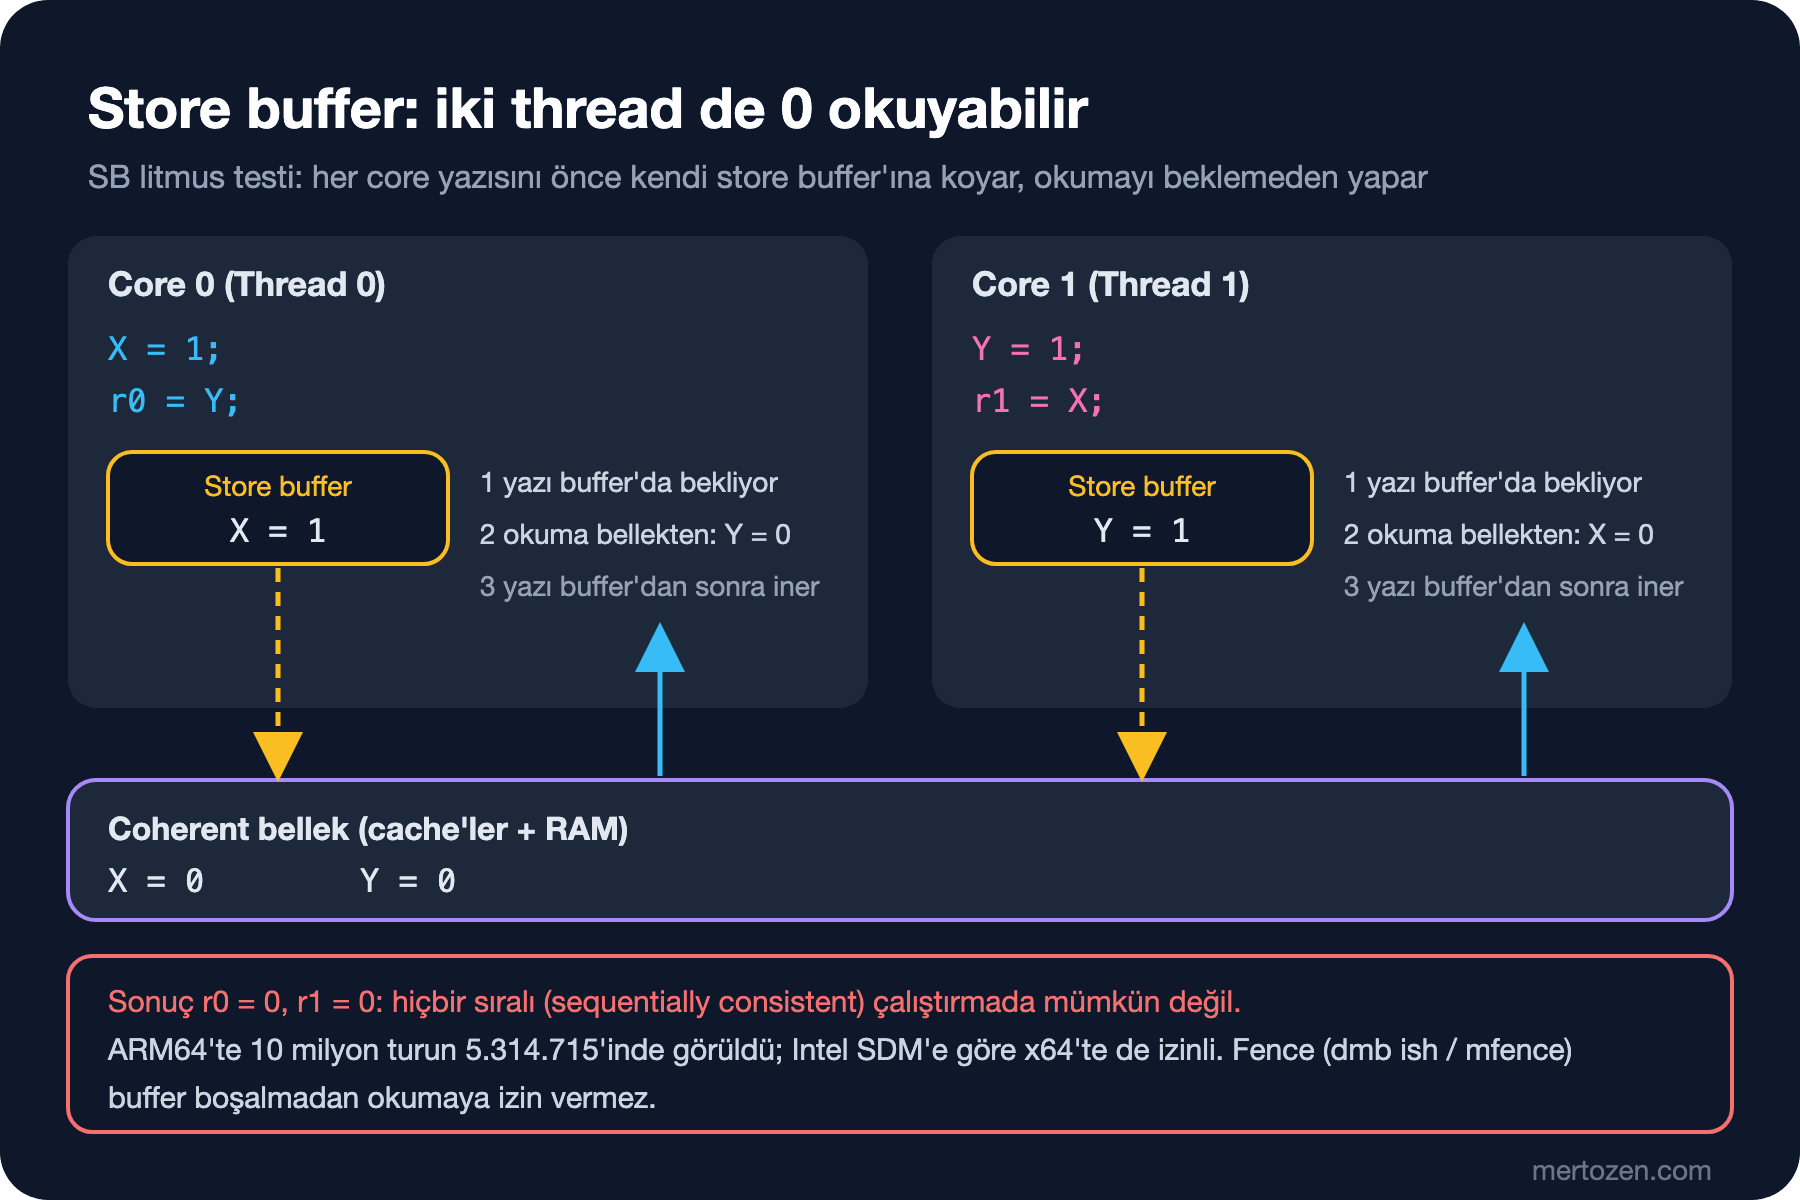
Sebebi store buffer. Bir core belleğe yazdığında yazının cache'e ulaşması için cache line'ın sahipliğini alması gerekir ve bu, line başka bir core'daysa onlarca nanosaniye sürebilir. Core bu süreyi boş beklemek yerine yazıyı kendi önündeki küçük bir store buffer'a koyar ve sonraki talimatlara geçer. Sonraki talimat başka bir adresten okumaysa okuma cache'ten hemen yapılır. Yazı henüz buffer'da durduğu için diğer core onu göremez. İki core aynı anda bunu yapınca ikisi de karşının eski değerini, yani 0'ı okur. Core kendi yazdığını buffer'dan okuyabilir (store forwarding), bu yüzden tek thread'in bakış açısından hiçbir şey bozulmaz.
Reordering Nereden Gelir: Donanım ve JIT
Bir okumanın kendinden önceki yazıyı geçmesi, programcının gözünden bir reordering'dir. Bunun üç kaynağı var: store buffer, out-of-order execution (CPU'nun bağımsız talimatları hazır oldukça program sırasından bağımsız yürütmesi) ve compiler. .NET'te compiler tarafı JIT'tir (kodu çalışma anında makine koduna çeviren compiler) ve memory model spec'i, sıradan okuma ve yazmaların tek thread'in gördüğü sonucu değiştirmediği sürece hem kod üretimi hem donanım yüzünden yeniden sıralanabileceğini açıkça söylüyor.
Deneyimizdeki 0,0 sonucunun JIT'ten değil donanımdan geldiğini görmek için üretilen koda baktım. DOTNET_JitDisasm ortam değişkeni, adı verilen method'ların assembly'sini konsola yazar (PowerShell'de $env:DOTNET_JitDisasm="Thread0", bash'te komutun başına DOTNET_JitDisasm=Thread0):
DOTNET_JitDisasm=Thread0 dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- litmus-sb 1; StoreBufferingPlain:Thread0
mov w1, #1
str w1, [x0, #0x08]
ldr w0, [x0, #0x88]
; StoreBufferingVolatile:Thread0
mov w1, #1
stlur w1, [x0, #0x08]
ldapur w0, [x0, #0x88]
; StoreBufferingFenced:Thread0
mov w1, #1
str w1, [x0, #0x08]
dmb ish
ldr w0, [x0, #0x88]Çıktının ilgili satırları bunlar. JIT talimatları program sırasında bırakmış: önce str (yazma), sonra ldr (okuma). Yer değiştirme tamamen donanımda oluyor. Volatile sürümünde yazma stlur'a (release store), okuma ldapur'a (acquire load) dönüşüyor. Release, yazmanın kendinden önceki işlemleri geçmesini engeller; acquire, okumanın kendinden sonrakilerin arkasına düşmesini engeller. Ama "önce yazma, sonra okuma" sırasını hiçbiri korumaz. Bu yüzden Volatile sürümü de 0,0 üretti. Fence'li sürümdeki dmb ish ise bir full barrier: önceki bütün bellek işlemleri tamamlanmadan sonrakiler başlayamaz, yani okuma store buffer boşalana kadar bekler.
Peterson'ın üçüncü yazıda neden bozulduğu da burada netleşiyor: "bayrağımı kaldırdım" yazısı store buffer'da beklerken "karşının bayrağı inik" okuması yapılıyordu. Volatile kuralları ve fence'lerin .NET'teki anlamı bir sonraki yazının konusu.
Cache Coherence ile Memory Consistency Farklı Şeyler
Bu noktada sık yapılan bir karışıklık var: "CPU'ların cache'leri coherent, o hâlde bir core'un yazdığını diğeri görür" düşüncesi. Bilgisayar Nasıl Çalışır serisinin multi-core yazısında MESI (bir cache line'ın alabileceği dört durumun baş harfleri: Modified, Exclusive, Shared, Invalid) protokolünü ve cache line'ların core'lar arasında nasıl el değiştirdiğini anlatmıştık. Coherence tek bir adres hakkında bir garantidir: aynı adrese yapılan yazmalar bütün core'lar tarafından aynı sırayla görülür. Consistency ise farklı adreslere yapılan işlemlerin birbirine göre hangi sırayla görüneceğidir.
Coherence'ı ayrıca ölçtüm. Bir thread aynı alana 1'den 50 milyona kadar sırayla yazıyor, üç thread aynı alanı durmadan okuyup bir önceki okumasından küçük bir değer görüp görmediğini sayıyor:
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- coherence 50000000writes=50,000,000 reads=172,760,742 saw the value go back=0172 milyon okumada değerin bir kez bile geriye gittiği görülmedi. Okumada Volatile.Read kullandım ama yalnız JIT ardışık okumaları tek okumada birleştirmesin diye; tek adresteki sıra garantisi coherence'tan geliyor. .NET memory model spec'i de bunu desteklenen bütün platformlardan beklediği bir donanım özelliği olarak yazıyor. Yani store buffering testindeki sorun bir cache tutarsızlığı değil: her adres kendi içinde tutarlı, sorun iki farklı adresin birbirine göre sırası. Coherence protokolü bu sırayı hiç düzenlemez; store buffer da coherence'ın önünde, ondan önce devreye giren bir katmandır.
x86-TSO ve ARM64: Message Passing Testi
Donanım mimarileri sequential consistency'den farklı ölçülerde uzaklaşır. x86 ailesinin modeli literatürde TSO (Total Store Order; bütün yazıların herkese tek bir sırayla göründüğü model) ya da x86-TSO olarak geçer. Intel SDM'in (Intel'in yazılım geliştirici kılavuzu) üçüncü cildindeki memory ordering bölümüne göre bu modelde okumalar başka okumalarla, yazmalar başka yazmalarla yer değiştirmez; bir yazma kendinden önceki bir okumayı da geçmez. İzin verilen tek yer değiştirme, bir okumanın kendinden önceki ve farklı adrese yapılmış bir yazmanın önüne geçmesi. Bu tam olarak store buffer'ın yaptığı şey. Yani SB testindeki 0,0 sonucu x64'te de izinli.
ARM64'ün modeli çok daha zayıf: farklı adreslere yapılan bağımsız okuma ve yazmaların neredeyse her ikilisi yer değiştirebilir. AWS'nin (Amazon'un bulut platformu) Graviton teknik kılavuzu bunu açıkça yazıyor: Arm zayıf sıralı (weakly ordered), x86 ise TSO'nun bir türü ve TSO'ya güvenen kodda gerekli barrier'lar eksik olabilir. Farkı en iyi gösteren litmus testi MP (message passing; bir thread'in diğerine veriyi bir bayrakla haber vererek aktarması), yani baştaki ikinci soru:
// Message passing (MP): X = sipariş tutarı, Y = "hazır" bayrağı
public override int Thread0()
{
    Shared.X = 1; // tutar
    Shared.Y = 1; // hazır
    return 0;
}

public override int Thread1()
{
    int ready = Shared.Y;
    int total = Shared.X;
    return ready * 2 + total;
}
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- litmus-mp 10000000MP plain ready=1,total=1: 57,615 ready=0: 3,650,600 ready=1,total=0: 6,291,785 (1899 ms)
MP Volatile.Read/Write ready=1,total=1: 2,729 ready=0: 9,997,271 ready=1,total=0: 0 (2215 ms)Düz erişimde 10 milyon turun 6.291.785'inde kargo thread'i bayrağı kaldırılmış, tutarı ise 0 gördü. Sipariş servisinin kodu tutarı bayraktan önce yazıyor ve JIT çıktısında da iki str bu sırada. ARM64 ya yazmaların görünme sırasını ya da okuma tarafındaki iki ldr'ın sırasını değiştirdi; ikisi de bu mimaride serbest. Bayrağı Volatile.Write ile yazıp Volatile.Read ile okuyunca bu sonuç sıfıra indi. Bu test release/acquire'ın tam olarak çözdüğü durum: release yazma tutarın bayraktan önce görünmesini, acquire okuma da tutarın bayraktan sonra okunmasını garanti ediyor.
| Litmus testi ve sonuç | ARM64 (ölçüm, 10 milyon tur) | x64 (Intel SDM'e göre) |
|---|---|---|
| SB, düz erişim: iki thread de 0 | 5.314.715 | izinli |
SB, Volatile: iki thread de 0 | 11.272 | izinli |
| SB, full fence: iki thread de 0 | 0 | yasak |
| MP, düz erişim: bayrak 1, tutar 0 | 6.291.785 | donanımda yasak |
MP, Volatile: bayrak 1, tutar 0 | 0 | yasak |
x64 sütunu ölçüm değil, kılavuzun izin verdiği ve vermediği sonuçlar. Bu programı Windows'taki x64 makinende çalıştırırsan kılavuza göre SB satırlarında 0,0 görmeli, MP'nin düz sürümünde ise bayrak 1, tutar 0 sonucunu hiç görmemelisin. "Donanımda yasak" ifadesine dikkat: .NET spec'i JIT'in düz okuma ve yazmaları yeniden sıralamasına izin veriyor. Bugün x64 JIT'i bu iki satırı yer değiştirmiyor olabilir; ama bu, dilin verdiği bir garanti değil.
Fence: Sırayı Geri Almak
Fence (ya da barrier), donanıma "bu noktada sıra önemli" demenin yolu. ARM64'te dmb ish talimatı bütün core'lar için bir full barrier; x64'te aynı işi mfence ya da lock önekli bir talimat görür, Intel SDM'e göre locked talimatlar okuma ve yazmalarla yer değiştirmez. .NET'te bunlara doğrudan yazmazsın: Interlocked.MemoryBarrier(), bütün Interlocked method'ları ve lock giriş-çıkışı runtime'ın platforma göre doğru talimatı seçtiği soyutlamalar.
Fence'in bir maliyeti var: core'u store buffer boşalana kadar bekletir. Bizim deneyde fark görünmüyor, çünkü her turun asıl maliyeti thread'leri senkronize etmek (üç koşu da 2 saniye civarında). Sıkı bir döngüde, her iterasyonda fence koymak ise ölçülebilir bir yavaşlama getirir. Memory model'lerin varlık sebebi bu: donanım üreticisi hızlı varsayılan davranışı seçer, sırayı gerçekten isteyen kod bunu açıkça ister.
Release/acquire ile full fence arasındaki fark da buradan çıkıyor. Message passing gibi "önce veriyi yaz, sonra bayrağı kaldır" durumlarında release/acquire yeterli ve ARM64'te ucuz (stlur/ldapur). Store buffering gibi "önce kendi niyetimi yaz, sonra karşınınkini oku" durumlarında (Peterson, Dekker gibi algoritmalar) full fence şart.
Üretimde Dikkat
x64 makinende geçen bir test ARM64'te bozulabilir ve ARM64 artık uzak bir ihtimal değil. AWS Graviton, Azure'un Cobalt 100 tabanlı sanal makineleri (Ekim 2024'te genel kullanıma açıldı) ve Windows on Arm cihazlar, .NET kodunun ARM64'te çalıştığı yaygın yerler. Container image'ını multi-arch build edip ARM64 node'lara deploy ettiğinde, x64'te hiç görmediğin MP türü bir bug ortaya çıkabilir. AWS'nin kılavuzu da aynı uyarıyı yapıyor ve önemli bir not ekliyor: dilin kendi kilit ve senkronizasyon soyutlamalarını kullanan kod bu farkı hissetmez. Sorun, kilitsiz yazılmış ve x86'nın davranışına güvenen koddadır.
Bu yüzden kilitsiz bir bayrak, kendi yazdığın bir cache yenileme mekanizması ya da "hazır" alanıyla iki thread arasında veri aktaran kod varsa, CI'da ARM64 bir runner'da da stress test çalıştır. x64'te sıfır hata görmek bu tür kod için kanıt değil; MP testinde x64 donanımı bu sonucu zaten yasakladığı için, x64'te çalışan bir test bu hatayı hiçbir zaman yakalayamaz.
Ölçerken laboratuvar koşullarını unutma. Deneyimizde iki thread her turda aynı anda serbest bırakıldığı için sayılar yüksek. Gerçek bir uygulamada aynı yanlış sıralama milyonlarca istekte bir görülebilir; seyrek olması zararsız olduğu anlamına gelmez, yalnız hata ayıklamanın daha zor olacağı anlamına gelir.
Sık Düşülen Tuzaklar
x86'da test edip ARM64'e deploy etmek. MP türü bir bug x64 donanımında hiç görünmez; ARM64'te ise bizim deneyde turların yarısından fazlasında göründü. Kilitsiz kodun doğruluğunu ölçümle değil, memory model kurallarıyla kanıtla.
Sıralamayı Thread.Sleep ile "garanti etmek". "Önce tutar yazılsın, 10 ms sonra bayrak kalksın" demek, hiçbir thread'e görünürlük sırası vermez; yalnız hatayı daha seyrek hâle getirir. Sıra ancak release/acquire, fence ya da kilitle kurulur.
Coherence'ı consistency sanmak. Cache'lerin coherent olması tek bir adresin değerlerinin sırasını korur. İki farklı alan arasındaki sıra için coherence hiçbir şey söylemez.
Volatile'ın her sırayı koruduğunu sanmak. SB testinde Volatile sürümü 10 milyonda 11.272 kez iki thread'e de 0 okuttu. Release/acquire, yazmadan sonra gelen okumanın sırasını korumaz.
Küçük Bir Deneme
★☆☆ litmus-sb ve litmus-mp komutlarını kendi makinende çalıştır. x64'teysen MP'nin düz sürümünde "ready=1,total=0" sayısının 0 kaldığını, SB'nin düz sürümünde ise 0,0'ın göründüğünü doğrula ve tablodaki x64 sütunuyla karşılaştır.
★★☆ Cells struct'ındaki FieldOffset(128)'i FieldOffset(4) yap, yani iki alanı aynı cache line'a koy. SB ve MP sonuçları nasıl değişti? Değişimi store buffer ve cache line sahipliği üzerinden açıkla.
★★★ LB (load buffering; okumanın kendinden sonraki yazıdan sonraya kalması) testini ekle: her thread önce diğerinin hücresini okusun, sonra kendi hücresine 1 yazsın. İki thread'in de 1 okuması sequential consistency'de mümkün mü? ARM64 modeli buna izin verir; kendi makinende görebiliyor musun? Göremiyorsan bunun "izin yok" anlamına gelmediğini açıkla.
Bu yazıda donanımın verdiği garantilere baktık ve gördük ki x64 ile ARM64 aynı kodu farklı sıralarla çalıştırıyor. Bir dil, üzerinde çalıştığı her donanımda aynı anlamı nasıl verir? Serinin sıradaki yazısında .NET memory model'ine geçiyoruz: happens-before, acquire/release, volatile'ın gerçek anlamı, double-checked locking ve JIT'in bir döngüyü neden sonsuza kadar çalıştırabildiği.