

Concurrency ve Parallelism: Interleaving, Nondeterminism ve Amdahl Yasası
Concurrency işlerin üst üste binmesidir, parallelism aynı anda çalışmalarıdır; hızlanmanın tavanını ise seri kısım belirler: %10 seri kısımla 64 core en fazla 8,8 kat getirir. İki thread'in 20 olası sırasından 18'inde artışın kaybolduğunu, gerçek koşuda sıraların %99,6'sının tek bir sıra olduğunu ve Bookstore rapor job'ının ARM64'te 10 worker'la Amdahl'ın altında kaldığını ölçüyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ile derlenip denenmiştir; testler xUnit v3 4.0.3, ölçümler BenchmarkDotNet 0.15.8 ile alınmıştır. Ölçümlerin platformu ARM64'tür (Arm'ın 64-bit işlemci mimarisi; 10 core: 4 performans, 6 verimlilik core'u); x64 için söylenenler dokümanlara dayanır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'un (bir online kitapçı) ay sonu raporu tek thread'de 360 ms sürüyor. Ekipten Emre, işi Parallel.For ile dağıtınca 64 core'lu bir sunucuda raporun 64 kat hızlanacağını söylüyor. Raporun %10'luk bir kısmı ise doğası gereği sırayla yapılmak zorunda: her satırın denetim hash'i bir önceki satırın hash'ini içeriyor. 64 core en fazla kaç kat hızlandırır? 10 core'lu bir makinede ölçtüğümüzde 10 worker 8 worker'dan hızlı mı çıkar?
İkinci soru: iki thread'in her biri üç adımlık bir iş yapıyor. Bu altı adım kaç farklı sırayla çalışabilir? İki thread'i aynı anda başlatıp yüz bin kez denesen, bu sıraların kaçını gerçekten görürsün? Cevapları gerçek koşularla vereceğiz. Bu, Concurrency Teorisi serisinin ilk yazısı; seri API değil, concurrent kodun neden böyle davrandığını anlatıyor.
Concurrency ve Parallelism Aynı Şey Değil
İki kelime günlük konuşmada birbirinin yerine kullanılıyor ama farklı şeyleri anlatıyor. Concurrency programın yapısıyla ilgili: birden çok iş aynı zaman aralığında başlamış ve henüz bitmemiş durumda, işler birbirinin üstüne biniyor. Parallelism ise yürütmeyle ilgili: aynı anda gerçekten birden çok instruction çalışıyor. Rob Pike'ın 2012'de Heroku'nun Waza konferansında verdiği "Concurrency is not parallelism" konuşmasının özeti de bu: concurrency, işleri bağımsız parçalar olarak kurmak; parallelism, o parçaları aynı anda çalıştırabilmek.
Tek core'lu bir makinede de concurrency vardır. Scheduler thread'lere sırayla zaman dilimi verir, her thread biraz ilerler ve kesilir. İşletim Sistemi Temelleri serisinin scheduling ve context switch yazısında bu dilimlemeyi ayrıntılı gördük; burada önemli olan sonucu: tek core'da bile iki thread'in adımları birbirine karışır. Parallelism ise birden çok core ister. Bilgisayar Nasıl Çalışır serisinin multi-core yazısında core'ların neyi paylaştığını anlatmıştık.
Bir de işin türü var. I/O-bound bir iş (veritabanı sorgusu, HTTP çağrısı) zamanının çoğunu beklemekle geçirir; burada kazanç core sayısından değil, beklerken thread'i bırakmaktan gelir ve bu C# Asenkron Programlama serisinin ilk yazısının konusu. CPU-bound bir iş (rapor hesaplama, sıkıştırma, hash) ise core'u gerçekten meşgul eder; hızlanma ancak parallelism ile gelir. Bu yazıdaki Amdahl hesabı CPU-bound işler içindir.
Interleaving: İki Thread Kaç Farklı Sırayla Çalışır?
Interleaving, birden çok thread'in adımlarının tek bir zaman çizgisinde nasıl sıralandığıdır. Her thread kendi adımlarını kendi sırasıyla yapar; değişebilen tek şey, adımların birbirine göre nasıl karıştığıdır. İki thread'in ikişer adımı varsa altı farklı sıra mümkündür ve bunları bir ağaç olarak çizebiliriz:
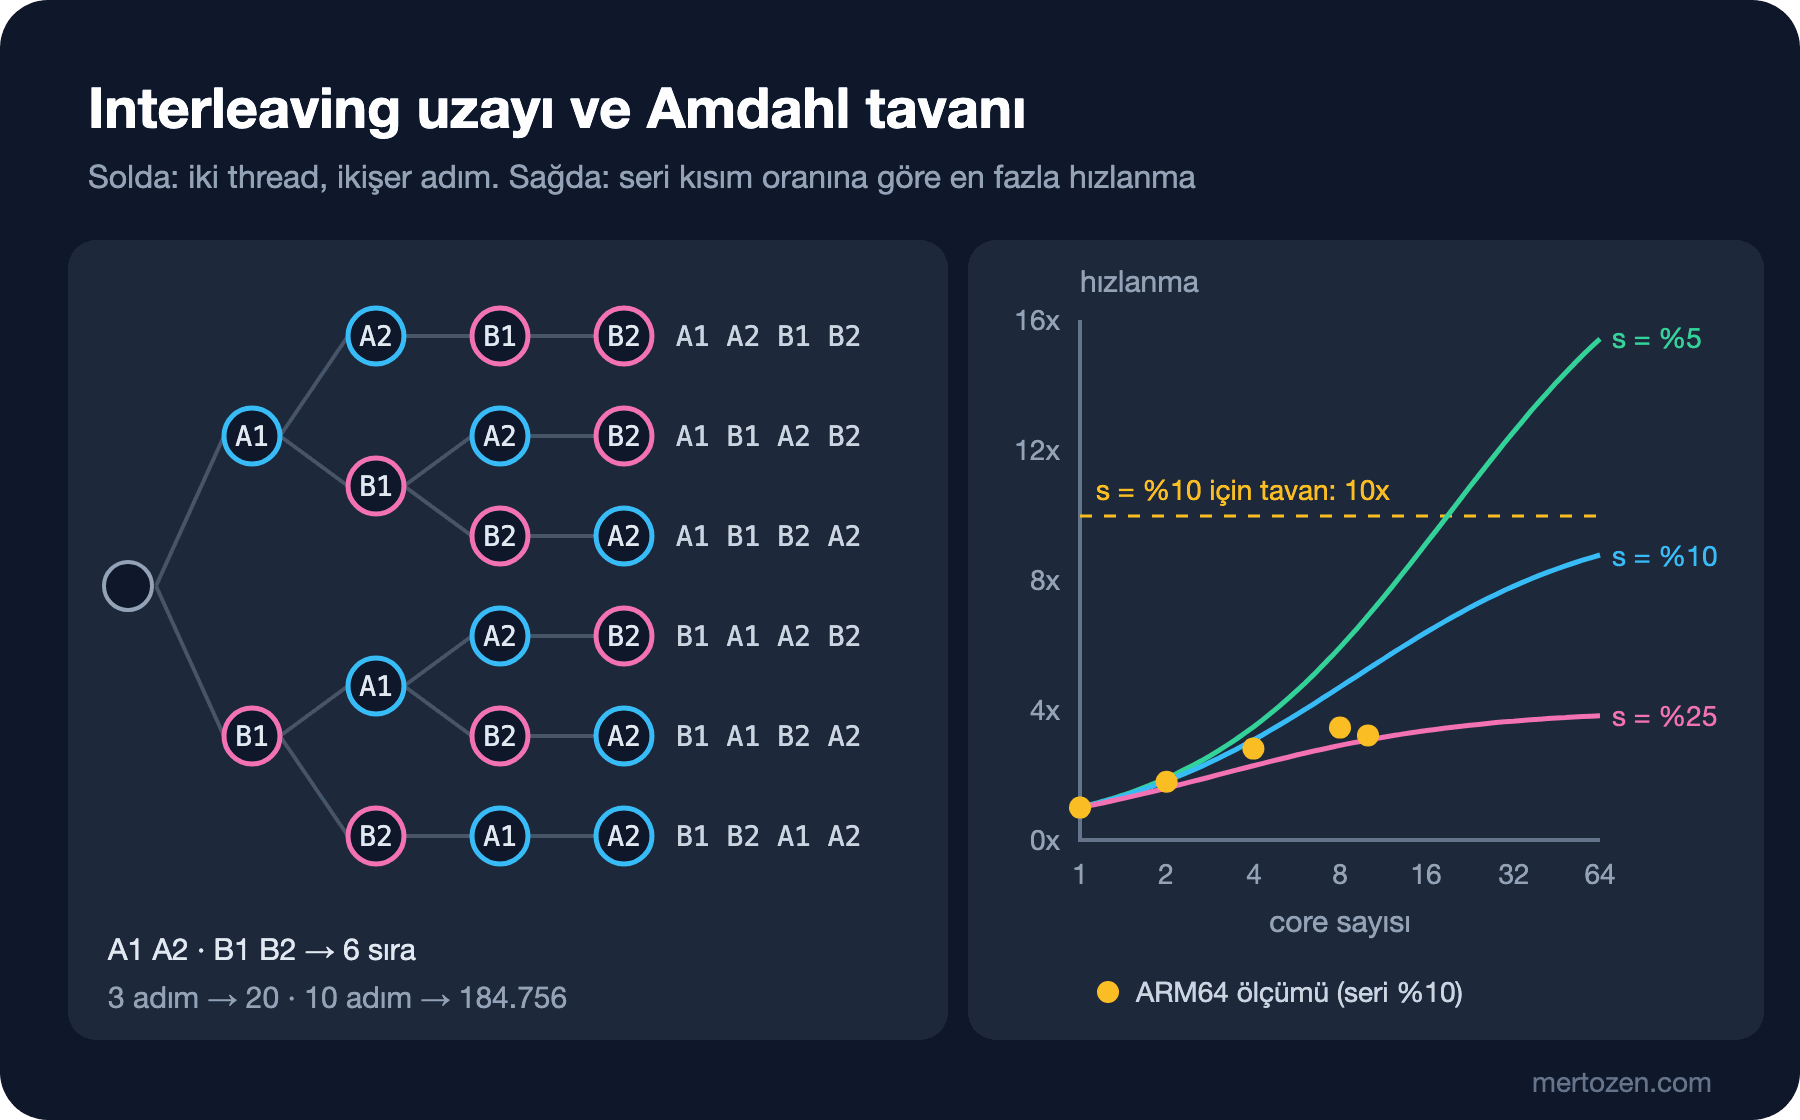
Genel formül basit bir kombinatorik: n thread'in her biri k atomik adım yapıyorsa olası sıra sayısı (n·k)! / (k!)^n olur. Sıraları tek tek üreten küçük bir method yazalım:
// Her iki listenin kendi iç sırası korunur; değişen yalnız karışım
public static IEnumerable<string[]> Enumerate(string[] a, string[] b)
{
    if (a.Length == 0) { yield return b; yield break; }
    if (b.Length == 0) { yield return a; yield break; }
    foreach (string[] rest in Enumerate(a[1..], b))
        yield return [a[0], .. rest];
    foreach (string[] rest in Enumerate(a, b[1..]))
        yield return [b[0], .. rest];
}
Şimdi bu sıraları bir stok sayacına uygulayalım. İki thread aynı kitabın stoğunu birer artırıyor ve stock = stock + 1 üç adıma ayrılıyor: değeri oku, bir ekle, geri yaz. RunIncrement her sırayı adım adım simüle edip son değeri döndürüyor:
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- interleavingsinterleavings: 20, final=2: 2, final=1: 18
2 threads x 3 steps -> 20
2 threads x 10 steps -> 184,756
3 threads x 10 steps -> 5,550,996,791,340
4 threads x 10 steps -> 4,705,360,871,073,570,227,520Yirmi sıranın yalnız ikisinde sonuç doğru: biri tamamen önce, diğeri tamamen sonra çalıştığında. Geri kalan on sekizinde iki thread aynı eski değeri okuyor ve bir artış kayboluyor. Adım sayısı büyüdükçe sıra sayısı patlıyor: dört thread'in onar adımı için 4,7 × 10^21 sıra var. Concurrent kodu "bütün durumları deneyerek" test edememenin sebebi bu sayı. Bu tür hataların ayrıntılı sınıflandırmasını bir sonraki yazıda yapacağız.
Nondeterminism: "Bende Çalışıyor" Nereden Gelir?
Sıraların hepsi mümkün ama hepsi eşit olasılıklı değil. Bunu görmek için iki thread'i bir Barrier ile aynı anda serbest bırakıp her birine üçer kayıt yazdırdım ve bu deneyi yüz bin kez tekrarladım:
private static void Steps(string name, ConcurrentQueue<string> log, Barrier start)
{
    start.SignalAndWait();
    for (int i = 1; i <= 3; i++)
        log.Enqueue($"{name}{i}");
}
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- observe 100000100,000 runs, 13 distinct orders out of 20
BBBAAA 99,598 99.60%
AAABBB 248 0.25%
BAAABB 125 0.12%
BBAAAB 15 0.01%
BABABA 4 0.00%
BBABAA 2 0.00%
BABBAA 2 0.00%
ABAABB 1 0.00%
ABBBAA 1 0.00%
AABABB 1 0.00%
BBAABA 1 0.00%
BAABBA 1 0.00%
ABABAB 1 0.00%Yirmi sıranın on üçü görüldü ama dağılım çok çarpık: denemelerin %99,6'sında B önce bitiyor. Sebebi Barrier'ın çalışma şekli: bariyere son gelen thread hiç beklemeden devam ediyor, önce gelen thread ise uykudan uyandırılmayı bekliyor. Uyanma birkaç mikrosaniye sürüyor ve B bu sürede üç küçük adımını bitiriyor. Aynı komutu iki kez daha çalıştırdığımda 8 ve 12 farklı sıra gördüm; yani hangi sıraların görüneceği bile koşudan koşuya değişiyor.
"Bende çalışıyor" cümlesinin kaynağı bu. Senin makinende, senin yükünde nadir sıralar hiç gelmeyebilir; production'da başka bir CPU, başka bir yük, başka bir thread pool durumu o sıraları sık hâle getirir. Shan Lu ve arkadaşlarının MySQL, Apache, Mozilla ve OpenOffice'ten seçilmiş 105 gerçek concurrency bug'ını incelediği 2008 tarihli çalışmaya göre bu bug'ların %92'si, en fazla dört bellek erişiminin belirli bir sıraya sokulmasıyla güvenilir şekilde tetiklenebiliyor. Sorun karmaşık sıralarda değil, nadir görülen kısa sıralarda.
Bu tür hatalara Heisenbug denir: gözlemlemeye çalıştığında kaybolan bug. Terim Jim Gray'in 1985 tarihli "Why Do Computers Stop and What Can Be Done About It?" raporuyla yaygınlaştı. Bir Console.WriteLine eklemek, debugger'da breakpoint koymak ya da Debug build'e geçmek zamanlamayı değiştirir ve hatalı sıra ortadan kalkar. Debugger'da race yakalama teknikleri Debugging ve Problem Çözme serisinin multi-thread debugging yazısında var; bu seride ise hatayı kâğıt üzerinde, sıralar ve invariant'lar üzerinden tanımlamayı öğreneceğiz.
Amdahl Yasası: Seri Kısım Tavanı Belirler
Şimdi hız sorusuna dönelim. Gene Amdahl 1967'de yayımladığı kısa makalede, bir programın paralelleşemeyen kısmının elde edilebilecek hızlanmaya üst sınır koyduğunu savundu; bugün kullandığımız formül bu fikrin sonradan yazılmış hâlidir. Tek thread'deki sürenin s kadarı seri, geri kalanı N core'a bölünebiliyorsa hızlanma 1 / (s + (1 − s) / N) olur. N sonsuza giderken bu değer 1 / s'ye yaklaşır:
public static double Speedup(double serialFraction, int cores) =>
    1.0 / (serialFraction + (1.0 - serialFraction) / cores);

public static double Limit(double serialFraction) => 1.0 / serialFraction;
%10 seri kısım için 64 core'un getirebileceği en fazla hızlanma 1 / (0,1 + 0,9 / 64) = 8,77 kattır; sonsuz core ile bile 10 katı geçemezsin. Emre'nin 64 kat beklentisi ilk tahminde bu sebeple çöküyor. Seri kısım %5'e inerse 64 core 15,4 kat, %25'e çıkarsa yalnız 3,7 kat getirir. Şekildeki sağ panel bu üç eğriyi gösteriyor.
Ölçüm: Bookstore Rapor Job'ı
Teoriyi gerçek bir işle karşılaştırmak için kurumsal siparişlerin aylık raporunu modelledim: 200.000 sipariş, her siparişte 22 farklı kitap. Rapor iki aşamalı. Birinci aşamada her siparişin toplamı ve satırlarının SHA256 ile (32 byte'lık özet üreten hash fonksiyonu) parmak izi hesaplanıyor; her sipariş yalnız kendine baktığı için bu aşama paralelleşebilir. İkinci aşama denetim zinciri: her halka, önceki halkanın hash'i ile siparişin parmak izinin hash'i. Bir halkayı hesaplamak için öncekini bilmek gerektiğinden bu kısım seri:
public static (decimal Revenue, string AuditHash) Build(Order[] orders, int workers)
{
    decimal[] totals = new decimal[orders.Length];
    byte[] fingerprints = new byte[orders.Length * HashSize];
    Parallel.For(0, orders.Length, new ParallelOptions { MaxDegreeOfParallelism = workers }, i =>
    {
        totals[i] = Summarize(orders[i], fingerprints.AsSpan(i * HashSize, HashSize));
    });
    byte[] audit = new byte[HashSize];
    Chain(fingerprints, audit);
    return (totals.Sum(), Convert.ToHexString(audit)[..16]);
}

// Seri kısım: her denetim hash'i bir öncekini içerir, bölünemez
public static void Chain(ReadOnlySpan<byte> fingerprints, Span<byte> chain)
{
    Span<byte> buffer = stackalloc byte[2 * HashSize];
    chain.Clear();
    for (int offset = 0; offset < fingerprints.Length; offset += HashSize)
    {
        chain.CopyTo(buffer);
        fingerprints.Slice(offset, HashSize).CopyTo(buffer[HashSize..]);
        SHA256.HashData(buffer, chain);
    }
}Parallel.For'un kendisini C# Asenkron Programlama serisinin paralellik yazısında anlattık; burada yalnız worker sayısını sınırlamak için kullanıyoruz. Her siparişin sonucu kendi index'ine yazıldığı için thread'ler aynı bellek alanına yazmıyor ve sonuç worker sayısından bağımsız. Önce iki aşamanın süresini tek thread'de ölçüp seri oranı bulalım:
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- report-phases 200000 22orders=200,000 summarize=328 ms chain=37 ms serial fraction=10.2 %
Amdahl n= 2: 1.82x
Amdahl n= 4: 3.07x
Amdahl n= 8: 4.67x
Amdahl n=10: 5.22x
Amdahl n=64: 8.64x
limit: 9.83xSeri oran %10,2, teori 64 core için 8,64 kat diyor. Şimdi BenchmarkDotNet ile 1, 2, 4, 8 ve 10 worker'ı ölçelim:
dotnet run -c Release --project bench/Bookstore.ConcurrencyLab.Benchmarks -- --filter "*ReportBenchmarks*"| Method | Orders | Workers | Mean | StdDev |
|------------ |------- |-------- |--------------:|--------------:|
| SingleChain | 200000 | 1 | 363,621.43 us | 10,610.172 us |
| SingleChain | 200000 | 2 | 203,420.68 us | 1,768.823 us |
| SingleChain | 200000 | 4 | 129,589.39 us | 450.475 us |
| SingleChain | 200000 | 8 | 104,962.35 us | 5,933.538 us |
| SingleChain | 200000 | 10 | 112,846.34 us | 7,923.190 us |Hızlanmalar 2 worker'da 1,79, 4'te 2,81, 8'de 3,46, 10'da 3,22 kat. 2 worker'da ölçüm teoriyle neredeyse aynı (1,82). 4 worker'da teorinin biraz altındayız (3,07 yerine 2,81); işi dağıtma ve thread'leri uyandırma maliyeti burada görünmeye başlıyor. 8 ve 10 worker'da ise fark büyük ve 10 worker 8'den hızlı değil; iki ölçüm standart sapma içinde aynı.
Sebep Amdahl'ın sessiz bir varsayımı: bütün core'lar eşit hızda. Ölçtüğüm makinenin 4 performans ve 6 verimlilik core'u var ve verimlilik core'ları aynı işi daha yavaş yapıyor. 4 worker'a kadar iş büyük ölçüde hızlı core'larda dönüyor; sonrasında eklenen her worker daha az katkı veriyor. x64 dünyasında da bu durum yaygın: Intel'in 12. nesilden beri masaüstü işlemcilerinin çoğu performans ve verimlilik core'larını karıştırıyor. Core'ları eş bir sunucuda eğrinin Amdahl'a daha çok yaklaşmasını bekleriz ama bunu ben ölçmedim; kendi makinende aynı benchmark'ı çalıştırıp karşılaştırman bu yazının en öğretici kısmı olur.
Seri Kısmı Küçültmek ve Gustafson
Amdahl'ın asıl dersi şu: tavanı core sayısı değil seri kısım belirler. Core eklemek yerine seri kısmı küçültmeye bakalım. Denetim zincirini her gün için ayrı kurarsak 31 zincir paralel hesaplanabilir; sonra yalnız 31 günlük hash'i tek bir zincire bağlamak seri kalır:
Parallel.For(0, starts.Length - 1, new ParallelOptions { MaxDegreeOfParallelism = workers }, d =>
{
    Chain(fingerprints.AsSpan(starts[d] * HashSize, (starts[d + 1] - starts[d]) * HashSize),
        dayHashes.AsSpan(d * HashSize, HashSize));
});
byte[] audit = new byte[HashSize];
Chain(dayHashes, audit);
| Method | Orders | Workers | Mean | StdDev |
|------------ |------- |-------- |--------------:|--------------:|
| PerDayChain | 200000 | 1 | 351,856.57 us | 793.487 us |
| PerDayChain | 200000 | 4 | 109,433.71 us | 3,904.916 us |
| PerDayChain | 200000 | 8 | 89,755.72 us | 4,592.320 us |
| PerDayChain | 200000 | 10 | 78,001.59 us | 8,427.606 us |Aynı makinede 10 worker artık 4,66 kat hızlandırıyor ve 8'den 10'a geçmek yine kazandırıyor. Bu bir tasarım değişikliği: denetim hash'i artık farklı bir değer, iş tarafının (Selin) gün bazlı zinciri kabul etmesi gerekiyor. Concurrency kararlarının çoğu böyledir; hızlanma koddaki bir hileden değil, verinin bağımlılık yapısını değiştirmekten gelir.
John Gustafson 1988'de Amdahl'a farklı bir açıdan baktı: gerçek hayatta core sayısı artınca genelde problem de büyür. Seri kısmın süresi sabit kalıp paralel iş core sayısıyla büyürse ölçeklenmiş hızlanma s + (1 − s) · N olur; %10 seri kısım ve 64 core için 57,7 kat. Bizim raporda bu iyimser tablo geçerli değil, çünkü tek zincirde seri kısım sipariş sayısıyla birlikte büyüyor: sipariş iki katına çıkınca zincir de iki kat uzuyor ve oran %10'da kalıyor. Gustafson'un modeli seri kısmın problem boyutundan bağımsız olduğu işlere uyar; gün bazlı zincir de raporu o tarafa yaklaştırıyor.
Üretimde Dikkat
Paralelleştirmeden önce seri oranı ölç; tahmin etme. Bizim raporda seri kısım koda bakınca küçük görünüyordu ama gerçekte sürenin %10'uydu. Stopwatch ile aşamaları ayrı ayrı ölçmek, BenchmarkDotNet'te worker sayısını parametre yapmak birkaç dakikalık iş ve sonuç doğrudan kaç core'a para vereceğine dair karar veriyor.
Sunucunun core sayısıyla uygulamanın gördüğü core sayısı aynı olmayabilir. Container'a verilen CPU limiti, VM'in vCPU sayısı ve bulutta paylaşılan core'lar, Environment.ProcessorCount'un ve thread pool'un davranışını değiştirir. İşletim Sistemi Temelleri serisinin scheduling yazısında container CPU limitinin throttling'e nasıl dönüştüğünü ölçmüştük; paralel bir job'ı CPU limiti olan bir pod'da çalıştırıyorsan Amdahl hesabını o limite göre yap.
Paralel sürümün sonucu, seri sürümün sonucuyla aynı olmalı ve bunu test et. Bizim testimiz raporu 1, 2, 4 ve 8 worker'la üretip toplamların ve denetim hash'inin birebir aynı olduğunu doğruluyor. Paralel kodun en sık hatası yavaşlık değil, sessizce yanlış sonuç üretmesidir.
[Theory]
[InlineData(2)]
[InlineData(4)]
[InlineData(8)]
public void Parallel_report_equals_single_threaded_report(int workers) =>
    Assert.Equal(MonthlyReport.Build(Orders, 1), MonthlyReport.Build(Orders, workers));
dotnet testTest run summary: Passed!
total: 10
failed: 0
succeeded: 10
skipped: 0Sık Düşülen Tuzaklar
"Daha çok thread daha hızlı" varsayımı. Ölçümde 10 worker 8 worker'dan hızlı değildi; core sayısından fazla CPU-bound thread açmak ise context switch ekler, hiçbir şey kazandırmaz. Küçük işlerde durum daha da belirgin: aynı benchmark'ta 50 siparişlik raporda 8 worker yalnız 1,8 kat hızlandırdı (85 µs'den 47 µs'ye), çünkü işi dağıtmanın ve thread'leri uyandırmanın sabit maliyeti işin kendisiyle aynı ölçekte.
Coordination maliyetini unutmak. Paralel parçaların sonuçlarını birleştirmek, ortak bir sayaca yazmak, ortak bir lock'u beklemek seri kısma eklenir ve Amdahl'ın s değerini büyütür. Bizim raporda her worker kendi index'ine yazdığı için birleştirme maliyeti yok; ortak bir Dictionary'yi lock ile güncelleseydik seri oran %10'un çok üstüne çıkardı.
Nadir sırayı imkânsız sanmak. Yüz bin denemede bir kez görülen ABABAB sırası, saniyede binlerce sipariş işleyen bir servis için günde yüzlerce kez görülen bir sıradır. Testte görmediğin bir interleaving'i "olmuyor" diye değil, "henüz denk gelmedi" diye oku.
Concurrency ile parallelism'i karıştırıp yanlış aracı seçmek. I/O bekleyen bir işi Parallel.For ile hızlandırmaya çalışmak thread pool'u bekleyen thread'lerle doldurur; orada doğru araç async/await'tir. CPU-bound bir işi async yapmak ise tek başına hiçbir şeyi hızlandırmaz.
Küçük Bir Deneme
★☆☆ observe komutunda her thread'e üç yerine on adım yazdır ve kaç farklı sıra gördüğünü 184.756 olası sırayla karşılaştır. Sonra Steps method'unun başına Thread.Sleep(1) ekleyip dağılımın nasıl değiştiğini gözle.
★★☆ report-phases komutunu 22 yerine 8 satırlık siparişlerle çalıştır. Seri oran nasıl değişti? Yeni oranla Amdahl'ın 8 worker tahmini ile benchmark'ın ölçtüğü değeri karşılaştır.
★★★ Benchmark'ı kendi makinende çalıştır ve hızlanma eğrisini çiz. Core'ların eş mi, karışık mı olduğunu öğren ve ölçümü Amdahl'dan sapan noktalar için açıklamaya çalış. Gün bazlı zincirde seri oranı Stopwatch ile ölçüp teorinin 10 worker tahminini hesapla.
Bu yazıda yirmi sıranın on sekizinde bir artışın kaybolduğunu gördük ama bunu bir simülasyonla yaptık. Bir sonraki yazıda aynı hatayı gerçek thread'lerle üretip isimlendiriyoruz: race condition ile data race neden farklı şeyler, check-then-act ve read-modify-write hataları nasıl tanınır ve bir decimal fiyat neden yarısı eski, yarısı yeni okunabilir?