

Deadlock, Livelock ve Starvation: Coffman Koşulları, Lock Ordering ve Priority Inversion
Deadlock ancak mutual exclusion, hold and wait, no preemption ve circular wait birlikte olduğunda oluşur; pratikte en kolay kırılan koşul circular wait'tir ve çözümü kilitleri global bir sırayla almaktır. Bookstore'un iki deposu arasında gerçekten kilitlenen transferi Id sırasıyla 25 ms'de bitiriyor, 1 ms'lik timeout'un 5 saniyede 621.187 timeout'lu bir livelock ürettiğini ölçüyor ve Mars Pathfinder'ın priority inversion vakasına bakıyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (C# 14) ile derlenip denenmiştir; testler xUnit v3 4.0.3 ile yazıldı. Çıktılar ARM64 (Arm'ın 64-bit işlemci mimarisi) üzerinde alınmıştır; Windows ve Linux'un priority inversion davranışı resmi dokümanlarına dayanır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'un (bir online kitapçı) İstanbul ve Ankara'da iki deposu var. Stok transferi önce kaynak deponun kilidini, sonra hedef deponun kilidini alıyor. Bir thread İstanbul'dan Ankara'ya, diğeri aynı anda Ankara'dan İstanbul'a 100.000'er kitap taşıyor. İş ne kadar sürer?
Ekipten Emre deadlock riskini görüyor ve kilitleri 1 milisaniyelik timeout ile almayı öneriyor: alamazsan bırak, baştan dene. Bu çözüm transferleri bitirir mi? Son soru: 1997'de Mars'a inen Pathfinder'ın bilgisayarı neden birkaç günde bir kendini yeniden başlattı ve mühendisler bunu Dünya'dan nasıl düzeltti? Önceki yazıda bir thread'in kilidi beklerken ilerleyemediğini kabul ettik; bu yazıda beklemenin hiç bitmediği durumlara bakıyoruz.
İki Depo, İki Kilit: Gerçek Bir Deadlock
Transfer kodu ilk bakışta masum. Kaynak depoyu kilitle, hedef depoyu kilitle, stoğu taşı:
// Önce "from", sonra "to" kilitlenir: zıt yönde iki transfer birbirini sonsuza kadar bekleyebilir
public static void Move(Warehouse from, Warehouse to, string isbn, int quantity)
{
    lock (from.Gate)
    {
        lock (to.Gate)
        {
            Apply(from, to, isbn, quantity);
        }
    }
}
Deney komutu iki thread'i zıt yönlerde çalıştırıyor ve en fazla 5 saniye bekliyor:
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- transfer naive 100000naive: not finished after 5 s; timeouts=0, east=Background, WaitSleepJoin, west=Background, WaitSleepJoinİki thread de WaitSleepJoin durumunda, yani bir kilidi bekliyor ve bu bekleyiş hiç bitmeyecek. East İstanbul'un kilidini tutup Ankara'yı bekliyor, West Ankara'yı tutup İstanbul'u bekliyor. Thread'leri background yaptığım için process kapanabildi; bir web uygulamasında bu iki thread'in tuttuğu kilitler, o depolara dokunan bütün istekleri de sonsuza kadar bekletirdi. CLR (Common Language Runtime; .NET kodunu çalıştıran runtime), Monitor kilitlerinde deadlock tespit etmez: exception yok, log yok, yalnız asılı kalmış istekler. Asılı bir process'te kilitleri tutan thread'leri bulmayı Debugging ve Problem Çözme serisinin multi-thread debugging yazısında Parallel Stacks ile göstermiştik.
Coffman'ın Dört Koşulu
Edward Coffman, Michael Elphick ve Arie Shoshani 1971'de ACM'in (Association for Computing Machinery; bilgisayar bilimi alanının uluslararası meslek kuruluşu) Computing Surveys dergisinde yayımlanan "System Deadlocks" makalesinde, deadlock'un ancak dört koşul aynı anda sağlandığında oluşabileceğini gösterdi. Değerli olan, her koşulun bir çözüm kapısı olması: dördünden birini kırarsan deadlock imkânsız hâle gelir.
| Koşul | Anlamı | Kırmanın yolu |
|---|---|---|
| Mutual exclusion | Kaynak aynı anda yalnız bir thread tarafından tutulabilir | Paylaşmamak, immutable veri, kilitsiz atomik işlem |
| Hold and wait | Thread bir kaynağı tutarken başka birini bekler | Gereken bütün kilitleri tek seferde almak ya da hiçbirini tutmadan beklemek |
| No preemption | Tutulan kaynak zorla geri alınamaz | Timeout ile alamayınca tuttuğunu bırakmak |
| Circular wait | Thread'ler bir döngü içinde birbirini bekler | Bütün kilitleri global bir sırayla almak |
İlk üç koşul kilitli programlarda neredeyse her zaman doğrudur; kilit zaten mutual exclusion içindir, iç içe kilit hold and wait'tir ve lock elinden alınamaz. Bu yüzden pratikte en çok kırılan koşul dördüncüsü: circular wait.
Resource Allocation Graph ve Cycle
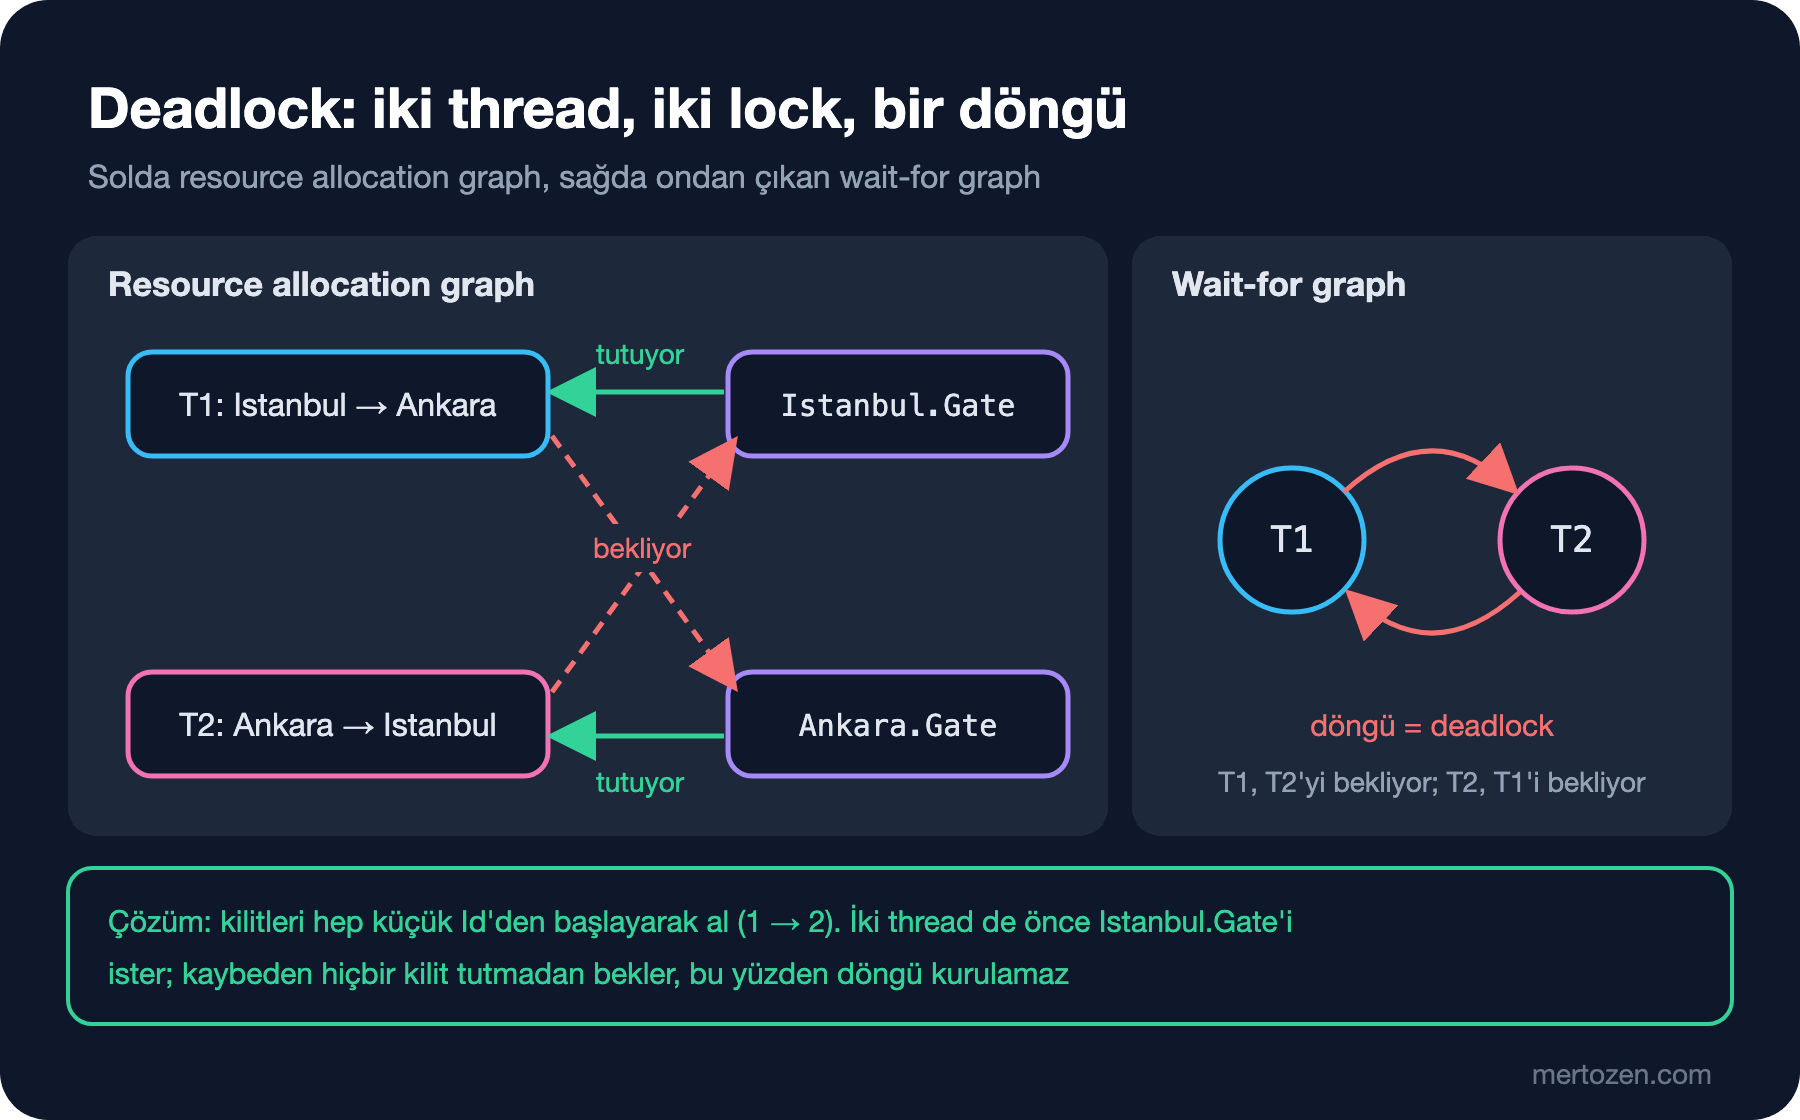
Deadlock'u görselleştirmenin standart yolu resource allocation graph: thread'ler ve kaynaklar düğüm, "tutuyor" ve "bekliyor" ilişkileri kenar. Kaynak düğümlerini çıkarıp yalnız "T1, T2'yi bekliyor" kenarlarını bırakırsan wait-for graph elde edersin. Her kaynağın tek bir örneği varsa, wait-for graph'ta bir cycle olması deadlock olması demektir:
Cycle aramak basit bir depth-first search. Veritabanlarının deadlock tespiti de temelde budur:
// Derinlik öncelikli arama; bulunan ilk cycle'ı ya da boş liste döner
private List<string> Visit(string node, List<string> path, HashSet<string> done)
{
    int index = path.IndexOf(node);
    if (index >= 0)
        return [.. path[index..], node];
    if (!done.Add(node))
        return [];
    path.Add(node);
    foreach (string next in _edges.GetValueOrDefault(node) ?? [])
    {
        List<string> cycle = Visit(next, path, done);
        if (cycle.Count > 0)
            return cycle;
    }
    path.RemoveAt(path.Count - 1);
    return [];
}
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- wait-forcycle: T1 (Istanbul->Ankara) -> T2 (Ankara->Istanbul) -> T1 (Istanbul->Ankara)Graph'a T1'i bekleyen bir rapor thread'i (T3) de ekledim. T3 cycle'ın parçası değil ama o da sonsuza kadar bekliyor: deadlock yalnız döngüdeki thread'leri değil, onlara bağlı olan her şeyi durdurur.
Prevention: Global Lock Ordering
Circular wait'i kırmanın yolu, bütün kilitlere bir sıra vermek ve her thread'in kilitleri yalnız bu sırayla almasını sağlamak. Depoların Id'si doğal bir sıra:
// Global kilit sırası: yön ne olursa olsun önce küçük Id
public static void MoveOrdered(Warehouse from, Warehouse to, string isbn, int quantity)
{
    (Warehouse first, Warehouse second) = from.Id < to.Id ? (from, to) : (to, from);
    lock (first.Gate)
    {
        lock (second.Gate)
        {
            Apply(from, to, isbn, quantity);
        }
    }
}
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- transfer ordered 100000ordered: finished in 25 ms, total stock=2,000,000, timeouts=0200.000 transfer 25 ms'de bitti ve toplam stok korundu. Neden çalıştığını şekilde de görebilirsin: iki thread de önce İstanbul'un kilidini ister. Kaybeden hiçbir kilit tutmadan bekler, kazanan ise ikinci kilidi kimse tutmadığı için alır. Bir thread'in tuttuğu kilitler her zaman beklediği kilitten küçük olduğundan, beklemeler hep büyüyen Id yönünde ilerler ve döngü kapanamaz.
Klasik Dining Philosophers problemi aynı fikrin genellemesi. Dijkstra'nın 1965'te bir sınav sorusu olarak sorduğu ve Hoare'un bugünkü masa ve çatal hikâyesiyle yaygınlaştırdığı problemde beş filozof yuvarlak masada oturur, aralarında beş çatal vardır ve yemek için iki çatal gerekir. Herkes önce solundaki, sonra sağındaki çatalı alırsa, herkesin bir çatal tuttuğu ve diğerini beklediği bir döngü oluşabilir. Çözüm yine sıralama: herkes önce numarası küçük olan çatalı alır. Bu, son filozofun önce sağındaki çatalı alması demektir ve döngü kırılır:
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- philosophersleft then right table froze (deadlock)
ordered forks all ate in 166 msAvoidance, Detection ve Timeout
Prevention, deadlock'u tasarımla imkânsız kılar. Avoidance ise her kilit isteğinde "bunu verirsem ileride deadlock'a gidebilir miyiz?" diye bakar. En bilinen örneği Dijkstra'nın Banker's algoritması: her thread en fazla ne kadar kaynak isteyeceğini önceden bildirir ve sistem bir isteği yalnız, sonrasında herkesin işini bitirebileceği bir sıra hâlâ varsa onaylar. Bankacının kredi verirken kasada herkesin ihtiyacını sırayla karşılayacak kadar para bırakması gibi. Pratikte nadir görülür, çünkü uygulama kodu hangi kilitlere ne kadar ihtiyaç duyacağını önceden bilmez ve her istekte bu hesabı yapmak pahalıdır.
Detection and recovery deadlock'a izin verir, sonra onu bulup çözer. Veritabanları bu yolu seçer: SQL Server periyodik olarak wait-for graph'ta cycle arar, bulduğunda bir transaction'ı kurban seçip geri alır ve uygulama 1205 hatası alır. Bunu deadlock graph'ı ve .NET'te retry ile birlikte SQL Server Derinlemesine serisinin deadlock yazısında anlatmıştık. Uygulama kodunda kilitler için böyle bir mekanizma yok; bu yüzden tasarımla önlemek gerekir.
Üçüncü yol timeout: kilidi belirli sürede alamazsan elindekini bırak. Bu, no preemption koşulunu kırar; thread kaynağı gönüllü olarak geri verir:
// Sonsuza kadar beklemek yerine timeout: başarısızlıkta ne yapılacağına çağıran karar verir
public static bool TryMove(Warehouse from, Warehouse to, string isbn, int quantity, TimeSpan timeout)
{
    if (!Monitor.TryEnter(from.Gate, timeout))
        return false;
    try
    {
        if (!Monitor.TryEnter(to.Gate, timeout))
            return false;
        try
        {
            Apply(from, to, isbn, quantity);
            return true;
        }
        finally { Monitor.Exit(to.Gate); }
    }
    finally { Monitor.Exit(from.Gate); }
}
Emre'nin önerisini aynen uyguladım: başarısız olursa hemen tekrar dene. İkinci sürüm ise başarısızlıktan sonra 0–2 ms arası rastgele bir süre uyuyor:
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- transfer timeout 100000
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- transfer timeout-backoff 100000
timeout: not finished after 5 s; timeouts=621,187, east=Background, WaitSleepJoin, west=Background, WaitSleepJoin
timeout-backoff: finished in 16 ms, total stock=2,000,000, timeouts=3Deadlock yok ama iş de bitmedi: 5 saniyede 621.187 timeout. İki thread aynı anda ilk kilidi alıyor, ikisi de ikinci kilitte zaman aşımına uğruyor, ikisi de bırakıp aynı anda tekrar deniyor. Bu, deadlock'un kardeşi livelock: thread'ler bloklanmıyor, sürekli bir şey yapıyorlar ama kimse ilerlemiyor. 1.000 transferle denediğimde iş 184 ms'de, 8.368 timeout ile bitti; yani tamamen durmuyor ama ilerleme rastlantıya kalıyor. Rastgele backoff simetriyi bozuyor ve aynı iş 3 timeout ile 16 ms'de bitiyor. Ethernet'in çarpışma sonrası rastgele bekleme süresi de aynı fikre dayanır.
Livelock ve Starvation
Livelock'u daha net görmek için iki kibar thread yazdım: her biri kendi kilidini tutup diğerininkini beklemeden dener, alamazsa kendi kilidini bırakıp hemen yeniden dener. Koridorda karşılaşıp ikisi de aynı anda aynı tarafa çekilen iki kişi gibi:
dotnet run -c Release --project src/Bookstore.ConcurrencyLab -- livelock 100000retry at once transfers=200,000 retries=73,258 time=12 ms
random backoff transfers=200,000 retries=682 time=3 msHemen tekrar deneyen sürüm 200.000 transfer için 73.258 kez geri çekildi; rastgele bekleyen sürüm 682 kez. Bu deneyde ikisi de bitiyor, çünkü OS scheduler'ı thread'leri tam simetrik çalıştırmıyor. Gerçek sistemlerde livelock genelde "tamamen durdu" değil, "yük artınca verimin aniden çöktüğü" bir durum olarak görünür.
Starvation ise sistem bir bütün olarak ilerlerken belirli bir thread'in sürekli geri kalmasıdır. Önceki yazıdaki test-and-set kilidi bounded waiting sağlamıyordu; şanssız bir thread yarışı hep kaybedebilir. .NET'in Monitor dokümanına göre kilit bırakıldığında onu alacak thread, sinyal verilen thread olmak zorunda değildir; yani sıra garantisi yoktur. Bu, verim için bilinçli bir tercih: kilidi o anda isteyen çalışır durumdaki thread'e vermek, uyuyan bir thread'i uyandırıp beklemekten hızlıdır. Fairness gerekiyorsa (örneğin kurumsal müşterilerin istekleri bireysel müşterilerin arkasında sonsuza kadar beklememeli) bunu kilitten değil, açık bir kuyruk tasarımından beklemelisin.
Priority Inversion: Mars Pathfinder
Thread'lere öncelik verildiğinde ortaya çıkan özel bir starvation türü var. Düşük öncelikli L bir kilidi tutuyor, yüksek öncelikli H aynı kilidi bekliyor. Bu sırada kilitle hiç ilgisi olmayan orta öncelikli M çalışmaya hazır hâle geliyor. Scheduler önceliğe baktığı için M'yi L'nin önüne koyuyor; L çalışamadığı için kilidi bırakamıyor ve H, kendisinden düşük öncelikli M yüzünden bekliyor. Öncelikler fiilen ters dönmüş oluyor.
Bunun en bilinen vakası Mars Pathfinder. Uzay aracı 4 Temmuz 1997'de Mars'a indi ve birkaç gün sonra bilgisayarı ara ara kendini yeniden başlatmaya başladı. Uçuş yazılımından sorumlu mühendis Glenn Reeves'in Aralık 1997'de yazdığı açıklamaya göre VxWorks gerçek zamanlı işletim sistemi üzerinde çalışan yazılımda, veri yolunu yöneten yüksek öncelikli bir görev, meteoroloji verisini taşıyan düşük öncelikli bir görevin tuttuğu bir mutex'i bekliyordu; orta öncelikli görevler düşük öncelikliyi sürekli önüne geçtiği için yüksek öncelikli görev zamanında bitemiyor, bunu fark eden zamanlama kontrolü de sistemi sıfırlıyordu. Ekip hatayı Dünya'daki bir kopya üzerinde, uçuş yazılımında bilerek bırakılmış trace altyapısıyla 18 saatten kısa sürede yeniden üretti. Çözüm, ilgili semaphore'lar için kapalı olan priority inheritance seçeneğini bir global değişkeni değiştirerek açmaktı; değişiklik araca yama olarak gönderildi ve resetler durdu.
Priority inheritance'ın fikri basit: bir kilidi tutan thread, o kilidi bekleyenlerin en yüksek önceliğini geçici olarak devralır. L, H'nin önceliğiyle çalışır, M onu geçemez, L kilidi bırakır ve önceliği geri düşer. Microsoft Learn'deki "Priority Inversion" sayfasına göre Windows bunu AutoBoost adlı özellikle yapıyor: kaynak sahipliğini izleyip kilit sahibine bekleyenlerin en yüksek önceliğini taban olarak veriyor. Linux'ta ise pthread mutex'leri için bu protokol PTHREAD_PRIO_INHERIT ile açıkça seçilir. .NET uygulamalarında ders şu: Thread.Priority ile oynamak nadiren iyi bir fikirdir; aynı kilidi paylaşan thread'lere farklı öncelik vermek bu problemi kendi elinle kurmak demektir.
Üretimde Dikkat
Lock ordering'i bir kural olarak yaz ve kodla zorla. "Depo kilitleri Id sırasıyla alınır" cümlesi bir code review notunda kalırsa altı ay sonra unutulur. Kilitleri alan tek bir yardımcı method (bizim MoveOrdered gibi) yaz, iki kilidi elle iç içe almayı yasakla.
Kilit tutarken dışarıdaki kodu çağırma. Bir kilit içinden event tetiklemek, callback çağırmak ya da sanal bir method'u çağırmak, kilit sırasını o kodu yazan kişiye bırakmaktır. Warehouse kilidini tutarken StockChanged event'ini tetiklersen ve bir subscriber raporlama için başka bir deponun kilidini alırsa, kodunda hiç görünmeyen bir iç içe kilit oluşur. Event'i kilitten çıktıktan sonra tetikle.
Asılı istekleri bir metrik olarak izle. Deadlock exception üretmez; belirtisi, belirli bir endpoint'in süresinin aniden timeout sınırına dayanması ve thread pool'un büyümesidir. Böyle bir durumda process'ten dump alıp bekleyen thread'lerin hangi kilitleri tuttuğuna bakmak, tahmin yürütmekten hızlıdır.
Sık Düşülen Tuzaklar
Timeout'u deadlock çözümü sanmak. Deneyde timeout deadlock'u yok etti ama yerine 5 saniyede 621.187 timeout'lu bir livelock koydu. Timeout ancak rastgele backoff ve bir üst deneme sınırıyla birlikte işe yarar; asıl çözüm kilit sırası.
İç içe kilitleri code review'da görmemek. lock içinde başka bir lock ya da kilit alan bir method çağrısı gördüğünde iki soru sor: bu iki kilit başka bir yerde ters sırayla alınıyor mu, ve bu sıra yazılı bir kurala dayanıyor mu? Çoğu deadlock iki farklı dosyadaki iki masum method'un birleşimidir.
Testlerde deadlock'u ancak şanslıysan görmek. Bizim deneyde naive transfer her seferinde kilitlendi, çünkü iki thread'i bir bariyerle aynı anda başlatıp 100.000 kez denedik. Gerçek kodda aynı iki transfer günde bir kez aynı anda gelir ve deadlock ayda bir olur. Bu yüzden deadlock'tan korunmanın yolu test değil, sıralama kuralının kendisi.
Küçük Bir Deneme
★☆☆ philosophers komutundaki sıralı çözümde masaya altıncı bir filozof ekle ve yine donmadığını doğrula. Neden çatal sayısından bağımsız olarak çalıştığını bir cümleyle açıkla.
★★☆ Üç depolu bir senaryo kur: T1 İstanbul→Ankara, T2 Ankara→İzmir, T3 İzmir→İstanbul. Naive transfer ile üç thread'lik bir cycle oluştuğunu gözle, aynı cycle'ı WaitForGraph ile kur ve FindCycle'ın döndürdüğü yolu yazdır.
★★★ TryMove'a üstel artan rastgele backoff ve en fazla 10 deneme ekle; 10 denemede başaramazsa bir exception fırlatsın. 1, 10 ve 100 mikrosaniyelik başlangıç beklemeleri ile toplam süreyi ve timeout sayısını ölç, en iyi değeri hangi faktörlerin belirlediğini tartış.
İlk dört yazıda hep "bir thread'in yazdığını diğeri görür" diye düşündük; yalnız Peterson'da bu varsayımın bozulduğunu gördük. Serinin sıradaki yazısında donanımın kendisine iniyoruz: store buffer, cache coherence, sequential consistency ve x64 ile ARM64'ün bellek sıralama modelleri neden farklı davranıyor.