

YARP'ta Load Balancing, Health Check ve Session Affinity
YARP'ta yavaş bir instance'a karşı PowerOfTwoChoices ve LeastRequests trafiği kendiliğinden kaydırır; passive health check yalnız transport hatalarını sayar ve reactivation süresi 60 saniyelik pencereden kısa olamaz, bu yüzden active check ile birlikte kullanılmalıdır. Catalog'un üç instance'ında policy'leri ölçüyor, zone'a göre seçen kendi policy'mizi yazıyor, HealthyOrPanic'i, HashCookie affinity'yi, service discovery'yi ve HTTP/2 ile ActivityTimeout tuzaklarını gerçek loglarla gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Yarp.ReverseProxy 2.3 ve Microsoft.Extensions.ServiceDiscovery.Yarp 10.11 ile derlenip denenmiştir.
Önce Tahmin Et
Catalog service'inin üç instance'ı var ve biri, catalog-2, her isteğe 50 ms gecikmeyle cevap veriyor. Gateway'e 20 paralel bağlantıyla 600 istek atıyorsun. Load balancing policy RoundRobin olsaydı catalog-2 kaç istek alırdı? PowerOfTwoChoices olsaydı?
İkinci soru: cluster'da passive health check açık ve ReactivationPeriod değerini 00:00:10 yazdın. catalog-2'yi öldürüyorsun, gateway onu devre dışı bırakıyor, sonra process'i hemen yeniden başlatıyorsun. Gateway catalog-2'ye kaç saniye sonra tekrar trafik gönderir? İkisinin de cevabı ölçülerek verildi ve ikincisi YARP (Yet Another Reverse Proxy; .NET için reverse proxy library'si) dokümantasyonunu okuyarak tahmin edeceğin sayı değil.
Üç Catalog Instance'ı ve Küçük Bir Ölçüm Aracı
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için kurduğumuz gateway'de şimdiye kadar her cluster'da tek destination vardı. Catalog service'ini üç instance'a çıkarıyoruz. Hangi instance'ın cevap verdiğini görmek için Catalog her cevaba X-Catalog-Instance header'ı ekliyor; yavaş bir instance'ı taklit etmek için de config'ten gecikme okuyor:
app.Use(async (context, next) =>
{
    context.Response.Headers[InstanceInfo.Header] = instance.Name;
    if (instance.ResponseDelayMs > 0 && context.Request.Path.StartsWithSegments("/books"))
    {
        await Task.Delay(instance.ResponseDelayMs, context.RequestAborted);
    }
    await next();
});

app.MapHealthChecks("/health");
Instance adı ve port launchSettings.json'daki üç profilden geliyor (http, catalog-2, catalog-3; portlar 5301, 5311, 5312). Gateway'in cluster tanımı da üç destination'a çıktı:
dotnet run --project src/Bookstore.Catalog.Api
dotnet run --project src/Bookstore.Catalog.Api --launch-profile catalog-2
dotnet run --project src/Bookstore.Catalog.Api --launch-profile catalog-3
"catalog": {
"LoadBalancingPolicy": "PreferSameZone",
"HealthCheck": {
"AvailableDestinationsPolicy": "HealthyOrPanic",
"Active": {
"Enabled": true,
"Interval": "00:00:05",
"Timeout": "00:00:02",
"Policy": "ConsecutiveFailures",
"Path": "/health"
},
"Passive": {
"Enabled": true,
"Policy": "TransportFailureRate",
"ReactivationPeriod": "00:01:00"
}
},
"HttpRequest": {
"ActivityTimeout": "00:00:30"
},
"Metadata": {
"ConsecutiveFailuresHealthPolicy.Threshold": "2",
"TransportFailureRateHealthPolicy.RateLimit": "0.5"
},
"Destinations": {
"catalog-1": { "Address": "http://localhost:5301/", "Metadata": { "Zone": "zone-a" } },
"catalog-2": { "Address": "http://localhost:5311/", "Metadata": { "Zone": "zone-a" } },
"catalog-3": { "Address": "http://localhost:5312/", "Metadata": { "Zone": "zone-b" } }
}
}Bu config'in her satırını yazı boyunca açacağız. Dağılımı ölçmek için repo'ya tools/Bookstore.LoadProbe adında küçük bir console uygulaması ekledim: verilen URL'ye belirli bir paralellikle istek atıyor ve cevapları X-Catalog-Instance header'ına ve status code'a göre sayıyor. Windows'ta da aynı komutla çalışıyor:
dotnet run --project tools/Bookstore.LoadProbe -- http://localhost:5300/api/v1/books 600 20Load Balancing Policy'leri: Ölçerek Karşılaştırmak
YARP beş hazır policy ile geliyor ve hiçbir şey yazmazsan PowerOfTwoChoices kullanılıyor. catalog-2'yi 50 ms gecikmeyle başlattım ve cluster'ın LoadBalancingPolicy değerini gateway çalışırken dört kez değiştirdim (02'de gördüğümüz canlı reload sayesinde gateway'i yeniden başlatmadan). Her seferinde 600 istek, 20 paralel bağlantı:
| Policy | catalog-1 | catalog-2 (yavaş) | catalog-3 | Toplam süre | p95 |
|---|---|---|---|---|---|
RoundRobin | 200 | 200 | 200 | 1,1 sn | 53 ms |
Random | 207 | 209 | 184 | 1,1 sn | 53 ms |
PowerOfTwoChoices | 305 | 5 | 290 | 0,1 sn | 1 ms |
LeastRequests | 336 | 4 | 260 | 0,1 sn | 0 ms |
"Önce Tahmin Et"in ilk sorusunun cevabı tabloda: RoundRobin yavaş instance'a da tam üçte bir pay veriyor ve p95 gecikme o instance'ın gecikmesine yapışıyor. PowerOfTwoChoices rastgele iki destination seçip o anda daha az eşzamanlı isteği olanı alıyor; LeastRequests ise bütün destination'lara bakıp en az eşzamanlı isteği olanı seçiyor. Yavaş instance'ta istekler daha uzun süre "açık" kaldığı için ikisi de onu doğal olarak az seçiyor. İkisinin farkı ölçekte: LeastRequests her istekte bütün listeyi tarıyor, PowerOfTwoChoices yalnız ikisine bakıyor ve büyük cluster'larda bütün gateway instance'larının aynı "en boş" destination'a yığılmasını da azaltıyor. Varsayılanın bu olması bu yüzden mantıklı. Beşinci policy FirstAlphabetical, ID'si alfabetik olarak ilk sıradaki sağlıklı destination'ı seçiyor; bir yük dağıtımı değil, aktif-pasif failover kurmak için kullanılır.
Bir uyarı: bu sayılar tek makinede, localhost üzerinde ve çok küçük bir payload ile alındı. Senin ortamındaki sayılar farklı olacak; tablonun gösterdiği şey mutlak değerler değil, policy'lerin yavaş bir destination'a tepkisi.
Kendi Load Balancing Policy'n: Aynı Zone'u Tercih Etmek
Hazır policy'ler destination'ların nerede durduğunu bilmiyor. Bookstore'un instance'ları iki zone'a dağılmış olsun: gateway zone-a'da, catalog-1 ve catalog-2 de orada, catalog-3 ise zone-b'de. Zone'lar arası trafik hem gecikme hem de bulut faturası demek. İstediğimiz şey: aynı zone'da sağlıklı destination varsa onlar arasında seç, kalmadıysa diğer zone'a geç. ILoadBalancingPolicy tek bir method'dan ibaret:
public sealed class PreferSameZonePolicy(IConfiguration configuration) : ILoadBalancingPolicy
{
    public const string PolicyName = "PreferSameZone";
    public const string ZoneMetadataKey = "Zone";

    private readonly string? _zone = configuration["Gateway:Zone"];

    public string Name => PolicyName;

    public DestinationState? PickDestination(
        HttpContext context, ClusterState cluster, IReadOnlyList<DestinationState> availableDestinations)
    {
        if (availableDestinations.Count == 0)
        {
            return null;
        }

        List<DestinationState> local = [];
        foreach (DestinationState destination in availableDestinations)
        {
            if (destination.Model.Config.Metadata?.GetValueOrDefault(ZoneMetadataKey) == _zone)
            {
                local.Add(destination);
            }
        }

        IReadOnlyList<DestinationState> candidates = local.Count > 0 ? local : availableDestinations;
        if (candidates.Count == 1)
        {
            return candidates[0];
        }

        // PowerOfTwoChoices gibi: rastgele iki aday, eşzamanlı isteği az olan kazanır
        int first = Random.Shared.Next(candidates.Count);
        int second = Random.Shared.Next(candidates.Count - 1);
        if (second >= first)
        {
            second++;
        }

        DestinationState a = candidates[first];
        DestinationState b = candidates[second];
        return a.ConcurrentRequestCount <= b.ConcurrentRequestCount ? a : b;
    }
}

// Program.cs
builder.Services.AddSingleton<ILoadBalancingPolicy, PreferSameZonePolicy>();
Policy DI (Dependency Injection; bağımlılıkların dışarıdan verilmesi) container'ına singleton olarak ekleniyor ve cluster config'inde Name değeriyle seçiliyor. Önemli nokta: availableDestinations listesi health check'lerden sonra kalan destination'lar. Yani policy sağlık durumuyla uğraşmıyor; "aynı zone'da kimse kalmadı" durumu sağlık kontrolünün doğal sonucu oluyor. Gecikme olmadan 600 istek:
600 requests, concurrency 20, 0.1 s
p50 0 ms, p95 1 ms
  catalog-1      296
  catalog-2      304
  status 200     600
catalog-3 hiç istek almadı. Bu method her istekte çalışıyor; içinde I/O, lock ya da pahalı bir hesaplama olmamalı. Burada küçük bir List ayırıyoruz, üç destination için önemsiz; yüzlerce destination'lı bir cluster'da zone listesini config değiştiğinde önceden hesaplamak daha doğru olur.
Active ve Passive Health Check
Active: periyodik probe
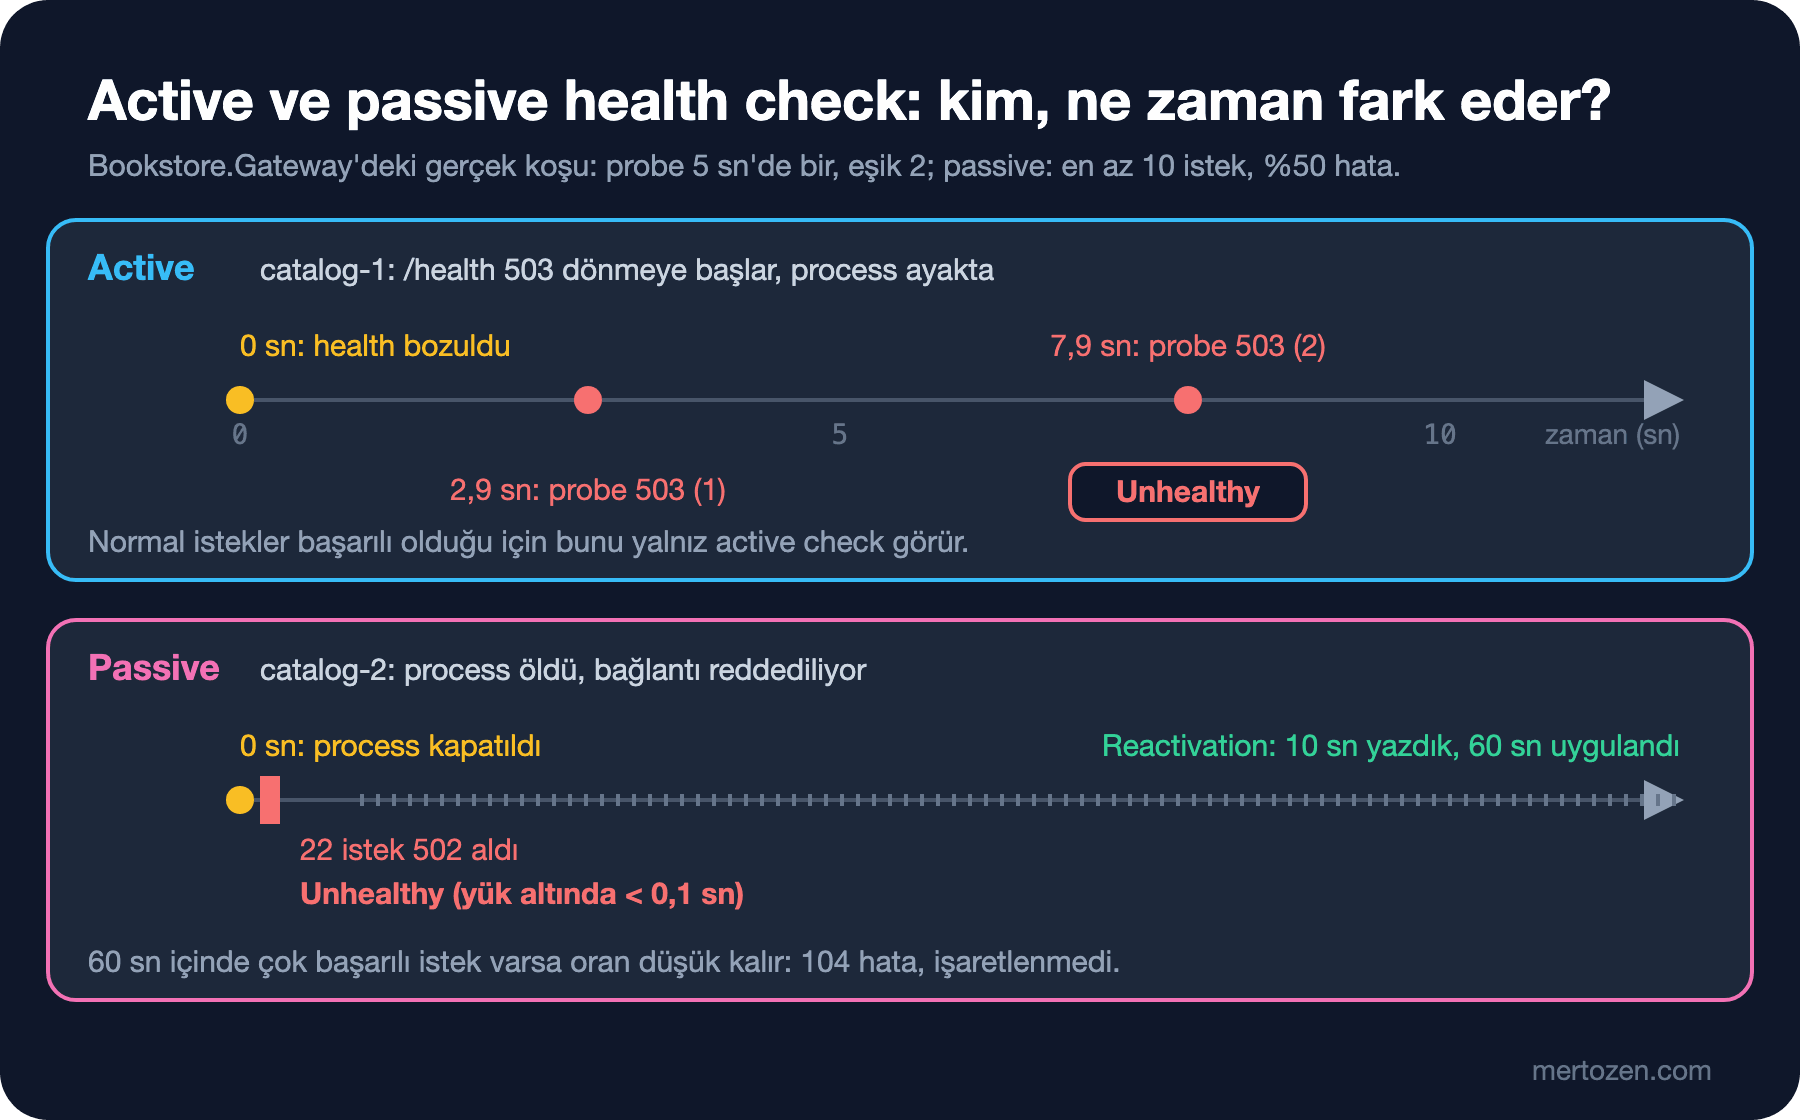
Active health check, gateway'in her destination'a belirli aralıklarla kendisinin istek atmasıdır. Bizim config'imizde her 5 saniyede bir /health çağrılıyor, 2 saniyede cevap gelmezse probe başarısız sayılıyor ve ConsecutiveFailures policy'si art arda 2 başarısız probe'da destination'ı Unhealthy yapıyor (eşik metadata'daki ConsecutiveFailuresHealthPolicy.Threshold; varsayılan da 2). YARP'ın varsayılan aralığı 15 saniye, timeout'u 10 saniye. /health endpoint'ini nasıl yazacağımızı, liveness ile readiness ayrımını ASP.NET Core Web API serisinin Health Check yazısında anlattık; gateway için doğru olan readiness, yani "bu instance trafik almaya hazır mı" sorusunun cevabı.
Catalog'a yalnız Development'ta açık bir endpoint ekledim; health check'i process'i öldürmeden bozuyor. catalog-1'in health'ini bozduğum an 13:47:02.3; gateway logu:
13:47:05.193 info: Yarp.ReverseProxy.Health.ActiveHealthCheckMonitor[16]
      Probing destination `catalog-1[localhost:5301]` on cluster `catalog` completed with the response code `503`.
13:47:10.198 info: Yarp.ReverseProxy.Health.ActiveHealthCheckMonitor[16]
      Probing destination `catalog-1[localhost:5301]` on cluster `catalog` completed with the response code `503`.
13:47:10.201 warn: Yarp.ReverseProxy.Health.DestinationHealthUpdater[49]
      Active health state of destination `catalog-1[localhost:5301]` on cluster `catalog` is set to 'Unhealthy'.
Yaklaşık 8 saniye sonra catalog-1 devreden çıktı ve sonraki 600 isteğin hepsi catalog-2'ye gitti. Bu durumda catalog-1'e giden normal istekler hâlâ başarılıydı; bunu yalnız active check görebilirdi. Örneğin veritabanı bağlantısını kaybetmiş ama kitap listesini hâlâ cache'ten dönen bir instance tam olarak böyle görünür.
Passive: gerçek trafiğe bakmak
Passive health check ayrı bir istek atmıyor; proxy'lenen isteklerin sonucuna bakıyor. TransportFailureRate policy'si bir destination'a giden isteklerin son 60 saniyedeki hata oranını hesaplıyor ve oran limiti aştığında destination'ı devre dışı bırakıyor. Burada "hata" 5xx demek değil. YARP'ın kaynak kodunda sayılan durumlar bağlantı kurulamaması, timeout ve body'nin backend tarafında kopması gibi transport hataları; backend'in bilerek döndüğü 500 bu sayıya girmiyor. Değerlendirme için pencerede en az 10 istek olması gerekiyor ve limit varsayılan olarak %30; biz metadata ile %50 yaptık.
Ölçümü temiz yapmak için active check'i kapattım, gateway'i yeniden başlattım (geçmişi sıfırlamak için), catalog-2'yi öldürdüm ve hemen 600 istek attım:
600 requests, concurrency 20, 0.1 s
p50 0 ms, p95 1 ms
  (none)          22
  catalog-1      578
  status 200     578
  status 502      22

warn: Yarp.ReverseProxy.Health.DestinationHealthUpdater[19]
      Destination `catalog-2[localhost:5311]` marked as 'Unhealthy` by the passive health check is scheduled for a reactivation in `00:01:00`.
22 istek 502 aldı, sonra catalog-2 devreden çıktı. Active check bunu 5 ile 10 saniye arasında görürdü; yük altında passive check çok daha hızlı. Ama aynı deneyi, gateway birkaç saniye önce catalog-2'ye 600 başarılı istek göndermişken tekrarladığımda sonuç farklıydı: 104 istek 502 aldı ve passive check catalog-2'yi hiç işaretlemedi. Oran son 60 saniyedeki bütün isteklere göre hesaplandığı için 104 hata, 600 başarının yanında %50'ye ulaşmadı. Trafiği yüksek bir instance'ın aniden ölmesi tam olarak bu durum; bu yüzden passive check'i tek başına bırakma, active check ile birlikte kullan.
"Önce Tahmin Et"in ikinci sorusu da logda: ReactivationPeriod değerini 10 saniyeye çektiğimde bile log reactivation in 00:01:00 yazdı ve yeniden ayağa kaldırdığım catalog-2 ilk trafiğini 60 saniyeden sonra aldı. YARP'ın kaynak kodunda reactivation süresi, policy'nin 60 saniyelik DetectionWindowSize değerinden kısa olamıyor; amaç eski hata geçmişinin yeni değerlendirmeyi etkilememesi. Daha kısa bir süre istiyorsan TransportFailureRateHealthPolicyOptions üzerinden pencereyi küçültmen gerekiyor.
Hepsi sağlıksızsa: HealthyOrPanic
Üç instance'ın health'ini birden bozdum. YARP 2.1'den beri varsayılan AvailableDestinationsPolicy değeri HealthyOrPanic: sağlıklı destination kalmadığında "panik" moduna geçip hepsini kullanılabilir sayıyor. Sonra policy'yi HealthyAndUnknown yaptım:
== HealthyOrPanic
  catalog-1      162
  catalog-2      138
  status 200     300
      Route catalog-v1 -> cluster catalog, 3 available destination(s)
== HealthyAndUnknown
  (none)         300
  status 503     300
      Route catalog-v1 -> cluster catalog, 0 available destination(s)
warn: Yarp.ReverseProxy.LoadBalancing.LoadBalancingMiddleware[7]
      No available destinations after load balancing for cluster 'catalog'.
Hangisi doğru, health endpoint'ine ne kadar güvendiğine bağlı. Health check'in kendisi bozuksa (yanlış path, yavaş bir bağımlılık kontrolü) HealthyOrPanic siteyi ayakta tutar. Health check'e güveniyorsan ve bozuk instance'a istek göndermek veri hatasına yol açabiliyorsa HealthyAndUnknown ile hızlı ve açık bir 503 daha iyidir.
Session Affinity: Ne Zaman Gerekir?
Session affinity, aynı istemcinin isteklerini hep aynı destination'a göndermek demek. YARP'ta cluster bazında açılıyor; 2.0'dan beri varsayılan policy HashCookie:
"SessionAffinity": {
  "Enabled": true,
  "Policy": "HashCookie",
  "FailurePolicy": "Redistribute",
  "AffinityKeyName": ".Bookstore.Catalog.Affinity",
  "Cookie": {
    "HttpOnly": true,
    "SameSite": "Lax",
    "SecurePolicy": "SameAsRequest"
  }
}
Set-Cookie: .Bookstore.Catalog.Affinity=d673564b930708ae; path=/; samesite=lax; httponly
X-Catalog-Instance: catalog-2
X-Catalog-Instance: catalog-2
X-Catalog-Instance: catalog-2İlk cevap cookie'yi set etti, sonraki bütün istekler catalog-2'ye gitti. Cookie'deki değer destination ID'sinin hash'i. ArrCookie aynı işi IIS'in (Internet Information Services; Microsoft'un Windows için web sunucusu) ARR (Application Request Routing; IIS'in reverse proxy modülü) cookie formatıyla yapıyor, eski bir IIS kurulumundan geçerken işe yarar. Dokümantasyon iki cookie'nin de güçlü gizlilik sağlamadığını, destination ID'sine hassas bilgi koymamak gerektiğini açıkça yazıyor. Sonra catalog-2'yi öldürdüm:
HTTP/1.1 502 Bad Gateway
# 12 sn sonra:
HTTP/1.1 200 OK
Set-Cookie: .Bookstore.Catalog.Affinity=e76da95c600cb57c; path=/; samesite=lax; httponly
X-Catalog-Instance: catalog-1

warn: Yarp.ReverseProxy.SessionAffinity.HashCookieSessionAffinityPolicy[39]
      Destination matching to the request affinity key is not found on cluster `catalog`. Configured failure policy will be applied.
Health check destination'ı işaretleyene kadar affinity isteği ölü instance'a göndermeye devam etti. İşaretlendikten sonra Redistribute policy'si isteği başka bir destination'a verdi ve cookie'yi yeniledi. Kullanıcının o instance'ın belleğindeki durumu ise kayboldu; affinity bir garanti değil, bir tercih.
O yüzden Bookstore'un Catalog'unda affinity'yi kapalı tutuyoruz; snapshot'taki config'de yok. Gerçekten gereken yerler sınırlı: SignalR'ın WebSocket dışı transport'ları (long polling, server-sent events) bağlantı boyunca aynı sunucuya gitmek zorunda; bunu Real-time Uygulamalar serisinin SignalR'ı scale-out etmek yazısında konuştuk. Bellekte session tutan eski bir uygulamayı geçiş sürecinde ayakta tutmak da bir sebep (06'da strangler fig'de göreceğiz). Bunların dışında doğru çözüm state'i paylaşılan bir yere (Redis, veritabanı) taşımak ve service'i stateless tutmak.
Destination'ları Dinamik Bulmak
Adresleri config'e elle yazmak üç sabit instance için yeterli; instance sayısı değişiyorsa değil. YARP 2.1 ile gelen IDestinationResolver, config'teki destination'ları gerçek adreslere genişleten bir genişleme noktası. YARP'ın kendi içinde bir DNS resolver'ı var (AddDnsDestinationResolver): host adını çözüp her IP için ayrı bir destination oluşturuyor ve varsayılan olarak 5 dakikada bir yeniliyor. Bookstore'da Microsoft.Extensions.ServiceDiscovery kütüphanesinin YARP entegrasyonunu kullanıyoruz; yazıyı yazdığım gün NuGet'te 11.0.0 da var, ama .NET 10 tabanına uygun olan 10.11.0'ı seçtik. Ordering cluster'ı artık adres değil, mantıksal bir isim kullanıyor:
// Program.cs
builder.Services.AddServiceDiscovery();

builder.Services.AddReverseProxy()
    .LoadFromConfig(builder.Configuration.GetSection("ReverseProxy"))
    .AddTransforms(InternalHeaderTransforms.Apply)
    .AddConfigFilter<DestinationAddressFilter>()
    .AddServiceDiscoveryDestinationResolver();

// appsettings.json
"Services": {
  "ordering": {
    "http": [ "localhost:5302" ]
  }
},
"ReverseProxy": {
  "Clusters": {
    "ordering": {
      "Destinations": {
        "ordering": { "Address": "http://ordering" }
      }
    }
  }
}
curl http://localhost:5300/api/v1/orders/1001
{"id":1001,"customerEmail":"ada@example.com","total":605.50,"status":"Shipped"}
Forwarded to ordering[localhost:5302], status 200Resolver http://ordering adresini configuration'daki Services:ordering:http listesine göre çözdü ve destination ID'sini ordering[localhost:5302] yaptı. Geliştirmede liste config'ten geliyor; Kubernetes'te ya da Azure Container Apps'te aynı kod, platformun DNS'ine düşen pass-through provider ile çalışıyor. Client-side ve server-side discovery farkını Microservices serisinin Service Discovery yazısında anlattık. Aspire ile bu adresler otomatik dolduruluyor, o tarafı ilerideki Aspire ile Dağıtık Uygulamalar serisine bırakıyoruz.
Cluster'ın HttpClient ve HttpRequest Ayarları
Her cluster backend'e kendi HttpMessageInvoker'ı ile gidiyor. Bağlantı tarafı HttpClient bölümünde (MaxConnectionsPerServer, EnableMultipleHttp2Connections, SslProtocols, DangerousAcceptAnyServerCertificate), istek tarafı HttpRequest bölümünde (ActivityTimeout, Version, VersionPolicy). Üç ayar gerçek sorun çıkarıyor.
ActivityTimeout: YARP'ın kaynak kodunda varsayılanı 100 saniye. Bu bir toplam süre değil, backend'den hiçbir veri gelmeden geçebilecek en uzun süre. Değeri 2 saniyeye çekip catalog-2'yi 3 saniye gecikmeyle başlattım:
40 requests, concurrency 4, 2.0 s
p50 0 ms, p95 2023 ms
  (none)           2
  catalog-1       38
  status 200      38
  status 504       2

warn: Yarp.ReverseProxy.Forwarder.HttpForwarder[48]
      RequestTimedOut: The request timed out before receiving a response.
İki istek 504 Gateway Timeout aldı. Dikkat: RequestTimedOut, passive health check'in hata saydığı türlerden biri. Yavaş ama sağlam bir instance, kısa bir ActivityTimeout ile passive check tarafından devre dışı bırakılabilir. Route bazında toplam süre sınırı için 04'te request timeout middleware'ini kullanacağız.
HTTP sürümü: 01'de logda HTTP/2 RequestVersionOrLower ama Received HTTP/1.1 gördük. Şifresiz bağlantıda HTTP/2 kullanmak için iki tarafın da açıkça anlaşması lazım. catalog-1'i yalnız HTTP/2 kabul edecek şekilde başlattım (--Kestrel:EndpointDefaults:Protocols=Http2) ve cluster'a "Version": "2", "VersionPolicy": "RequestVersionExact" verdim:
      Proxying to http://localhost:5301/books HTTP/2 RequestVersionExact
      Received HTTP/2.0 response 200.

      Probing destination `catalog-2[localhost:5311]` on cluster `catalog` failed.
      System.Net.Http.HttpRequestException: The HTTP/2 server closed the connection. HTTP/2 error code 'HTTP_1_1_REQUIRED' (0xd). (HttpProtocolError)
catalog-1 artık HTTP/2 konuşuyor. Varsayılan Kestrel ayarındaki catalog-2 ve catalog-3 ise şifresiz HTTP/2'yi reddetti; health probe'ları da aynı HttpRequest ayarlarını kullandığı için ikisi Unhealthy oldu ve bütün trafik catalog-1'e kaldı. Sürüm ayarını cluster'daki bütün destination'larla birlikte değiştir. gRPC'yi proxy'lemek bu yüzden HTTP/2'yi baştan sona gerektiriyor; 04'te bu konuya döneceğiz.
DangerousAcceptAnyServerCertificate: backend'in TLS (Transport Layer Security; HTTPS'in altındaki şifreleme protokolü) certificate'ını hiç doğrulamamak. Lokal geliştirmede self-signed certificate'la uğraşmamak için cazip, ama bu ayarın production config'ine sızması gateway ile backend arasındaki TLS'i anlamsızlaştırır. Yalnız appsettings.Development.json'da tut; production'da backend certificate'ını güvenilen bir CA'dan (Certificate Authority; certificate'ları imzalayan kuruluş) al ya da iç CA'nı gateway'in trust store'una ekle.
Üretimde Dikkat
Health check endpoint'inin maliyetini hesapla. Her gateway instance'ı her destination'a kendi probe'unu atıyor: 4 gateway, 20 destination ve 5 saniyelik aralık, saniyede 16 health isteği demek. /health'in içinde veritabanına sorgu varsa bu yük veritabanına da yansır; readiness kontrolünü hafif tut.
Health durumu gateway instance'ı başına tutuluyor. İki gateway instance'ı aynı destination için bir süre farklı kararda olabilir ve passive check'in geçmişi de instance başına. Tutarlı davranış beklemek yerine her instance'ın kendi gözlemine göre karar vermesini kabul et; logları instance adıyla topla.
Health state değişikliklerini (is set to 'Unhealthy', marked as 'Unhealthy') alarm olarak izle. Gateway'in sessizce bir instance'ı devre dışı bırakması iyi, ama kimsenin fark etmemesi kötü: kapasiten azalmış demek.
Sık Düşülen Tuzaklar
Birincisi, passive health check'in 5xx'leri saydığını sanmak. Saymıyor; uygulama hata dönmeye başladığında destination sağlıklı görünmeye devam ediyor. Uygulama seviyesindeki sorunları active check'in readiness endpoint'i yakalamalı.
İkincisi, ReactivationPeriod'u kısaltınca devreden çıkan instance'ın hızla geri geleceğini düşünmek. Değer, tespit penceresinden (varsayılan 60 saniye) kısa olamıyor.
Üçüncüsü, MapReverseProxy'nin overload'unu kullanıp UsePassiveHealthChecks() ya da UseSessionAffinity() satırını unutmak. Config'te açık görünen özellik çalışmaz; 01'deki pipeline'ımızda bu satırlar bu yüzden var.
Dördüncüsü, session affinity'yi state sorununun çözümü sanmak. Instance öldüğünde, deploy sırasında yeniden başladığında ya da ölçek küçüldüğünde kullanıcının durumu yine kayboluyor; affinity sadece bu anı erteliyor.
Beşincisi, custom load balancing policy'de yavaş iş yapmak. PickDestination her istekte, isteğin kritik yolunda çalışıyor.
Küçük Bir Deneme
★☆☆ catalog-2'yi 50 ms gecikmeyle başlat ve FirstAlphabetical policy'siyle 600 istek at. Sonra catalog-1'in health'ini bozup aynı ölçümü tekrarla. Bu policy'nin aktif-pasif failover için neden kullanılabileceğini sonuçla açıkla.
★★☆ Program.cs'te TransportFailureRateHealthPolicyOptions'ı yapılandırıp DetectionWindowSize'ı 15 saniyeye indir. ReactivationPeriod'u 10 saniye bırak, catalog-2'yi öldür, yeniden başlat ve logdaki reactivation süresine bak. Gözlediğin değeri kaynak koddaki kuralla açıkla.
★★★ PreferSameZonePolicy'ye taşma (spillover) kuralı ekle: aynı zone'daki iki adayın ConcurrentRequestCount'u da metadata'da tanımlayacağın bir eşiğin üzerindeyse diğer zone'daki destination'lar da aday olsun. catalog-1 ve catalog-2'yi 50 ms gecikmeyle başlat, LoadProbe'u 5, 20 ve 50 paralellikle çalıştır ve catalog-3'ün hangi yükte trafik almaya başladığını ölç.
Trafik artık birden fazla instance'a sağlıklı şekilde dağılıyor. Bir sonraki yazıda gateway'e ilk gerçek cross-cutting işleri koyuyoruz: JWT (JSON Web Token; imzalı kimlik bilgisi taşıyan token) doğrulaması, route bazında authorization, kullanıcı başına rate limit, timeout ve output cache; bir de kimliği backend'e güvenle nasıl taşıyacağımız.