

Vector Database Seçimi: pgvector, SQL Server 2025, Qdrant, Azure AI Search ve Elasticsearch

Önce mevcut veritabanının vector desteğini dene; ANN index'ini de kendi verinde recall ölçerek ayarla. 100.000 vektörlük pgvector tablosunda exact arama 237 ms, HNSW 1 ms sürdü ama varsayılan ef_search ile recall 0.83 kaldı; filtreli sorguda index'e zorlanan HNSW sıfır satır döndürdü, iterative scan 10 satırı buldu. HNSW, IVFFlat, DiskANN, metric seçimi ve beş seçeneğin karşılaştırması.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Npgsql 10.0.3 ve Pgvector 0.3.2 ile derlenip PostgreSQL 17.11 ve pgvector 0.8.7 (Docker image pgvector/pgvector:pg17) üzerinde denenmiştir.
Önce Tahmin Et
Bir tabloda 100.000 tane 768 boyutlu vektör var ve üzerinde bir HNSW (Hierarchical Navigable Small World) index'i kurulu. Her satırın bir category kolonu var; category = 7 satırların yaklaşık %2'sini seçiyor. Şu sorguyu çalıştırıyorsun: "category 7 olanlar arasında sorguya en yakın 10 vektörü getir". Index kullanılıyorsa kaç satır gelir? 10 mu, daha az mı?
Cevap, vector database seçerken sorulması gereken en önemli sorulardan birini açıyor: filtreyle ANN (Approximate Nearest Neighbor) aramasını birlikte nasıl yapıyorsun?
Exact kNN ve ANN
Bellekteki listede yaptığımız arama exact kNN'di (k-Nearest Neighbors): sorgu vektörünü her vektörle karşılaştır, en yakın k tanesini al. Sonuç kesindir ve maliyeti satır sayısıyla doğrusal büyür. İkinci yazıda 100.000 vektörü C#'ta brute-force taramanın 768 boyutta 14 ms sürdüğünü görmüştük; veritabanında aynı iş disk okumasıyla birlikte daha pahalı. Bu tablo için PostgreSQL'de exact arama sorgu başına ortalama 237 ms sürdü.
ANN index'leri kesinlikten biraz vazgeçip hızı kazanır: en yakın 10 vektörün çoğunu, her vektöre bakmadan bulurlar. Ne kadarını bulduklarını ölçmenin yolu recall: exact sonuçtaki 10 vektörün kaçının ANN sonucunda da olduğu. Recall 0.95 demek, her 20 doğru komşudan birinin kaçırılması demek. RAG (Retrieval-Augmented Generation) için bu "doğru chunk bazen hiç gelmez" anlamına geliyor; o yüzden recall'u ölçmeden index parametresi seçmemelisin.
Index Türleri: HNSW, IVFFlat, DiskANN
HNSW vektörleri katmanlı bir graph'a yerleştirir. En alttaki katmanda bütün vektörler var ve her biri en yakın komşularına bağlı; üst katmanlarda giderek daha az node var ve bağlantılar uzun mesafeli. Arama en üstteki giriş noktasından başlar, her katmanda sorguya yaklaşan komşuya atlar, bir alt katmana iner ve en altta bir aday listesi tutarak en yakınları toplar.
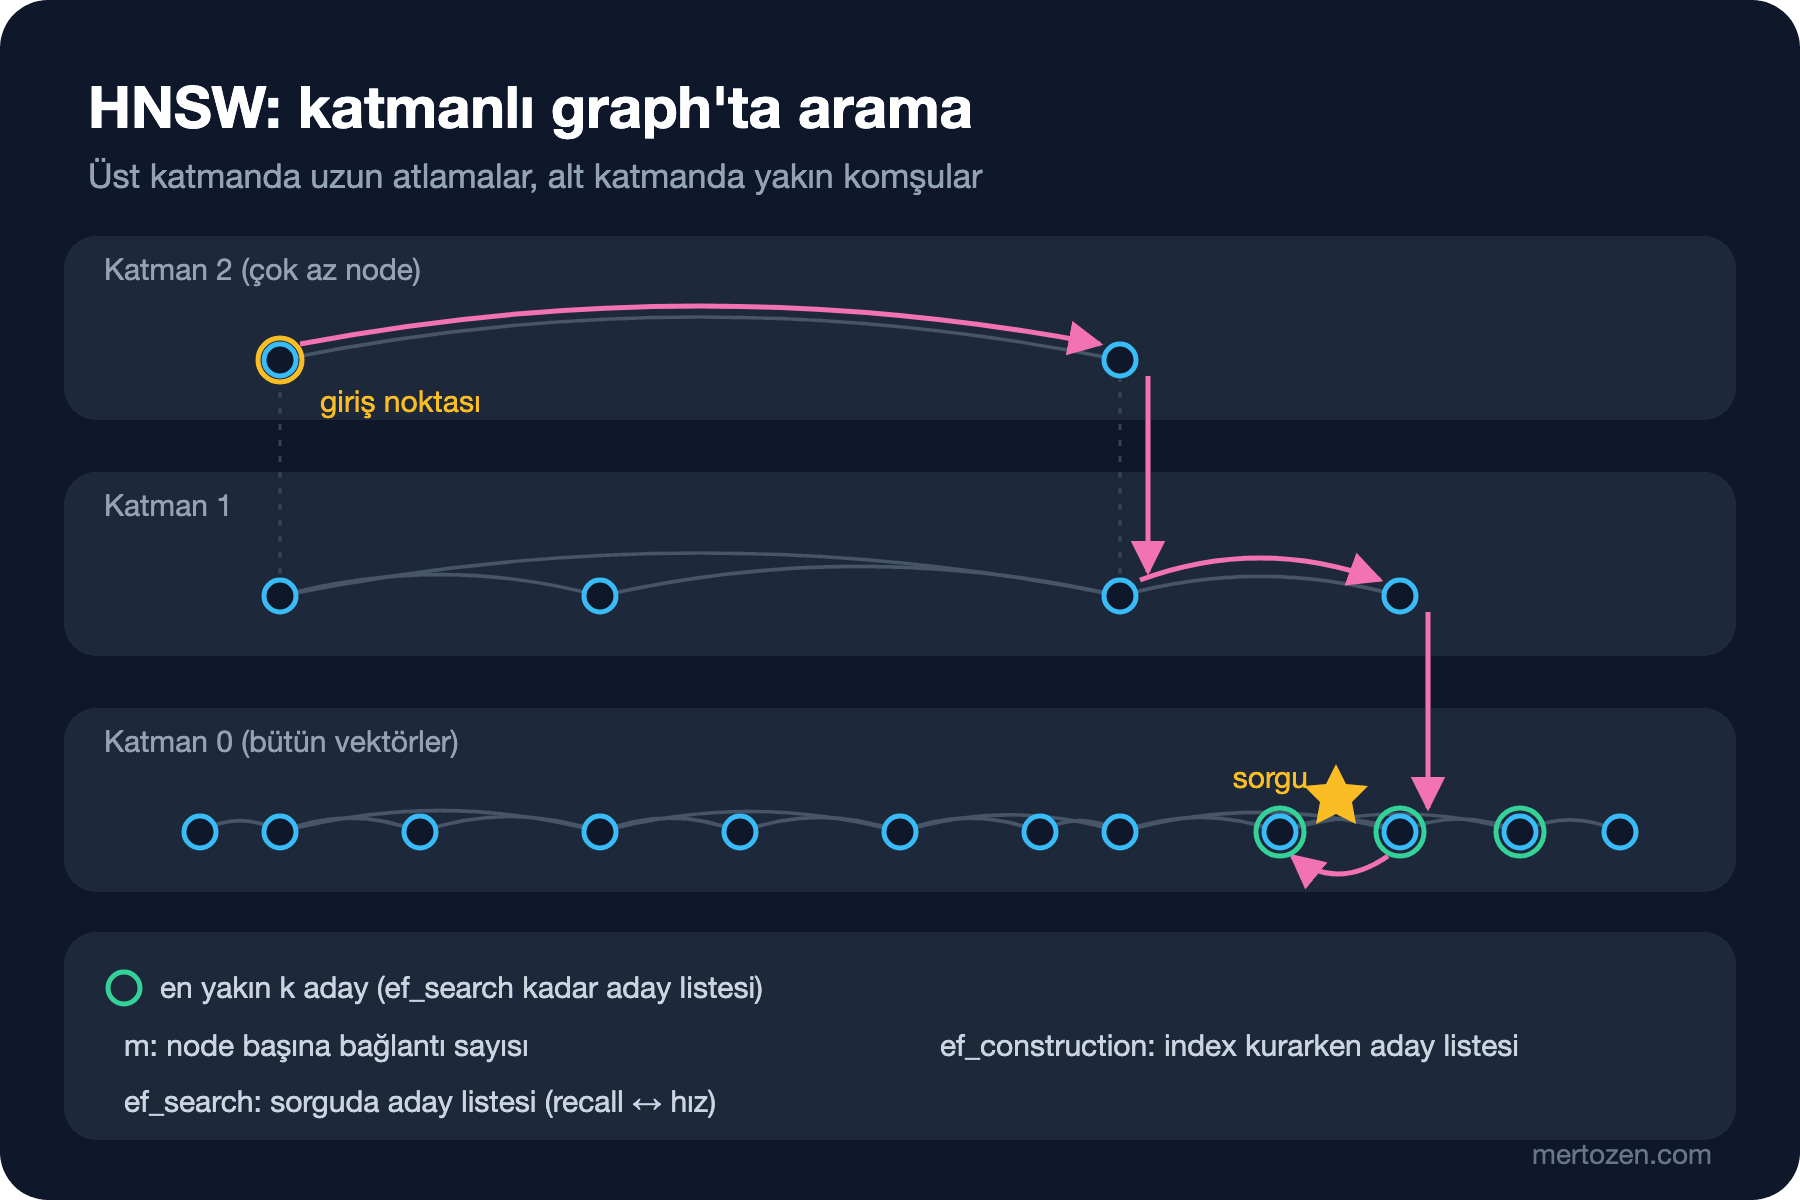
Üç parametre bu davranışı yönetir. m her node'un kaç bağlantısı olacağını, ef_construction index kurulurken kaç adayın değerlendirileceğini belirler; ikisi de index'i büyütür ve kurulumu yavaşlatır ama recall'u artırır. ef_search ise sorgu anındaki aday listesinin boyutu: index'i yeniden kurmadan, oturum bazında değiştirilebilir. pgvector'da varsayılanlar m = 16, ef_construction = 64 ve hnsw.ef_search = 40.
IVFFlat (Inverted File with Flat compression) vektörleri k-means ile lists sayıda kümeye ayırır; sorguda yalnız sorguya en yakın probes kümenin içine bakar. Kurulumu daha hızlı, ama kümeler index kurulurken veriden öğrenildiği için index'i boş tabloda kurmamalısın. pgvector README'si başlangıç için 1 milyona kadar satırda lists = satır / 1000, probes için de lists'in karekökünü öneriyor; varsayılan probes 1.
DiskANN, Microsoft Research'ün geliştirdiği ve graph'ın büyük kısmını SSD'de (Solid-State Drive) tutmak için tasarlanmış bir graph tabanlı ANN yöntemi. SQL (Structured Query Language) Server 2025'in vector index'i bunu kullanıyor; altıncı yazıda ele alacağız.
100.000 Vektörle Ölçmek
Gerçek embedding'ler yerine sentetik veri kullandım, çünkü 100.000 chunk'ı yerel modelle embed etmek saatler sürerdi. 200 rastgele cluster merkezi ve her birinin etrafına gürültüyle dağılmış 500 nokta:
/* 200 cluster merkezi, her biri 768 boyutlu */
CREATE TABLE bench_centroids AS
SELECT c, ARRAY(SELECT (random() - 0.5)::real FROM generate_series(1, 768) WHERE c > -1) AS v
FROM generate_series(0, 199) c;

/* 100.000 nokta: merkez + gürültü; category %2'lik rastgele bir filtre kolonu */
CREATE TABLE bench_items (id int PRIMARY KEY, category int NOT NULL, embedding vector(768) NOT NULL);
INSERT INTO bench_items
SELECT i, floor(random() * 50)::int,
       (SELECT array_agg(x.val + (random() - 0.5) * 0.6 ORDER BY x.ord)
        FROM unnest(c.v) WITH ORDINALITY AS x(val, ord))::vector
FROM generate_series(1, 100000) i
JOIN bench_centroids c ON c.c = i % 200;
Bu SQL 12 saniyede 403 MB'lık bir tablo üretti. Ölçüm programı tabloda olmayan 50 sorgu vektörü üretiyor (cluster merkezi artı yeni gürültü), önce index yokken exact sonuçları alıyor, sonra index kurup aynı sorguları farklı parametrelerle çalıştırıyor:
// Exact kNN: index yokken sonuç kesin ve recall'un referansı
(List<HashSet<int>> truth, double exactMs) = await SearchAllAsync(conn, queries, null);
Console.WriteLine($"exact (seq scan)          recall@10=1.000  avg={exactMs:F1} ms");

Stopwatch sw = Stopwatch.StartNew();
await Exec(conn, "SET maintenance_work_mem = '1GB'; CREATE INDEX bench_hnsw ON bench_items USING hnsw (embedding vector_cosine_ops) WITH (m = 16, ef_construction = 64);");
Console.WriteLine($"hnsw build: {sw.Elapsed.TotalSeconds:F1} s, size: {await Scalar(conn, "SELECT pg_size_pretty(pg_relation_size('bench_hnsw'))")}");

foreach (int ef in new[] { 10, 40, 100, 200 })
{
    await Exec(conn, $"SET hnsw.ef_search = {ef}");
    (List<HashSet<int>> got, double ms) = await SearchAllAsync(conn, queries, null);
    Console.WriteLine($"hnsw ef_search={ef,-4}       recall@10={Recall(truth, got):F3}  avg={ms:F1} ms");
}

private static async Task<(List<HashSet<int>>, double)> SearchAllAsync(NpgsqlConnection conn, List<Vector> queries, int? category)
{
    string where = category is null ? "" : "WHERE category = @cat";
    List<HashSet<int>> results = [];
    Stopwatch sw = Stopwatch.StartNew();
    foreach (Vector q in queries)
    {
        await using NpgsqlCommand cmd = new($"SELECT id FROM bench_items {where} ORDER BY embedding <=> @q LIMIT 10", conn);
        cmd.Parameters.AddWithValue("q", q);
        if (category is not null) cmd.Parameters.AddWithValue("cat", category.Value);
        HashSet<int> ids = [];
        await using NpgsqlDataReader r = await cmd.ExecuteReaderAsync();
        while (await r.ReadAsync()) ids.Add(r.GetInt32(0));
        results.Add(ids);
    }
    return (results, sw.Elapsed.TotalMilliseconds / queries.Count);
}

private static double Recall(List<HashSet<int>> truth, List<HashSet<int>> got) =>
    truth.Zip(got, (t, g) => (double)t.Intersect(g).Count() / t.Count).Average();
<=> pgvector'ın cosine distance operatörü. Sonuçlar:
$ dotnet run -c Release -- vdb-bench
exact (seq scan)          recall@10=1.000  avg=237.6 ms
hnsw build: 31.3 s, size: 391 MB
hnsw ef_search=10         recall@10=0.610  avg=0.8 ms
hnsw ef_search=40         recall@10=0.830  avg=0.9 ms
hnsw ef_search=100        recall@10=0.898  avg=1.1 ms
hnsw ef_search=200        recall@10=0.898  avg=1.4 ms
hnsw + WHERE category=7   avg rows=10.0/10  avg=6.7 ms
  + iterative_scan        avg rows=10.0/10  avg=5.9 ms
ivfflat build: 10.0 s, size: 392 MB
ivfflat probes=1           recall@10=0.936  avg=1.2 ms
ivfflat probes=10          recall@10=1.000  avg=3.8 ms
ivfflat probes=32          recall@10=1.000  avg=11.6 ms
Önce hız: exact arama 237 ms, HNSW 1 ms civarında. İki yüz kattan fazla fark ve bu fark tablo büyüdükçe açılır. Bedeli de ortada: HNSW index'i 391 MB, tablonun kendisi kadar; kurulumu 31 saniye sürdü. Varsayılan ef_search = 40 ile recall 0.830; her 10 doğru komşudan yaklaşık 2'si kaçıyor. ef_search'i 100'e çıkarmak recall'u 0.898'e taşıdı ve gecikmeyi yalnız 0.2 ms artırdı; 200'de recall artmadı.
IVFFlat'in bu veride daha iyi çıkması dikkatini çekmeli: probes = 1 ile 0.936, probes = 10 ile tam 1.000. Sebebi veri: 200 belirgin cluster'dan oluşan sentetik bir set, k-means tabanlı bir index için ideal durum. Gerçek metin embedding'leri böyle düzgün kümelenmez; bu yüzden bu tablodan "IVFFlat daha iyi" sonucunu çıkarma. Çıkarman gereken ders başka: index parametrelerini kendi verinle ve recall ölçerek seç, başka birinin benchmark'ıyla değil.
Distance Metric Seçimi
pgvector'da üç ana metric var: L2 (Euclidean) distance <->, inner product <#> (negatif değer döner) ve cosine distance <=>. Index'in operator class'ı metric'le eşleşmeli: vector_l2_ops, vector_ip_ops, vector_cosine_ops. Yanlış operator class'la kurulan index, sorgu tarafından hiç kullanılmaz; bunu yedinci yazıda EXPLAIN ile göreceğiz.
Hangisini seçeceğini embedding modeli söyler. Text embedding modellerinin çoğu cosine için eğitilir. Vektörler zaten uzunluğu 1 olacak şekilde normalize ediliyorsa (Ollama'nın nomic-embed-text çıktısı öyle; ikinci yazıda ölçtük) cosine, inner product ve L2 aynı sıralamayı verir; pgvector README'si bu durumda en iyi performans için inner product öneriyor. Normalize edilmemiş vektörlerde ise üçü farklı sıralama verir ve modelin önerdiği metric'ten sapmak recall'u sessizce düşürür.
Filtre ve ANN: Pre-filter, Post-filter, Iterative Scan
RAG'de filtre istisna değil kuraldır: tenant, yetki, doküman tipi, dil, tarih. Açılıştaki soruya dönelim. Önce PostgreSQL'in kendi planına bakalım:
SET hnsw.ef_search = 40;
SELECT embedding AS q FROM bench_items WHERE id = 5 \gset
EXPLAIN (ANALYZE, COSTS OFF)
SELECT id FROM bench_items WHERE category = 7
ORDER BY embedding <=> :'q' LIMIT 10;

 Limit (actual time=11.815..11.816 rows=10 loops=1)
   ->  Sort (actual time=11.814..11.815 rows=10 loops=1)
         Sort Key: ((embedding <=> '[...]'::vector))
         Sort Method: top-N heapsort  Memory: 25kB
         ->  Seq Scan on bench_items (actual time=0.007..11.674 rows=1940 loops=1)
               Filter: (category = 7)
               Rows Removed by Filter: 98060
 Planning Time: 0.049 ms
 Execution Time: 11.829 ms
(9 rows)
Planner index'i hiç kullanmadı. Filtre satırların %2'sini seçtiği için 1.940 satırı sırayla taramayı ve distance'ı yalnız onlar için hesaplamayı daha ucuz buldu: 11.8 ms ve sonuç exact. Bu bir pre-filter: önce filtrele, sonra filtrelenmiş küme üzerinde exact arama yap. Seçici filtrelerde çoğu zaman en doğru plan budur. Şimdi planner'ı index'e zorlayalım:
SET enable_seqscan = off;
EXPLAIN (ANALYZE, COSTS OFF)
SELECT id FROM bench_items WHERE category = 7
ORDER BY embedding <=> :'q' LIMIT 10;

 Limit (actual time=3.500..3.500 rows=0 loops=1)
   ->  Index Scan using bench_hnsw on bench_items (actual time=3.499..3.499 rows=0 loops=1)
         Order By: (embedding <=> '[...]'::vector)
         Filter: (category = 7)
         Rows Removed by Filter: 40
 Planning Time: 0.085 ms
 Execution Time: 3.509 ms
(7 rows)
Sıfır satır. HNSW index'i ef_search = 40 aday döndürdü, filtre bu 40 adayın hepsini eledi ve sorgu boş döndü. Bu post-filter: önce ANN, sonra filtre. Filtre ne kadar seçiciyse sonuç o kadar eksik gelir. pgvector README'si aynı durumu kendi örneğiyle anlatıyor: satırların %10'unu seçen bir koşulda varsayılan ef_search ile ortalama 4 satır kalıyor.
pgvector 0.8.0 bunun için iterative index scan'i getirdi: yeterli sonuç bulunana kadar index taramasına devam etmek.
SET hnsw.iterative_scan = relaxed_order;
EXPLAIN (ANALYZE, COSTS OFF)
SELECT id FROM bench_items WHERE category = 7
ORDER BY embedding <=> :'q' LIMIT 10;

 Limit (actual time=0.573..8.100 rows=10 loops=1)
   ->  Index Scan using bench_hnsw on bench_items (actual time=0.573..8.099 rows=10 loops=1)
         Order By: (embedding <=> '[...]'::vector)
         Filter: (category = 7)
         Rows Removed by Filter: 473
 Planning Time: 0.017 ms
 Execution Time: 8.107 ms
(7 rows)
On satır, 8.1 ms. Index 473 adayı filtreden geçirip 10 eşleşme bulana kadar devam etti. relaxed_order sonuçların distance sırasının küçük sapmalarına izin verir; kesin sıra istiyorsan strict_order var. Taramanın sonsuza gitmemesi için hnsw.max_scan_tuples sınırı var (varsayılan 20.000).
Production'da bu üç plan arasında bilinçli seçim yapman gerekiyor. Çok seçici filtrelerde (tek bir tenant'ın dokümanları gibi) B-tree index'li bir pre-filter ve exact arama genelde yeterli ve doğru. Filtre çok değerli ama her değer büyükse partial index ya da partitioning düşünülür. Arada kalan durumlarda iterative scan. Hangisinin seçildiğini her zaman EXPLAIN ile kontrol et; yedinci yazıda tenant ve yetki filtresini gerçek doc_chunks tablosunda deneyeceğiz.
Seçenekler: pgvector, SQL Server 2025, Qdrant, Azure AI Search, Elasticsearch
Elinde zaten bir veritabanı varsa ilk sorulacak soru "onun vector desteği bana yeter mi?" olmalı. Ayrı bir vector database yeni bir backup, izleme, güvenlik ve veri senkronizasyonu problemi getirir; chunk'ların metadata'sı ve yetki bilgisi ana veritabanında yaşıyorsa, iki sistem arasında tutarlılık da senin sorunun olur.
| Seçenek | ANN index | Filtre | .NET erişimi | Ne zaman |
|---|---|---|---|---|
| PostgreSQL + pgvector | HNSW, IVFFlat | SQL WHERE; 0.8 ile iterative scan | Npgsql + Pgvector, EF (Entity Framework) Core, Dapper | PostgreSQL zaten varsa |
| SQL Server 2025 | DiskANN (preview) | Son index sürümünde iterative filtering | EF Core 10, SqlClient 6.1 | SQL Server zaten varsa |
| Qdrant | HNSW | Payload filtresi aramayla birlikte | Qdrant client | Büyük ölçek, ayrı servis kabul |
| Azure AI (Artificial Intelligence) Search | HNSW, exhaustive kNN | OData filtresi | Azure SDK (Software Development Kit) | Managed hybrid search gerekiyorsa |
| Elasticsearch | HNSW | kNN araması içinde filtre | Elastic client | Full-text arama zaten oradaysa |
Hepsine Microsoft.Extensions.VectorData soyutlamasıyla da erişebilirsin; Microsoft Learn'deki provider listesinde PostgreSQL, SQL Server, Qdrant, Azure AI Search ve Elasticsearch için paketler var (CommunityToolkit.VectorData.PgVector, CommunityToolkit.VectorData.SqlServer, CommunityToolkit.VectorData.Qdrant, CommunityToolkit.VectorData.AzureAISearch, Elastic.SemanticKernel.Connectors.Elasticsearch). API'nin (Application Programming Interface) kendisi ilerideki .NET ile Yapay Zeka serisinin konusu; burada önemli olan, ortak soyutlamanın en küçük ortak paydayı sunması. pgvector'ın iterative scan ayarı ya da SQL Server'ın WITH APPROXIMATE'i gibi ince ayarlar için ya veritabanının kendi API'sine ya da EF Core'a inmen gerekir. Bu seride ana örnek PostgreSQL + pgvector; SQL Server 2025'i bir sonraki yazıda ayrıca ele alıyoruz.
Üretimde Dikkat
Index kurulumu ayrı bir operasyon. Bu ölçümü ilk kez çalıştırırken HNSW kurulumu şu hatayla düştü:
53100: could not resize shared memory segment "/PostgreSQL.2802977584" to 1070632384 bytes: No space left on deviceParalel HNSW kurulumu maintenance_work_mem kadar shared memory ister; Docker container'ının /dev/shm'si varsayılan olarak 64 MB. pgvector README'si Docker'da --shm-size'ı en az maintenance_work_mem kadar yapmayı söylüyor; container'ı --shm-size=1g ile yeniden başlatınca sorun çözüldü. Tersine, maintenance_work_mem'i varsayılan 64 MB'ta bırakınca PostgreSQL bir NOTICE veriyor: "hnsw graph no longer fits into maintenance_work_mem after 17699 tuples" ve kurulum belirgin biçimde yavaşlıyor.
Index boyutunu kapasite planına kat. 768 boyutlu 100.000 vektör için tablo 403 MB, HNSW index'i 391 MB. HNSW'nin iyi çalışması için index'in belleğe sığması gerekir; bir milyon chunk'ta bu rakamlar on katına çıkar. İkinci yazıdaki halfvec ve Matryoshka boyut kısaltması burada somut bir kazanca dönüşür.
Recall'u izle. ef_search bir kez seçilip unutulacak bir sayı değil; veri büyüdükçe ve dağılımı değiştikçe aynı değer farklı recall verir. Ölçüm setini periyodik olarak exact aramayla karşılaştırmak, recall düşüşünü müşteriden önce görmeni sağlar.
Sık Düşülen Tuzaklar
Birincisi, 1.000 kayıtla benchmark yapmak. 1.000 satırda exact arama da hızlıdır, index de mükemmel recall verir; farklar ancak yüz binler ve milyonlarda ortaya çıkar. Ölçümünü hedeflediğin büyüklüğe yakın bir veriyle yap.
İkincisi, index'siz tablo taraması. Index yoksa her sorgu bütün tabloyu tarar; 100.000 satırda 237 ms, bir milyonda saniyeler. Index'in kullanılıp kullanılmadığını EXPLAIN ile doğrula.
Üçüncüsü, filtreyle ANN'i birlikte kullanıp sonuç sayısını kontrol etmemek. Post-filter'da boş ya da eksik sonuç hata vermez; sadece RAG'in context'i boş kalır ve model "bilmiyorum" der.
Dördüncüsü, sentetik benchmark'tan genelleme yapmak. Bu yazıdaki IVFFlat sonucu, verinin cluster yapısının bir sonucu; gerçek embedding'lerde aynı sıralama çıkmayabilir.
Beşincisi, ayrı bir vector database'i yalnız "vector database lazım" diye eklemek. İki sistem arasında doküman silme, yetki değişikliği ve yeniden embed etme senkronizasyonu, aramanın kendisinden daha çok iş çıkarır.
Küçük Bir Deneme
★☆☆ bench_items üzerinde category için bir B-tree index kur ve açılıştaki sorgunun planına yeniden bak. Planner hangi planı seçiyor ve süre ne kadar değişiyor?
★★☆ HNSW index'ini m = 32, ef_construction = 128 ile yeniden kur. Kurulum süresi, index boyutu ve ef_search = 40'taki recall nasıl değişiyor?
★★★ bench_items'ı 200 yerine 2.000 cluster'la yeniden üret (cluster başına 50 nokta). IVFFlat ve HNSW'nin recall sıralaması değişiyor mu? Sonucu, verinin yapısının index seçimine etkisi açısından yorumla.
Seçenekleri ve ANN'in mekaniğini gördük. Bir sonraki yazıda SQL Server 2025'in vector tipine ve EF Core'un VectorDistance desteğine geçiyoruz; ardından yedinci yazıda aynı işi PostgreSQL ve pgvector ile, gerçek doküman chunk'larımız üzerinde yapacağız.