

Reranking ve Query Transformation: Cross-encoder, Sorgu Yeniden Yazma ve HyDE

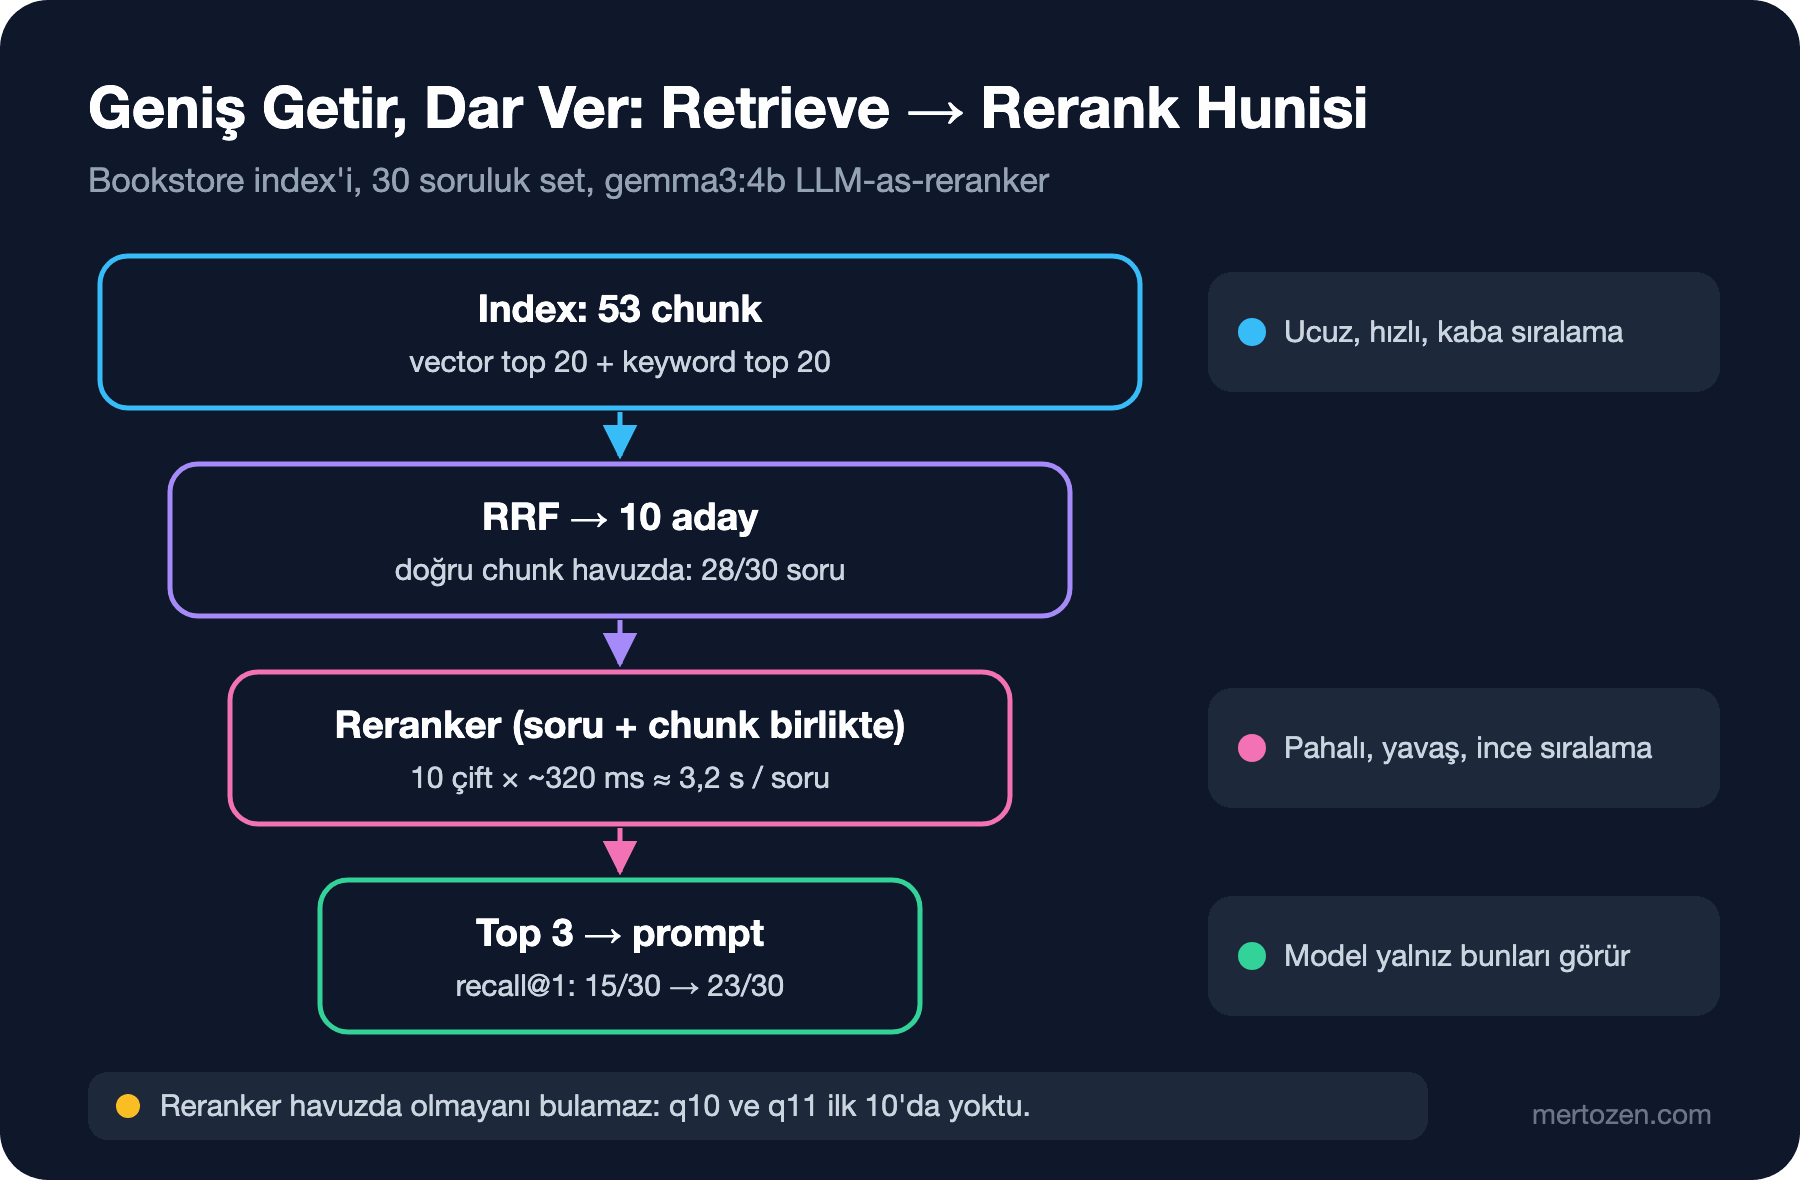
Geniş getir, dar ver: hybrid search'ün 10 adayını soru ve chunk'ı birlikte okuyan bir reranker'dan geçirmek, 30 soruda birinci sıradaki doğru chunk sayısını 15'ten 23'e çıkardı; bedeli soru başına 3,2 saniye. Sohbette soru yeniden yazma, multi-query, HyDE ve self-query'yi aynı setle ölçüp ne zaman zarar verdiklerini gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Microsoft.Extensions.AI 10.11.0, OllamaSharp 5.5.2, Entity Framework Core 10 (Npgsql 10.0.3) ve PostgreSQL 17 + pgvector 0.8.7 ile derlenip denenmiştir; modeller Ollama'da gemma3:4b, qwen3:4b ve nomic-embed-text.
Önce Tahmin Et
Bir önceki yazıda kurduğumuz hybrid search, 30 soruluk setin 15'inde doğru chunk'ı birinci sıraya koyuyordu; 28 soruda ise doğru chunk ilk 10 aday arasındaydı. Yani çoğu zaman doğru cevap elimizde, ama yanlış sırada. Bu 10 adayı küçük bir yerel modele, gemma3:4b'ye, "bu pasaj bu soruyu ne kadar cevaplıyor, 0–10 arası puan ver" diye tek tek okutsak ve puana göre yeniden sıralasak, birinci sıradaki doğru chunk sayısı 15'ten kaça çıkar? Ve bunun bedeli soru başına kaç saniye olur?
Ölçtüğüm sonuç: 15'ten 23'e. Bedeli soru başına yaklaşık 3,2 saniye. Bu yazının konusu bu takas: geniş getirip dar vermek (reranking) ve aramadan önce sorguyu dönüştürmek (query rewriting, multi-query, HyDE ve self-query). Her birinin ne zaman işe yaradığını ve ne zaman zarar verdiğini aynı soru setiyle göreceğiz.
Bi-encoder ile Cross-encoder Arasındaki Fark
Şu ana kadar kullandığımız embedding modeli bir bi-encoder: soruyu ve chunk'ı ayrı ayrı vector'e çevirir, sonra iki vector'ü karşılaştırır. Chunk vector'leri önceden hesaplanıp index'lenebildiği için milyonlarca kayıtta milisaniyeler içinde arama yapılır. Bedeli şu: model soruyu ve chunk'ı hiçbir zaman birlikte görmez. "Kargom evde kimse yokken gelirse" ile "adreste kimse bulunamazsa" arasındaki bağı, iki ayrı sıkıştırmanın tesadüfen yakın düşmesine bırakır.
Cross-encoder ise soruyu ve chunk'ı tek bir girdi olarak okur ve doğrudan bir alaka skoru üretir. Çok daha isabetlidir, ama önceden hesaplanamaz: her (soru, chunk) çifti için modeli yeniden çalıştırmak gerekir. Bu yüzden ikisini zincirleriz: ucuz bi-encoder ve keyword search ile 20–150 aday getir, pahalı cross-encoder ile bunları sırala, en iyi 3–10'unu prompt'a koy.
Çok dilli cross-encoder'lara örnek BAAI'nin (Beijing Academy of Artificial Intelligence) bge-reranker-v2-m3 modeli: bge-m3 üzerine kurulu, yaklaşık 0,6 milyar parametreli ve model kartına göre güçlü çok dilli yetenekleri var; ham skoru sigmoid ile 0–1 aralığına çevrilebiliyor. Ollama'da reranker endpoint'i olmadığı ve bu seride yeni model indirmediğimiz için bu yazıda cross-encoder'ı çalıştırmadım. Onun yerine aynı işi bir sohbet modeline yaptıracağız: bir LLM (Large Language Model) ile reranking, yani LLM-as-reranker.
Bir Reranker Interface'i ve İki Implementasyon
Pipeline'ın reranker'ın türünü bilmesine gerek yok:
public sealed record Candidate(string Id, string Section, string Content);
public sealed record Scored(Candidate Candidate, double Score);

public interface IReranker
{
    Task<List<Scored>> RerankAsync(string query, IReadOnlyList<Candidate> candidates, CancellationToken ct = default);
}

// LLM-as-reranker: her (soru, chunk) çifti için 0-10 arası puan (pointwise)
public sealed class LlmReranker(IChatClient chat) : IReranker
{
    const string Instructions = """
        You are a relevance judge for a Turkish bookstore help center.
        Given a question and a passage, reply with a single integer from 0 to 10:
        10 = the passage directly answers the question, 0 = the passage is unrelated.
        Reply with the number only.
        """;

    public async Task<List<Scored>> RerankAsync(string query, IReadOnlyList<Candidate> candidates, CancellationToken ct = default)
    {
        List<Scored> result = [];
        foreach (Candidate c in candidates)
        {
            ChatResponse response = await chat.GetResponseAsync(
            [
                new ChatMessage(ChatRole.System, Instructions),
                new ChatMessage(ChatRole.User, $"Question: {query}\n\nPassage:\n{c.Content}\n\nScore:")
            ], new ChatOptions { Temperature = 0, Seed = 42, MaxOutputTokens = 4 }, ct);

            double score = double.TryParse(response.Text.Trim(), NumberStyles.Float, CultureInfo.InvariantCulture, out double s) ? s : 0;
            result.Add(new Scored(c, score));
        }
        // Eşit puanda ilk sıradaki (retrieval sırası) önde kalsın: OrderBy stable
        return result.OrderByDescending(s => s.Score).ToList();
    }
}
MaxOutputTokens = 4 önemli: modelin açıklama yazmasına izin verirsek her çift saniyeler sürer. Sıralamanın stable olması da önemli; küçük modeller çok sık 10 verir ve eşitlikte hybrid sırası korunmalı.
Cross-encoder tarafı için Hugging Face'in Text Embeddings Inference (TEI) sunucusunun /rerank endpoint'ine giden bir implementasyon. Bu kod derlendi ama bu yazıda çalıştırılmadı:
// Cross-encoder: Hugging Face Text Embeddings Inference (TEI) /rerank endpoint'i
public sealed class TeiReranker(HttpClient http) : IReranker
{
    sealed record RerankRequest(string Query, IReadOnlyList<string> Texts, bool RawScores);
    sealed record RerankItem(int Index, double Score);

    // TEI snake_case bekler: raw_scores
    static readonly JsonSerializerOptions Json = new(JsonSerializerDefaults.Web) { PropertyNamingPolicy = JsonNamingPolicy.SnakeCaseLower };

    public async Task<List<Scored>> RerankAsync(string query, IReadOnlyList<Candidate> candidates, CancellationToken ct = default)
    {
        HttpResponseMessage response = await http.PostAsJsonAsync("/rerank",
            new RerankRequest(query, candidates.Select(c => c.Content).ToList(), RawScores: false), Json, ct);
        response.EnsureSuccessStatusCode();
        List<RerankItem> items = (await response.Content.ReadFromJsonAsync<List<RerankItem>>(Json, ct))!;
        return items.Select(i => new Scored(candidates[i.Index], i.Score))
            .OrderByDescending(s => s.Score)
            .ToList();
    }
}
Fark burada belirginleşiyor: TEI tek HTTP (Hypertext Transfer Protocol) isteğinde bütün adayları batch olarak skorlar, bizim LLM reranker'ımız ise aday başına bir model çağrısı yapar.
Ölçüm: 10 Aday, 300 Çağrı
Her soru için önceki yazıdaki hybrid search'ten 10 aday aldım, gemma3:4b ile skorladım ve doğru chunk'ın sırasını öncesi ve sonrası için yazdırdım:
$ dotnet run -- rerank-eval 10 gemma3:4b
q04 rank 4 -> 1  top: iade-politikasi#2=8 sadakat-programi#0=8 iade-politikasi#0=8
q05 rank 8 -> 2  top: iade-politikasi#0=10 iade-politikasi#3=9 kurumsal-satis-sozlesmesi#3=7
q08 rank 6 -> 1  top: kargo-ve-teslimat#0=10 sadakat-programi#3=8 iade-politikasi#0=6
q12 rank 2 -> 2  top: kargo-ve-teslimat#2=0 kargo-ve-teslimat#5=0 kargo-ve-teslimat#3=0
q14 rank 2 -> 5  top: iade-politikasi#1=8 iade-politikasi#2=6 odeme-secenekleri#1=3
q16 rank 1 -> 4  top: sadakat-programi#2=3 sadakat-programi#0=3 sadakat-programi#3=2
q26 rank 2 -> 1  top: urun-katalogu#7=10 urun-katalogu#11=10 urun-katalogu#0=10
q30 rank 4 -> 1  top: urun-katalogu#9=10 sss#2=0 sss#3=0
...
in pool@10: 28/30 | recall@1 15 -> 23 | recall@3 24 -> 25 | rerank time 96,7s (3222 ms/question)
Kazanç gerçek: recall@1 15'ten 23'e çıktı. Önceki yazıda hybrid'in dördüncüye ittiği q30'daki çocuk kitabı ve ikinciye ittiği q26'daki BKS-20114 şimdi birinci. q05'te ("Kitap yırtık geldi") doğru chunk sekizinciden ikinciye çıktı. Bunlar tam olarak bi-encoder'ın göremediği, soruyu ve metni birlikte okumayı gerektiren durumlar.
Kayıplar da gerçek. q14'te ("Hediye kartımı nakde çevirebilir miyim?") doğru chunk 2'den 5'e düştü; model iade politikasındaki bir chunk'a 8 verdi. q16'da birinci olan doğru chunk dördüncüye indi. q12'de model on adayın hepsine 0 verdi; ham çağrıyı tek başına tekrarladığımda da cevap '0''dı, yani bir parse hatası değil, modelin "Kargom evde kimse yokken gelirse ne olur?" sorusunu "Teslim edilemeyen gönderiler" bölümüyle ilişkilendirememesi. 4 milyar parametreli genel amaçlı bir model, bu iş için eğitilmiş bir cross-encoder değil; skorlar kaba (q26'da üç aday birden 10) ve bazen tamamen yanlış.
Recall@3'ün yalnız 24'ten 25'e çıktığına da dikkat et. Prompt'a üç chunk koyacaksan reranker'ın asıl kazandırdığı şey "doğru chunk'ı bulmak" değil, onu en üste taşımak. Bu, bir sonraki yazıda konuşacağımız context bütçesi için önemli: daha az chunk'la aynı isabeti yakalayabilirsin.
Gecikme ve Maliyet
Soru başına 3,2 saniye, yaklaşık 320 ms çarpı 10 çift. Bu ölçüm, aynı Ollama'yı başka işlerin de kullandığı bir geliştirici makinesinde yapıldı; production'da GPU'lu (Graphics Processing Unit) bir sunucuda çok daha hızlı olur, ama oran değişmez: aday sayısını iki katına çıkarırsan reranker süresi de iki katına çıkar. Bulut API'lerinde (Application Programming Interface) aynı hesap token üzerinden yapılır: 10 aday çarpı chunk başına yaklaşık 150 token, her soruda 1.500 token ek input demek. Bunu çağrıları paralelleştirerek (ama sağlayıcının rate limit'ini aşmadan) ya da gerçek bir cross-encoder'a geçerek azaltırsın.
Sorguyu Dönüştürmek (1): Sohbette Soru Yeniden Yazma
Sohbette kullanıcı tam cümle kurmaz. "Annem için hediye kartı almak istiyorum" dedikten sonra "Süresi ne kadar?" diye sorar. Bu takip sorusunu olduğu gibi embed edersen arama "süre" kelimesine en yakın her şeyi getirir. Çözüm, sohbet geçmişini kullanarak soruyu bağımsız bir sorguya çevirmek:
// Sohbet bağlamındaki takip sorusunu tek başına anlamlı bir arama sorgusuna çevir
public async Task<string> RewriteAsync(IEnumerable<ChatMessage> history, string followUp)
{
    string transcript = string.Join("\n", history.Select(m => $"{m.Role}: {m.Text}"));
    ChatResponse response = await chat.GetResponseAsync(
    [
        new ChatMessage(ChatRole.System, """
            Rewrite the user's last message as a standalone search query in Turkish.
            Use the conversation only to resolve references. Do not answer. Return only the query.
            """),
        new ChatMessage(ChatRole.User, $"Conversation:\n{transcript}\n\nLast message: {followUp}")
    ], Deterministic);
    return response.Text.Trim();
}
$ dotnet run -- rewrite
follow-up: Süresi ne kadar? => rewritten (553 ms): hediye kartlarının süresi ne kadar?
raw : hediye-karti#1, iade-politikasi#0, sadakat-programi#2
rewritten: hediye-karti#1, hediye-karti#0, hediye-karti#2
follow-up: Nakde çevirebilir mi? => rewritten (839 ms): hediye kartını nakde çevirebilirim mi?
raw : hediye-karti#2, sadakat-programi#1, sadakat-programi#3
rewritten: hediye-karti#2, hediye-karti#0, hediye-karti#1
follow-up: Puan kazandırır mı? => rewritten (575 ms): hediye kartları puan kazandırır mı
raw : sadakat-programi#0, sadakat-programi#2, sadakat-programi#1
rewritten: hediye-karti#0, sadakat-programi#0, hediye-karti#2Sonuç beklediğimden daha nüanslı. İlk iki soruda ham sorgu da doğru chunk'ı birinci getiriyor, ama ilk üçe iade süresi ve puan süresi gibi alakasız chunk'lar da giriyor; bunlar prompt'a girerse model "süre" sorusuna yanlış bölümden cevap verebilir. Yeniden yazılmış sorgu ilk üçü hediye kartıyla dolduruyor. Üçüncü soruda ise tersi oldu: cevap "Puan kazanmak" bölümündeki "hediye kartı alımları puan kazandırmaz" cümlesi. Ham sorgu onu birinci getirdi, yeniden yazılmış sorgu "hediye kartı"nı öne çıkarınca ikinciye düştü. Rewrite sorguyu doğru konuya bağlar, ama cevabın başka bir konunun dokümanında olduğu soruları biraz zorlaştırır. Bir de dil hatasına bak: "çevirebilirim mi". Arama için sorun değil, ama bu metni kullanıcıya gösterme.
Sorguyu Dönüştürmek (2): Multi-query ve HyDE
Multi-query, soruyu modelden üç farklı şekilde yeniden yazdırır, her biriyle ayrı arama yapar ve sonuçları RRF (Reciprocal Rank Fusion) ile birleştirir. HyDE (Hypothetical Document Embeddings) ise Gao ve arkadaşlarının 2022 makalesindeki fikir: soruyu değil, modelin o soruya yazacağı hipotetik bir cevap pasajını embed et. Pasajın içeriği yanlış olabilir; önemli olan dokümanlara benzemesi.
// HyDE: soruya cevap verecek hipotetik bir pasaj yaz, onu embed et
public async Task<string> HypotheticalDocumentAsync(string question)
{
    ChatResponse response = await chat.GetResponseAsync(
    [
        new ChatMessage(ChatRole.System, "Write a short passage (2-3 sentences, in Turkish) from an online bookstore's help page that answers the question. Do not add a title."),
        new ChatMessage(ChatRole.User, question)
    ], new ChatOptions { Temperature = 0, Seed = 42, MaxOutputTokens = 160 });
    return response.Text.Trim();
}

// Arama tarafı: hipotetik pasaj soru gibi değil, doküman gibi embed edilir
string passage = await qt.HypotheticalDocumentAsync(q.Question);
transformed = await retriever.VectorAsync(await embedder.GenerateVectorAsync($"search_document: {passage}"), 5);
$ dotnet run -- hyde-eval
q01 + -> + Kitapları satın aldıktan sonra 30 gün içinde iade edebilirsiniz. ...
q04 - -> + Ödeme işleminiz tamamlandıktan sonra, ödeme yöntemine bağlı olarak genellikle 1-3 iş günü içinde hesabınıza geri yatar. ...
q08 - -> + Siparişlerinizde 500 TL ve üzeri alışverişlerde kargo ücreti ödemenize gerek kalmıyor. ...
q11 - -> + Evet, Almanya'ya kitap göndermekteyiz. Ancak, kargo ücretleri ve gümrük vergileri gibi faktörler nedeniyle ...
q26 - -> - BKS-20114 koduyla ilgili kitap, güncel stok durumuna göre değişiklik gösterebilir. ...
hyde-eval recall@5: 25/30 -> 28/30, LLM time 94,0s (3133 ms/question)
$ dotnet run -- multi-eval
q05 - -> - Yırtık kitap nasıl onarılır? | Kitap sayfaları yırtıldı çözüm nedir? | Yırtılmış kitap tamir yöntemleri
q08 - -> + Hangi alışveriş tutarı için kargo ücretsiz? | Kargo ücretsiz olan minimum alışveriş tutarı ne kadar? | ...
multi-eval recall@5: 26/30 -> 27/30, LLM time 79,0s (2633 ms/question)HyDE'nin sonucu bu yazının en öğretici çıktısı. Yalnız vector search'te recall@5 25'ten 28'e çıktı: soru gibi değil doküman gibi görünen bir metin, doküman embedding'lerine gerçekten daha yakın düşüyor. Ama pasajların içine bak: iade süresi 30 gün (doğrusu 21), ücretsiz kargo 500 TL (doğrusu 400), "Almanya'ya kitap göndermekteyiz" (göndermiyoruz). Model bilmediği şeyi uydurdu ve bu uydurma retrieval'ı iyileştirdi. Bu yüzden HyDE pasajı yalnız arama için kullanılır; asla prompt'a, log'a ya da kullanıcıya gitmez. SKU (Stock Keeping Unit) sorusu q26'da HyDE de çaresiz: model koda dair bir şey bilmediği için genel bir "ürün sayfasını ziyaret edin" pasajı yazdı.
Multi-query hybrid üzerinde yalnız bir soru kazandırdı (26'dan 27'ye) ve q05'te sorgu kaymasının (query drift) güzel bir örneğini üretti: "Kitap yırtık geldi, ne yapmalıyım?" sorusu "Yırtık kitap nasıl onarılır?" oldu. Kullanıcı iade istiyor, model tamir tavsiyesi arıyor. Üç ek arama ve bir LLM çağrısı karşılığında bir soru, bu sette iyi bir takas değil.
Self-query: Sorudan Metadata Filtresi Çıkarmak
Son teknik, sorudan bir metadata filtresi çıkarıp aramayı o kategoriyle sınırlamak. Structured output ile modelden bir arama planı istiyoruz:
public enum Category { Iade, Kargo, Odeme, HediyeKarti, Sadakat, Siparis, Urun, Kurumsal }

public sealed record SearchPlan(
    [property: Description("The search query, without filter words")] string Query,
    [property: Description("Topic filter, or null if unclear")] Category? Category);

// Self-query: sorudan metadata filtresi çıkar
public async Task<SearchPlan> SelfQueryAsync(string question)
{
    ChatResponse<SearchPlan> response = await chat.GetResponseAsync<SearchPlan>(
    [
        new ChatMessage(ChatRole.System, """
            Turn the customer's question into a search plan for a bookstore help center.
            Categories: Iade (returns), Kargo (shipping), Odeme (payment, installments), HediyeKarti (gift cards),
            Sadakat (loyalty points), Siparis (orders, store pickup, customer service), Urun (product catalog), Kurumsal (corporate sales).
            """),
        new ChatMessage(ChatRole.User, question)
    ], new ChatOptions { Temperature = 0, Seed = 42, AdditionalProperties = new() { ["think"] = false } });
    return response.Result;
}
$ dotnet run -- selfquery ...
Kitap yırtık geldi, ne yapmalıyım?
plan (11595 ms): query="Kitap yırtık geldi" category=Iade
top3: iade-politikasi#3, iade-politikasi#4, iade-politikasi#0
Hediye kartımı nakde çevirebilir miyim?
plan (10234 ms): query="Hediye kartımı nakde çevirebilir miyim?" category=HediyeKarti
top3: hediye-karti#0, hediye-karti#2, hediye-karti#1
Kargom evde kimse yokken gelirse ne olur?
plan (11260 ms): query="Kargom evde kimse yokken gelirse ne olur?" category=Kargo
top3: kargo-ve-teslimat#3, kargo-ve-teslimat#1, kargo-ve-teslimat#5
Okulumuz için 120 adet kitap alırsak ne kadar indirim alırız?
plan (13310 ms): query="Okulumuz için 120 adet kitap alırsak ne kadar indirim alırız?" category=Sadakat
top3: sadakat-programi#1, sadakat-programi#3, sadakat-programi#0
Hediye kartıyla aldığım kitabı iade edersem param nereye yatar?
plan (15863 ms): query="Hediye kartıyla aldığım kitabı iade edersem param nereye yatar?" category=Iade
top3: iade-politikasi#1, iade-politikasi#2, iade-politikasi#0Kategori tahmini beşte dördünde doğru ve filtre bu sorularda ilk üçü tek dokümana topladı. Beşincisinde ise self-query'nin asıl riskini görüyorsun: "Okulumuz için 120 adet kitap alırsak ne kadar indirim alırız?" sorusunu model Sadakat kategorisine koydu. Filtre arama uzayını daralttığı için kurumsal satış sözleşmesi aramaya hiç girmedi; ilk üç sonucun üçü de puan programından. Hybrid search'te bu soru zaten birinci sıradaydı. Yanlış bir filtre, yanlış bir sıralamadan daha kötüdür: sıralama hatasını reranker düzeltebilir, dışarıda bırakılan dokümanı hiçbir sonraki adım geri getiremez. Gecikme de ihmal edilemez: structured output'lu bu çağrılar, aynı Ollama'yı başka işler de kullanırken soru başına 10–16 saniye sürdü. Self-query'yi yalnız kategorinin gerçekten belirgin olduğu yerde, düşük güvenle filtreyi hiç uygulamayacak şekilde (ör. null kategoriye izin vererek ve filtreli sonuç boşsa filtresiz aramaya dönerek) kullan.
Üretimde Dikkat
Her teknik ayrı bir LLM çağrısı ve bunlar toplanır. Bu yazıdaki ölçümlerle rewrite yaklaşık 0,5–0,8 saniye, HyDE 3,1 saniye, multi-query 2,6 saniye ve LLM reranker 3,2 saniye ekledi. Hepsini zincirlersen kullanıcı cevap üretilmeden önce 10 saniye bekler. Önce hangi hata sınıfını çözdüğünü ölç, sonra yalnız ona ödeme yap: sohbet arayüzün varsa rewrite neredeyse zorunlu, yoksa gereksiz.
Reranker skorlarını loglarla birlikte sakla. Production'da "neden yanlış cevap verdi?" sorusunun cevabı çoğu zaman "doğru chunk havuzdaydı ama reranker onu 5. sıraya itti" ya da "havuzda hiç yoktu"dur. İkisinin çözümü farklı: birincisi reranker'ı, ikincisi retrieval'ı ilgilendirir. Havuz boyutu (burada 10) reranker'ın tavanıdır; q10 ve q11 havuzda olmadığı için hiçbir reranker onları kurtaramaz.
Gecikme bütçesi için cache'i unutma. Aynı soru-chunk çiftinin skoru, chunk değişmediği sürece değişmez; (model, soru hash'i, chunk content_hash) anahtarlı bir cache reranker çağrılarının önemli bir kısmını ortadan kaldırabilir. Sık sorulan sorularda bu fark büyük.
Sık Düşülen Tuzaklar
Her isteğe ekstra LLM çağrısı ekleyip gecikmeyi ikiye katlamak. Yukarıdaki teknikleri "hepsi iyi" diye üst üste koymak en yaygın hata. Ölçtüğün kazanç olmadan pipeline'a çağrı ekleme.
Reranker skorunu kalibre etmeden eşik olarak kullanmak. Bizim LLM reranker'ımız q12'de doğru chunk dahil her şeye 0 verdi, q16'da doğru chunk'a 3 verdi. "Skor 5'in altındaysa bilmiyorum de" kuralı bu iki soruyu yanlış yere atardı. Eşik koyacaksan önce kendi soru setinde skorların dağılımına bak; cross-encoder'ların sigmoid skorları da modelden modele farklı kalibre edilir.
HyDE pasajını gerçek bilgi sanmak. Pasaj yalnız arama vector'ü üretmek içindir. Prompt'a girerse model kendi uydurduğu "500 TL"yi kaynak gibi okur.
Sorgu kaymasını kontrol etmemek. Multi-query ve rewrite niyeti değiştirebilir ("iade" yerine "tamir"). Orijinal soruyu her zaman aramaya dahil et, multi-query'de olduğu gibi ilk liste olarak.
Küçük Bir Deneme
★☆☆ rerank-eval'i 10 yerine 5 ve 20 adayla çalıştır. recall@1 ve soru başına süre nasıl değişiyor? Hangi aday sayısından sonra kazanç duruyor?
★★☆ LlmReranker'ı pointwise yerine listwise yap: tek çağrıda 10 adayı numaralı ver ve modelden structured output ile sıralı bir id listesi iste. 30 soruda recall@1'i ve toplam süreyi pointwise ile karşılaştır.
★★☆ HyDE ile orijinal sorunun vector listesini RRF ile birleştir (HyDE tek başına değil, ek liste olarak). q01'de 30 günlük uydurma pasajın etkisi azalıyor mu?
★★★ Docker'da TEI ile bir cross-encoder çalıştırabildiğin bir makinen varsa TeiReranker'ı bağla ve aynı 30 soruda LLM reranker'la recall@1 ve gecikmeyi karşılaştır. Skorların dağılımını çıkar ve "bilmiyorum" için bir eşik seçmeyi dene.
Artık prompt'a girecek chunk'lar daha az ve daha isabetli. Ama onları prompt'a nasıl koyduğumuz da cevabı değiştiriyor: hangi sırayla, hangi id'lerle, kaç token'lık bir bütçeyle ve skor düşükse hiç koymadan. Bir sonraki yazıda chunk'ları id'li bloklar halinde paketleyip structured output ile cevap ve kaynak listesi alacak, uydurma citation id'lerini kodla yakalayacak ve modele gitmeden "bilmiyorum" demenin ne kadar zor olduğunu ölçeceğiz.