

Chunking Stratejileri: Token-based, Header-based, Semantic, Overlap ve Contextual Retrieval

Tek bir en iyi chunk size yok; stratejiyi recall ile context bütçesini birlikte ölçerek seç. Aynı 30 Türkçe soruda 64 token'lık pencereler doğru bölümü 19, başlık tabanlı chunk'lar 16 kez ilk sıraya koydu; 256 token recall@5'i 28'e çıkardı ama prompt'u 1.122 token'a büyüttü. Sabit boyut, overlap, semantic, parent-child ve gemma3:4b ile Contextual Retrieval'ı gerçek ölçümlerle karşılaştırıyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Microsoft.Extensions.AI 10.11.0, Microsoft.ML.Tokenizers 2.0.1 ve OllamaSharp 5.5.2 ile derlenip Ollama 0.34.4 üzerinde yerel modellerle (nomic-embed-text, gemma3:4b) denenmiştir.
Önce Tahmin Et
Elinde aynı 30 soru, aynı embedding modeli ve aynı doküman seti var. Değiştirdiğin tek şey dokümanları nasıl böldüğün. Şu iki seçenekten hangisi doğru bölümü daha sık ilk sıraya koyar: her Markdown başlığının altındaki bölümü tek parça yapmak mı, yoksa başlıklara hiç bakmadan metni 64 token'lık pencerelere bölmek mi? Sezgin büyük ihtimalle başlıklardan yana. Ölçüm biraz farklı söylüyor, ama hikâye tek bir sayıdan ibaret değil.
RAG (Retrieval-Augmented Generation) hattında chunking, embedding modelinin neyi "gördüğünü" belirleyen adım. İkinci yazıda uzun bir metnin vektörünün içindeki tek cümleyi ortalamada kaybettiğini görmüştük; çok kısa bir parça ise bağlamını kaybeder. Bu yazıda dört stratejiyi ve Anthropic'in Contextual Retrieval yöntemini aynı soru setiyle ölçüyoruz.
Dört Strateji, Aynı Doküman
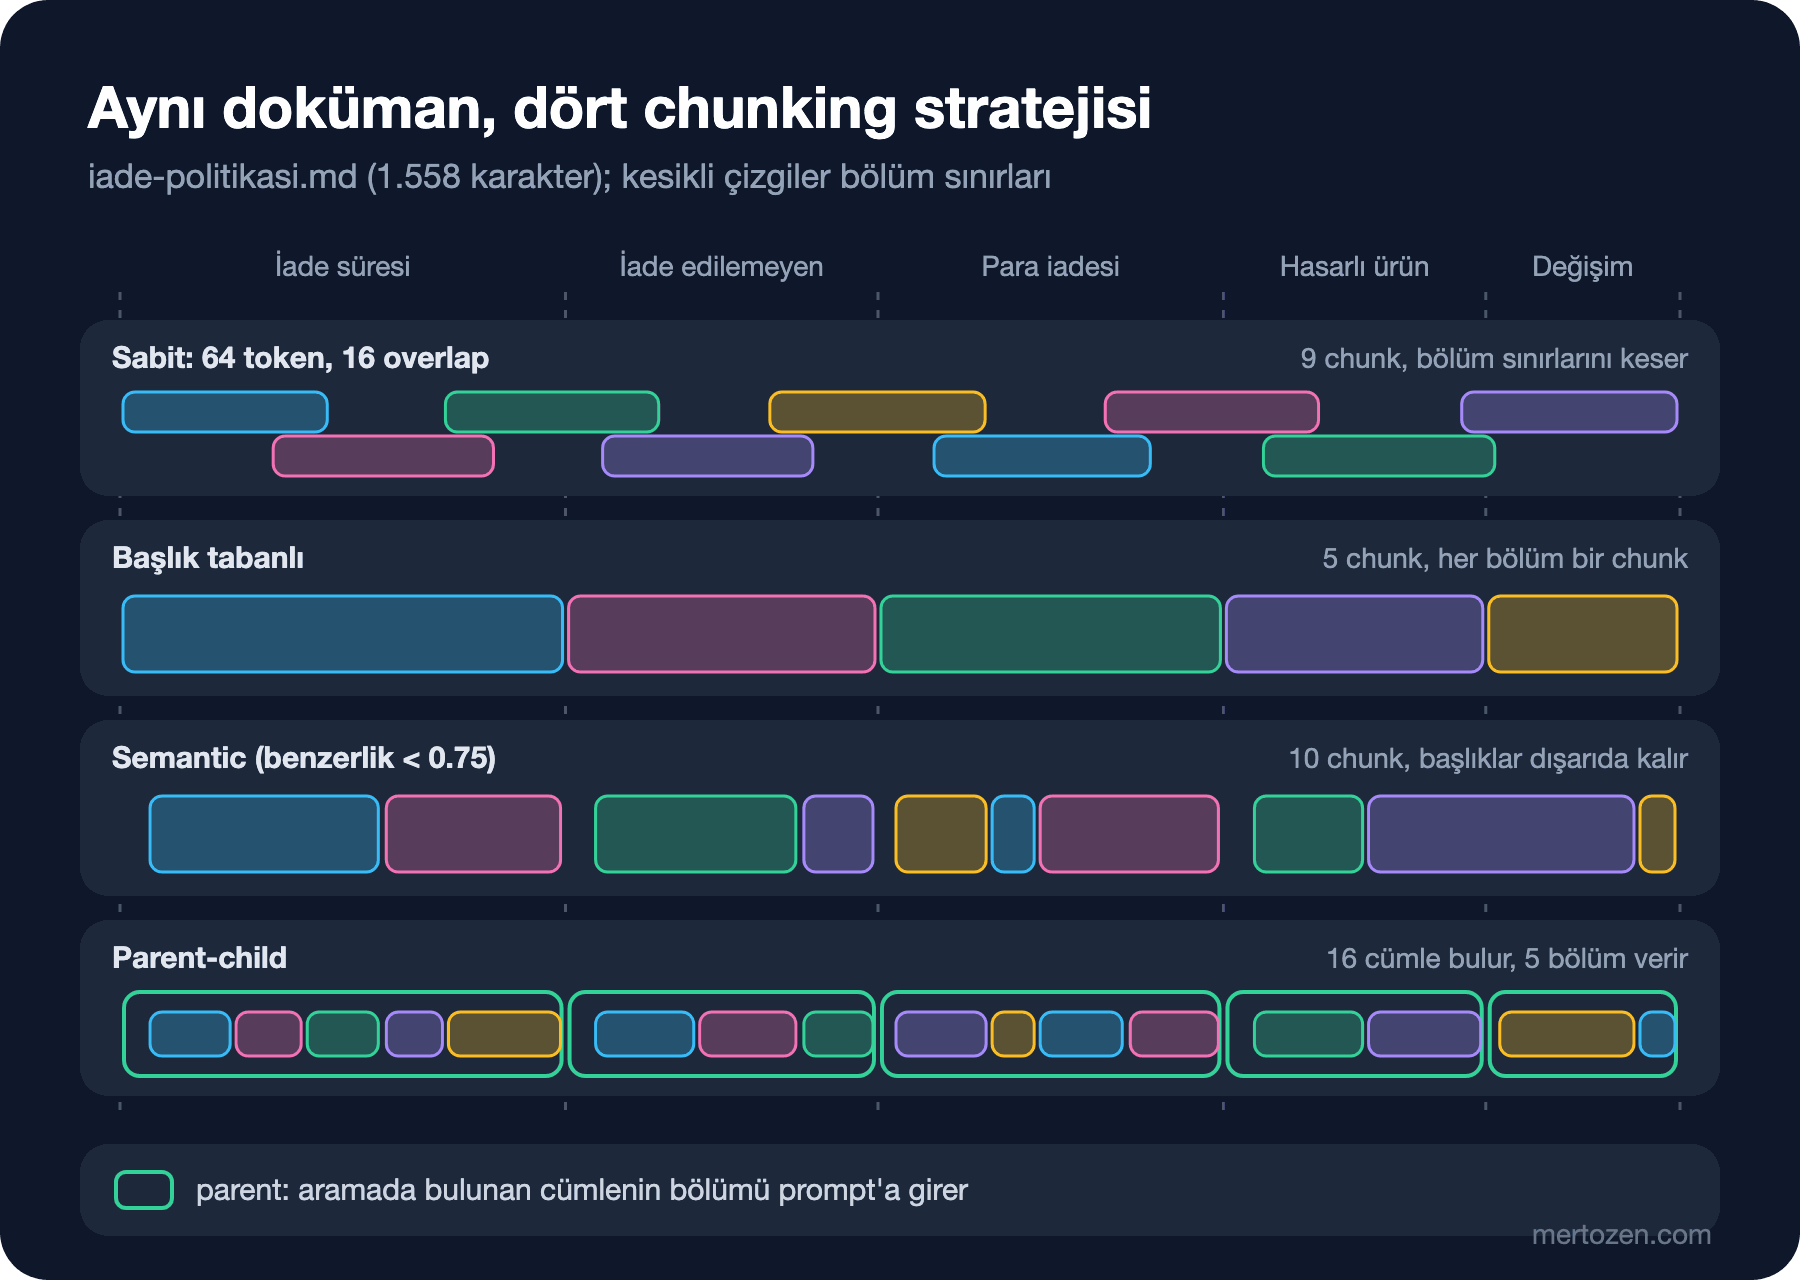
Sabit boyutlu chunking metni yapısını hiç bilmeden eşit parçalara böler; overlap, komşu parçaların bir kısmını tekrar ederek sınırda bölünen cümleyi iki parçada da tutar. Başlık tabanlı chunking dokümanın kendi yapısına güvenir: her bölüm bir chunk. Semantic chunking metni cümlelere ayırır ve ardışık iki cümlenin embedding'leri birbirinden uzaklaştığında yeni bir chunk başlatır; konunun değiştiği yeri modelden öğrenmeye çalışır. Parent-child (small-to-big diye de geçer) ise iki boyut kullanır: aramayı küçük parçalarla (burada cümleler) yapar, prompt'a büyük parçayı (o cümlenin ait olduğu bölüm) koyar.
Token Sayarak Bölmek
Sabit boyutu karakterle değil token'la ölçmek gerekiyor; modelin girdi sınırı ve prompt maliyeti token'la ölçülüyor. Microsoft.ML.Tokenizers bize hem token sayısını hem de her token'ın metindeki yerini veriyor (burada Tok, TiktokenTokenizer.CreateForEncoding("o200k_base")):
// Sabit boyut: N token'lık pencereler, overlap token kadar geri kayarak
public static List<SpannedChunk> FixedTokens(IEnumerable<FlatDoc> docs, int size, int overlap)
{
    List<SpannedChunk> result = [];
    foreach (FlatDoc f in docs)
    {
        IReadOnlyList<EncodedToken> tokens = Tok.EncodeToTokens(f.Text, out _);
        int n = 0;
        for (int i = 0; i < tokens.Count; i += size - overlap)
        {
            int j = Math.Min(i + size, tokens.Count);
            int start = tokens[i].Offset.Start.Value, end = tokens[j - 1].Offset.End.Value;
            result.Add(new(Chunkers.ToChunk(f.Doc, "", f.Text[start..end], n++), start, end));
            if (j == tokens.Count) break;
        }
    }
    return result;
}
Her chunk, dokümanın düzleştirilmiş metnindeki başlangıç ve bitiş karakterini de taşıyor. Ölçümde bunu kullanacağız: bir chunk, beklenen bölümle çakışıyorsa "isabet" sayılıyor. Başlık tabanlı chunker'da bu, birinci yazıdan beri kullandığımız "doğru doküman, doğru bölüm" kuralıyla aynı şey.
Başlık tabanlı bölme için Microsoft.Extensions.DataIngestion'ın HeaderChunker'ı hazır (üçüncü yazıda kullandık; IngestionChunkerOptions ile MaxTokensPerChunk ve OverlapTokens veriliyor). Ölçüm düzeneğinde aynı mantığı kendi tiplerimizle yazdım ki dört strateji aynı span bilgisini üretsin.
Semantic ve Parent-Child
Semantic chunker için önce dokümanları cümlelere ayırdım. Türkçede "5.000 TL" gibi binlik ayraçlar nokta kullandığı için cümle sonunu "noktadan sonra boşluk ya da satır sonu" diye tanımladım; tablo satırları da birer birim. 10 dokümandan 161 cümle çıktı:
// Semantic: ardışık cümlelerin benzerliği eşiğin altına düşünce yeni chunk başlat (başlıkları bilmeden)
public static async Task<List<SpannedChunk>> SemanticAsync(IEnumerable<FlatDoc> docs,
    IEmbeddingGenerator<string, Embedding<float>> embedder, float breakBelow)
{
    var sentences = Sentences(docs);
    GeneratedEmbeddings<Embedding<float>> vectors =
        await embedder.GenerateAsync(sentences.Select(s => "search_document: " + s.Text));
    List<SpannedChunk> result = [];
    int startIdx = 0, ordinal = 0;
    for (int i = 1; i <= sentences.Count; i++)
    {
        bool newDoc = i == sentences.Count || sentences[i].Doc != sentences[i - 1].Doc;
        bool topicShift = !newDoc && TensorPrimitives.CosineSimilarity(
            vectors[i - 1].Vector.Span, vectors[i].Vector.Span) < breakBelow;
        if (newDoc || topicShift)
        {
            var first = sentences[startIdx];
            var last = sentences[i - 1];
            string text = first.Doc.Text[first.Start..last.End];
            result.Add(new(Chunkers.ToChunk(first.Doc.Doc, "", text, ordinal++), first.Start, last.End));
            startIdx = i;
            if (newDoc) ordinal = 0;
        }
    }
    return result;
}
Eşik, iki cümlenin "aynı konudan" sayılması için gereken benzerlik. nomic-embed-text'in Türkçe skorları dar bir aralıkta toplandığı için (birinci yazıda doğru ve yanlış cevapların skorları 0.65–0.87 arasındaydı) 0.75 ve 0.70'i denedim. Parent-child ise her cümleyi başına doküman ve bölüm adını ekleyerek ayrı bir chunk yapıyor; arama sonucunda cümleyi değil, ait olduğu bölümü döndürüyor:
// Parent-child: küçük parçayla (cümle) bul, büyük parçayı (bölüm) ver
public static List<SpannedChunk> Children(IEnumerable<FlatDoc> docs) =>
    Sentences(docs).Select((s, i) => new SpannedChunk(
        Chunkers.ToChunk(s.Doc.Doc, s.Heading, $"{s.Doc.Doc.Title} > {s.Heading}: {s.Text}", i),
        s.Start, s.End, ParentId: $"{s.Doc.Doc.Id}::{s.Heading}")).ToList();
// parentMode: 30 cümle getir, bölümlerine çevir, tekrarı at, ilk 5 bölümü ver
if (parentMode)
{
FlatDoc f = byId[sc.Chunk.DocId];
var parent = f.Sections.First(s => s.Start <= sc.Start && sc.End <= s.End);
if (results.Any(r => r.DocId == sc.Chunk.DocId && r.Start == parent.Start)) continue;
results.Add((sc.Chunk.DocId, parent.Start, parent.End, f.Text[parent.Start..parent.End]));
}
else
{
results.Add((sc.Chunk.DocId, sc.Start, sc.End, sc.Chunk.Content));
}Aynı 30 Soruyla Ölçüm
$ dotnet run -- chunk-bench headers fixed64 fixed128 fixed128o fixed256 semantic semantic70 parent
header-based           chunks=  53 avgTok=   79  recall@1=16/30 recall@5=25/30 MRR=0.668  ctxTok@5= 399 sections@5=5.0
fixed 64, overlap 16   chunks=  82 avgTok=   60  recall@1=19/30 recall@5=25/30 MRR=0.717  ctxTok@5= 311 sections@5=4.4
fixed 128, overlap 0   chunks=  33 avgTok=  115  recall@1=19/30 recall@5=26/30 MRR=0.702  ctxTok@5= 567 sections@5=4.9
fixed 128, overlap 32  chunks=  40 avgTok=  119  recall@1=18/30 recall@5=24/30 MRR=0.682  ctxTok@5= 601 sections@5=4.9
fixed 256, overlap 0   chunks=  18 avgTok=  211  recall@1=17/30 recall@5=28/30 MRR=0.725  ctxTok@5=1122 sections@5=5.0
semantic (<0.75)       chunks= 110 avgTok=   31  recall@1=19/30 recall@5=24/30 MRR=0.701  ctxTok@5= 325 sections@5=4.8
semantic (<0.70)       chunks=  76 avgTok=   46  recall@1=20/30 recall@5=26/30 MRR=0.747  ctxTok@5= 667 sections@5=4.9
parent-child           chunks= 161 avgTok=   38  recall@1=16/30 recall@5=23/30 MRR=0.644  ctxTok@5= 372 sections@5=5.0

$ dotnet run -- chunk-bench contextual
contextualized 53 chunks in 298 s, input tokens=38272, output tokens=2443
header + contextual    chunks=  53 avgTok=  126  recall@1=18/30 recall@5=25/30 MRR=0.697  ctxTok@5= 647 sections@5=5.0
Sütunlar: chunk sayısı, chunk başına ortalama token, recall@1 ve recall@5 (doğru bölüm ilk 1 ya da 5 sonuçta mı), MRR (Mean Reciprocal Rank), ilk 5 sonucun prompt'a koyacağı toplam token ve bu 5 sonucun kaç farklı bölümü kapsadığı.
Önce açılıştaki sorunun cevabı: 64 token'lık sabit pencereler doğru bölümü 30 sorunun 19'unda ilk sıraya koydu, başlık tabanlı chunker 16'sında. Bunun bir sebebi ikinci yazıda gördüğümüz seyrelme: kısa bir parçanın vektörü, içindeki bilgiye daha çok benziyor. Ama tabloyu okurken üç uyarıyı birlikte tutman gerekiyor.
Birincisi, isabet tanımı büyük chunk'ları kayırıyor. 256 token'lık bir pencere ortalama iki üç bölümü birden kapsıyor; beklenen bölüme değmesi yeterli. recall@5'in 28'e çıkması bundan, ve bedeli de aynı satırda: prompt'a 1.122 token. Başlık tabanlıda bu 399. Recall'u context bütçesiyle birlikte okumazsan "büyük chunk her zaman iyi" gibi yanlış bir sonuca varırsın.
İkincisi, isabet "cevap chunk'ın içinde" demek değil. Sabit bir pencere bölümün yalnız son cümlesini ve bir sonraki bölümün başını içerebilir; ölçüm bunu isabet sayar ama model cevabı bulamayabilir. Bunun en net örneği tablolar:
$ dotnet run -- fixed-dump kargo-ve-teslimat 64 16
...
--- kargo-ve-teslimat#3 [489..712]
 ertesi iş günü teslim edilir. Ekspres teslimat ücreti sipariş tutarından bağımsız olarak 89,90 TL'dir ve ücretsiz kargo kampanyasına dahil değildir.

## Bölgelere göre teslim süreleri
| Bölge | Standart kargo | Ekspres |
|
--- kargo-ve-teslimat#4 [669..844]
leri
| Bölge | Standart kargo | Ekspres |
|---|---|---|
| İstanbul, Ankara, İzmir merkez | 1-2 iş günü | Ertesi iş günü |
| Diğer il merkezleri | 2-4 iş günü | Yok |
| İlçe ve
--- kargo-ve-teslimat#5 [801..957]
 merkezleri | 2-4 iş günü | Yok |
| İlçe ve köyler | 3-5 iş günü | Yok |
| KKTC | 5-8 iş günü | Yok |

## Yurt dışı gönderim
Şu an yalnızca KKTC'ye (Kuzey K
"İlçe ve köyler | 3-5 iş günü | Yok" satırı, sütun başlıklarını içeren satırdan ayrı bir chunk'a düştü. Bu chunk'ı okuyan model "3-5 iş günü"nün standart kargo mu ekspres mi olduğunu bilemez. Birinci yazıdaki "Van'ın bir köyüne kaç günde gelir?" sorusunun minimal RAG'de kaybolmasının sebebi de buydu.
Üçüncüsü, 30 soru küçük bir set. Bir soru 3,3 puan; 18 ile 19 arasındaki fark gürültü. Güvenle söyleyebileceğim şeyler daha kaba: overlap'li 128 token, overlap'siz 128 token'dan iyi değil (recall@5 26'dan 24'e indi, context 567'den 601 token'a çıktı); parent-child bu sette en kötü sonucu verdi; semantic chunking (0.70 eşiğiyle) en yüksek MRR'ı verdi ama ilk 5 sonucu ortalama 667 token, başlık tabanlının yaklaşık 1,7 katı.
Parent-child'ın kötü çıkması ilginç. Tek bir Türkçe cümle, İngilizce ağırlıklı bir embedding modeli için çok az sinyal taşıyor; "Puanlar nakde çevrilemez" cümlesi "Puanlarımı paraya çevirebilir miyim?" sorusuna, bölümün tamamından daha yakın olmuyor. Yöntem kötü değil; bu model ve bu dil için cümle, arama birimi olarak fazla küçük. Paragraf ya da 2–3 cümlelik pencerelerle denemek doğal bir sonraki adım.
Contextual Retrieval
Anthropic'in 19 Eylül 2024'te yayımladığı Contextual Retrieval yöntemi şunu öneriyor: her chunk'ı embed etmeden önce, dokümanın tamamını gören bir LLM'e (Large Language Model) o chunk'ın dokümandaki yerini anlatan 50–100 token'lık bir bağlam yazdır ve bunu chunk'ın başına ekle. Yazıda raporlanan sonuç, ilk 20 sonuçta retrieval başarısızlığının yalnız contextual embedding'le %35, contextual BM25 (Best Matching 25, klasik bir keyword sıralama algoritması) ile birlikte %49, reranking de eklenince %67 azalması. Aynı yazı, bilgi tabanı 200.000 token'ın altındaysa RAG yerine bütün bilgiyi prompt'a koymayı da öneriyor; bizim 4.184 token'lık setimiz bu sınırın çok altında, ama yöntemi ölçmek için iyi bir laboratuvar.
Her başlık tabanlı chunk için gemma3:4b'ye dokümanın tamamını ve chunk'ı verdim:
ChatResponse response = await chat.GetResponseAsync(
[
    new(ChatRole.System, "You write short retrieval context for document chunks. Reply in Turkish with one or two sentences and nothing else."),
    new(ChatRole.User, $"""
        <document>
        {byId[c.Chunk.DocId].Text}
        </document>
        <chunk>
        {c.Chunk.Content}
        </chunk>
        Write one or two sentences that place this chunk within the document (which document, which topic, what it applies to), so that the chunk can be found by search.
        """)
], new ChatOptions { Temperature = 0, Seed = 42 });
Sonuç, ölçüm tablosunun son satırında: recall@1 16'dan 18'e, MRR 0.668'den 0.697'ye çıktı, recall@5 25'te kaldı. 53 chunk için 298 saniye ve 38.272 input token harcandı; her çağrı dokümanın tamamını tekrar okuduğu için input maliyeti chunk sayısıyla değil "chunk sayısı × doküman uzunluğu" ile büyüyor. Anthropic'in maliyet hesabı bu yüzden prompt caching'e dayanıyor; yerel modelde o avantaj yok.
Kazancın küçük kalmasının sebebi, üretilen bağlamlara bakınca anlaşılıyor. Kargo politikasının ilk bölümü için model "Bu bölüm, standart kargo ile ilgili teslimat süreleri ve ücretlendirme bilgilerini açıklamaktadır." yazdı. Bu cümle bölüm başlığını tekrar ediyor; bizim chunk'larımızın başında zaten "Kargo ve Teslimat > Standart kargo" vardı. Contextual Retrieval en çok, başlıksız ve bağlamından kopuk chunk'larda işe yarar; başlık yolunu zaten chunk'a ekliyorsan ucuz yoldan kazancın büyük kısmını almışsın demektir.
Üretimde Dikkat
Chunk boyutunu bir kez seçip unutma. "Birkaç yüz token civarında başla, ölçerek ayarla" iyi bir varsayılan; bu sette en iyi sonuçlar 30–120 token arasından geldi, ama bu Türkçe ve kısa politika metinleri için geçerli. Uzun teknik dokümanlarda denge başka yerde olabilir.
Chunking stratejisini dokümanın türüne göre seç. Politika ve SSS (Sıkça Sorulan Sorular) gibi zaten bölümlenmiş içerikte başlık tabanlı chunking doğal sınırları korur; başlıksız uzun metinlerde (sözleşme ekleri, e-posta yazışmaları) sabit pencere ya da semantic chunking daha uygundur. Tablolar ve kod blokları için ayrı kural koy: ya bütün halinde tek chunk, ya her satıra başlık satırını ekleyerek.
Chunking'i değiştirmek bir yeniden index'leme operasyonudur. Bütün dokümanlar yeniden chunk'lanır ve embed edilir, eşikler kayar (birinci yazıda 0.70 eşiğinin chunker değişince her şeyi elediğini görmüştük). Değişikliği ölçüm setiyle doğrula ve ikinci yazıdaki "yeni kolon, backfill, geçiş" sırasıyla yap.
Context bütçesini ölçüm tablosuna ekle. Recall'u artıran her değişiklik prompt'u da büyütebilir; onuncu yazıda bu bütçeyi doğrudan yöneteceğiz.
Sık Düşülen Tuzaklar
Birincisi, tabloyu ortadan bölmek. Sütun başlığından ayrılmış bir tablo satırı, model için anlamsız bir sayı dizisidir. Tablo içeren bölümleri sabit pencereyle bölme ya da her parçaya başlık satırını tekrar ekle.
İkincisi, overlap'i artırıp duplicate sonuçlarla context'i doldurmak. Bu sette 32 token overlap recall'u artırmadı, context'i büyüttü. Overlap'in faydası, sınırda bölünen cümleyi kurtarmak; ama komşu iki chunk aynı soruya birlikte gelirse prompt'a aynı metin iki kez girer.
Üçüncüsü, tek bir "en iyi chunk size" aramak. Recall@1'e göre en iyi olan, recall@5'e ya da context bütçesine göre en iyi değil; 30 soruluk bir sette sıralamalar bir iki soruyla değişir. Birkaç makul seçeneği kendi soru setinle ve birden fazla metrikle karşılaştır.
Dördüncüsü, isabet tanımını sorgulamamak. "Chunk bölümle çakışıyor" kuralı büyük chunk'ları kayırıyor. Daha sıkı bir ölçüm için her soruya beklenen cevap cümlesini kaydet ve chunk'ın o cümleyi tam içerip içermediğine bak; on ikinci yazıda bunu ele alacağız.
Beşincisi, Contextual Retrieval'ı ölçmeden açmak. Ingestion maliyetini chunk sayısı × doküman uzunluğu kadar artırıyor; başlık yolu zaten chunk'taysa kazanç küçük kalabilir.
Küçük Bir Deneme
★☆☆ chunk-bench'e 32 token'lık sabit pencere ekle (overlap 8). recall@1 artmaya devam ediyor mu, yoksa chunk'lar anlamını kaybetmeye mi başlıyor?
★★☆ Children'ı cümle yerine 2 cümlelik pencerelerle (1 cümle overlap) çalışacak şekilde değiştir. Parent-child'ın recall@5'i başlık tabanlıyı geçiyor mu?
★★★ Sabit pencerede tablo satırlarını koruyan bir kural yaz: pencere bir tablonun içinde başlıyorsa, chunk'ın başına tablonun başlık satırını ekle. "Siparişim Van'ın bir köyüne kaç günde gelir?" sorusu için getirilen chunk'ı ve modelin cevabını önce ve sonra karşılaştır.
Chunk'larımız hazır; şimdi onları nerede saklayacağımıza karar verme zamanı. Bir sonraki yazıda vector database seçeneklerine, exact ve approximate aramaya, HNSW (Hierarchical Navigable Small World) ile IVFFlat'e ve filtreyle ANN (Approximate Nearest Neighbor) aramasının birlikte nasıl davrandığına bakıyoruz.