

Production RAG Mimarisi: Ingestion ve Query Pipeline'ları, Minimal RAG Neden Çöker?

Minimal RAG gerçek doküman setinde 30 sorunun yalnız 20'sini doğru cevapladı; hataların çoğu modelden değil retrieval, chunking, eski veri ve yetkisiz dokümandan geliyor. Bookstore'un Türkçe dokümanlarıyla hataları sınıflandırıyor, ingestion ve query pipeline'larını ayırıyor ve yetki filtresi ile trace log'u olan bir query pipeline iskeleti kuruyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Microsoft.Extensions.AI 10.11.0 ve OllamaSharp 5.5.2 ile derlenip Ollama 0.34.4 üzerinde yerel modellerle (nomic-embed-text, gemma3:4b) denenmiştir.
Önce Tahmin Et
LLM (Large Language Model) Temelleri serisinde, altı paragraflık bir politika dosyası üzerinde RAG (Retrieval-Augmented Generation) kurmuştuk ("LLM ve RAG: Modelin Bilmediği Veriyle Cevap Vermek" yazısı): dosyayı chunk'lara böl, embed et, soruya en yakın iki chunk'ı prompt'a koy. İade sorusuna 21 gün dedi, Almanya sorusuna "bilmiyorum" dedi; her şey yolunda görünüyordu.
Şimdi aynı kodu Bookstore'un gerçek doküman klasörüne bağlıyoruz: beş politika dosyası, yardım merkezinden alınmış bir HTML (HyperText Markup Language) sayfası, ürün kataloğu, iki sayfalık bir PDF sözleşme, personele özel iki doküman ve bir de unutulmuş eski kargo politikası. Kod aynı, model aynı, sadece veri gerçekleşti. 30 müşteri sorusundan kaçına doğru cevap gelir? Tahminini bir sayı olarak yaz, sonra okumaya devam et.
Minimal RAG'i Gerçek Doküman Klasörüne Taşımak
Bu seri boyunca kullanacağımız doküman seti Türkçe ve Bookstore'a ait. Müşteriler Türkçe soruyor, politikalar Türkçe yazılmış; bu yüzden örneklerdeki veri ve sorular Türkçe kalıyor. Klasörün yapısı şöyle:
corpus/
  policies/iade-politikasi.md        acl: public   updated_at: 2026-09-01
  policies/kargo-ve-teslimat.md      acl: public   updated_at: 2026-10-15
  policies/hediye-karti.md, sadakat-programi.md, odeme-secenekleri.md
  help/sss.html                      (help center export: menu, cookie banner, footer)
  products/urun-katalogu.md          14 products, one "## Title (BKS-xxxxx)" section each
  contracts/kurumsal-satis-sozlesmesi.pdf   2 pages, header/footer on every page
  internal/personel-indirimi.md      acl: staff
  internal/tedarikci-iade-sureci.md  acl: staff
  archive/kargo-ve-teslimat-2025.md  old version: free shipping from 300 TL
Her Markdown dosyasının başında küçük bir metadata bloğu var: id, title, acl (Access Control List; burada yalnız public ya da staff) ve updated_at. Minimal RAG bunların hiçbirini kullanmıyor; LLM Temelleri'ndeki gibi her paragrafı başına bölüm adını ekleyip ayrı bir chunk yapıyor, hepsini bellekte tutuyor ve en yakın ikisini prompt'a koyuyor. Klasörün tamamı 64 chunk'a dönüştü. Sınıf neredeyse birebir eskisi:
namespace Bookstore.Rag;

// LLM Temelleri 14'teki minimal RAG, bu kez Bookstore'un bütün doküman klasörüyle
public sealed class MinimalRag(InMemoryIndex index, IChatClient chat, int topK = 2)
{
    public async Task<(List<Hit> Hits, string Answer)> AskAsync(string question)
    {
        List<Hit> hits = await index.SearchAsync(question, topK);
        string context = string.Join("\n\n", hits.Select(h => h.Chunk.Content));
        List<ChatMessage> messages =
        [
            new(ChatRole.System, """
                You are the Bookstore support assistant. Answer in Turkish.
                Answer using ONLY the facts inside <context>.
                If the answer is not in <context>, reply exactly: "Bu konuda bilgim yok."
                """),
            new(ChatRole.User, $"<context>\n{context}\n</context>\n\nQuestion: {question}")
        ];
        ChatResponse response = await chat.GetResponseAsync(messages, new ChatOptions { Temperature = 0, Seed = 42 });
        return (hits, response.Text.Trim());
    }
}
Tek fark, cevabın Türkçe istenmesi ve "bilmiyorum" cümlesinin Türkçe olması. Sıcaklık 0, seed 42; aynı soruya her koşuda aynı cevabı alıyoruz, bu da hataları tekrar üretilebilir kılıyor.
30 Soru, Beş Hata Sınıfı
Doküman setiyle birlikte 30 soruluk bir soru seti de yazdım. Her sorunun cevabı dokümanlarda var ve her soru için cevabın hangi dokümanın hangi bölümünde olduğu kayıtlı. Bu kaydı ilerideki yazılarda recall ölçmek için kullanacağız; bugün yalnız cevaplara bakıyoruz. 30 soruyu tek tek çalıştırıp her cevabı elle sınıflandırdım:
| Sonuç | Soru sayısı | Örnek |
|---|---|---|
| Doğru cevap | 20 | İade süresi 21 gün |
| Eksik cevap | 1 | Puanların silinmesinde 24 ay kuralı atlandı |
| Retrieval doğru chunk'ı kaçırdı | 5 | Ücretsiz kargo eşiği, BKS-20114 fiyatı |
| Chunk sınırı bilgiyi böldü | 1 | Para iadesi süresi |
| Doğru chunk geldi, model yanlış okudu | 3 | 120 adet için %22 indirim |
30 sorunun 20'si doğru: üçte ikisi. Yanlışların yarısı retrieval'dan, yani modelin önüne doğru metin hiç gelmedi. Soru setinin dışında iki hata sınıfı daha denedim, çünkü bunları rastgele sorularla yakalamak zor ama production'da en pahalıları onlar: eski veri ve yetkisiz doküman.
Hataları Tek Tek Görmek
Retrieval kaçırdı ve chunk sınırı
$ dotnet run -- minimal "Kaç liralık alışverişte kargo bedava oluyor?"
  [0.694] sss#10 (public) Stokta olmayan bir kitabı nasıl alabilirim?: Ürün sayfasındaki "Gelinc...
  [0.685] hediye-karti#22 (public) Kısıtlamalar: Kaybolan veya çalınan hediye kartları, satın alma fatura...
  => Bu konuda bilgim yok.

$ dotnet run -- minimal "Param ne zaman hesabıma geri yatar?"
  [0.658] kurumsal-satis-sozlesmesi#3 (public) 2. Ödeme koşulları: Kurum, fatura tarihinden itibaren 30 gün vadeli öd...
  [0.654] iade-politikasi#28 (public) Para iadesi: Hediye kartıyla ödenen siparişlerde iade tutarı hediye ka...
  => Ödeme havale veya EFT ile yapıldığında, iade tutarı hediye kartına yüklenir.
İlk soruda cevap kargo-ve-teslimat dokümanında açıkça yazıyor: "400 TL ve üzeri siparişlerde standart kargo ücretsizdir". Ama müşteri "bedava" dedi, doküman "ücretsiz"; embedding bu iki kelimeyi yeterince yakın bulmadı ve en üste stokla ilgili bir SSS (Sıkça Sorulan Sorular) cevabı çıktı. Model doğru davrandı: önündeki metinde cevap yoktu, "bilgim yok" dedi. Müşteri açısından sonuç yine kötü.
İkinci soru daha sinsi. "Para iadesi" bölümü iki paragraftan oluşuyor; ilki "5 iş günü içinde başlatılır" diyor, ikincisi hediye kartıyla ödenen siparişleri anlatıyor. Paragraf tabanlı chunking bu bölümü ikiye böldü, retrieval ikinci yarıyı getirdi ve model elindeki iki alakasız cümleyi birleştirip hiç var olmayan bir kural uydurdu. Cevap kendinden emin ve yanlış; "bilmiyorum"dan daha kötü.
Eski veri ve yetkisiz doküman
$ dotnet run -- minimal "İstanbul'da aynı gün teslimat yapıyor musunuz?"
  [0.698] kargo-ve-teslimat-2025#1 (public) Ekspres teslimat: Ekspres teslimat İstanbul'da geçerlidir. Saat 14:00'...
  [0.690] kargo-ve-teslimat#33 (public) Ekspres teslimat: Ekspres teslimat yalnızca İstanbul, Ankara ve İzmir'...
  => Saat 14:00'ye kadar verilen siparişler aynı gün teslim edilir. Ekspres teslimat ücreti 69,90 TL'dir.

$ dotnet run -- minimal "Çalışanlarınıza indirim yapıyor musunuz?"
  [0.711] sadakat-programi#47 (public) Puan kullanmak: Her 100 puan bir sonraki siparişte 25 TL indirim olara...
  [0.701] personel-indirimi#14 (staff) Personel indirimi: Bookstore çalışanları kendi kullanımları için yapac...
  => Evet, Bookstore çalışanları kendi kullanımları için yapacakları alışverişlerde %30 personel indirimi alır.
Aynı gün teslimat bir yıl önce vardı; yeni politika ertesi iş günü diyor. İki doküman da index'te ve eski olanın skoru 0.698 ile yeni olanı (0.690) geçti. Model listede ilk geleni seçti ve müşteriye artık geçerli olmayan bir saati ve ücreti söyledi. Embedding'in "hangisi güncel" diye bir kavramı yok; ona yalnız metin benzerliği soruluyor.
İkinci cevap ise bir güvenlik olayı: personel-indirimi dokümanı acl: staff işaretli ve içinde "müşterilerle paylaşılmaz" diye yazıyor. Minimal RAG bu metadata'yı hiç okumadığı için doküman müşterinin context'ine girdi, model de görevini yaptı.
Model context'i yanlış okudu
$ dotnet run -- minimal "Okulumuz için 120 adet kitap alırsak ne kadar indirim alırız?"
  [0.743] kurumsal-satis-sozlesmesi#2 (public) 1. Toplu alım indirimi: Aynı siparişte aynı kitaptan en az 50 adet ala...
  [0.696] sadakat-programi#47 (public) Puan kullanmak: Her 100 puan bir sonraki siparişte 25 TL indirim olara...
  => 200 ve üzeri siparişlerde indirim oranı %22'dir. Bu durumda 120 adet kitap için %22 indirim alırsınız.
Retrieval kusursuz: doğru bölüm 0.743 ile en üstte. Sözleşme "50-199 adet için %15, 200 ve üzeri için %22" diyor, model 120'yi 200'ün üstünde saydı. 4 milyar parametrelik bir modelden sayısal karşılaştırmada hata beklemek gerekiyor; ama aynı sınıfa "Puanlarımı paraya çevirebilir miyim?" sorusu da düştü: chunk "Puanlar nakde çevrilemez" diyor, model "para" ile "nakit"i eşleyemedi ve "bilgim yok" dedi.
İki Pipeline: Ingestion ve Query
Bu beş hatanın hepsi tek bir fonksiyonun içinde oluyor gibi görünüyor, ama aslında iki ayrı sürecin farklı adımlarından geliyorlar. Production RAG'de bunları ayırmak, hatayı nerede arayacağını bilmek demek.
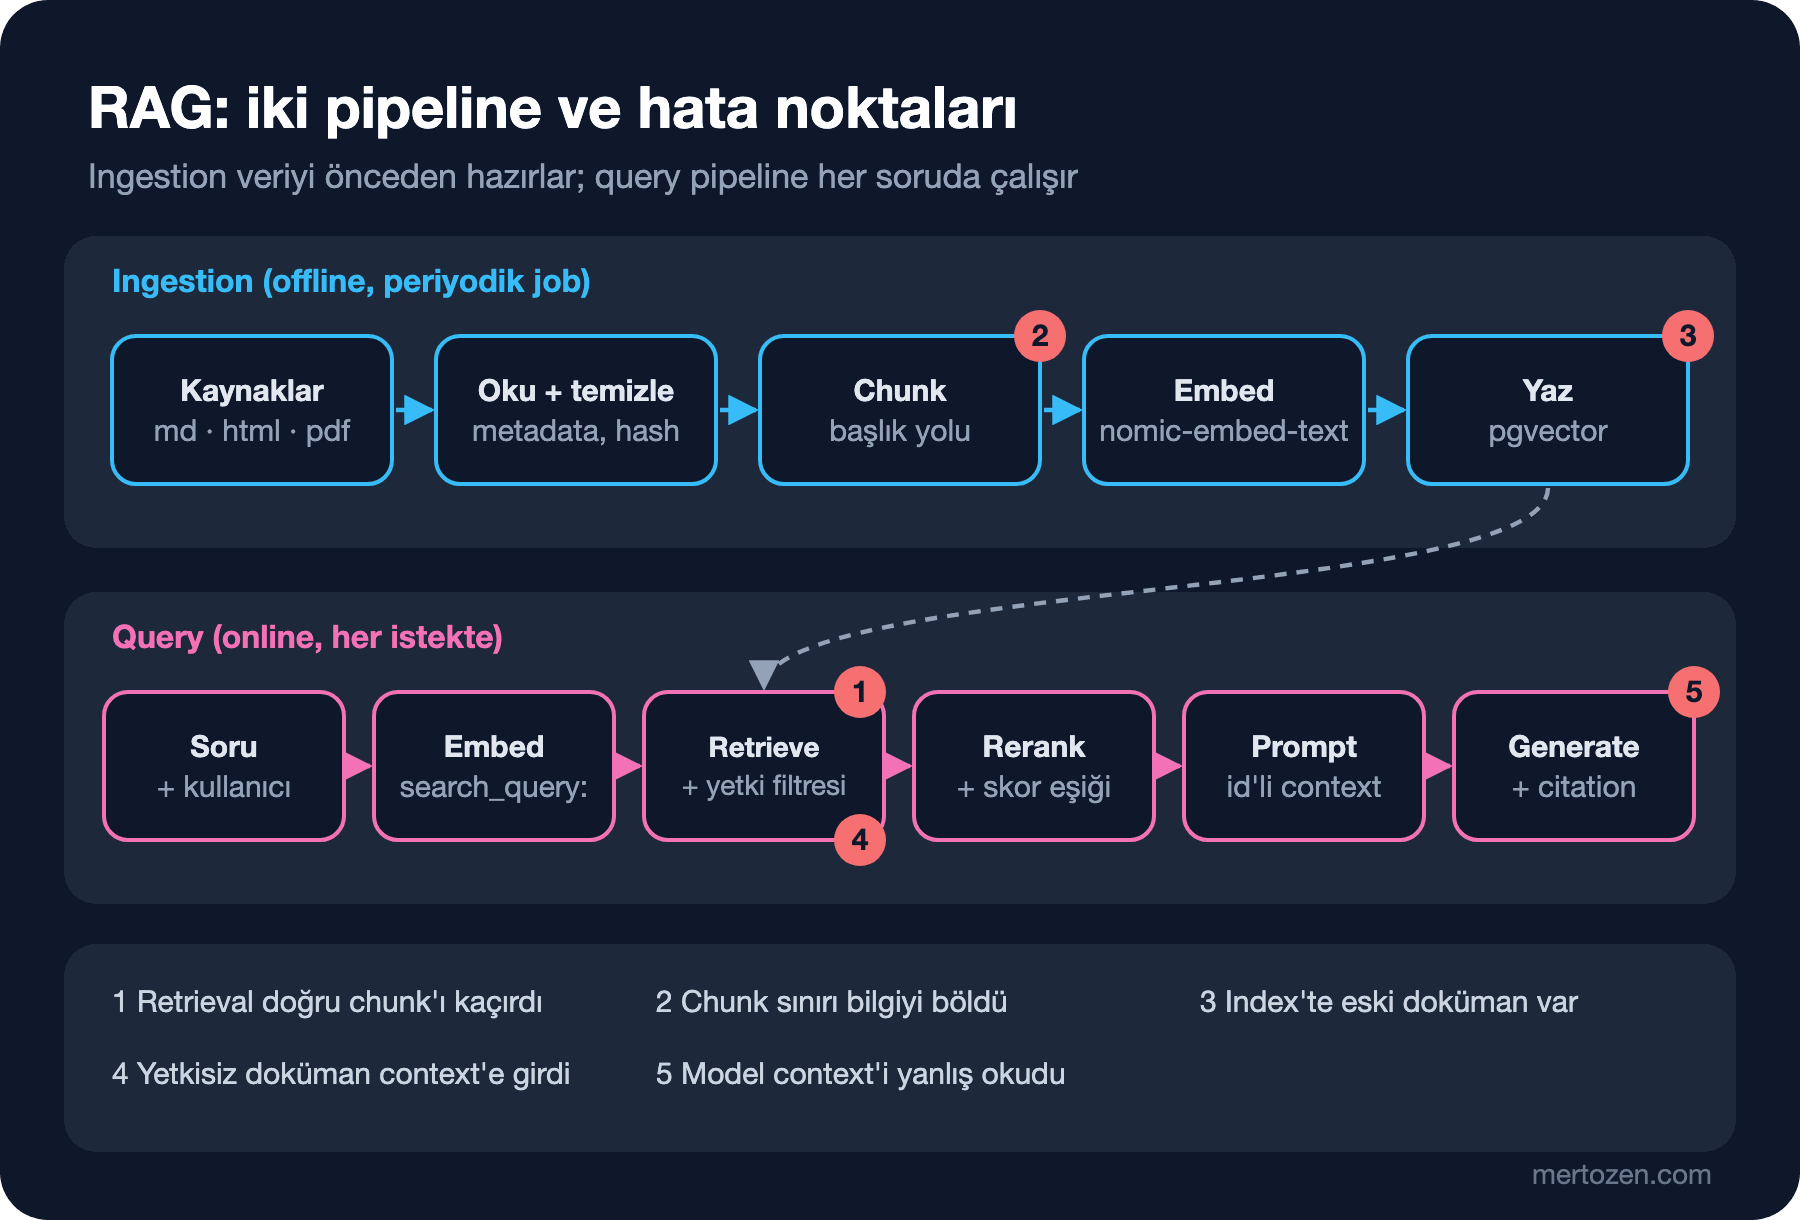
Ingestion pipeline offline çalışır: dokümanları kaynağından okur, temizler, metadata'yı çıkarır, chunk'lara böler, embed eder ve vector store'a yazar. Saniyeler değil dakikalar sürebilir, bir background job olarak periyodik ya da doküman değiştiğinde tetiklenir. Eski veri (3) ve chunk sınırı (2) hataları burada doğar: arşiv klasörünü index'e alan ya da silinen dokümanın vektörlerini bırakan, ingestion'dır.
Query pipeline her istekte çalışır ve gecikme bütçesi saniyelerle ölçülür: soruyu embed et, filtreyle retrieve et, aday chunk'ları rerank et, skor düşükse modele hiç gitme, kalanları id'leriyle prompt'a koy, cevabı üret ve citation'ları doğrula. Retrieval kaçırması (1), yetkisiz doküman (4) ve modelin yanlış okuması (5) burada olur.
Bu ayrımın pratik sonucu şu: minimal RAG'de her soru tüm dokümanları yeniden embed edebilirdi, kimse fark etmezdi. Gerçek sistemde ingestion'ın kendi takvimi, kendi hata yönetimi ve kendi metrikleri olur; query pipeline ise ingestion'ın bıraktığı index'e güvenir.
Query Pipeline'ın İskeleti
Serinin geri kalanında her adımı ayrı ayrı derinleştireceğiz, ama iskelet şimdiden belli. Aşağıdaki sınıf bellekteki index'i kullanıyor; vector database'e yedinci yazıda geçeceğiz. Ingestion tarafında tek değişiklik, standart chunker'ın artık paragrafı değil Markdown başlığı altındaki bölümün tamamını tek chunk yapması ve archive/ klasörünü index'e almaması:
public sealed record Caller(string UserId, string Tenant, IReadOnlyList<string> Roles);

public sealed record RagAnswer(string Text, IReadOnlyList<string> Sources, RagTrace Trace);

public sealed record RagTrace(string Question, IReadOnlyList<string> Retrieved, IReadOnlyList<float> Scores,
    bool AnsweredByModel, long RetrieveMs, long GenerateMs);

public sealed class QueryPipeline(InMemoryIndex index, IChatClient chat, float minScore = 0.70f, int topK = 3)
{
    public async Task<RagAnswer> AskAsync(string question, Caller caller)
    {
        Stopwatch sw = Stopwatch.StartNew();

        // 1. Retrieve: yetki filtresi aramanın İÇİNDE, sonradan değil
        List<Hit> hits = await index.SearchAsync(question, topK,
            c => c.Tenant == caller.Tenant && (c.Acl == "public" || caller.Roles.Contains(c.Acl)));
        long retrieveMs = sw.ElapsedMilliseconds;

        // 2. Rerank ve eşik: şimdilik yalnız skor eşiği (reranker 09'da)
        List<Hit> usable = hits.Where(h => h.Score >= minScore).ToList();
        if (usable.Count == 0)
        {
            RagTrace empty = new(question, hits.Select(h => h.Chunk.Id).ToList(),
                hits.Select(h => h.Score).ToList(), false, retrieveMs, 0);
            return new("Bu konuda bilgim yok.", [], empty);
        }

        // 3. Prompt: her chunk id'siyle, cevap kaynak göstersin
        string context = string.Join("\n\n", usable.Select(h => $"[{h.Chunk.Id}]\n{h.Chunk.Content}"));
        List<ChatMessage> messages =
        [
            new(ChatRole.System, """
                You are the Bookstore support assistant. Answer in Turkish.
                Answer using ONLY the facts inside <context>. Cite the ids you used like [doc#n].
                If the answer is not in <context>, reply exactly: "Bu konuda bilgim yok."
                """),
            new(ChatRole.User, $"<context>\n{context}\n</context>\n\nQuestion: {question}")
        ];

        // 4. Generate
        sw.Restart();
        ChatResponse response = await chat.GetResponseAsync(messages, new ChatOptions { Temperature = 0, Seed = 42 });
        RagTrace trace = new(question, usable.Select(h => h.Chunk.Id).ToList(),
            usable.Select(h => h.Score).ToList(), true, retrieveMs, sw.ElapsedMilliseconds);

        // 5. Citation: yalnız gerçekten verdiğimiz id'leri kabul et
        List<string> sources = usable.Select(h => h.Chunk.Id).Where(id => response.Text.Contains(id)).ToList();
        return new(response.Text.Trim(), sources, trace);
    }

    public static string ToLogLine(RagTrace trace) => JsonSerializer.Serialize(trace, LogJson);

    private static readonly JsonSerializerOptions LogJson = new() { Encoder = JavaScriptEncoder.UnsafeRelaxedJsonEscaping };
}
İki satır mimari açıdan önemli. Birincisi yetki filtresinin SearchAsync'in içine verilmesi: yetkisiz chunk'lar hiç aday olmuyor, böylece k sonucun hepsi kullanıcının görebileceği dokümanlardan geliyor. İkincisi RagTrace: her istekte hangi chunk'ların hangi skorla geldiğini ve modelin çağrılıp çağrılmadığını tek satırlık JSON (JavaScript Object Notation) olarak loglamak. Yanlış bir cevap geldiğinde ilk soru "retrieval mı, model mi?" olur ve bu satır cevabı verir.
Önce skor eşiğini 0.70'e koydum, çünkü minimal RAG'de doğru cevaplanan 20 sorunun 15'inde en yüksek skor 0.70'in üstündeydi:
$ MIN_SCORE=0.70 dotnet run -- pipeline customer "Kaç liralık alışverişte kargo bedava oluyor?"
Bu konuda bilgim yok.
sources:
{"Question":"Kaç liralık alışverişte kargo bedava oluyor?","Retrieved":["sss#2","kargo-ve-teslimat#5","kargo-ve-teslimat#1"],"Scores":[0.6895946,0.67578393,0.6729067],"AnsweredByModel":false,"RetrieveMs":26,"GenerateMs":0}
Eşik, retrieval'ın kaçırdığı soruda modeli hiç çağırmadan "bilgim yok" dedi ve birkaç saniyelik bir model çağrısı tasarruf edildi. Ama aynı eşik, ilk denediğim beş sorunun beşinde de modeli çağırmadı; bunlardan "İstanbul'da aynı gün teslimat" sorusunda doğru bölüm 0.677 ile en üstteydi. Chunker değişince skor dağılımı da kaydı. Daha önemlisi, minimal RAG'de yanlış cevaplanan 10 sorunun 7'sinde de en yüksek skor 0.70'in üstündeydi: skorun yüksek olması doğru chunk'ın geldiği anlamına gelmiyor. Eşiği bir kez seçip unutamazsın; onuncu yazıda bir ölçüm setiyle kalibre edeceğiz. Şimdilik 0.60 ile devam:
$ MIN_SCORE=0.60 dotnet run -- pipeline customer "Çalışanlarınıza indirim yapıyor musunuz?"
Kurumsal Satış Sözleşmesi'ne [kurumsal-satis-sozlesmesi#0] göre, aynı siparişte aynı kitaptan en az 50 adet alan Kurum, liste fiyatı üzerinden %15 indirim alır. 200 adet ve üzeri siparişlerde ise indirim oranı %22'dir.
sources: kurumsal-satis-sozlesmesi#0
{"Question":"Çalışanlarınıza indirim yapıyor musunuz?","Retrieved":["sadakat-programi#1","kurumsal-satis-sozlesmesi#0","sadakat-programi#2"],"Scores":[0.69410163,0.66159636,0.6609422],"AnsweredByModel":true,"RetrieveMs":18,"GenerateMs":3222}

$ MIN_SCORE=0.60 dotnet run -- pipeline staff "Çalışanlarınıza indirim yapıyor musunuz?"
Evet, çalışanlarımız kendi kullanımları için alışverişlerde %30 personel indirimi alırlar [personel-indirimi#0].
sources: personel-indirimi#0
{"Question":"Çalışanlarınıza indirim yapıyor musunuz?","Retrieved":["personel-indirimi#0","sadakat-programi#1","personel-indirimi#2"],"Scores":[0.7003257,0.69410163,0.6704573],"AnsweredByModel":true,"RetrieveMs":18,"GenerateMs":1213}
Aynı soru, iki farklı kullanıcı. Müşterinin araması personel-indirimi chunk'ını hiç görmedi; model elindeki en yakın şeyi, kurumsal indirimleri anlattı. Bu ideal bir cevap değil ama sızıntı da değil. Personel rolündeki kullanıcı ise %30'u, kaynağıyla birlikte aldı.
$ MIN_SCORE=0.60 dotnet run -- pipeline customer "İstanbul'da aynı gün teslimat yapıyor musunuz?"
Evet, İstanbul'da ekspres teslimat ile aynı gün teslimat yapıyoruz [kargo-ve-teslimat#1]. Saat 12:00'ye kadar verilen siparişler ertesi iş günü teslim edilir.
sources: kargo-ve-teslimat#1
{"Question":"İstanbul'da aynı gün teslimat yapıyor musunuz?","Retrieved":["kargo-ve-teslimat#1","kargo-ve-teslimat#2","sss#4"],"Scores":[0.6768913,0.6651281,0.65260315],"AnsweredByModel":true,"RetrieveMs":96,"GenerateMs":2138}
Burası dürüst olmamız gereken yer. Arşiv index'te olmadığı için eski 14:00 kuralı artık gelmiyor; retrieval doğru dokümanı buldu. Ama model "Evet, aynı gün" deyip hemen ardından context'teki "ertesi iş günü" cümlesini kopyaladı: kendi cevabıyla çelişti. Mimari, yetkisiz doküman ve eski veri sınıflarını yapısal olarak kapattı; retrieval kaçırması ve modelin yanlış okuması ise duruyor. Onlar mimariyle değil, ölçüm ve daha iyi parçalarla çözülür.
RAG mı, Long Context mı, Fine-Tuning mi?
Bu doküman setinin tamamı o200k_base tokenizer'ıyla 4.184 token. Bugün çoğu model bunu tek prompt'a sığdırır. O zaman neden retrieval? Çünkü gerçek Bookstore'un doküman seti 14 ürünle bitmez: binlerce ürün açıklaması, yüzlerce sözleşme, her hafta değişen kampanyalar. Hepsini her soruda prompt'a koymak her isteğin maliyetini ve gecikmesini doküman setinin boyutuna bağlar; uzun context'in ortasındaki bilgiyi modelin kaçırma eğilimi de ayrıca bir risk. Küçük ve nadiren değişen bir doküman seti için "her şeyi prompt'a koy" gerçekten makul bir başlangıç; bunu on üçüncü yazıda ölçerek karşılaştıracağız.
Fine-tuning ise farklı bir soruya cevap verir. Modelin üslubunu, biçimini ya da dar bir görevi öğretmek için iyidir; "kargo eşiği 300'den 400'e çıktı" gibi değişen bir bilgiyi modele güvenilir biçimde yerleştirmez ve her politika değişikliğinde yeniden eğitim ister. Değişen, yetkiye tabi ve kaynak gösterilmesi gereken bilgi için RAG doğru araç; ama yukarıda gördüğümüz gibi, ancak parçaları ayrı ayrı iyi yapılırsa.
Serinin Yol Haritası
Her yazı, bugün gördüğümüz hata sınıflarından birine karşılık geliyor:
- Retrieval kaçırdı: embedding model seçimi (02), hybrid search (08), reranking ve query transformation (09).
- Chunk sınırı yanlış: doküman ingestion (03) ve chunking stratejileri (04).
- Veri eski: artımlı güncelleme ve silinen dokümanların index'ten çıkarılması (03).
- Yetkisiz doküman: vector database'de filtreleme (05, 07) ve RAG'de yetki ve güvenlik (11).
- Model context'i yanlış okudu: citation, context bütçesi ve "bilmiyorum" eşiği (10), ölçüm (12).
Araya vector database seçimi (05) ve EF (Entity Framework) Core ile vector search (06, 07) giriyor; çünkü bellekteki listeyi production'a taşımadan filtre ve index konuşmanın anlamı yok. Son yazı, klasik RAG'in yetmediği yerleri, agentic RAG ve GraphRAG'i ele alıyor.
Üretimde Dikkat
Ölçmeden iyileştirme yapma. Bu yazıdaki 30 soruluk set küçük ama elle sınıflandırılmış; bir değişikliğin işe yarayıp yaramadığını ancak böyle bir setle görürsün. Chunker'ı değiştirdiğimde skor dağılımının kaydığını eşik deneyinde gördük; ölçüm seti olmasaydı bunu bir müşteri şikâyetinden öğrenecektik.
Retrieval'ı ve generation'ı ayrı logla. RagTrace satırındaki RetrieveMs 18–96 ms arasında, GenerateMs ise 1,2–3,2 saniye. Gecikmenin neredeyse tamamı model çağrısında; retrieval'ı hızlandırmak için harcayacağın emek, düşük skorlu soruda modeli hiç çağırmamakla kazanacağının yanında küçük kalır.
Yetki filtresini retrieval'a koy, prompt'a değil. "Bu dokümanları kullanıcıya gösterme" diye system prompt yazmak, yetkisiz metni modelin önüne koyup ondan susmasını rica etmektir. Filtre sorgunun içinde olduğunda yetkisiz metin hiç yüklenmez.
Ingestion'ı ayrı bir süreç olarak tasarla. Hangi klasörün index'e girdiği, hangi dokümanın en son ne zaman embed edildiği ve hangi embedding modeliyle üretildiği bir yerde kayıtlı olmalı; eski veri hatası çoğu zaman "o klasörü kim ekledi?" sorusuyla başlar.
Sık Düşülen Tuzaklar
Birincisi, demo dokümanıyla karar vermek. Altı paragraflık politika dosyasında minimal RAG kusursuz çalıştı; gerçek klasörde 30 sorunun 10'unu kaçırdı. Değerlendirmeyi kendi verinle ve kendi kullanıcılarının diliyle ("bedava", "paraya çevirmek") yap.
İkincisi, her yanlış cevabı modele yüklemek. Doğru olmayan on cevabın altısı retrieval ya da chunking kaynaklıydı; daha büyük modele geçmek bunları düzeltmez, çünkü doğru metin modele hiç ulaşmıyor.
Üçüncüsü, metadata'yı sonraya bırakmak. acl ve updated_at alanları dokümanlarda vardı ama chunk'lara taşınmadığı için kullanılamadı. Metadata'yı ingestion'ın ilk gününden chunk'la birlikte sakla; sonradan eklemek her şeyi yeniden işlemek demek.
Dördüncüsü, eşiği başka bir sistemden kopyalamak. 0.70 paragraf chunker'ında makuldü, bölüm chunker'ında her şeyi eledi. Skorlar embedding modeline, chunk boyutuna ve dile göre değişir.
Beşincisi, "bilmiyorum"u başarı saymak. Retrieval'ın kaçırdığı soruda model doğru davranıp "bilgim yok" dedi; ama cevap dokümanda vardı. Ölçümde bu bir hatadır, iyi bir davranış değil.
Küçük Bir Deneme
★☆☆ MinimalRag'in topK değerini 2'den 4'e çıkar ve "Param ne zaman hesabıma geri yatar?" sorusunu tekrar sor. "Para iadesi" bölümünün iki yarısı da geliyor mu, cevap düzeliyor mu? Prompt'un kaç token büyüdüğünü de not et.
★★☆ QueryPipeline'a bir doküman tarihi kuralı ekle: aynı title'a sahip iki dokümandan yalnız updated_at'i yeni olanın chunk'ları aday olsun. Arşiv klasörünü index'e geri alıp aynı gün teslimat sorusunu dene.
★★★ Soru setindeki 30 soruyu QueryPipeline ile, 0.55, 0.60 ve 0.65 eşikleriyle çalıştır. Her eşikte kaç doğru cevap modelden önce elendi, kaç yanlış cevap engellendi? Eşiği bu iki sayının dengesine göre seç.
Bu yazıda hata sınıflarını gördük ve iskeleti kurduk. Bir sonraki yazıda en temel parçaya, embedding modeline dönüyoruz: nomic-embed-text Türkçe sorularda ne kadar iyi, prefix'ler ve vektör boyutu sonucu nasıl değiştiriyor ve modeli değiştirmek istediğinde eski vektörlere ne olacak.