

Bir Sorgunun SQL Server İçindeki Yolculuğu: Relational Engine, Storage Engine, Buffer Pool ve Transaction Log

Bir sorgu SQL Server'da TDS ile gelir, Relational Engine'de parse, bind ve optimize edilip plan cache'e girer; Storage Engine page'leri buffer pool üzerinden okur, değişiklikler önce transaction log'a yazılır (WAL) ve data file'a checkpoint ile sonra gider. Seri boyunca kullanılacak 5,6 milyon satırlık deterministik Bookstore lab verisi, 2025 edition'ları ve compatibility level'ın motor sürümünden farkı.
Sürüm notu: Bu yazıdaki T-SQL (Transact-SQL, Microsoft'un SQL (Structured Query Language) lehçesi) örnekleri SQL Server 2025 RTM (Release To Manufacturing) CU10 (Cumulative Update 10; 17.0.5035.5, Enterprise Developer Edition, compatibility level 170) üzerinde, C# örnekleri .NET 10, Microsoft.Data.SqlClient 7.1.1 ve Dapper 2.1.89 ile denenmiştir.
Önce Tahmin Et
Bookstore veritabanında 1.000.000 sipariş var. Aynı rapor sorgusunu arka arkaya iki kez çalıştırıyoruz; ikisinin arasında hiçbir şey değişmiyor:
SET STATISTICS IO ON;
SELECT COUNT(*) AS Orders2026, SUM(TotalAmount) AS Revenue
FROM dbo.Orders
WHERE CreatedAt >= '2026-01-01';
/* aynı sorgu ikinci kez */
SELECT COUNT(*) AS Orders2026, SUM(TotalAmount) AS Revenue
FROM dbo.Orders
WHERE CreatedAt >= '2026-01-01';
İki çalıştırma da aynı sonucu döndürüyor: 210.880 sipariş, 16.560.619,87 ciro. Peki SQL Server'ın okuduğu page sayısı ikisinde aynı mı? Diske kaç kez gidildi? Tahminini yap, sonra gerçek çıktıya bak:
Table 'Orders'. Scan count 11, logical reads 7709, physical reads 1, read-ahead reads 4551, ...
Table 'Orders'. Scan count 11, logical reads 7709, physical reads 0, read-ahead reads 0, ...
Logical reads iki çalıştırmada da 7.709. Fark diskte: ilk çalıştırma 4.552 page'i diskten getirdi, ikincisi hiçbirini. Aynı sorgu, aynı plan, aynı iş; ama ikinci kez "disk" hiç devreye girmedi. Bir de şunu düşün: 100 siparişin durumunu güncelleyen bir UPDATE commit olduğunda data file'a kaç page yazılmış olur? Cevap "o anda hiçbiri". Bu yazı, bu iki cevabın arkasındaki parçaları tek tek dolaşıyor: TDS (Tabular Data Stream) protokolü, Relational Engine, Storage Engine, buffer pool, transaction log ve hepsinin altındaki SQLOS (SQL Server Operating System). Seri boyunca kullanacağımız veriyi de burada kuruyoruz.
Seri Boyunca Kullanacağımız Lab Verisi
Motorun içini görmek için birkaç bin satır yetmez: index seviyeleri, statistics histogramları, parameter sniffing ancak gerçekçi hacim ve çarpık dağılımla ortaya çıkar. Stack Overflow veritabanı gibi dış bir veri setine bağlı kalmamak için serinin klasöründe tek bir SCHEMA.sql duruyor. Script set-based T-SQL ve GENERATE_SERIES ile Bookstore şemasını kurup yaklaşık 5,6 milyon satırla dolduruyor. RAND() ya da NEWID() yok; her değer satır numarasından türeyen deterministik bir hash'ten geliyor, yani iki yükleme birebir aynı veriyi üretiyor ve yazılardaki logical reads sayılarını sen de aynen görebilirsin:
/* her yazının kendi veritabanı var */
CREATE DATABASE sqls_01;
GO
/* sqlcmd ile: sqlcmd -S localhost -d sqls_01 -I -i SCHEMA.sql */
/* script yanlış veritabanında çalışmasın diye kendini korur: */
DECLARE @Db sysname = DB_NAME();
IF @Db NOT LIKE 'sqls[_]%'
BEGIN
    RAISERROR('SCHEMA.sql must run inside a sqls_<NN> database. Current database: %s', 16, 1, @Db) WITH NOWAIT;
    RETURN;
END;
TableName Rows
---------- -------
Authors 5000
Books 40000
Customers 100000
OrderItems 2500496
Orders 1000000
Payments 1000000
Shipments 954755
StockItems 40000Yükleme bu container'da yaklaşık 13 saniye sürdü; veri ve index'ler birlikte 416 MB yer tutuyor. Dağılım bilerek çarpık: 1 numaralı müşteri (Grace Hopper, bir üniversite kütüphanesinin kurumsal hesabı) siparişlerin tam %20'sine, yani 200.000 siparişe sahip; geri kalan müşteriler bir power-law dağılımına uyuyor ve 2.190 müşterinin hiç siparişi yok. Status kolonunda 940.502 Delivered'a karşılık yalnızca 4.800 Pending var ve bunların hepsi en yeni siparişler. CreatedAt ve OrderId birlikte artıyor. Index olarak yalnızca Entity Framework Core'un (EF Core) convention'larının yaratacağı primary key, unique ve foreign key index'leri var; geri kalanını ilerleyen yazılarda adım adım kuracağız. Tablo ve kolon listesi serinin SCHEMA.md dosyasında.
Uygulamadan Motora: TDS ve Protocol Katmanı
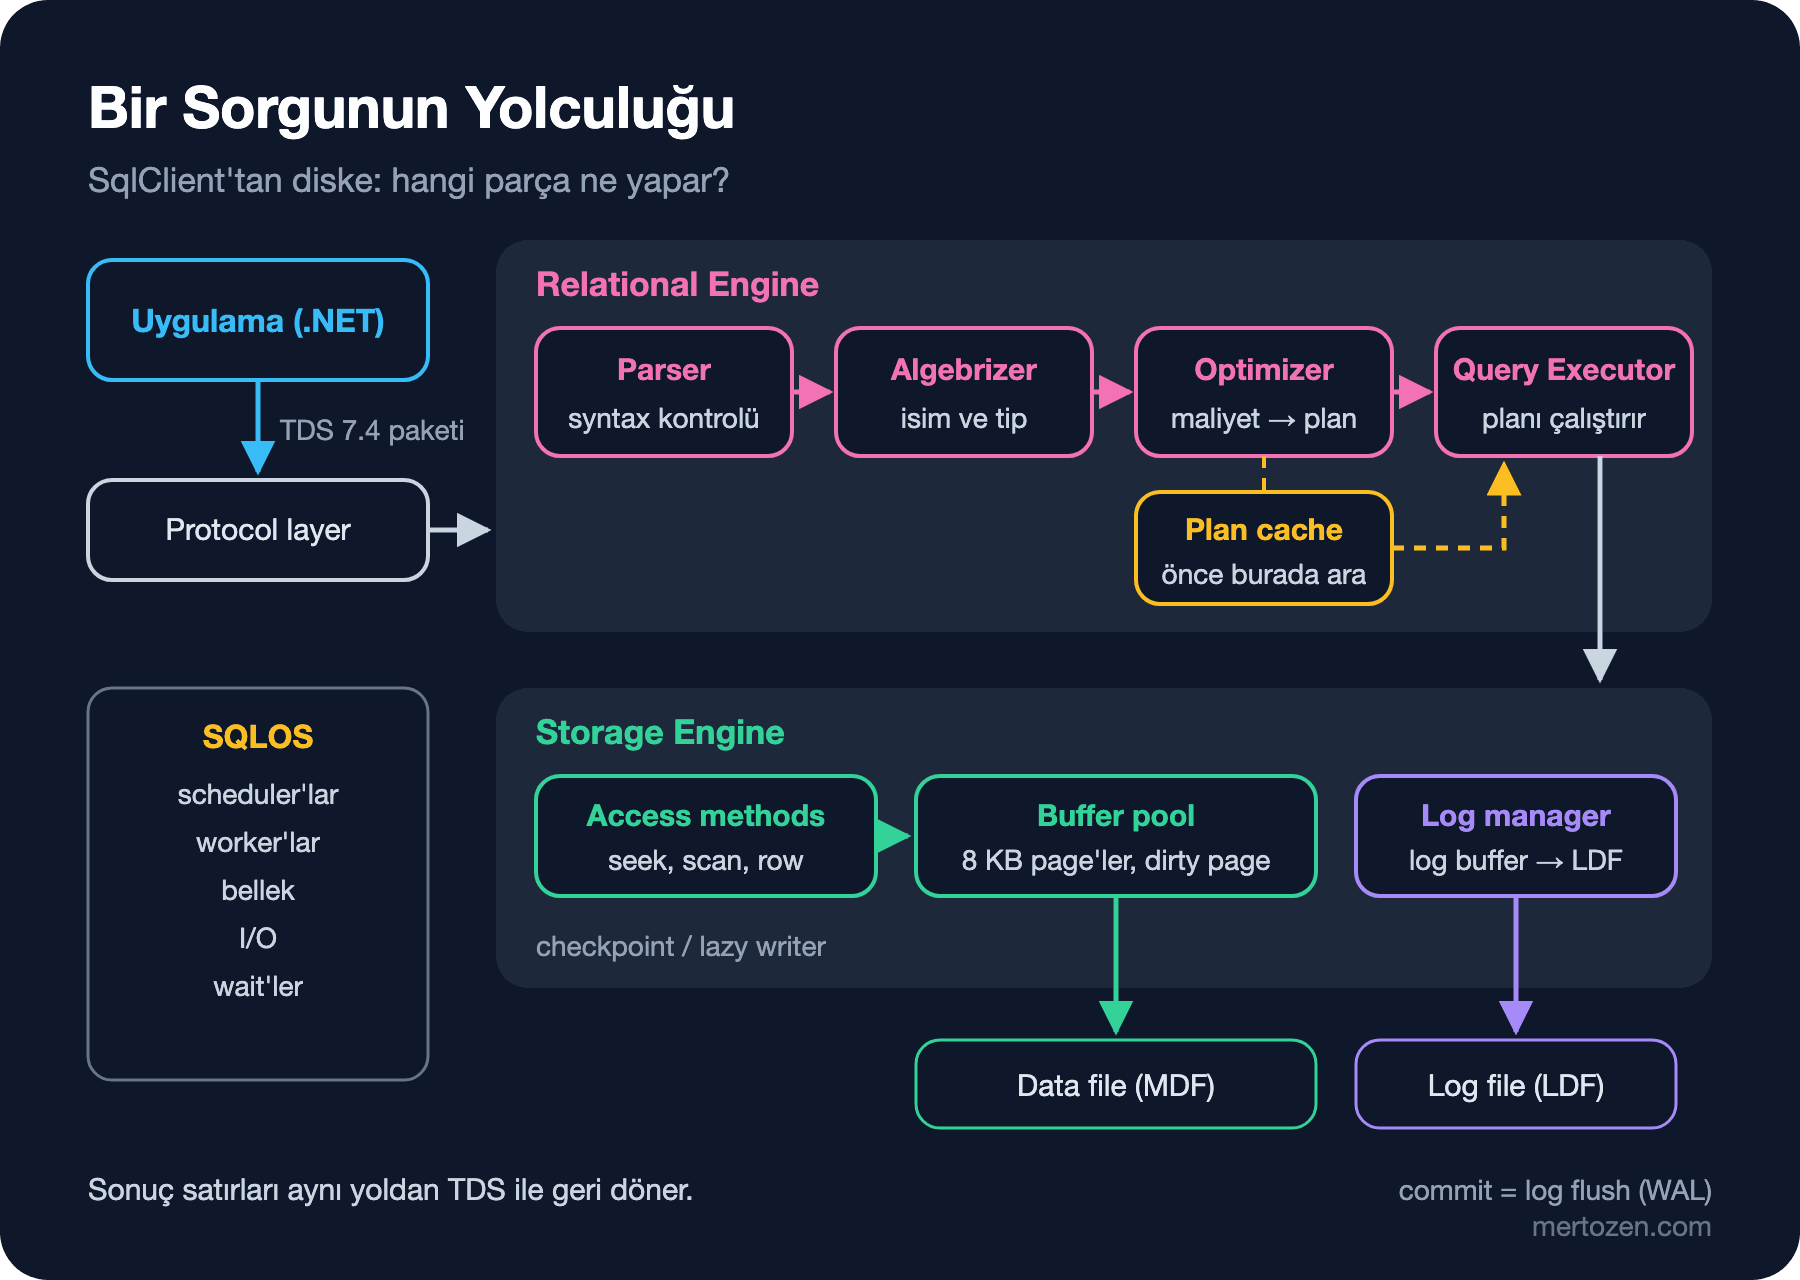
.NET uygulaman SqlConnection açtığında SqlClient sunucuyla TDS konuşur. TDS, SQL Server'ın istemciyle konuştuğu uygulama seviyesi protokoldür: login, sorgu metni, RPC (Remote Procedure Call) çağrısı, sonuç satırları ve hata mesajları hep TDS paketleri içinde taşınır. Kendi bağlantımızı DMV (Dynamic Management View) üzerinden sorabiliriz:
await using var conn = new SqlConnection(connectionString);
await conn.OpenAsync();

var session = await conn.QuerySingleAsync<SessionInfo>("""
    SELECT c.net_transport AS NetTransport, c.protocol_type AS ProtocolType,
           CONVERT(varchar(10), CONVERT(varbinary(4), c.protocol_version), 2) AS TdsVersion,
           c.encrypt_option AS EncryptOption, c.auth_scheme AS AuthScheme,
           s.program_name AS ProgramName
    FROM sys.dm_exec_connections AS c
    JOIN sys.dm_exec_sessions AS s ON s.session_id = c.session_id
    WHERE c.session_id = @@SPID
    """);
Console.WriteLine(session);

sealed record SessionInfo(string NetTransport, string ProtocolType, string TdsVersion,
    string EncryptOption, string AuthScheme, string ProgramName);
SessionInfo { NetTransport = TCP, ProtocolType = TSQL, TdsVersion = 74000004, EncryptOption = TRUE, AuthScheme = SQL, ProgramName = Core Microsoft SqlClient Data Provider }0x74000004 TDS 7.4 demek. EncryptOption = TRUE ise SqlClient 4.0'dan beri Encrypt'in varsayılan olarak açık gelmesinin sonucu; TDS 8.0 ve strict encryption'ı güvenlik yazısında ayrıca ele alacağız. Protocol katmanı paketi açar ve içindeki isteği Relational Engine'e verir. Sonuç satırları da aynı yoldan geri döner.
Relational Engine: Parse, Bind, Optimize, Execute
Relational Engine (query processor) sorgu metnini çalıştırılabilir bir plana çevirir. Bunu birbirini izleyen aşamalarla yapar ve her aşama farklı bir hata sınıfı üretir. Üç bozuk sorgu bu aşamaları ayırt etmenin en kolay yolu:
SELEC OrderId FROM dbo.Orders;           /* 1 */
SELECT OrderId, Discount FROM dbo.Orders; /* 2 */
SELECT OrderId FROM dbo.Orderz;           /* 3 */
Msg 156, Level 15, State 1, Line 2
Incorrect syntax near the keyword 'FROM'.
Msg 207, Level 16, State 1, Line 2
Invalid column name 'Discount'.
Msg 208, Level 16, State 1, Line 2
Invalid object name 'dbo.Orderz'.İlki parser'dan döndü: metin T-SQL grammar'ına uymuyor, Level 15 bir syntax hatası. İkinci ve üçüncü sorgu syntax olarak kusursuz; onları algebrizer (binding aşaması) reddetti. Algebrizer isimleri metadata'ya bağlar, kolon tiplerini çözer, gerekirse implicit conversion ekler ve sonunda optimizer'ın üzerinde çalışacağı query tree'yi üretir. Tablo yoksa ya da kolon yoksa hata buradan gelir.
Optimizer'ın işi en pahalı kısımdır, bu yüzden önce plan cache'e bakılır. Aynı parametreli sorguyu üç farklı değerle çalıştırıp cache'e bakalım:
ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE;  /* yalnız bu veritabanının planları */

EXEC sp_executesql N'SELECT o.OrderNumber, o.Status, o.TotalAmount FROM dbo.Orders AS o WHERE o.OrderId = @OrderId',
     N'@OrderId int', @OrderId = 42;
/* aynısı @OrderId = 43 ve 44 ile */

SELECT cp.objtype, cp.usecounts, cp.size_in_bytes, LEFT(st.text, 50) AS text
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle) AS st
WHERE st.text LIKE '%WHERE o.OrderId = @OrderId%' AND st.text NOT LIKE '%dm_exec%';
objtype usecounts size_in_bytes text
-------- --------- ------------- --------------------------------------------------
Prepared 3 49152 (@OrderId int)SELECT o.OrderNumber, o.Status, o.ToÜç çalıştırma, tek plan, usecounts = 3. İlk çağrı compile etti, diğer ikisi hazır planı kullandı. Plan XML'ine (Extensible Markup Language) baktığımızda optimizer'ın bu sorgu için ne kadar uğraştığı da görünüyor:
OptmLevel CE  CompileMemoryKB FirstOp
--------- --- --------------- --------------------
TRIVIAL 170 168 Clustered Index SeekTRIVIAL, primary key üzerinde eşitlik araması gibi tek makul planı olan sorgularda optimizer'ın maliyet tabanlı aramayı hiç başlatmadığı anlamına gelir. Join'li, aggregate'li bir sorgu FULL optimization'a gider: optimizer statistics'ten satır sayılarını tahmin eder (CE, cardinality estimation), alternatif planları maliyetlendirir ve "yeterince iyi" olanı seçer. CE = 170 kullanılan cardinality estimation model'inin sürümü; bunun compatibility level'dan geldiğini birazdan göreceğiz. Seçilen plan Query Executor'a gider ve executor her operator'ün ihtiyaç duyduğu satırları Storage Engine'den ister. Statistics'i dördüncü, planı okumayı beşinci yazıda, plan cache ile parameter sniffing'i yedinci yazıda derinlemesine açacağız.
Storage Engine ve Buffer Pool
Storage Engine'in access method'ları "şu index'te şu key'i ara" ya da "şu tabloyu baştan sona tara" isteklerini page isteklerine çevirir. Ama hiçbir operator diskten doğrudan okumaz; her page buffer pool üzerinden okunur. Buffer pool, SQL Server'ın data page'lerini 8 KB'lık buffer'larda tuttuğu bellek alanıdır. İstenen page orada yoksa buffer manager onu diskten getirir (physical read), sıralı okuma sezerse ileriye doğru toplu okur (read-ahead). Page oradaysa iş bellekte biter (logical read).
Açılıştaki deneyi tekrarlanabilir kılmak için paylaşılan sunucuda DBCC DROPCLEANBUFFERS gibi server genelini etkileyen bir komut kullanmadım. Veritabanını offline alıp online yapmak yalnızca o veritabanının page'lerini buffer pool'dan düşürür. Ardından sorguyu çalıştırıp buffer pool'da hangi tablonun kaç page'i olduğuna baktım:
SELECT OBJECT_NAME(p.object_id) AS TableName,
       COUNT(*) AS cached_pages,
       SUM(CASE WHEN bd.is_modified = 1 THEN 1 ELSE 0 END) AS dirty_pages
FROM sys.dm_os_buffer_descriptors AS bd
JOIN sys.allocation_units AS au ON au.allocation_unit_id = bd.allocation_unit_id
JOIN sys.partitions AS p ON p.hobt_id = au.container_id
WHERE bd.database_id = DB_ID() AND OBJECT_SCHEMA_NAME(p.object_id) = 'dbo'
GROUP BY p.object_id;
TableName cached_pages dirty_pages
---------- ------------ -----------
Authors 1 0
Books 1 0
Customers 2 0
Orders 7604 0
OrderItems 1 0
StockItems 1 0
Payments 1 0
Shipments 2 0Orders'ın clustered index'i 7.601 leaf page'den oluşuyor; sorgu CreatedAt üzerinde index olmadığı için hepsini taradı ve şimdi neredeyse tamamı bellekte. İkinci çalıştırmanın physical read'i bu yüzden sıfır. Burada iki pratik sonuç var. Birincisi: performans karşılaştırırken logical reads'e bak, çünkü physical reads o anki cache durumuna bağlı ve aynı sorgu için çalıştırmadan çalıştırmaya değişir. İkincisi: Scan count 11 sorgunun paralel çalıştığını söylüyor; sunucuda 10 scheduler var ve tarama thread'lere bölündü. Paralelliği altıncı yazıda konuşacağız.
Yazma Yolu: Dirty Page, Write-Ahead Logging ve Checkpoint
Okuma buffer pool'da biter; yazma da öyle. Bir UPDATE page'i buffer pool'da değiştirir ve page "dirty" olarak işaretlenir. Data file'a o anda hiçbir şey yazılmaz:
CHECKPOINT;
UPDATE dbo.Orders SET Status = 'Delivered'
WHERE OrderId BETWEEN 999001 AND 999100 AND OrderId % 25 <> 7;

SELECT ISNULL(OBJECT_NAME(p.object_id), '(other)') AS ObjectName, COUNT(*) AS dirty_pages
FROM sys.dm_os_buffer_descriptors AS bd
LEFT JOIN sys.allocation_units AS au ON au.allocation_unit_id = bd.allocation_unit_id
LEFT JOIN sys.partitions AS p ON p.hobt_id = au.container_id
WHERE bd.database_id = DB_ID() AND bd.is_modified = 1
GROUP BY p.object_id;
ObjectName dirty_pages
---------- -----------
Orders 2Peki sunucu tam bu anda kapanırsa güncelleme nasıl kaybolmuyor? Cevap WAL (write-ahead logging): değişikliği anlatan log record'u, data page'inden önce ve en geç commit anında transaction log'a (LDF dosyasına) yazılır. Commit'in "bitti" demesi, log record'larının diske flush edilmesi demektir; data page'leri sonra, kendi zamanlarında yazılır. Tek satırlık bir transaction'ın log'a ne bıraktığını sys.fn_dblog ile görebiliriz (belgelenmemiş bir fonksiyon, yalnızca deneme ortamında kullan):
BEGIN TRANSACTION;
UPDATE dbo.StockItems SET QuantityOnHand = QuantityOnHand - 1 WHERE BookId = 1;
COMMIT;
Current LSN Operation Context Transaction ID AllocUnitName
---------------------- --------------- ------------- -------------- ---------------------------
00000041:000021D8:0001 LOP_BEGIN_XACT LCX_NULL 0000:00002e33 NULL
00000041:000021D8:0002 LOP_MODIFY_ROW LCX_CLUSTERED 0000:00002e33 dbo.StockItems.PK_StockItems
00000041:000021D8:0003 LOP_COMMIT_XACT LCX_NULL 0000:00002e33 NULLHer log record'un bir LSN'i (Log Sequence Number) var ve değiştirdiği page de son değişikliğin LSN'ini taşır. Sunucu çökerse açılışta recovery log'u okur: commit olmuş ama data file'a ulaşmamış değişiklikleri yeniden uygular (redo), commit olmamışları geri alır (undo). Dirty page'leri diske yazan iki mekanizma var. Checkpoint, dirty page'leri periyodik olarak yazarak recovery'nin okuması gereken log miktarını sınırlar; SQL Server 2016'dan beri yeni veritabanları indirect checkpoint ile ve 60 saniyelik bir hedef recovery süresiyle gelir (sys.databases.target_recovery_time_in_seconds bizim veritabanında da 60). Lazy writer ise bellek baskısı olduğunda soğuk page'leri boşaltır, gerekirse önce diske yazar. Elle CHECKPOINT çalıştırınca dirty page sayısı sıfıra indi. Transaction'lar, log'un büyümesi ve recovery model'ler dokuzuncu yazının konusu.
SQLOS: Scheduler'lar, Worker'lar ve Wait'ler
Bütün bu parçaların altında SQLOS durur: SQL Server'ın işletim sistemiyle arasına koyduğu katman. Thread'leri işletim sistemine bırakmak yerine kendi scheduler'larında cooperative (non-preemptive) şekilde çalıştırır, belleği kendi clerk'leriyle yönetir, I/O'yu kendi yapar. Linux'ta da Windows'ta da aynı motor bu katman sayesinde çalışır.
SELECT status, COUNT(*) AS schedulers FROM sys.dm_os_schedulers GROUP BY status;
SELECT r.session_id, r.scheduler_id, r.status, r.command
FROM sys.dm_exec_requests AS r WHERE r.session_id = @@SPID;
status schedulers
-------------------- ----------
HIDDEN ONLINE 9
VISIBLE ONLINE 10
VISIBLE ONLINE (DAC) 1
session_id scheduler_id status command
---------- ------------ ------- -------
59 0 running SELECT10 CPU (Central Processing Unit) için 10 görünür scheduler var; bir tane de DAC (Dedicated Admin Connection) için ayrılmış. Bir worker CPU'yu bırakıp bir şey beklemeye başladığında (bir page'in diskten gelmesi, bir lock, log flush) bunu bir wait type olarak kaydeder: PAGEIOLATCH_SH, LCK_M_X, WRITELOG gibi. "Veritabanı yavaş" şikâyetini ölçerek çözmenin başlangıç noktası bu wait'lerdir; teşhis yazısında bu katmana geri döneceğiz.
Edition'lar ve Compatibility Level
SQL Server 2025 (17.x) 18 Kasım 2025'te genel kullanıma çıktı. Edition tablosunda bu sürümle gelen değişiklikler şöyle:
| Edition | Önemli sınır | Not |
|---|---|---|
| Enterprise | İşletim sistemi sınırı | Bütün IQP (Intelligent Query Processing) feedback özellikleri burada |
| Standard | 4 socket veya 32 core, buffer pool 256 GB | 2022'de 24 core idi; Resource Governor artık Standard'da da var |
| Express | Veritabanı başına 50 GB, buffer pool 1.410 MB | 2022'de 10 GB idi; Advanced Services ayrı edition olarak kalktı |
| Enterprise Developer | Enterprise ile aynı | Ücretsiz, yalnızca geliştirme ve test |
| Standard Developer | Standard ile aynı | Ücretsiz; production'ı Standard olan ekipler için yeni |
İki Developer edition'ın ayrılması pratik bir sorunu çözüyor: eskiden geliştirici makinesinde Enterprise özellikleriyle (batch mode on rowstore, adaptive join, memory grant feedback) test edip production'da Standard'la çalışınca planların neden farklı olduğunu anlamak zordu. Bu seride kullandığım container Enterprise Developer; Standard'da olmayan bir özellik gördüğümüzde bunu ayrıca belirteceğim.
Motorun sürümü ile veritabanının compatibility level'ı ayrı şeylerdir. Motor 17.x, ama her veritabanı hangi davranış setiyle çalışacağını compatibility level ile seçer. Aynı sunucuda level'ı 150'ye indirip deneyelim:
ALTER DATABASE CURRENT SET COMPATIBILITY_LEVEL = 150;
GO
SELECT value FROM GENERATE_SERIES(1, 3);
GO
SET SHOWPLAN_XML ON;
GO
SELECT COUNT(*) FROM dbo.Orders WHERE CustomerId = 42;
GO
SET SHOWPLAN_XML OFF;
GO
ALTER DATABASE CURRENT SET COMPATIBILITY_LEVEL = 170;
Msg 208, Level 16, State 1, Line 1
Invalid object name 'GENERATE_SERIES'.
CardinalityEstimationModelVersion="150"Motor 2025 olduğu hâlde GENERATE_SERIES (level 160 ister) tanınmadı ve optimizer CE model'inin 150 sürümünü kullandı. PSP (Parameter Sensitive Plan) optimization, DOP (degree of parallelism) feedback ve OPPO (Optional Parameter Plan Optimization) gibi özelliklerin çoğu da compatibility level'a bağlı. Bu yüzden "sunucuyu 2025'e yükselttik" demek, veritabanları eski level'da kaldıkça yeni optimizer davranışlarının çoğunu almadık demektir. Yükseltme stratejisi serinin son yazısında.
SQL Server 2019/2022'de farkı: 2019'da varsayılan level 150, 2022'de 160; GENERATE_SERIES 2022 ile geldi, yani bu serinin SCHEMA.sql'i 2019'da çalışmaz. 2022'de Standard 24 core ve 128 GB buffer pool, Express 10 GB ile sınırlı ve tek bir Developer edition var. Parser, algebrizer, buffer pool ve WAL mimarisi ise üç sürümde de aynı.
Üretimde Dikkat
Ölçerken logical reads'i esas al. Physical reads ve süre, cache'in o anki durumuna, diskin hızına ve sunucudaki diğer yüke göre değişir; logical reads aynı plan ve aynı veri için sabittir. Bu seride süre yerine logical reads, row sayısı, plan operator'leri ve wait type'ları göstermemin sebebi de bu: container emülasyonla çalışıyor ve mutlak süreler hiçbir şey kanıtlamaz.
Buffer pool'u boşaltan komutları production'da çalıştırma. DBCC DROPCLEANBUFFERS ve DBCC FREEPROCCACHE bütün sunucuyu soğuk başlatır; ardından gelen dakikalarda her sorgu diske gider ve yeniden compile olur. Tek bir veritabanının plan cache'ini temizlemek gerekiyorsa ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE var.
Commit hızı log diskinin hızıdır. WAL yüzünden her commit log flush'ını bekler; çok sayıda küçük transaction açan bir uygulamada WRITELOG wait'i yükselir. Toplu işlemleri tek transaction'da gruplamak ya da log'u hızlı bir diske koymak bu yüzden etkilidir.
Sık Düşülen Tuzaklar
İlk çalıştırmanın süresini benchmark sanmak. İlk çalıştırma compile eder ve page'leri diskten getirir; ikinci çalıştırma ikisini de yapmaz. "Index ekledim, sorgu 10 kat hızlandı" sonucunun yarısı bazen sadece cache'in ısınmasıdır.
Compatibility level'ı unutmak. Restore edilen ya da eski sunucudan taşınan bir veritabanı eski level'ında kalır. SELECT name, compatibility_level FROM sys.databases sorgusu yükseltme sonrası ilk bakılacak yer.
"Commit oldu, demek ki data file'da" varsaymak. Data file her an commit edilmemiş değişiklik içerebilir ve commit edilmiş değişikliği henüz içermeyebilir. Tutarlılığı sağlayan data file değil, log ve recovery'dir; bu yüzden data file'ları SQL Server çalışırken kopyalamak yedek değildir.
Edition farkını test ortamında görmemek. Enterprise Developer'da güzel çalışan bir plan, Standard'da batch mode ve memory grant feedback olmadığı için farklı davranabilir. Production Standard ise testi Standard Developer'da yap.
Küçük Bir Deneme
★☆☆ Kendi sqls_01 veritabanını oluştur, SCHEMA.sql'i yükle ve tablo satır sayılarının bu yazıdakilerle aynı olduğunu doğrula. Sonra EXEC sp_spaceused ile veritabanının boyutuna bak.
★★☆ Açılıştaki sorguyu WHERE CustomerId = 42 filtresiyle çalıştır. Logical reads neden 7.709'dan çok daha az? Planda hangi index'in kullanıldığını SET SHOWPLAN_TEXT ON ile bul.
★★★ Bir UPDATE'i BEGIN TRANSACTION ile başlat ama commit etme. Başka bir oturumdan sys.dm_tran_database_transactions ile o transaction'ın ürettiği log byte'larını, sys.databases.log_reuse_wait_desc ile de log'un neden truncate edilemediğini incele. Sonra ROLLBACK et ve aynı değerlere tekrar bak.
Sorgunun yolculuğunda page'lerin buffer pool'a nasıl geldiğini gördük ama page'in içine hiç bakmadık. Bir sonraki yazıda 8 KB'lık page'in yapısını, heap ile clustered index arasındaki farkı, B-tree seviyelerini ve GUID (Globally Unique Identifier) key'lerin neden page split'e yol açtığını gerçek page'ler üzerinden inceleyeceğiz.