

Execution Plan Okumak 1: Estimated vs Actual Plan, Operator'ler ve Join Algoritmaları

Execution plan sağdan sola, içten dışa okunur; ilk bakılacak şey cost yüzdesi değil, tahmini ve gerçek satır sayısı ile her operator'ün kaç kez çalıştığıdır. EF Core Include sorgusunun actual plan'ında cost yüzdesinin yanılttığı yer, seek/scan/lookup, nested loops, merge ve hash join'in aynı sorguda ölçülen maliyetleri, stream ve hash aggregate ve iki index'le 2.549'dan 689 logical read'e iniş.
Sürüm notu: Bu yazıdaki T-SQL (Transact-SQL, Microsoft'un SQL (Structured Query Language) lehçesi) örnekleri SQL Server 2025 CU10 (17.0.5035.5, compatibility level 170) üzerinde, C# örnekleri .NET 10 ve Entity Framework Core (EF Core) 10.0.14 ile denenmiştir.
Önce Tahmin Et
Müşteri detay sayfası, müşterinin 2026'daki siparişlerini kalemleriyle birlikte EF Core'un Include'uyla çekiyor:
int customerId = 42;
var since = new DateTime(2026, 1, 1);
var orders = await db.Orders
    .Where(o => o.CustomerId == customerId && o.CreatedAt >= since)
    .Include(o => o.Items)
    .OrderByDescending(o => o.CreatedAt)
    .ToListAsync();
Console.WriteLine($"{orders.Count} orders, {orders.Sum(o => o.Items.Count)} items");
104 orders, 244 itemsEF Core'un ürettiği SQL'i aynı parametre tipleriyle (@customerId int, @since datetime2(7)) sunucuda çalıştırıp actual plan'ı aldım. Planda sekiz operator var ve SSMS (SQL Server Management Studio) her birinin üstüne bir "Cost %" yazıyor. Sence en pahalı operator hangisi: en yüksek yüzdeli olan mı, yoksa başka biri mi? Aşağıdaki şekle bakmadan önce tahmin et.
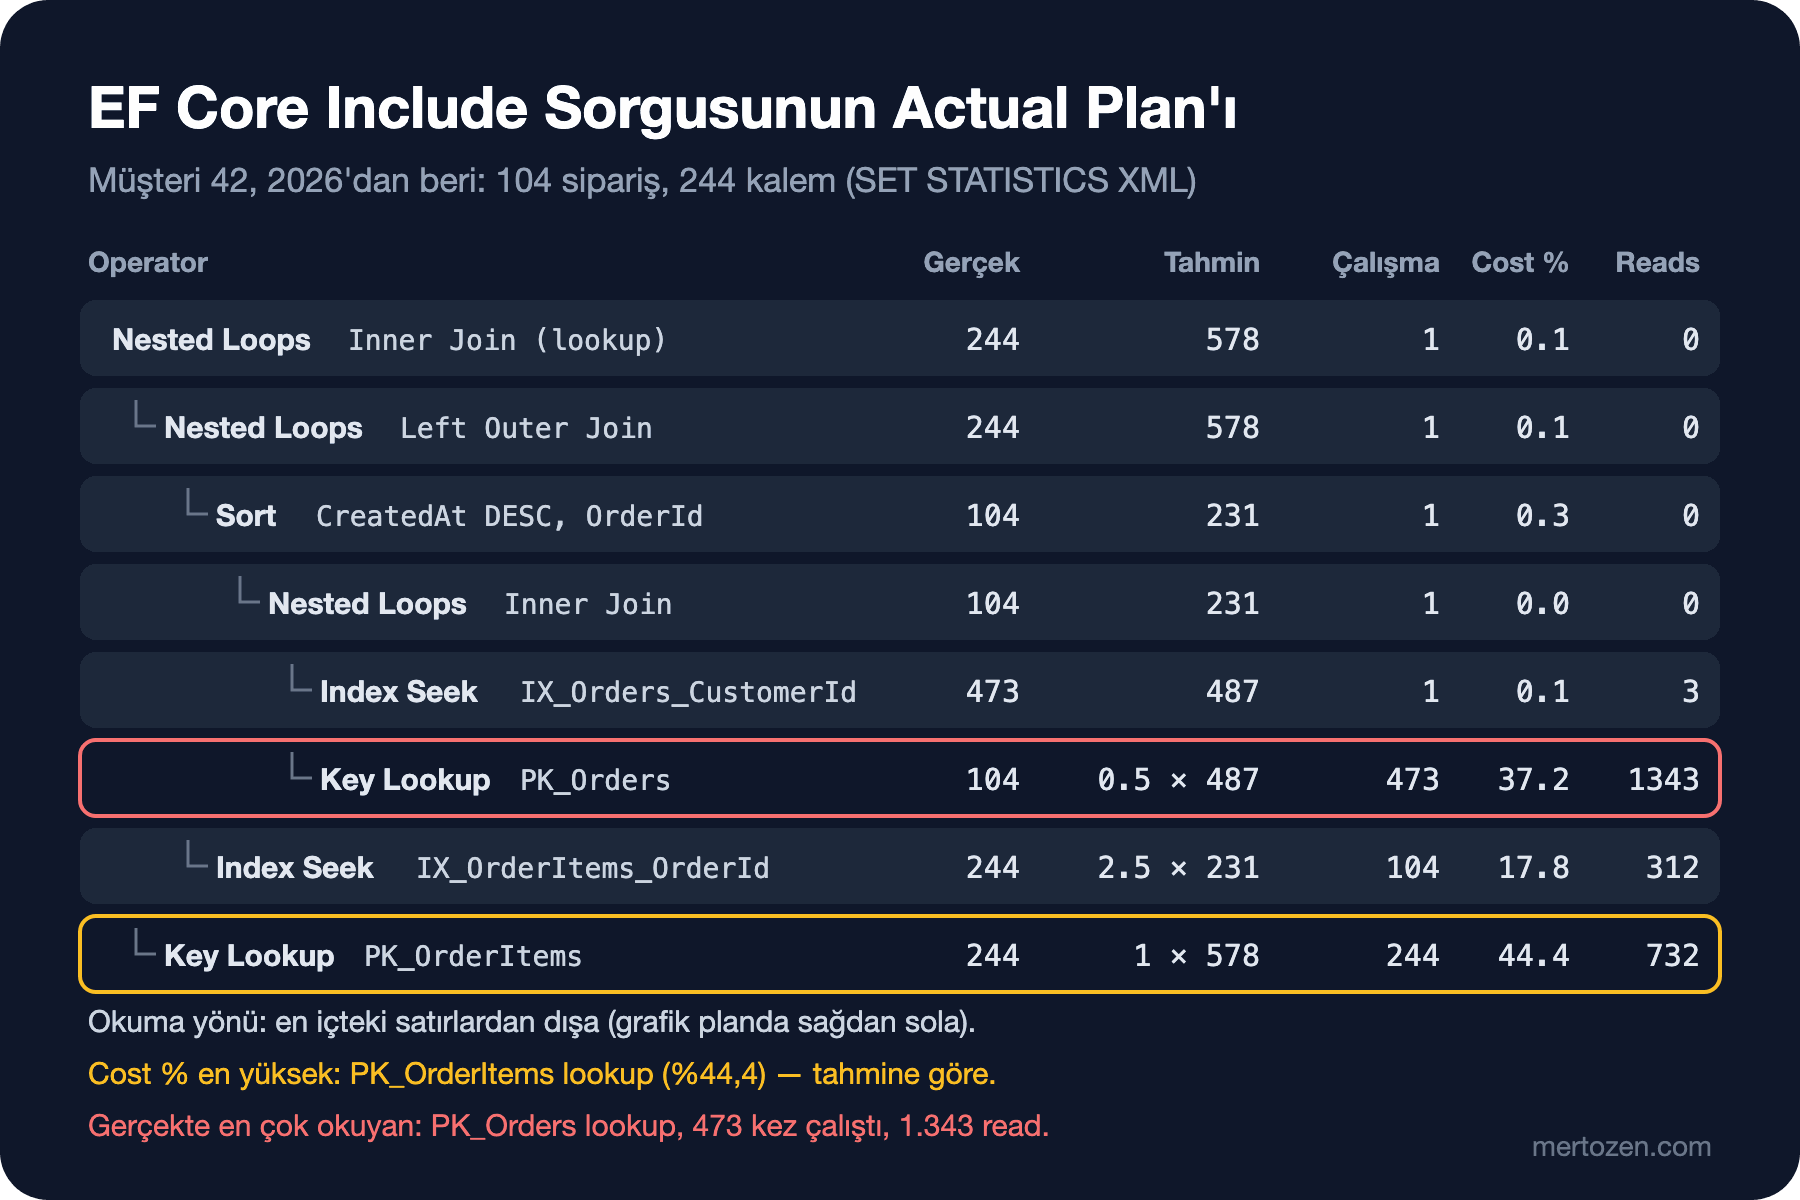
Cost yüzdesine göre en pahalısı PK_OrderItems lookup'ı (%44,4). Gerçekte en çok page okuyan ise PK_Orders lookup'ı: 473 kez çalıştı ve 1.343 logical read yaptı, planın bütün okumalarının yarısından fazlası. Çünkü cost yüzdesi çalıştırmadan önce, tahminlerle hesaplanır ve actual plan'da bile değişmez. Bu yazıda planı nasıl alacağımızı, nasıl okuyacağımızı, temel operator'leri ve üç join algoritmasını konuşacağız; en önemli alışkanlık da şu olacak: önce tahmin edilen ve gerçekleşen satır sayısını karşılaştır.
Plan Nasıl Alınır?
İki tür plan var. Estimated plan sorgu çalıştırılmadan derlenen plandır: operator'ler, tahmini satır sayıları ve maliyetler. Actual plan aynı planın çalıştırıldıktan sonraki hâlidir: her operator için gerçek satır sayısı, kaç kez çalıştığı (executions) ve operator bazında logical reads gibi runtime bilgileri eklenir. Planın kendisi değişmez; değişen, üzerine yazılan ölçümlerdir.
/* estimated: sorgu çalışmaz */
SET SHOWPLAN_XML ON;      /* ya da metin olarak SET SHOWPLAN_TEXT ON */

/* actual: sorgu çalışır, plan sonuç olarak döner */
SET STATISTICS XML ON;    /* ya da metin olarak SET STATISTICS PROFILE ON */
SET STATISTICS IO ON;     /* tablo bazında logical/physical reads */

/* cache'teki plan (estimated) */
SELECT qp.query_plan
FROM sys.dm_exec_query_stats AS qs
CROSS APPLY sys.dm_exec_query_plan(qs.plan_handle) AS qp;

/* son çalıştırmanın actual plan'ı (2019+, veritabanı seviyesinde açılır) */
ALTER DATABASE SCOPED CONFIGURATION SET LAST_QUERY_PLAN_STATS = ON;
SELECT ps.query_plan
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_query_plan_stats(cp.plan_handle) AS ps;
Grafik araçlarda karşılıkları: SSMS 22'de (11 Kasım 2025'te genel kullanıma çıktı) Ctrl+L estimated, Ctrl+M actual plan'ı açar; Visual Studio Code'un (VS Code) MSSQL (Microsoft SQL Server) extension'ı da planı grafik olarak gösterebiliyor. Bu seride ekran görüntüsü yerine planın metin hâlini ve XML'den (Extensible Markup Language) okunan değerleri kullanıyorum, çünkü aynı bilgiyi içerirler ve kopyalanabilirler. Production'da bir sorgunun geçmiş planlarını görmek için en iyi kaynak ise Query Store; onu sekizinci yazıda açacağız. Operator'leri tek tek, örnekleriyle öğrenmek istersen Grant Fritchey'nin Redgate tarafından ücretsiz e-kitap olarak yayımlanan SQL Server Execution Plans kitabı (3. baskı) iyi bir başvuru kaynağı.
Planı Okumak: Sağdan Sola, İçten Dışa
EF Core'un ürettiği SQL şu:
SELECT [o].[OrderId], [o].[CreatedAt], [o].[Currency], [o].[CustomerId], [o].[OrderNumber], [o].[Status], [o].[TotalAmount],
       [o0].[OrderItemId], [o0].[BookId], [o0].[OrderId], [o0].[Quantity], [o0].[UnitPrice]
FROM [Orders] AS [o]
LEFT JOIN [OrderItems] AS [o0] ON [o].[OrderId] = [o0].[OrderId]
WHERE [o].[CustomerId] = @customerId AND [o].[CreatedAt] >= @since
ORDER BY [o].[CreatedAt] DESC, [o].[OrderId]
Planın metin hâlinde (SET STATISTICS PROFILE ON) sol kolonlar gerçek satır sayısı, çalıştırma sayısı ve tahmini satır sayısı:
    Rows Executes EstimateRows
     244        1    578.45044  |--Nested Loops(Inner Join, PASSTHRU:([IsBaseRow1001] IS NULL), OUTER REFERENCES:([o0].[OrderItemId]))
     244        1    578.45044       |--Nested Loops(Left Outer Join, OUTER REFERENCES:([o].[OrderId], [Expr1003]) WITH ORDERED PREFETCH)
     104        1    231.33427       |    |--Sort(ORDER BY:([o].[CreatedAt] DESC, [o].[OrderId] ASC))
     104        1    231.33427       |    |    |--Nested Loops(Inner Join, OUTER REFERENCES:([o].[OrderId], [Expr1002]) WITH UNORDERED PREFETCH)
     473        1    486.77777       |    |         |--Index Seek(OBJECT:([Orders].[IX_Orders_CustomerId] AS [o]), SEEK:([o].[CustomerId]=[@customerId]))
     104      473   0.47523591       |    |         |--Clustered Index Seek(OBJECT:([Orders].[PK_Orders] AS [o]), ... WHERE:([o].[CreatedAt]>=[@since]) LOOKUP)
     244      104    2.5004959       |    |--Index Seek(OBJECT:([OrderItems].[IX_OrderItems_OrderId] AS [o0]), SEEK:([o0].[OrderId]=[o].[OrderId]))
     244      244          1.0       |--Clustered Index Seek(OBJECT:([OrderItems].[PK_OrderItems] AS [o0]), ... LOOKUP)
Grafik planda veri sağdan sola akar; metin planda da en içteki satırlardan dışarı doğru okunur. Bu planın hikâyesi: IX_Orders_CustomerId müşteri 42'nin 473 siparişini buldu. Index'te CreatedAt olmadığı için her biri için PK_Orders'a lookup yapıldı (473 çalıştırma) ve tarih filtresi orada uygulandı; 104 sipariş kaldı. Bunlar ORDER BY için sıralandı. Sonra her sipariş için IX_OrderItems_OrderId'de kalemler arandı (104 çalıştırma) ve index'te olmayan BookId, Quantity, UnitPrice için her kalemde bir lookup daha yapıldı (244 çalıştırma).
Grafik plandaki okların kalınlığı o oktan geçen satır sayısını gösterir; estimated plan'da tahmini, actual plan'da gerçek satır sayısını. Kalın bir okun ince bir operator'e girmesi, ya da tersine "1 satır" tahmin edilen bir ok üzerinden binlerce satır geçmesi, ilk bakılacak yerlerdir. Executes değeri de en az satır sayısı kadar önemlidir: tahmini maliyeti küçük ama 473 kez çalışan bir operator, maliyeti büyük ama bir kez çalışan bir operator'den pahalı olabilir.
Erişim Operator'leri: Seek, Scan, Lookup
Üçüncü yazıda ayrıntısıyla gördüğümüz üç erişim şeklini planda şöyle tanırsın. Index Seek / Clustered Index Seek: B-tree'de belirli bir key'e ya da aralığa iner. Index Scan / Clustered Index Scan: index'in tamamını (ya da paralel planda bir bölümünü) okur; heap'te bunun adı Table Scan'dir. Key lookup: grafik planda "Key Lookup (Clustered)", metin planda LOOKUP kelimesi taşıyan bir Clustered Index Seek; nonclustered index'te olmayan kolonlar için satır başına clustered index'e gidiş. Heap'teki karşılığı RID (Row Identifier) Lookup'tır.
Her erişim operator'ünde iki kısma ayrı bak: SEEK: index'te aranan aralığı, WHERE: okunan satırlara sonradan uygulanan residual predicate'i gösterir. Yukarıdaki PK_Orders lookup'ında tarih filtresi WHERE:'da: 473 satır okunup 369'u atıldı. Bu, index'in eksik olduğunun en net işaretidir.
Join Algoritmaları: Nested Loops, Merge Join ve Hash Match
SQL Server iki tabloyu üç fiziksel yöntemle birleştirebilir. Aynı sorguyu (son 100.000 siparişin kalem adetleri) her biriyle zorlayıp ölçtüm; karşılaştırma adil olsun diye hepsini MAXDOP 1 ile tek thread'de çalıştırdım:
SELECT o.OrderId, o.OrderNumber, SUM(oi.Quantity) AS Units
FROM dbo.Orders AS o
JOIN dbo.OrderItems AS oi ON oi.OrderId = o.OrderId
WHERE o.OrderId BETWEEN 900001 AND 1000000
GROUP BY o.OrderId, o.OrderNumber
OPTION (MAXDOP 1); /* ve OPTION (LOOP JOIN | MERGE JOIN | HASH JOIN, MAXDOP 1) */| Hint | Join operator'ü | Orders reads | OrderItems reads | Not |
|---|---|---|---|---|
| Yok (optimizer'ın seçimi) | Adaptive Join | 758 | 9902 | Çalışma anında hash join'e karar verdi |
LOOP JOIN | Nested Loops | 306.259 | 9902 | 100.000 kez PK_Orders seek |
MERGE JOIN | Merge Join | 758 | 9902 | Aggregate sonrası bir Sort eklendi |
HASH JOIN | Hash Match | 758 | 9902 | Bellekte hash tablosu |
Nested loops dış girdinin her satırı için iç girdiyi bir kez çalıştırır. Dış taraf küçükse ve iç tarafta index varsa rakipsizdir; Include planındaki bütün join'ler bu yüzden nested loops. Bellek istemez ve ilk satırı hemen döndürmeye başlar. Ama dış taraf büyüdükçe maliyeti doğrusal artar: burada 100.000 seek, 306.259 logical read. Önceki yazıdaki "1 satır" tahmininin pahalıya patlamasının sebebi de buydu.
Merge join iki girdinin join key'ine göre sıralı olmasını ister ve ikisini fermuar gibi birlikte yürür. Girdiler index sayesinde zaten sıralıysa çok ucuzdur. Değilse optimizer bir Sort ekler ve sort bellek ister. Bizim planda Orders tarafı PK_Orders sırasında geliyordu, ama kalemler aggregate'ten hash sırasıyla çıktığı için yeniden sıralanmaları gerekti.
Hash match küçük girdiden (build) bellekte bir hash tablosu kurar ve büyük girdiyi (probe) onun üzerinden geçirir. Sıra istemez, büyük ve sırasız girdilerde iyidir. Bedeli bellek: build tarafı tahminden büyük çıkarsa hash tablosu tempdb'ye taşar (spill). Build bitmeden çıktı üretemediği için blocking'dir.
Hint'siz plandaki Adaptive Join ilginç olan: optimizer nested loops ile hash join arasındaki kararı çalışma anına bırakmış, build tarafındaki gerçek satır sayısına göre birini seçiyor. Batch mode ile çalışan bu operator'ü bir sonraki yazıda memory grant ve paralellikle birlikte inceleyeceğiz. Join hint'leri burada yalnızca ölçmek için; production sorgusunda join tipini zorlamak, verinin değişebileceği her durumda optimizer'ı devre dışı bırakmak demektir.
Aggregate: Stream Aggregate ve Hash Aggregate
Gruplamada da iki yöntem var ve seçimi yine girdinin sıralı olup olmaması belirler:
SELECT CustomerId, COUNT(*) AS Orders FROM dbo.Orders WHERE CustomerId <= 1000 GROUP BY CustomerId OPTION (MAXDOP 1);
SELECT Status, COUNT(*) AS Orders FROM dbo.Orders GROUP BY Status OPTION (MAXDOP 1);
Table 'Orders'. Scan count 1, logical reads 650
1000 1 1000.0 |--Stream Aggregate(GROUP BY:([Orders].[CustomerId]) DEFINE:([Expr1005]=Count(*)))
371879 1 371868.03 |--Index Seek(OBJECT:([Orders].[IX_Orders_CustomerId]), SEEK:([Orders].[CustomerId] <= (1000)) ORDERED FORWARD)
Table 'Orders'. Scan count 1, logical reads 7601
5 1 5.0 |--Hash Match(Aggregate, HASH:([Orders].[Status]) ...)
1000000 1 1000000.0 |--Clustered Index Scan(OBJECT:([Orders].[PK_Orders]))IX_Orders_CustomerId satırları zaten CustomerId sırasında verdiği için stream aggregate her grubu sırayla topluyor: bellek istemiyor, bir grup bitince sonucu hemen veriyor. Status için sıralı bir girdi yok; hash aggregate beş grubu bellekteki bir hash tablosunda biriktiriyor. Grup sayısı az ve girdi büyükse hash aggregate iyi bir seçim; grup sayısı çok büyükse onun da bellek ihtiyacı ve spill riski büyür.
Ana Sinyal: Tahmini ve Gerçek Satır Sayısı
Açılıştaki şekle geri dönelim. Cost yüzdesi her operator'ün tahmini I/O (Input/Output) ve CPU (Central Processing Unit) maliyetinin toplam içindeki payı. Tahmin yanlışsa yüzde de yanlıştır; actual plan'da bile bu sayı yeniden hesaplanmaz. PK_OrderItems lookup'ı 578 çalıştırma tahminiyle %44,4 almış, gerçekte 244 kez çalışıp 732 read yapmış. PK_Orders lookup'ı 487 tahminle %37,2 almış, gerçekte 473 kez çalışıp 1.343 read yapmış. Sıralama tersine dönüyor.
Bu yüzden plan okurken sırayla şunlara bak: tahmini ve gerçek satır sayısı arasındaki büyük farklar (burada tarih filtresi için 231 tahmin, 104 gerçek), çok çalışan operator'ler (Executes), WHERE: içindeki residual predicate'ler ve operator bazında logical reads. Bu planın teşhisi açık: iki lookup. Siparişlerde tarih filtresini index'e taşıyan, kalemlerde de seçilen kolonları INCLUDE eden iki index:
CREATE INDEX IX_Orders_Customer_Created ON dbo.Orders (CustomerId, CreatedAt);
DROP INDEX IX_OrderItems_OrderId ON dbo.OrderItems;
CREATE INDEX IX_OrderItems_OrderId ON dbo.OrderItems (OrderId) INCLUDE (BookId, Quantity, UnitPrice);
Table 'OrderItems'. Scan count 104, logical reads 359 /* önce 1089 */
Table 'Orders'. Scan count 1, logical reads 330 /* önce 1460 */EF Core bütün kolonları seçtiği için Orders tarafındaki lookup tamamen kalkmadı, ama artık yalnızca filtreyi geçen 104 sipariş için yapılıyor; kalemlerdeki lookup ise tamamen kayboldu. Toplam okuma 2.549'dan 689'a indi. EF Core'da bunun alternatifi, gerçekten gereken kolonları Select ile projekte etmek; EF Core serisinin performans temelleri yazısında anlatılan projection burada doğrudan index tasarımını kolaylaştırıyor.
SQL Server 2019/2022'de farkı: plan operator'leri ve okuma şekli üç sürümde de aynı. sys.dm_exec_query_plan_stats ve LAST_QUERY_PLAN_STATS 2019 ile geldi. Rowstore tablolarda Adaptive Join görmek için batch mode on rowstore gerekiyor; bu 2019'da compatibility level 150 ve Enterprise edition ile başladı. 2022 ve sonrasında plan metninde görebileceğin PLAN PER VALUE ekleri PSP (Parameter Sensitive Plan) optimization'a ait.
Üretimde Dikkat
Actual plan almak sorguyu çalıştırmak demek. UPDATE ya da DELETE içeren bir sorgunun actual plan'ını production'da "bakmak için" almak veriyi değiştirir. Bu sorgular için estimated plan, Query Store ya da sys.dm_exec_query_plan_stats kullan, ya da işi bir transaction içinde yapıp rollback et.
Cost yüzdesine göre sıralama yapma. Plan karşılaştırırken operator bazında logical reads ve Executes değerlerini kullan; bunlar actual plan'da gerçek ölçümlerdir.
Planı kaydet. Bir sorgunun "dün hızlıydı" planını bugünküyle karşılaştırmak en hızlı teşhis yoludur; Query Store bunu senin için otomatik yapar.
Sık Düşülen Tuzaklar
Estimated plan'ı actual sanmak. Estimated plan'da "Actual Number of Rows" yoktur; orada gördüğün satır sayıları tahmindir. Bir sorgunun neden yavaş olduğunu anlamak için actual plan'a ya da en azından STATISTICS IO'ya ihtiyacın var.
"Scan kötü, seek iyi" diye ezberlemek. 100.000 kez çalışan bir seek, bir kez çalışan bir scan'den çok daha pahalıydı. Operator tipinden çok satır sayısına, çalışma sayısına ve okumaya bak.
Join hint'leriyle sorunu "çözmek". Hint ölçüm aracıdır. Kalıcı çözüm çoğu zaman doğru index, doğru statistics ya da sorgunun yeniden yazılmasıdır.
ORM'in (Object-Relational Mapping) ürettiği SQL'e bakmadan plan tartışmak. EF Core'un Include için LEFT JOIN ve ORDER BY ..., [o].[OrderId] eklediğini, parametreyi datetime2(7) gönderdiğini SQL'i görmeden bilemezsin. ToQueryString() ya da logging ile SQL'i al, planı o SQL'le çıkar.
Küçük Bir Deneme
★☆☆ Açılıştaki EF Core sorgusunu müşteri 2 (17.359 sipariş) için çalıştır ve planı al. Hangi operator'ler değişti? Lookup'lar hâlâ orada mı?
★★☆ Aynı sorguyu AsSplitQuery() ile çalıştır. EF Core kaç SQL gönderdi, her birinin planı nasıl? Toplam logical reads'i tek sorgulu hâliyle karşılaştır.
★★★ Join karşılaştırmasını WHERE o.OrderId BETWEEN 999901 AND 1000000 (100 sipariş) için tekrarla. Hangi join en ucuz oldu? Optimizer'ın hint'siz seçimi neydi ve neden?
Bu planlarda iki konuyu sonraya bıraktık: hash join ve sort'un istediği bellek (memory grant) ile Adaptive Join'in ait olduğu batch mode. Bir sonraki yazıda memory grant ve spill uyarılarını, paralel planları, exchange operator'lerini ve implicit conversion uyarısını okuyacağız.