

Lock'lar ve Blocking: Lock Mode'ları, Granularity, Lock Escalation ve Blocking Zincirini Bulmak

Tek satırlık bir UPDATE bile dört lock tutar ve SQL Server lock isteklerini sıraya koyar; bu yüzden zincirin kökünü sys.dm_exec_requests ve sys.dm_exec_sessions ile ararsın. Lock mode'ları ve compatibility matrisi, laboratuvarda 6.249 lock'ta ölçülen escalation, UPDLOCK/SERIALIZABLE ile güvenli upsert, READPAST ile queue table, LOCK_TIMEOUT ve migration'ın Sch-M ile bütün okuyucuları durdurması gerçek çıktılarla.
Sürüm notu: Bu yazıdaki SQL (Structured Query Language) örnekleri SQL Server 2025 (17.0.5035.5, Cumulative Update 10) üzerinde, compatibility level 170 ile çalıştırılmıştır; veritabanında RCSI (Read Committed Snapshot Isolation) ve optimized locking kapalıdır (SQL Server 2025'in yeni veritabanı varsayılanı).
Önce Tahmin Et: Tek Satırlık UPDATE Kaç Lock Tutar?
Bookstore'un sipariş tablosunda bir siparişin durumunu değiştiriyoruz ve transaction'ı henüz commit etmiyoruz. Aynı transaction'ın içinden kendi lock'larımıza bakıyoruz:
BEGIN TRANSACTION;
UPDATE dbo.Orders SET Status = 'Cancelled' WHERE OrderId = 999001;

SELECT resource_type, resource_description, request_mode, request_status
FROM sys.dm_tran_locks
WHERE request_session_id = @@SPID AND resource_database_id = DB_ID()
ORDER BY resource_type;
ROLLBACK;
Tek bir satır değişti. Sonuçta kaç satır göreceğini, hangi mode'larla ve hangi kaynaklarda göreceğini tahmin et. Bir de şunu düşün: bu transaction açıkken başka bir session aynı tablodan SELECT COUNT(*) yaparsa bekler mi?
resource_type|resource_description|request_mode|request_status
-------------|--------------------|------------|--------------
DATABASE|                    |S|GRANT
KEY|(94e983785ab1)          |X|GRANT
OBJECT|                    |IX|GRANT
PAGE|1:9915                |IX|GRANT
Dört lock. Satırın kendisinde bir X, satırın bulunduğu page'de ve tablonun tamamında birer IX, veritabanında bir S. Bu yazı bu dört satırın ne anlattığını, bir satırın neden bir anda tüm tabloyu kilitleyebildiğini ve production'da "her şey dondu" dendiğinde kimin kimi beklettiğini nasıl bulacağını anlatıyor. Örnekler serinin ortak Bookstore verisinde (1.000.000 sipariş, 2,5 milyon sipariş kalemi) çalışıyor.
Isolation level'ların hangi anomaliyi engellediğini serinin 10. yazısında (Isolation Level'lar ve Row Versioning) gördük. Burada aynı konunun mekanik tarafındayız: SQL Server bu garantileri lock'larla nasıl sağlıyor ve bunun bedelini kim ödüyor.
Lock Mode'ları ve Granularity
SQL Server kaynakları hiyerarşik olarak kilitler: veritabanı, object (tablo), page ve en altta satır. Satır, clustered index'li tabloda KEY (index key'i), heap'te RID (Row Identifier) olarak görünür. Çıktıdaki (94e983785ab1), OrderId = 999001 key'inin hash'i; 1:9915 ise dosya 1'deki 9915 numaralı page.
Mode'lar şunlar:
S(Shared): okuma. Birden fazla session aynı kaynakta aynı anda tutabilir.U(Update): "okuyorum ama birazdan değiştireceğim". Aynı anda yalnız bir session tutabilir; satır değişirkenX'e dönüşür.X(Exclusive): yazma. Hiçbir mode ile birlikte verilmez.IS,IX,SIX(Intent Shared, Intent Exclusive, Shared with Intent Exclusive): üst seviyedeki "niyet" işaretleri. SatırdaXtutan session tabloyaIXkoyar ki tabloyu bütünüyle kilitlemek isteyen biri milyonlarca satırı tek tek kontrol etmeden çakışmayı görsün.Sch-SveSch-M(Schema Stability, Schema Modification): sorgu derlenirken ve çalışırken şemanın değişmemesi içinSch-S; DDL (Data Definition Language) işlemi içinSch-M.
Hangi mode'un hangisiyle yan yana durabileceğini compatibility matrisi söyler. Blocking dediğimiz şey bu matrisin kırmızı hücrelerinden biridir:
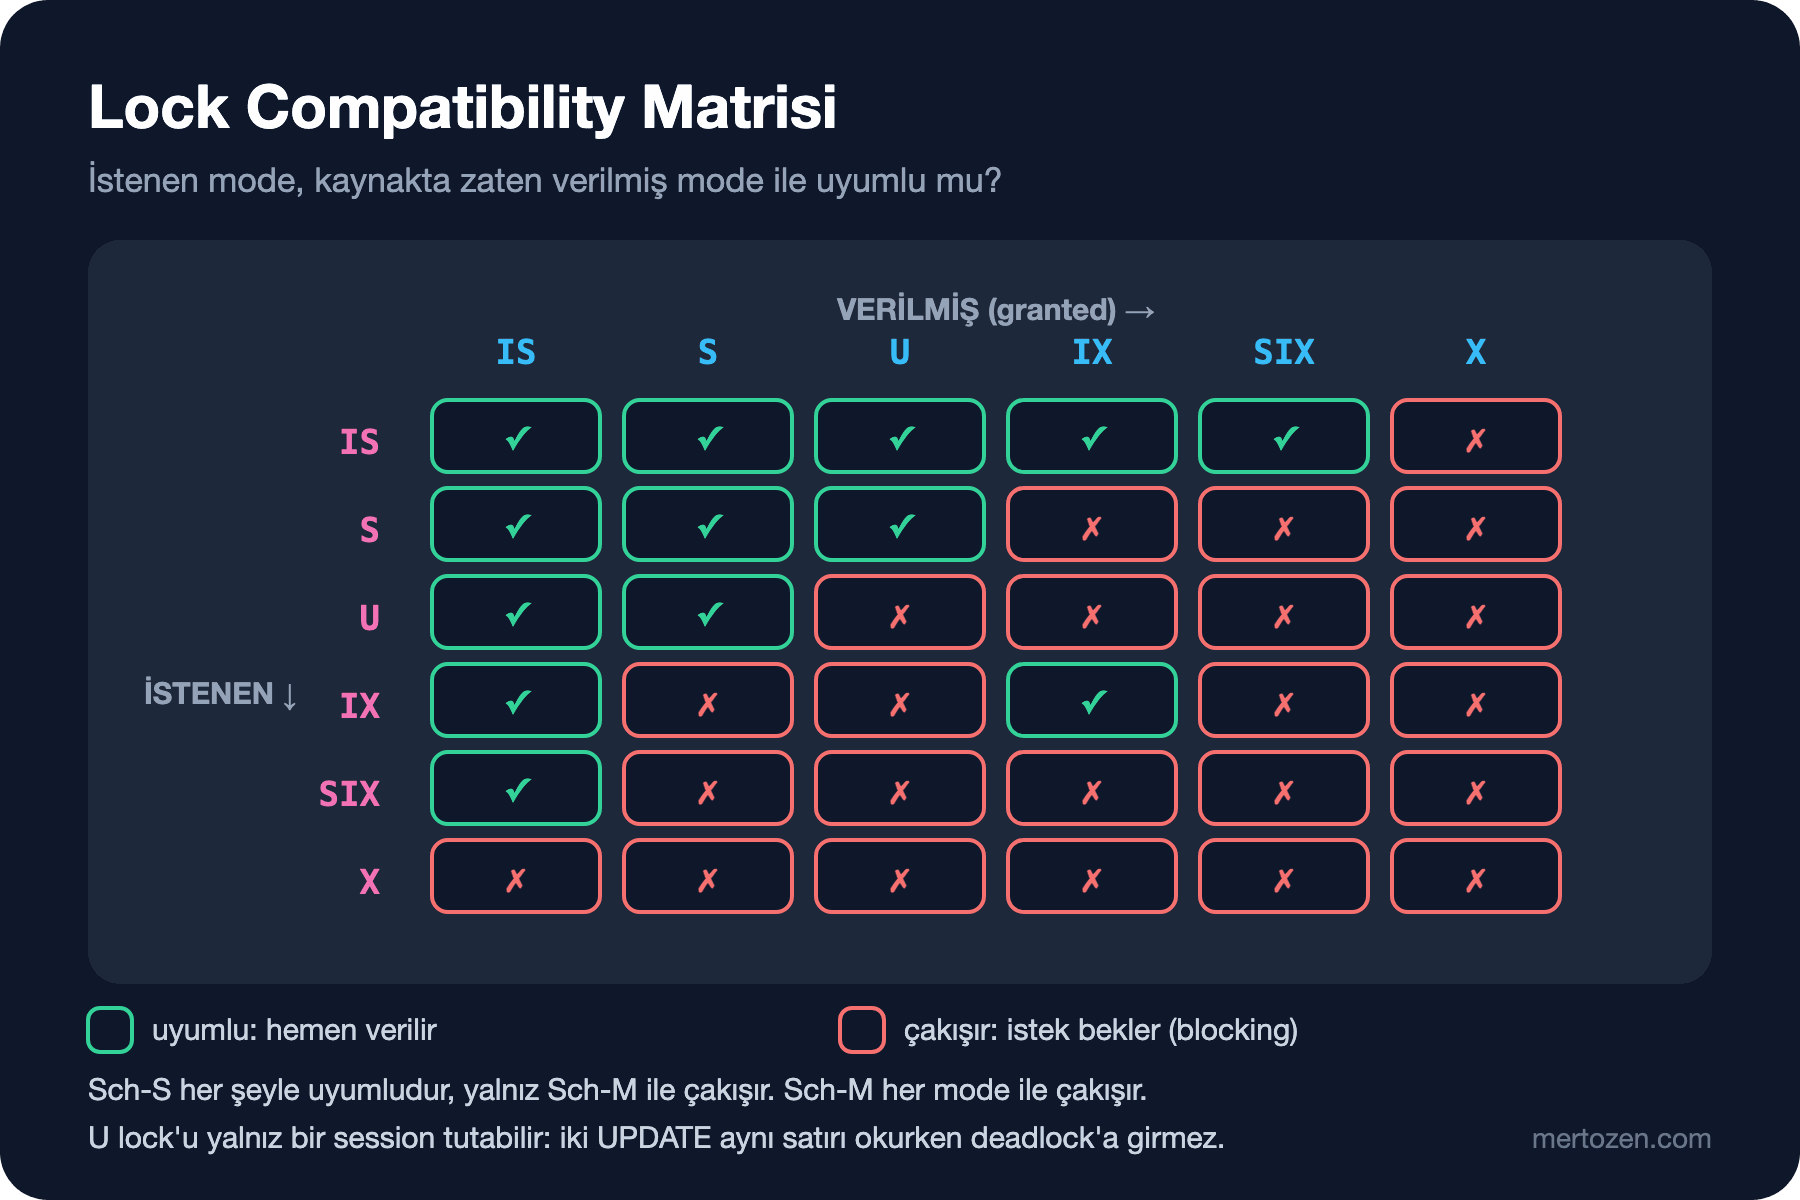
Açılıştaki soruya dönelim. IX, IS ile uyumlu olduğu için başka bir session tabloya IS koyup okumaya başlayabilir. Ama OrderId = 999001 satırına geldiğinde o satırda S ister ve X ile çakışır. Varsayılan READ COMMITTED'da (RCSI kapalıyken) okuyucu, yazıcının commit etmesini bekler. Bunu birazdan zincir hâlinde göreceğiz.
U'nun neden var olduğu da matristen okunur. İki session S alıp sonra ikisi de X'e yükseltmeye çalışsaydı, ikisi de diğerinin S'ini beklerdi: klasik conversion deadlock. U ile U uyumsuz olduğu için ikinci UPDATE daha okuma aşamasında sıraya girer.
Lock Escalation: 5.000 Kuralı Pratikte
Her satır için bir lock tutmak bellek ister. SQL Server bu yüzden belli bir eşikten sonra satır ve page lock'larını tek bir tablo lock'una çevirir. Dokümandaki kural: tek bir statement, tek bir tablo ya da index üzerinde en az 5.000 lock aldığında escalation denenir; çakışma yüzünden yapılamazsa her 1.250 yeni lock'ta tekrar denenir. Lock belleği, Database Engine belleğinin yüzde 24'üne ulaştığında da escalation tetiklenir.
Sayıyı ölçelim. Aynı sorguyu farklı aralıklarla çalıştırıp lock'ları grupluyoruz:
BEGIN TRANSACTION;
UPDATE dbo.Orders SET Status = 'Cancelled' WHERE OrderId BETWEEN 900001 AND 906300;

SELECT resource_type, request_mode, COUNT(*) AS locks
FROM sys.dm_tran_locks
WHERE request_session_id = @@SPID AND resource_database_id = DB_ID()
GROUP BY resource_type, request_mode;
ROLLBACK;
rows resource_type request_mode locks
5000 KEY X 5000
5000 PAGE IX 39
6200 KEY X 6200
6200 PAGE IX 48
6300 OBJECT X 1Tablo üç ayrı koşunun özeti (DATABASE ve OBJECT satırları çıkarıldı). 5.000 ve 6.200 satırda escalation yok: 6.200 tane key lock ve 48 page lock duruyor. 6.300 satırda hepsi kayboldu ve yerine tablonun tamamında tek bir X geldi. Artık bu transaction bitene kadar tablodaki bir milyon siparişin hiçbiri okunamaz, güncellenemez.
Escalation tam olarak nerede oldu? lock_escalation event'ini yakalayan kısa bir Extended Events session'ı bunu söylüyor:
CREATE EVENT SESSION sqls_11_escalation ON SERVER
ADD EVENT sqlserver.lock_escalation
    (WHERE sqlserver.database_name = N'sqls_11')
ADD TARGET package0.ring_buffer
WITH (MAX_DURATION = 10 MINUTES);
event_name|escalation_cause|escalated_lock_count|hobt_lock_count|mode
----------|----------------|--------------------|---------------|----
lock_escalation|Lock threshold|6249|6248|X6.249 lock. Kontrol her 1.250 lock'ta yapılıyor ve 5.000'inci lock alındığında bu tablonun (HoBT: Heap or B-Tree) kendi lock sayısı, veritabanı ve object lock'ları da sayıldığı için henüz 5.000'in altındaydı. Bir sonraki kontrolde, 6.250 civarında, eşik aşıldı. Pratik sonuç: "5.000 satır" bir sınır değil, bir başlangıç noktası. Senin tablonda gerçek sayıyı bu event söyler.
Escalation'ı tablo bazında yönetebilirsin: ALTER TABLE dbo.Orders SET (LOCK_ESCALATION = DISABLE). Ama bu, sorunu lock belleğine taşır. Daha iyi çözüm büyük işi küçük parçalara bölmek: 50.000 siparişi tek UPDATE ile değil, 4.000'lik batch'lerle, her batch ayrı transaction'da güncellemek. Optimized locking'in bu tabloyu nasıl değiştirdiğini 13. yazıda göreceğiz.
Blocking Zincirini Bulmak
Gerçek hayattaki hikâye hep aynı başlar: "Sipariş ekranı dondu." Bunu laboratuvarda üç session ile kuruyoruz. A siparişi güncelliyor ve commit etmeden bekliyor (uygulama tarafında bu genellikle transaction açıkken yapılan bir HTTP (Hypertext Transfer Protocol) çağrısıdır). B aynı siparişi güncellemek istiyor. C ise yalnız okuyor:
/* Session A */
BEGIN TRANSACTION;
UPDATE dbo.Orders SET Status = 'Cancelled' WHERE OrderId = 999001;
WAITFOR DELAY '00:00:08';
ROLLBACK;

/* Session B */
UPDATE dbo.Orders SET Status = 'PaymentPending' WHERE OrderId = 999001;

/* Session C */
SELECT COUNT(*) AS pending
FROM dbo.Orders
WHERE OrderId BETWEEN 999000 AND 999010 AND Status = 'Pending';
Dördüncü bir session'dan sys.dm_exec_requests'e bakıyoruz:
SELECT r.session_id, r.blocking_session_id, r.wait_type, r.wait_resource, r.command,
       LEFT(t.text, 60) AS sql_text
FROM sys.dm_exec_requests AS r
CROSS APPLY sys.dm_exec_sql_text(r.sql_handle) AS t
WHERE r.database_id = DB_ID() AND r.session_id <> @@SPID
ORDER BY r.session_id;
session_id|blocking_session_id|wait_type|wait_resource|command
----------|-------------------|---------|-------------|-------
54|0|WAITFOR||WAITFOR
59|54|LCK_M_X|KEY: 38:72057594047430656 (94e983785ab1)|UPDATE
60|59|LCK_M_S|KEY: 38:72057594047430656 (94e983785ab1)|SELECTÜç önemli ayrıntı var. Birincisi, wait type lock mode'unu söylüyor: LCK_M_X X lock bekliyor, LCK_M_S S lock bekliyor. İkincisi, wait_resource açılıştaki key'in ta kendisi; 72057594047430656 bir hobt_id ve sys.partitions'ta Orders tablosunun clustered index'ine karşılık geliyor. Üçüncüsü ve en az bilineni: C'yi bekleten A değil, B. SQL Server lock isteklerini sıraya koyar; C'nin S isteği, kendisinden önce gelip bekleyen B'nin X isteğinin arkasına geçer. Yani zincirde yalnız "ilk" halkayı değil, kökü aramalısın.
Kök, yani head blocker, kendisi kimseyi beklemeyen ama başkasını bekleten session'dır:
WITH blocked AS
(
    SELECT session_id, blocking_session_id
    FROM sys.dm_exec_requests
    WHERE blocking_session_id <> 0
)
SELECT DISTINCT b.blocking_session_id AS head_blocker,
       s.status, s.open_transaction_count, s.program_name
FROM blocked AS b
JOIN sys.dm_exec_sessions AS s ON s.session_id = b.blocking_session_id
WHERE b.blocking_session_id NOT IN (SELECT session_id FROM blocked);
head_blocker|status|open_transaction_count|program_name
------------|------|----------------------|------------
54|running|1|SQLCMDBurada A WAITFOR çalıştırdığı için running görünüyor. Production'da en sık gördüğün tablo farklıdır: head blocker sleeping durumundadır, open_transaction_count 1'dir ve sys.dm_exec_requests'te hiç satırı yoktur. Yani session hiçbir şey çalıştırmıyor ama transaction'ı açık. Bu genellikle uygulama kodunda transaction açıldıktan sonra beklenen bir dış çağrı ya da yakalanıp yutulan bir exception yüzünden kapatılmamış bir transaction demektir. Bu yüzden head blocker sorgusunda sys.dm_exec_requests değil sys.dm_exec_sessions kullanıyoruz. program_name'in işe yaraması için connection string'e Application Name=Bookstore.Api eklemeyi alışkanlık hâline getir.
Blocked Process Report ve Extended Events
DMV'ler (Dynamic Management View) yalnız şu anı gösterir. Gece 03:00'te on saniye süren bir blocking'i sabah görmek için kalıcı bir kayıt gerekir. SQL Server'ın bunun için hazır bir event'i var: blocked_process_report. Ama bu event, server seviyesindeki blocked process threshold ayarı sıfırdan büyük değilse hiç üretilmez:
SELECT name, value_in_use FROM sys.configurations WHERE name = 'blocked process threshold (s)';name|value_in_use
----|------------
blocked process threshold (s)|0Varsayılan 0, yani kapalı. Bu laboratuvar ortak bir sunucuda çalıştığı için server ayarını değiştirmedik; kendi sunucunda sp_configure 'blocked process threshold (s)', 10 ile açarsın (örneğin 10 saniye; çok düşük değer gereksiz yük üretir). Event'i toplayan session şöyle:
CREATE EVENT SESSION sqls_11_blocking ON SERVER
ADD EVENT sqlserver.blocked_process_report
    (WHERE sqlserver.database_name = N'sqls_11')
ADD TARGET package0.event_file (SET filename = N'sqls_11_blocking.xel', max_file_size = 50)
WITH (MAX_DURATION = 2 HOURS);
Rapor her eşik süresinde bir XML (Extensible Markup Language) belgesi üretir: bekleyen ve bekleten process'lerin input buffer'ı, waitresource'u, isolation level'ı ve transaction adı. Aynı blocking sürdükçe rapor tekrar gelir; bu yüzden XML'leri blocking-process ve blocked-process çiftine göre gruplayarak okumak gerekir. MAX_DURATION SQL Server 2025 ile gelen time-bound session özelliği: unutulan bir teşhis session'ı iki saat sonra kendini durdurur. Teşhis metodolojisini 18. yazıda bütün olarak ele alacağız.
Lock Hint'leri: Güvenli Upsert, Queue Table ve LOCK_TIMEOUT
Hint'ler optimizer'ın değil lock manager'ın davranışını değiştirir ve doğru yerde kullanıldığında gerçek sorunları çözer. Üç tipik kullanım var.
UPDLOCK + SERIALIZABLE ile upsert
Günlük kitap satış sayacı tutuyoruz. Herkesin yazdığı ilk versiyon şu (yarış koşulunu görünür kılmak için araya üç saniyelik bir bekleme koyduk):
CREATE TABLE dbo.DailyBookSales
(
    SalesDate date NOT NULL,
    BookId    int  NOT NULL,
    Quantity  int  NOT NULL,
    CONSTRAINT PK_DailyBookSales PRIMARY KEY (SalesDate, BookId)
);

DECLARE @d date = '2026-11-08', @b int = 42, @q int = 1;
BEGIN TRANSACTION;
IF NOT EXISTS (SELECT 1 FROM dbo.DailyBookSales WHERE SalesDate = @d AND BookId = @b)
BEGIN
    WAITFOR DELAY '00:00:03';
    INSERT dbo.DailyBookSales (SalesDate, BookId, Quantity) VALUES (@d, @b, @q);
END
ELSE
    UPDATE dbo.DailyBookSales SET Quantity += @q WHERE SalesDate = @d AND BookId = @b;
COMMIT;
İki session aynı anda çalıştırınca ikisi de "satır yok" görüyor ve ikisi de INSERT'e gidiyor:
Msg 2627, Level 14, State 1, Server b8be943222fa, Line 7
Violation of PRIMARY KEY constraint 'PK_DailyBookSales'. Cannot insert duplicate key in object 'dbo.DailyBookSales'. The duplicate key value is (2026-11-08, 42).
Transaction bunu engellemedi, çünkü READ COMMITTED'da EXISTS'in aldığı S lock okuma biter bitmez bırakılıyor ve olmayan bir satırı kilitlemek zaten mümkün değil. Doğrusu, kontrolü UPDATE'in kendisine yaptırmak ve "olmayan satırı" bir range lock ile korumak:
BEGIN TRANSACTION;
UPDATE dbo.DailyBookSales WITH (UPDLOCK, SERIALIZABLE)
SET Quantity += @q
WHERE SalesDate = @d AND BookId = @b;

IF @@ROWCOUNT = 0
    INSERT dbo.DailyBookSales (SalesDate, BookId, Quantity) VALUES (@d, @b, @q);
COMMIT;
Tabloda BookId 7 ve 99 varken BookId 42 için UPDATE hiçbir satır bulmuyor ama şu lock'u alıyor:
resource_type|resource_description|request_mode
-------------|--------------------|------------
KEY|(c3384d858808)|RangeX-X(c3384d858808), BookId 99 satırının key'i. RangeX-X, 7 ile 99 arasındaki boşluğu kilitliyor; ikinci session aynı aralığa yazamadığı için UPDATE'te bekliyor, birincisi commit edince satırı bulup güncelliyor. Sonuç tek satır ve Quantity = 2. Hata yok, kayıp yok. SERIALIZABLE yerine HOLDLOCK yazmak aynı şeydir. MERGE da aynı hint'lere ihtiyaç duyar; tek statement olması onu yarışa karşı korumaz.
READPAST ile queue table
Sipariş onay e-postalarını bir outbox tablosundan işleyen birden fazla worker var. Her worker bir sonraki New satırı alıp Sending yapıyor:
BEGIN TRANSACTION;
WITH next_email AS
(
    SELECT TOP (1) EmailOutboxId, OrderId, Status
    FROM dbo.EmailOutbox WITH (ROWLOCK, UPDLOCK, READPAST)
    WHERE Status = 'New'
    ORDER BY EmailOutboxId
)
UPDATE next_email
SET Status = 'Sending'
OUTPUT inserted.EmailOutboxId, inserted.OrderId;
/* e-posta gönderimi burada */
COMMIT;
İki worker aynı anda çalışınca biri 1'i, diğeri 2'yi alıyor ve hiçbiri beklemiyor. READPAST, kilitli satırı beklemek yerine atlar. Hint'ten READPAST'i çıkardığımızda ikinci worker'ın durumu:
session_id|blocking_session_id|wait_type
----------|-------------------|---------
54|0|WAITFOR
59|54|LCK_M_U
İkinci worker, birincinin işi bitene kadar sırada bekliyor; worker sayısını artırmak hiçbir şey kazandırmıyor. READPAST yalnız satır ve page lock'larını atlar; tablo escalate olmuşsa yine bekler. Bu yüzden ROWLOCK ile birlikte ve Status, EmailOutboxId üzerinde bir index ile kullanılır. Outbox pattern'inin kendisini Messaging ve Event-Driven Architecture serisinde anlattık; burada konu yalnız onun veritabanı tarafındaki lock davranışı.
LOCK_TIMEOUT
Varsayılan LOCK_TIMEOUT -1'dir: sonsuza kadar bekle. Uygulamadaki command timeout (SqlClient'ta varsayılan 30 saniye) dolunca istemci isteği iptal eder ama o ana kadar zincir büyümüştür. Bazı işlerde beklemek yerine hemen hata almak daha iyidir:
SET LOCK_TIMEOUT 3000;
ALTER TABLE dbo.Books ADD Subtitle2 nvarchar(200) NULL;
Msg 1222, Level 16, State 56, Server b8be943222fa, Line 2
Lock request time out period exceeded.Hata 1222 yalnız statement'ı sonlandırır, transaction'ı geri almaz. SET XACT_ABORT ON yoksa transaction açık kalır; bunu ele almak çağıranın işidir (9. yazıdaki TRY/CATCH kalıbı).
Sch-M: Migration'ın Herkesi Durdurması
Yukarıdaki ALTER TABLE'ı neden timeout ile çalıştırdığımızı şimdi görelim. Senaryo: A, bir kitabın fiyatına dokunan kısa bir transaction açmış ve henüz commit etmemiş. Deploy pipeline'ı Entity Framework Core (EF Core) migration'ını çalıştırıyor ve Books'a bir kolon ekliyor. Bu sırada katalog sayfası tek bir kitabı okuyor:
/* Session A */
BEGIN TRANSACTION;
UPDATE dbo.Books SET Price = Price WHERE BookId = 1;
WAITFOR DELAY '00:00:08';
COMMIT;

/* Session B: migration */
ALTER TABLE dbo.Books ADD Subtitle nvarchar(200) NULL;

/* Session C: katalog sayfası */
SELECT Title, Price FROM dbo.Books WHERE BookId = 2;
session_id|blocking_session_id|wait_type|wait_resource|sql_text
----------|-------------------|---------|-------------|--------
54|0|WAITFOR||BEGIN TRANSACTION; UPDATE dbo.Books SET Price = Pr
59|54|LCK_M_SCH_M|OBJECT: 38:1253579504:0|ALTER TABLE dbo.Books ADD Subtitle nvarchar(200) N
60|59|LCK_M_SCH_S|OBJECT: 38:1253579504:0|SELECT Title, Price FROM dbo.Books WHERE BookId =C, A'nın dokunmadığı başka bir kitabı okuyor; A ile hiçbir çakışması yok. Ama Sch-M bekleyen B sırada C'nin önünde ve Sch-S, Sch-M ile uyumsuz. Yeni kolon nullable ve metadata-only bir değişiklik; kendisi milisaniyeler sürer. Ama lock'u alabilmek için bekledikçe arkasına tablonun tüm okuyucularını dizer. Production'da bu, "deploy sırasında site 40 saniye cevap vermedi" olarak görünür.
Çözüm üç parçalı. Migration'ları kısa bir LOCK_TIMEOUT ile çalıştır ve hata alınca yeniden dene; uzun açık transaction'ları önce bul (bir önceki bölümdeki head blocker sorgusu). Index işlemlerinde ONLINE = ON ile birlikte WAIT_AT_LOW_PRIORITY kullan; bekleyen işlem diğerlerinin önüne geçmez:
CREATE INDEX IX_Orders_Status ON dbo.Orders (Status)
WITH (ONLINE = ON (WAIT_AT_LOW_PRIORITY (MAX_DURATION = 1 MINUTES, ABORT_AFTER_WAIT = SELF)));
Online index işlemleri Enterprise (ve Developer) edition özelliğidir; ONLINE = ON bile başta ve sonda kısa bir Sch-M ister. WAIT_AT_LOW_PRIORITY bu iki anı yönetir. EF Core migration'larının nasıl script'e çevrildiğini EF Core serisinin migration yazısında görmüştük; production'da o script'i bu kurallarla çalıştırmak senin işin.
SQL Server 2019/2022'de Farkı
Bu yazıdaki lock modeli SQL Server 2019 ve 2022'de birebir aynı: aynı mode'lar, aynı escalation kuralı, aynı DMV'ler. Farklar kenarlarda. CREATE INDEX için WAIT_AT_LOW_PRIORITY SQL Server 2022 ile geldi (ALTER INDEX ... REBUILD için 2014'ten beri var); 2019'da yeni index'i bu seçenekle oluşturamazsın. MAX_DURATION'lı time-bound Extended Events session'ları 2025'e özgü; 2019/2022'de session'ı kendin durdurmalısın. En büyük fark ise SQL Server 2025'teki optimized locking: açıldığında açılıştaki dört lock'un çoğu transaction boyunca tutulmaz. 2025'te varsayılan kapalı, 2019/2022'de hiç yok; 13. yazının konusu.
Üretimde Dikkat
Blocking'i ölçmenin en ucuz yolu wait istatistiği. LCK_M_% wait'lerinin toplam bekleme süresi yükseliyorsa bir blocking sorunun var; hangi lock mode'unun beklendiği (LCK_M_U, LCK_M_X, LCK_M_SCH_M) sorunun türünü söyler. Ama süre tek başına yetmez: kimin beklettiğini blocked_process_report ya da düzenli aralıkla alınan sys.dm_exec_requests görüntüleri gösterir.
Transaction'ı kısa tut. Lock'lar transaction sonuna kadar tutulur, statement sonuna kadar değil. Bir transaction'ın içinde ödeme sağlayıcısına HTTP çağrısı yapmak, o çağrı ne kadar sürerse siparişin satırını o kadar kilitli tutmak demektir. Ödeme sonucunu bekleyip sonra kısa bir transaction açmak doğru sıradır.
Escalation'ı izle. lock_escalation event'i ya da sys.dm_db_index_operational_stats'taki index_lock_promotion_count sütunu, hangi tabloda escalation yaşandığını gösterir. Rapor sorguları ve toplu güncellemeler tipik şüphelilerdir.
Okuyucuları yazıcılardan ayır. Açılıştaki örnekte okuyucunun beklemesinin nedeni RCSI'ın kapalı olması. RCSI açıkken okuyucu lock almaz, satırın son commit edilmiş versiyonunu okur. Bu, blocking şikâyetlerinin büyük kısmını tek ayarla çözer; maliyetini 10. yazıda gördük.
Sık Düşülen Tuzaklar
NOLOCK ile blocking'i "çözmek". WITH (NOLOCK) okuyucuyu bekletmez ama commit edilmemiş, sonradan geri alınacak veriyi okutur ve scan sırasında page split olursa aynı satırı iki kez ya da hiç göstermeyebilir. Okuma tutarlılığı gerekmeyen bir yer bulmak sandığından zordur; çözüm RCSI'dır.
"SELECT kilitlemez" sanmak. READ COMMITTED'da (RCSI kapalı) SELECT, okuduğu satırda kısa süreli S lock alır ve X tutulan satırda bekler. REPEATABLE READ ve SERIALIZABLE'da bu lock'lar transaction sonuna kadar tutulur ve okuyucu, yazıcıyı bekletir.
Hint'i yanlış yere koymak. UPDLOCK'u SERIALIZABLE olmadan kullanmak upsert'te yarışı çözmez, çünkü olmayan satırı korumaz. READPAST'i index'siz bir tabloda kullanmak da scan'in kilitli page'lere takılmasına, hatta escalation'a yol açar.
Uygulama tarafında transaction'ı açık unutmak. using bloğu olmadan açılmış bir SqlTransaction ya da exception'da Rollback çağrılmayan bir kod yolu, head blocker'ın en sık kaynağıdır. Connection pool'a dönen connection bir sonraki kullanımda sıfırlanır ama o ana kadar lock'lar durur. Dapper serisinin transaction yazısındaki using kalıbı bu yüzden önemli.
Küçük Bir Deneme
★☆☆ Açılıştaki UPDATE'i OrderId BETWEEN 999001 AND 999100 ile çalıştır. Kaç KEY ve kaç PAGE lock görüyorsun? Page sayısını tablonun page başına satır sayısıyla (sys.dm_db_index_physical_stats) açıkla.
★★☆ Escalation deneyini Status üzerinde bir nonclustered index varken tekrarla. UPDATE artık iki index'e yazıyor; hobt_lock_count değişiyor mu, escalation daha az satırda mı oluyor?
★★★ Blocking zinciri demosunu ALTER DATABASE sqls_11 SET READ_COMMITTED_SNAPSHOT ON sonrası tekrar çalıştır. C hâlâ bekliyor mu? B ne bekliyor? Sonra C'ye WITH (READCOMMITTEDLOCK) ekle ve farkı açıkla.
Lock'ların sırayla beklediğini ve zincirin kökünü nasıl bulacağımızı gördük. İki session birbirini beklediğinde ise zincir bir döngüye dönüşür ve SQL Server birini kurban seçer. Bir sonraki yazıda deadlock graph'ı okuyor, yaygın deadlock pattern'lerini kuruyor ve .NET tarafında 1205 hatasını güvenle yeniden denemeyi konuşuyoruz.