

Page'ler, Heap ve Clustered Index: SQL Server Veriyi Diskte Nasıl Tutar?

SQL Server veriyi 8 KB'lık page'lerde tutar; clustered index tablonun kendisi olan sığ bir B-tree'dir, heap ise sırasız page'ler ve güncellemede forwarded record demektir. Gerçek page'ler, ROW_OVERFLOW/LOB, clustering key seçimi, Guid.CreateVersion7 değerlerinin SQL Server sıralamasında NEWID kadar rastgele olduğunu gösteren deney ve fill factor ile page density ölçümleri.
Sürüm notu: Bu yazıdaki T-SQL (Transact-SQL, Microsoft'un SQL (Structured Query Language) lehçesi) örnekleri SQL Server 2025 CU10 (17.0.5035.5, compatibility level 170) üzerinde, C# örnekleri .NET 10, Microsoft.Data.SqlClient 7.1.1, Dapper 2.1.89 ve Entity Framework Core (EF Core) 10.0.14 ile denenmiştir.
Önce Tahmin Et
Sipariş notlarını tutmak için aceleyle açılmış, clustered index'i olmayan bir tablo düşün. İçinde 20.000 satır var ve tablo diskte 129 page (sayfa) kaplıyor. Her satırı bir kez okuyan basit bir sayım sorgusu çalıştırıyoruz:
SET STATISTICS IO ON;
SELECT COUNT(*) AS NotesWithText FROM dbo.OrderNotes WHERE LEN(Note) > 2;
129 page'lik bir tabloyu baştan sona taramak kaç logical read tutar? 129 demek mantıklı görünüyor. Gerçek çıktı:
NotesWithText
-------------
2000
Table 'OrderNotes'. Scan count 1, logical reads 2082, physical reads 0
2.082, yani page sayısının 16 katı. Tabloyu ALTER TABLE ... REBUILD ile yeniden kurunca aynı sorgu 129 logical read'e iniyor; satır sayısı ve sonuç değişmiyor. Bu farkın sebebini anlamak için SQL Server'ın veriyi diskte nasıl tuttuğuna bakmamız gerekiyor: 8 KB'lık page, satırın yapısı, heap, clustered index'in B-tree'si ve key seçiminin bütün bunlara etkisi. Yazının sonunda .NET 9 ile gelen Guid.CreateVersion7() değerlerinin SQL Server'da neden "sıralı" olmadığını da deneyle göreceğiz.
8 KB'lık Page ve Extent
SQL Server data file'ı 8 KB'lık page'lere bölünmüştür ve bütün okuma yazma page birimiyle yapılır. Her page 96 byte'lık bir header ile başlar; sonunda satırların page içindeki yerini tutan slot array (row offset array) durur. Bir satırın in-row kısmı en fazla 8.060 byte olabilir. Sekiz ardışık page bir extent'i (64 KB) oluşturur ve alan tahsisi extent'lerle yapılır. SQL Server 2016'dan beri kullanıcı veritabanlarında yeni tablolar varsayılan olarak doğrudan uniform extent alır, yani bir extent'i tek bir nesne kullanır.
Bir satırın hangi page'de durduğunu belgelenmemiş ama yaygın kullanılan %%physloc%% ile, page'in kendisini de SQL Server 2019 ile gelen sys.dm_db_page_info ile görebiliriz:
SELECT TOP (3) OrderId, sys.fn_PhysLocFormatter(%%physloc%%) AS FilePageSlot
FROM dbo.Orders WHERE OrderId IN (1, 132, 133) ORDER BY OrderId;

SELECT page_type_desc, page_level, slot_count, free_bytes,
       prev_page_page_id, next_page_page_id, OBJECT_NAME(object_id) AS obj, index_id
FROM sys.dm_db_page_info(DB_ID(), 1, 2288, 'DETAILED');
OrderId FilePageSlot
------- ------------
1 (1:2288:0)
132 (1:2288:131)
133 (1:2290:0)
page_type_desc page_level slot_count free_bytes prev_page_page_id next_page_page_id obj index_id
-------------- ---------- ---------- ---------- ----------------- ----------------- ------ --------
DATA_PAGE 0 132 44 0 2290 Orders 11 numaralı dosyanın 2288 numaralı page'i Orders'ın ilk data page'i: 132 satır (slot 0'dan 131'e), geriye yalnızca 44 byte boş yer kalmış. prev_page_page_id = 0 bunun zincirin ilk page'i olduğunu, next_page_page_id = 2290 ise sonraki page'i gösteriyor. Clustered index'in leaf page'leri birbirine bu şekilde çift yönlü bağlıdır.
Satırın Yapısı: IN_ROW, ROW_OVERFLOW ve LOB
Satır 8.060 byte'a sığmazsa ne olur? SQL Server değişken uzunluklu kolonları satırın dışına taşır. Bunu görmek için üç farklı satır yazalım:
CREATE TABLE dbo.BookReviews (
    ReviewId int IDENTITY PRIMARY KEY,
    BookId   int NOT NULL,
    Summary  varchar(5000) NOT NULL,
    Body     varchar(5000) NOT NULL,
    FullText nvarchar(max) NULL);

INSERT dbo.BookReviews (BookId, Summary, Body, FullText) VALUES
 (1, REPLICATE('s', 100), REPLICATE('b', 100), NULL),
 (2, REPLICATE('s', 5000), REPLICATE('b', 5000), NULL),
 (3, 'short', 'short', REPLICATE(CAST(N'r' AS nvarchar(max)), 20000));

SELECT au.type_desc, au.total_pages, au.used_pages
FROM sys.allocation_units AS au
JOIN sys.partitions AS p ON au.container_id = p.partition_id
WHERE p.object_id = OBJECT_ID('dbo.BookReviews');
type_desc total_pages used_pages
----------------- ----------- ----------
IN_ROW_DATA 9 2
LOB_DATA 9 6
ROW_OVERFLOW_DATA 9 2Tablo tek ama üç allocation unit'i var. İkinci satır 10.000 byte'ı aştığı için kolonlarından biri ROW_OVERFLOW_DATA'ya taşındı ve satırda yerine 24 byte'lık bir pointer kaldı. Üçüncü satırdaki 40.000 byte'lık nvarchar(max) değeri LOB_DATA page'lerine gitti. Pratik sonucu şu: SELECT * ile çekilen her overflow ya da LOB (Large Object) kolon, satır başına fazladan page okuması demek ve bunlar STATISTICS IO'da ayrı olarak lob logical reads diye görünür. Geniş kolonları ihtiyaç olmadıkça seçmemek bu yüzden ORM (Object-Relational Mapping) tarafında da önemli.
Clustered Index: Tablonun Kendisi Olan B-tree
Clustered index ayrı bir yapı değildir; tablonun kendisidir. Satırlar clustering key'e göre sıralı olarak B-tree'nin (dokümanlar "B-tree" der, uygulamada B+ tree'dir) leaf seviyesinde durur. Orders'ın primary key'i PK_Orders için seviyelere bakalım:
SELECT index_level, page_count, record_count,
       CAST(avg_page_space_used_in_percent AS decimal(5,2)) AS avg_space_pct,
       min_record_size_in_bytes AS min_rec, max_record_size_in_bytes AS max_rec
FROM sys.dm_db_index_physical_stats(DB_ID(), OBJECT_ID('dbo.Orders'), 1, NULL, 'DETAILED')
ORDER BY index_level DESC;
index_level page_count record_count avg_space_pct min_rec max_rec
----------- ---------- ------------ ------------- ------- -------
2 1 27 4.31 11 11
1 27 7573 45.02 11 11
0 7573 1000000 99.43 57 64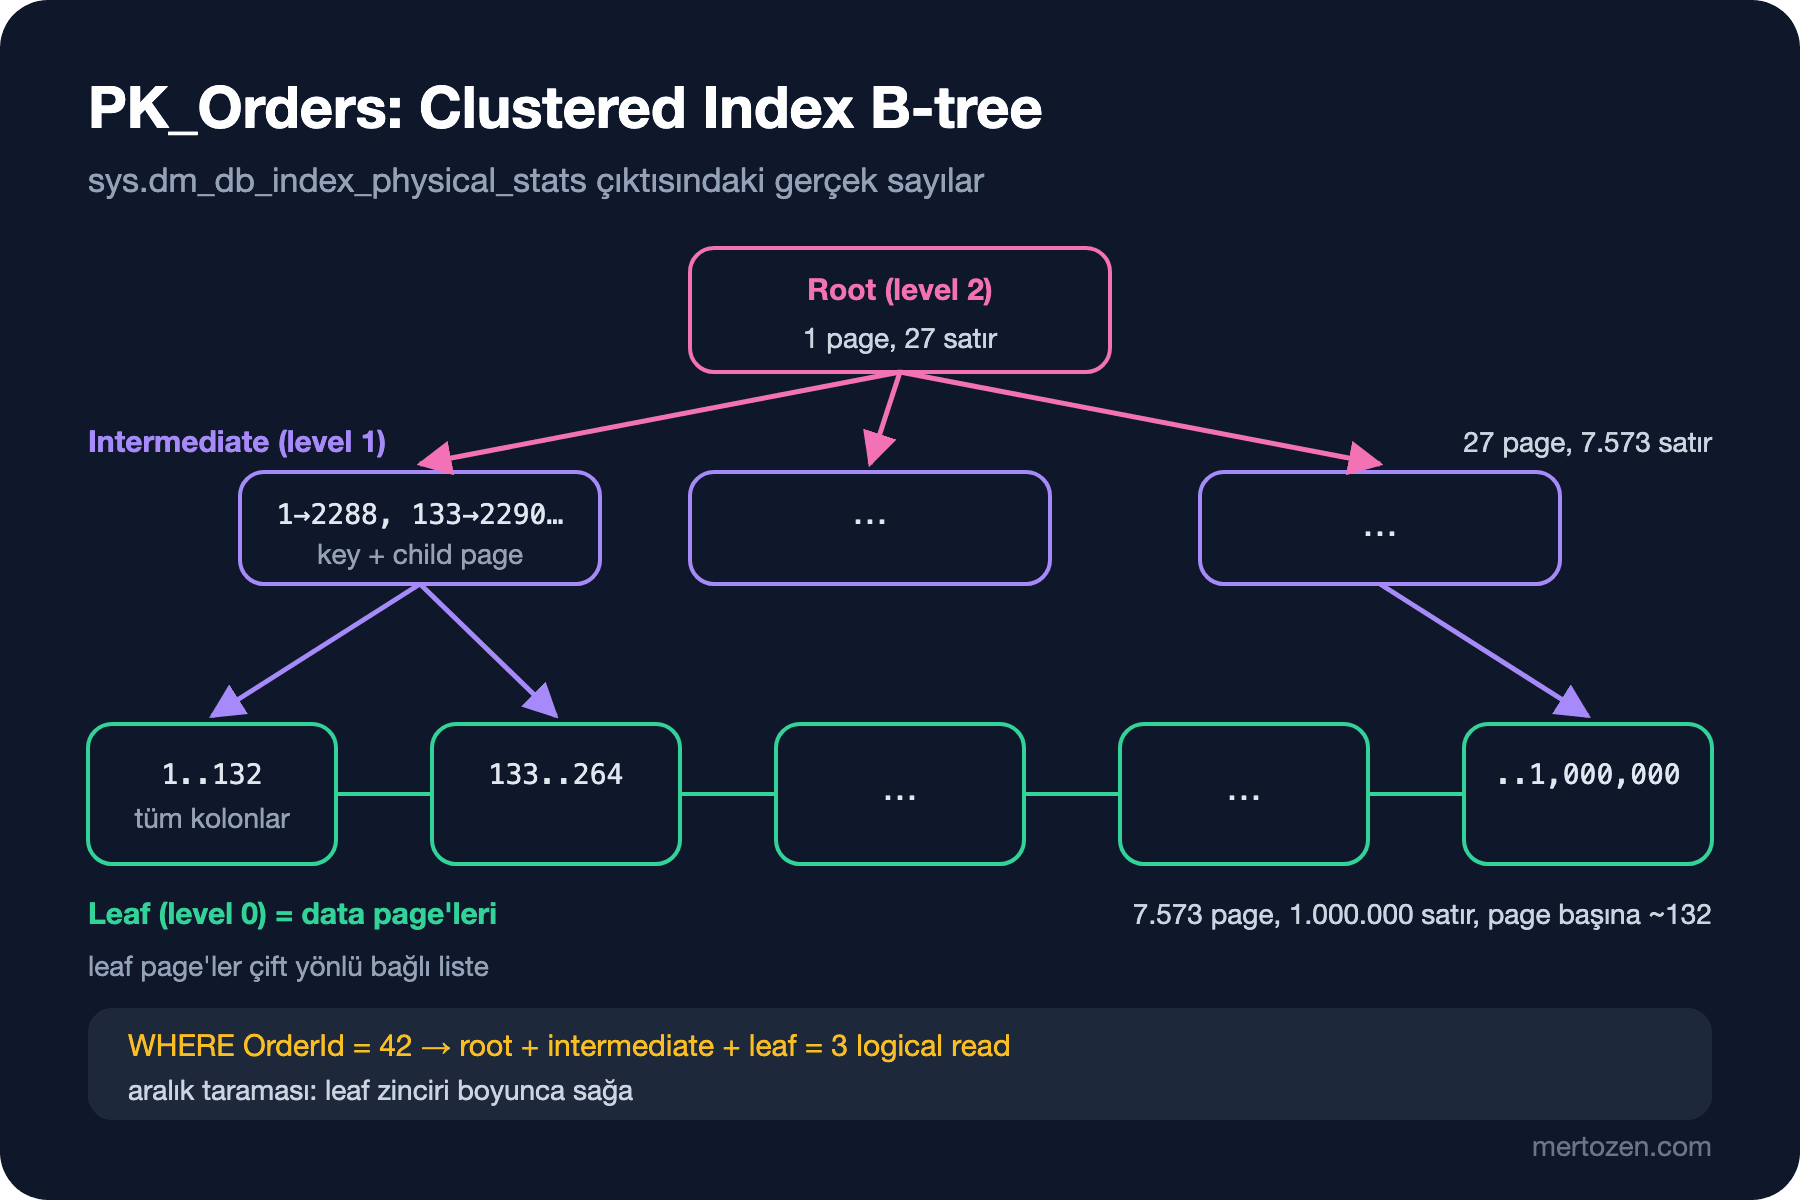
Bir milyon satır için yalnızca üç seviye var. Leaf seviyesinde 7.573 data page, her biri tam satırları (57–64 byte) taşıyor ve ortalama %99,43 dolu. Üstteki seviyelerde her kayıt yalnızca 11 byte: 4 byte'lık OrderId key'i, 6 byte'lık child page adresi ve bir byte satır header'ı. Bu kadar dar kayıtlar sayesinde tek bir intermediate page yüzlerce leaf page'i adresleyebiliyor ve ağaç çok sığ kalıyor. Primary key ile tek satır aramanın maliyeti bu yüzden seviye sayısı kadar:
SET STATISTICS IO ON;
SELECT OrderNumber, Status FROM dbo.Orders WHERE OrderId = 42;
SELECT COUNT(*) FROM dbo.Orders WHERE OrderId BETWEEN 1 AND 131;
Table 'Orders'. Scan count 0, logical reads 3, ...
Table 'Orders'. Scan count 1, logical reads 3, ...İlk sorgu root, intermediate ve leaf olmak üzere üç page okudu. İkincisi 131 satırı yine üç page ile buldu, çünkü hepsi aynı leaf page'de. Aralık sorguları leaf zincirinde sağa doğru yürür; satırlar key sırasında olduğu için ardışık page'leri okur.
Heap ve Forwarded Record
Clustered index'i olmayan tablo heap'tir: satırlar belirli bir sırada değil, boş yer bulunan page'e yazılır ve satıra fiziksel adresiyle (RID, Row Identifier: dosya, page, slot) ulaşılır. Açılıştaki tablo böyle bir heap. Önce 20.000 kısa not yazdım, sonra her onuncu notu 300 karaktere büyüttüm:
CREATE TABLE dbo.OrderNotes (OrderId int NOT NULL, Note varchar(1000) NOT NULL);  /* heap */
INSERT dbo.OrderNotes (OrderId, Note)
SELECT OrderId, 'ok' FROM dbo.Orders WHERE OrderId <= 20000;

UPDATE dbo.OrderNotes SET Note = REPLICATE('x', 300) WHERE OrderId % 10 = 0;

SELECT index_type_desc, page_count, record_count, forwarded_record_count
FROM sys.dm_db_index_physical_stats(DB_ID(), OBJECT_ID('dbo.OrderNotes'), 0, NULL, 'DETAILED');
index_type_desc page_count record_count forwarded_record_count
--------------- ---------- ------------ ----------------------
HEAP 47 20000 0
HEAP 129 21953 1953Büyüyen satır kendi page'ine sığmayınca SQL Server onu başka bir page'e taşıdı, ama eski yerinde yeni adresi gösteren bir forwarding pointer bıraktı. Neden taşıyıp adresi güncellemiyor? Çünkü heap üzerindeki her nonclustered index satırı RID ile gösterir; satırın adresi değişseydi bütün index'lerin güncellenmesi gerekirdi. Bedeli tarama sırasında ödenir: scan her forwarding pointer'da yeni adrese atlar, okumayı orada bitirir ve kaldığı yere döner. Açılıştaki 2.082 logical read bu atlamalardan geliyor. ALTER TABLE dbo.OrderNotes REBUILD sonrasında forwarded record sayısı sıfıra, logical reads 129'a indi.
Heap'in yeri dar: tek seferlik yüklenip sonra baştan sona okunan staging tabloları gibi. Güncellenen, aralıkla sorgulanan bir iş tablosunda clustered index varsayılan seçim olmalı. EF Core primary key'i zaten clustered index olarak oluşturur.
Clustering Key Seçimi
Clustering key bütün nonclustered index'lerin içine de girer: nonclustered index satırları, clustered tabloda satırı RID ile değil clustering key ile gösterir. Bu yüzden clustering key'den beklenenler kısa bir listedir:
- Dar: her nonclustered index satırında tekrar eder. 4 byte'lık
intyerine 16 byte'lıkuniqueidentifier, Orders'taki her index'i büyütür. - Unique: değilse SQL Server tekrar eden değerlere 4 byte'lık gizli bir uniquifier ekler.
- Değişmeyen: key değişirse satır B-tree'de yer değiştirir ve bütün nonclustered index'ler de güncellenir.
- Sürekli artan: yeni satırlar hep son page'e eklenir, ortadaki dolu page'ler bölünmez.
Sonuncusunun bir istisnası var: çok yoğun eşzamanlı insert'te herkesin aynı son page için beklemesi (PAGELATCH_EX, last-page insert contention). Bunun için SQL Server 2019 index'e OPTIMIZE_FOR_SEQUENTIAL_KEY = ON seçeneğini ekledi. Bookstore'un dakikada 120 siparişlik kampanya zirvesi bu seviyenin çok altında.
GUID Key'ler: NEWID, NEWSEQUENTIALID ve Guid.CreateVersion7
Dağıtık sistemlerde ID'yi uygulamada üretmek cazip; GUID (Globally Unique Identifier) bu yüzden sık seçilir. Rastgele bir GUID her insert'i B-tree'nin rastgele bir noktasına koyar. Dolu bir page'in ortasına satır gelince page ikiye bölünür (page split): yarısı yeni bir page'e taşınır ve iki page de yaklaşık yarı dolu kalır. .NET 9 ile gelen Guid.CreateVersion7() ise başında 48 bit Unix zaman damgası taşıyan, RFC (Request for Comments) 9562'deki UUID (Universally Unique Identifier) version 7 değerleri üretiyor ve "artık sıralı GUID'imiz var" diye düşünmek kolay. Önce beş değeri birkaç milisaniye arayla yazıp SQL Server'a sıralatalım:
for (int seq = 1; seq <= 5; seq++)
{
    Guid id = Guid.CreateVersion7();
    await conn.ExecuteAsync("INSERT dbo.GuidOrder (Seq, Id) VALUES (@seq, @id)", new { seq, id });
    await Task.Delay(2);
}
foreach (var row in await conn.QueryAsync<(int Seq, Guid Id)>("SELECT Seq, Id FROM dbo.GuidOrder ORDER BY Id"))
    Console.WriteLine($"{row.Seq}  {row.Id}");
5 01a1bafa-505d-78f5-9d56-0c03fa9c3e22
1 01a1bafa-5040-7ac4-a7d2-65cfd477a27b
3 01a1bafa-5056-708f-8410-6c0fde44ccff
2 01a1bafa-5052-7baa-80bc-8efc4f8f45fe
4 01a1bafa-5059-71a0-93be-b62f62df25b9Metin olarak bakınca değerler artıyor: 5040, 5052, 5056… Ama ORDER BY Id sırası 5, 1, 3, 2, 4. Sebep, SQL Server'ın uniqueidentifier karşılaştırma kuralı: önce son 6 byte'a (10–15), sonra 8–9, 6–7, 4–5 ve en son 0–3 byte'larına bakar. Version 7'de zaman damgası baştaki byte'larda, son 6 byte ise rastgele. Yani SQL Server'ın gözünde bu değerler NEWID() kadar rastgele. Tek bir örnek ikna etmezse 100.000 değere bakalım. Değerleri saniyede yaklaşık 1.000 insert'lik bir uygulamayı taklit edecek şekilde milisaniyede bir üretip ardışık çiftlerin kaçının "artan" olduğunu iki tarafın kurallarıyla saydım; EF Core'un SQL Server için Guid key'lerde kullandığı SequentialGuidValueGenerator'ı da ekledim:
DateTimeOffset start = DateTimeOffset.UtcNow;
for (int seq = 1; seq <= 100_000; seq++)
    table.Rows.Add(seq, Guid.CreateVersion7(start.AddMilliseconds(seq)));
/* SqlBulkCopy ile dbo.GuidStage (Seq, Id) tablosuna yazılır */

int sqlAscending = await conn.ExecuteScalarAsync<int>("""
    SELECT COUNT(*) FROM (
        SELECT Id, LAG(Id) OVER (ORDER BY Seq) AS PrevId FROM dbo.GuidStage) AS x
    WHERE x.Id > x.PrevId
    """);
Guid[] ids = table.Rows.Cast<DataRow>().Select(r => (Guid)r["Id"]).ToArray();
int dotnetAscending = ids.Zip(ids.Skip(1)).Count(p => p.Second.CompareTo(p.First) > 0);

var generator = new Microsoft.EntityFrameworkCore.ValueGeneration.SequentialGuidValueGenerator();
/* aynı ölçüm generator.Next(...) ile üretilen 100.000 değer için */
ascending pairs, SQL Server comparison: 49.944 / 99,999
ascending pairs, .NET Guid comparison: 99.999 / 99,999
ascending pairs, EF Core SequentialGuidValueGenerator (SQL Server comparison): 99.999 / 99,999.NET'in kendi karşılaştırmasında version 7 kusursuz artıyor; SQL Server'ın karşılaştırmasında çiftlerin yarısı artan, yarısı azalan, yani yazı tura. EF Core'un generator'ı ise zamanla değişen kısmı son byte'lara koyduğu için SQL Server sırasında artıyor. Şimdi bunun index'e etkisi. Dört tabloya 100.000'er satırı OLTP (Online Transaction Processing) uygulaması gibi tek tek insert ettim; version 7 değerleri yukarıdaki üretim sırasıyla geldi:
CREATE TABLE dbo.KeyInt   (Id int IDENTITY(1,1) NOT NULL PRIMARY KEY, Payload char(200) NOT NULL);
CREATE TABLE dbo.KeyNewId (Id uniqueidentifier NOT NULL DEFAULT NEWID() PRIMARY KEY, Payload char(200) NOT NULL);
CREATE TABLE dbo.KeySeq   (Id uniqueidentifier NOT NULL DEFAULT NEWSEQUENTIALID() PRIMARY KEY, Payload char(200) NOT NULL);
CREATE TABLE dbo.KeyV7    (Id uniqueidentifier NOT NULL PRIMARY KEY, Payload char(200) NOT NULL);

DECLARE @i int = 1, @id uniqueidentifier;
BEGIN TRANSACTION;
WHILE @i <= 100000
BEGIN
    INSERT dbo.KeyInt (Payload) VALUES ('order');
    INSERT dbo.KeyNewId (Payload) VALUES ('order');
    INSERT dbo.KeySeq (Payload) VALUES ('order');
    SELECT @id = Id FROM dbo.GuidStage WHERE Seq = @i;  /* v7 değerleri üretim sırasıyla */
    INSERT dbo.KeyV7 (Id, Payload) VALUES (@id, 'order');
    IF @i % 1000 = 0 BEGIN COMMIT; BEGIN TRANSACTION; END;  /* 1.000 satırda bir commit */
    SET @i += 1;
END;
COMMIT;
TableName page_count avg_space_pct frag_pct leaf_allocation_count
--------- ---------- ------------- -------- ---------------------
KeyInt 2632 100.0 .4 2632
KeySeq 2858 97.2 .7 2858
KeyV7 4147 67.0 99.2 4147
KeyNewId 4180 66.5 99.2 4180Version 7 ile NEWID() arasında fark yok: ikisi de 4.100 küsur page, %67 doluluk ve %99 fragmentation. NEWSEQUENTIALID() ve int IDENTITY yaklaşık 2.600–2.900 page'de kaldı. Aynı veri için %58 daha fazla page; bu, aynı tabloyu okumak için %58 daha fazla I/O (Input/Output) ve buffer pool'da %58 daha fazla bellek demek. Uygulamada GUID üretmen gerekiyorsa EF Core'un generator'ı bu iş için tasarlanmış. Version 7'yi başka sistemlerle paylaşmak gibi bir sebeple kullanıyorsan onu clustering key yapma; dar bir int/bigint clustered key ve GUID üzerinde unique nonclustered index daha iyi bir denge.
Fragmentation, Page Density ve Fill Factor
Yukarıdaki tabloda iki ayrı ölçü var. Fragmentation (avg_fragmentation_in_percent) leaf page'lerin mantıksal sırası ile diskteki sırasının ne kadar uyuşmadığıdır. Page density (avg_page_space_used_in_percent) ise page'lerin ne kadar dolu olduğudur. Microsoft'un index bakımı rehberi, birçok iş yükünde page density'yi artırmanın fragmentation'ı azaltmaktan daha büyük etki yaptığını ve bakım kararının sabit eşiklere göre değil, ölçülen etkiye göre verilmesi gerektiğini söylüyor. Random I/O'nun sıralı I/O kadar hızlı olduğu modern SSD'lerde (Solid-State Drive) fragmentation'ın kendisi daha az önemli; ama yarı boş page'ler her ortamda daha çok okuma ve daha çok bellek demek. NEWID() tablosunu yeniden kurup fill factor'ün etkisine baktım:
ALTER INDEX ALL ON dbo.KeyNewId REBUILD WITH (FILLFACTOR = 100);
/* 1.000 yeni rastgele key insert */
ALTER INDEX ALL ON dbo.KeyNewId REBUILD WITH (FILLFACTOR = 80);
/* 1.000 yeni rastgele key insert */| Durum | page_count | avg_page_space_used_in_percent | Tam tarama logical reads |
|---|---|---|---|
| Rebuild öncesi | 4180 | 66.5 | 4199 |
FILLFACTOR = 100 rebuild | 2862 | 97.1 | 2875 |
| + 1.000 rastgele insert | 3674 | 76.4 | - |
FILLFACTOR = 80 rebuild | 3487 | 80.5 | - |
| + 1.000 rastgele insert | 3487 | 81.3 | - |
Rebuild page sayısını 4.180'den 2.862'ye indirdi ve tam tarama 4.199 yerine 2.875 logical read'e düştü. Ama tamamen dolu page'lere yalnızca 1.000 rastgele insert (verinin %1'i) 812 yeni page açtı: neredeyse her insert bir split. Fill factor 80 ile rebuild edilen index'te aynı 1.000 insert hiç yeni page açmadı. Microsoft'un önerisi de bu: fill factor'ü 100'den farklı bir değere yalnızca çok page split yaşayan index'lerde, örneğin baş kolonu sırasız GUID olanlarda ayarla. Sürekli artan key'li bir index'te fill factor'ü düşürmek yalnızca boş yer bırakır.
Rebuild sonrası görülen hızlanmanın bir kısmı da index statistics'inin FULLSCAN ile güncellenmesinden gelir ve aynı etkiyi çok daha ucuza statistics güncellemesiyle almak çoğu zaman mümkündür. Statistics dördüncü yazının konusu.
SQL Server 2019/2022'de farkı: page yapısı, heap, B-tree ve uniqueidentifier sıralaması üç sürümde de aynı. sys.dm_db_page_info ve OPTIMIZE_FOR_SEQUENTIAL_KEY 2019 ile geldi; 2017 ve öncesinde page'e bakmak için belgelenmemiş DBCC PAGE kullanılırdı. Bu yazıdaki ölçümler 2019 ve 2022'de de aynı sonucu verir, yalnızca SCHEMA.sql 2019'da GENERATE_SERIES olmadığı için çalışmaz.
Üretimde Dikkat
Heap'leri izle. Güncellenen bir heap'te forwarded record sayısı sessizce büyür ve tarama maliyeti page sayısıyla değil forwarded record sayısıyla artar. sys.dm_db_index_physical_stats'ta heap'ler için forwarded_record_count'a bak; kalıcı çözüm clustered index eklemek.
Index bakımını takvime değil ölçüme bağla. Her gece bütün index'leri rebuild eden bir job, kaynak harcar, log üretir ve çoğu zaman ölçülebilir bir fayda getirmez. Page density'si düşük ve sorgularda gerçekten kullanılan index'leri hedefle, etkisini Query Store ile önce ve sonra ölç.
Index rebuild'in de bir bedeli var. Enterprise'da ONLINE = ON mümkün; Standard'da offline rebuild tabloyu süre boyunca kilitler ve kilitlerin etkisini ileriki lock yazısında göreceğiz.
Sık Düşülen Tuzaklar
Version 7 GUID'i "SQL Server için sıralı" sanmak. .NET sırasında artıyor, SQL Server sırasında artmıyor. Clustering key olarak kullanılınca NEWID() ile aynı split ve doluluk sorunlarını yaşıyorsun.
Geniş ya da değişen bir clustering key seçmek. Email gibi bir kolonu clustered key yapmak hem bütün nonclustered index'leri büyütür hem de e-posta her değiştiğinde satırı ağaçta taşır.
Fragmentation yüzdesine bakıp karar vermek. %99 fragmentation'lı ama %95 dolu ve SSD üzerindeki bir index, %10 fragmentation'lı ama %50 dolu bir index'ten daha az sorun çıkarabilir. İkisine birlikte ve sorgu ölçümleriyle bak.
Heap'i "daha hızlı insert" diye seçmek. Insert gerçekten ucuz olabilir, ama ilk büyüyen UPDATE'te forwarded record'lar ve her nonclustered index'in RID lookup'ı bu kazancı geri alır.
Küçük Bir Deneme
★☆☆ dbo.Customers için sys.dm_db_index_physical_stats çalıştır. Kaç seviye var, leaf page'ler ne kadar dolu? CustomerId = 50000 aramasının kaç logical read tutacağını önce tahmin et, sonra ölç.
★★☆ dbo.OrderNotes heap'ine CREATE CLUSTERED INDEX ile OrderId üzerinde clustered index ekle ve aynı büyüten UPDATE'i tekrar çalıştır. Forwarded record yerine ne oluyor? Page sayısını ve tarama maliyetini karşılaştır.
★★★ KeyV7 tablosunu Id üzerinde unique nonclustered index, bigint IDENTITY üzerinde clustered index olacak şekilde yeniden tasarla ve 100.000 insert'i tekrarla. İki index'in page sayısını ve doluluğunu ayrı ayrı ölç; split'lerin nereye taşındığını açıkla.
Clustered index'in tablonun kendisi olduğunu ve key'in her nonclustered index'e girdiğini gördük. Bir sonraki yazıda nonclustered index'leri tasarlayacağız: key kolonlarının sırası, INCLUDE, covering index, key lookup'ın maliyeti ve optimizer'ın index'i bırakıp tabloyu taramaya karar verdiği tipping point.