

SLO Tabanlı Alerting: Burn Rate, Multiwindow Alert'ler ve Alert Yorgunluğunu Bitirmek

SLO tabanlı alert, error budget'ın harcanma hızını (burn rate) bir uzun ve bir kısa pencerede birlikte ölçer: uzun pencere kısa sıçramalarda susar, kısa pencere arıza bitince alert'i hızla kapatır. Bookstore checkout'u için Workbook'un 14,4/6/1 eşiklerini Prometheus rule'larına çeviriyor, promtool ile test ediyor, canlı bir arızada ne zaman çalıp sustuklarını ölçüyor ve Sloth'un ürettikleriyle karşılaştırıyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10, OpenTelemetry .NET 1.21, Prometheus 3.16.0 (promtool dahil) ve Sloth 0.16.0 ile denenmiştir.
Önce Tahmin Et
Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) checkout'u için SLO (Service Level Objective; belirli bir zaman penceresinde tutturulması hedeflenen güvenilirlik seviyesi) yüzde 99,5. Üç gün boyunca sorunsuz çalışan checkout'ta beş dakika boyunca bütün istekler hata veriyor. Workbook'taki "1 saatlik pencerede burn rate 14,4" alert'i kaçıncı dakikada çalar: hemen mi, birinci dakikada mı, beşinci dakikada mı? Aynı alert, hata oranı yüzde 100 yerine yüzde 10 olsaydı kaç dakika sonra çalardı? Ve arıza bittikten sonra alert'in susması ne kadar sürer? Cevapları promtool'un birim testlerinde ve canlı bir arızada ölçtük.
Neden Değil, Belirti
Klasik alert'ler nedenlere bakar: "CPU yüzde 80'in üstünde", "disk yüzde 90 dolu", "thread pool kuyruğu 100'ü geçti". Bunların her biri bir sorunun nedeni olabilir, ama kullanıcı etkilenmeden de çalabilirler ve kullanıcı etkilendiğinde hiçbiri çalmayabilir. Serinin ikinci yazısında ödeme sağlayıcısı hata verirken API'nin CPU'su hiç değişmedi; checkout'ların yüzde 5'i yine de başarısızdı. Belirti tabanlı (symptom-based) alert ise doğrudan kullanıcının yaşadığına bakar: SLI (Service Level Indicator; servisin kullanıcıya ne kadar iyi hizmet verdiğini gösteren ölçüm) kötüleşiyor mu?
İkinci ayrım alert'in kime gittiği. Page (on-call kişiyi gece de olsa telefonla uyandıran alert) ancak hemen müdahale gerektiren durumlar için. Ticket (mesai saatinde bakılacak iş kaydı) bekleyebilecek sorunlar için. Her page bir insanın uykusundan ya da odaklanmasından alınan zaman; bir alert'in page olmayı hak etmesi gerekiyor.
SRE (Site Reliability Engineering; güvenilirliği yazılım mühendisliğiyle yönetme disiplini) Workbook'unun "Alerting on SLOs" bölümü bir alert stratejisini dört ölçüyle değerlendiriyor. Precision: çalan alert'lerin ne kadarı gerçekten önemli bir olaydı (bütçenin büyük bir kısmını yiyen bir olay). Recall: önemli olayların ne kadarı alert üretti. Detection time: sorun başladıktan ne kadar sonra alert geldi. Reset time: sorun bittikten ne kadar sonra alert sustu. Tek bir eşikle bu dördünü birden iyi yapmak mümkün değil; bu yazının konusu olan yaklaşım bunun için iki pencereyi birlikte kullanıyor.
Burn Rate
Burn rate, error budget'ın (hata bütçesi) ne hızla harcandığı: gözlenen hata oranı bölü SLO'nun izin verdiği hata oranı. Checkout için izin verilen oran yüzde 0,5. Hata oranı yüzde 0,5 ise burn rate 1: bütçe tam 30 günde biter. Yüzde 5 ise burn rate 10: bütçe 3 günde biter. Yüzde 100 ise burn rate 200: 30 günlük bütçe 3,6 saatte biter.
Bu tanım alert eşiğini bütçeye bağlıyor. "1 saat içinde 30 günlük bütçenin yüzde 2'sini harcadık" demek, 1 saatlik pencerede burn rate'in 30 gün × 24 saat × 0,02 = 14,4 olması demek. Workbook'un önerdiği tablo bu mantıkla kurulmuş; birincil kaynaktan kontrol ettiğimiz değerler şöyle:
| Önem | Uzun pencere | Kısa pencere | Burn rate | Harcanan bütçe | Checkout için hata oranı |
|---|---|---|---|---|---|
| Page | 1 saat | 5 dakika | 14,4 | yüzde 2 | yüzde 7,2 |
| Page | 6 saat | 30 dakika | 6 | yüzde 5 | yüzde 3 |
| Ticket | 3 gün | 6 saat | 1 | yüzde 10 | yüzde 0,5 |
Uzun pencere precision'ı sağlıyor: kısa bir sıçrama 1 saatlik pencerede bütçenin yüzde 2'sini harcamaya yetmez, alert çalmaz. Kısa pencere reset time'ı kısaltıyor: sorun bittiği anda 5 dakikalık pencere temizlenmeye başlar ve alert, 1 saatlik pencere hâlâ yüksekken susar. Workbook kısa pencereyi uzun pencerenin 1/12'si olarak öneriyor. İki page satırı farklı hızları yakalıyor: 1 saatlik satır hızlı yanan arızaları, 6 saatlik satır daha yavaş ama uzun süren arızaları. Ticket satırı ise "bu gidişle ay sonunda bütçe bitecek" diyor.
Burn Rate'i Prometheus Rule'larına Çevirmek
Her pencere için hata oranını bir recording rule'a yazdık; alert'ler bu serileri karşılaştırıyor. Rule'lar deploy/prometheus/rules/slo-alerts.yaml dosyasında (5m, 30m, 1h, 6h ve 3d için aynı kalıp; burada ikisi):
# Checkout availability SLO'su için multiwindow, multi-burn-rate alert'ler (%99,5, error budget 0.005).
# Burn rate = hata oranı / 0.005. Eşikler SRE Workbook'un "Alerting on SLOs" bölümünden:
#   page:   1h ve 5m pencereleri 14.4'ün üstünde  (30 günlük bütçenin %2'si bir saatte)
#   page:   6h ve 30m pencereleri 6'nın üstünde   (bütçenin %5'i altı saatte)
#   ticket: 3d ve 6h pencereleri 1'in üstünde     (bütçenin %10'u üç günde)
# Kısa pencere (uzun olanın 1/12'si) alert'in sorun bittikten kısa süre sonra susmasını sağlar.
groups:
  - name: bookstore-slo-burn
    rules:
      - record: slo:checkout_availability:error_ratio_rate5m
        expr: |
          1 - sum(rate(http_server_request_duration_seconds_count{job="bookstore-api", http_route="/api/orders/", http_request_method="POST", http_response_status_code=~"[23].."}[5m]))
            / sum(rate(http_server_request_duration_seconds_count{job="bookstore-api", http_route="/api/orders/", http_request_method="POST", http_response_status_code=~"[235]..|429"}[5m]))
      - record: slo:checkout_availability:error_ratio_rate1h
        expr: |
          1 - sum(rate(http_server_request_duration_seconds_count{job="bookstore-api", http_route="/api/orders/", http_request_method="POST", http_response_status_code=~"[23].."}[1h]))
            / sum(rate(http_server_request_duration_seconds_count{job="bookstore-api", http_route="/api/orders/", http_request_method="POST", http_response_status_code=~"[235]..|429"}[1h]))

      - alert: CheckoutErrorBudgetBurn
        expr: |
          slo:checkout_availability:error_ratio_rate1h > (14.4 * 0.005)
          and
          slo:checkout_availability:error_ratio_rate5m > (14.4 * 0.005)
        labels:
          severity: page
          long_window: 1h
        annotations:
          summary: "Checkout is burning its 30-day error budget 14.4 times too fast (1h and 5m windows)"
      - alert: CheckoutErrorBudgetBurn
        expr: |
          slo:checkout_availability:error_ratio_rate6h > (6 * 0.005)
          and
          slo:checkout_availability:error_ratio_rate30m > (6 * 0.005)
        labels:
          severity: page
          long_window: 6h
        annotations:
          summary: "Checkout is burning its 30-day error budget 6 times too fast (6h and 30m windows)"
      - alert: CheckoutErrorBudgetBurn
        expr: |
          slo:checkout_availability:error_ratio_rate3d > (1 * 0.005)
          and
          slo:checkout_availability:error_ratio_rate6h > (1 * 0.005)
        labels:
          severity: ticket
          long_window: 3d
        annotations:
          summary: "Checkout will use up its 30-day error budget at this pace (3d and 6h windows)"
Üç alert'in adı aynı, long_window label'ı farklı. Böylece Alertmanager'da aynı alert olarak gruplanıyorlar, ama hangi satırın çaldığı label'dan okunuyor. for kullanmadık: kısa pencere zaten bir tür bekleme süresi; üstüne for eklemek detection time'ı uzatır ve Workbook'taki hesapları bozar. Prometheus'u kurmak, rule dosyalarını yüklemek ve Alertmanager'ı bağlamak Observability serisinin alerting yazısının konusu; burada yalnız SLO'nun alert'e nasıl çevrildiği var.
Alert'leri promtool ile Test Etmek
Bir alert'in doğru çalıştığını görmek için production'da arıza beklemek gerekmiyor. promtool test rules, verilen zaman serileri üzerinde rule'ları dakika dakika hesaplıyor ve belirli anlarda hangi alert'lerin çalması gerektiğini kontrol ediyor. Serilerin yazımı kısa: 0+600x4320, 0'dan başlayıp 4.320 adım boyunca her adımda 600 artan bir counter demek. İlk test dosyamızda senaryolar iki saatlik sakin veriyle başlıyordu ve test şöyle patladı:
promtool test rules slo-alerts.test.yaml
Processing test file: slo-alerts.test.yaml
  FAILED:
    alertname: CheckoutErrorBudgetBurn, time: 2h40m,
        exp:[],
        got:[
            0:
              Labels:{alertname="CheckoutErrorBudgetBurn", long_window="3d", severity="ticket"}
              Annotations:{summary="Checkout will use up its 30-day error budget at this pace (3d and 6h windows)"}
            ]
...
    alertname: CheckoutErrorBudgetBurn, time: 1h15m,
        exp:[],
        got:[
            0:
              Labels:{alertname="CheckoutErrorBudgetBurn", long_window="3d", severity="ticket"}
              Annotations:{summary="Checkout will use up its 30-day error budget at this pace (3d and 6h windows)"},
            1:
              Labels:{alertname="CheckoutErrorBudgetBurn", long_window="6h", severity="page"}
              Annotations:{summary="Checkout is burning its 30-day error budget 6 times too fast (6h and 30m windows)"}
            ]
Bu hata bir şey öğretiyor: 3 günlük ve 6 saatlik pencerelerde yalnız iki saatlik veri vardı. Prometheus rate'i pencerede ne kadar veri varsa onunla hesaplıyor, yani yeni açılmış bir serviste "3 günlük" hata oranı aslında son iki saatin hata oranı. Ticket ve 6 saatlik page bu yüzden olması gerekenden çok erken çaldı. Aynı şey yeni deploy edilen, metric'i sıfırdan başlayan bir serviste production'da da olur. Testleri, her senaryodan önce üç sakin gün olacak şekilde düzelttik:
# Burn-rate alert'lerinin birim testleri: promtool test rules deploy/prometheus/tests/slo-alerts.test.yaml
# Her testte checkout trafiği dakikada 600 istek; değişen yalnız 502 cevaplarının payı.
# Her senaryo üç sakin günden sonra başlar; uzun pencereler (6h, 3d) production'daki gibi doludur.
rule_files:
  - ../rules/slo-alerts.yaml

evaluation_interval: 1m

tests:
  # ... (yüzde 10 hata ve üç günlük ticket senaryoları)

  # Üç hatasız günden sonra her checkout'un hata verdiği beş dakika: burn rate 200, yaklaşık 4,3 dakika sonra page,
  # ve arıza bittikten birkaç dakika sonra sessizlik.
  - interval: 1m
    input_series:
      - series: 'http_server_request_duration_seconds_count{job="bookstore-api", http_route="/api/orders/", http_request_method="POST", http_response_status_code="201"}'
        values: '0+600x4320 2592000+0x5 2592000+600x30'
      - series: 'http_server_request_duration_seconds_count{job="bookstore-api", http_route="/api/orders/", http_request_method="POST", http_response_status_code="502"}'
        values: '0+0x4320 600+600x4 3000+0x30'
    alert_rule_test:
      - eval_time: 72h4m
        alertname: CheckoutErrorBudgetBurn
        exp_alerts: []
      - eval_time: 72h5m
        alertname: CheckoutErrorBudgetBurn
        exp_alerts:
          - exp_labels:
              severity: page
              long_window: 1h
            exp_annotations:
              summary: "Checkout is burning its 30-day error budget 14.4 times too fast (1h and 5m windows)"
      - eval_time: 72h15m
        alertname: CheckoutErrorBudgetBurn
        exp_alerts: []
promtool test rules deploy/prometheus/tests/slo-alerts.test.yaml
Processing test file: slo-alerts.test.yaml
SUCCESSÖnce Tahmin Et'in cevapları bu testlerde. Yüzde 100 hata, yüzde 0,5'lik bütçe için burn rate 200 demek; 1 saatlik pencerede yüzde 7,2'ye ulaşmak için 60 × 0,072 = 4,3 dakika gerekiyor. Test bunu doğruluyor: 4. dakikada alert yok, 5. dakikada var. Hata oranı yüzde 10 olsaydı (burn rate 20) hesaba göre aynı alert ancak 43. dakikada çalardı; ilk senaryo 40. dakikada sessiz, 45. dakikada çalıyor olmasını kontrol ediyor. Arıza bittikten sonra ise 5 dakikalık pencere temizlenince alert susuyor; 1 saatlik pencere o sırada hâlâ yüzde 8,3 gösteriyor.
Canlı Bir Arıza
Testler mantığı doğruluyor; aynı rule'ların gerçek trafikte nasıl davrandığını da görmek istedik. Prometheus'u boş bir veritabanıyla başlattık, trafik aracı 20:42:20'den itibaren saniyede dört yolculuk gönderdi ve 20 dakika sonra sahte ödeme sağlayıcısını 10 dakika boyunca ödemelerin yüzde 30'unu reddedecek şekilde ayarladık. Yüzde 30 hata, yüzde 0,5'lik bütçe için burn rate 60 demek:
curl -X PUT http://localhost:5090/admin/faults -H "content-type: application/json" -d '{"failRatio":0.3}'
{"failRatio":0.3,"slowRatio":0.002,"slowDelayMs":1500}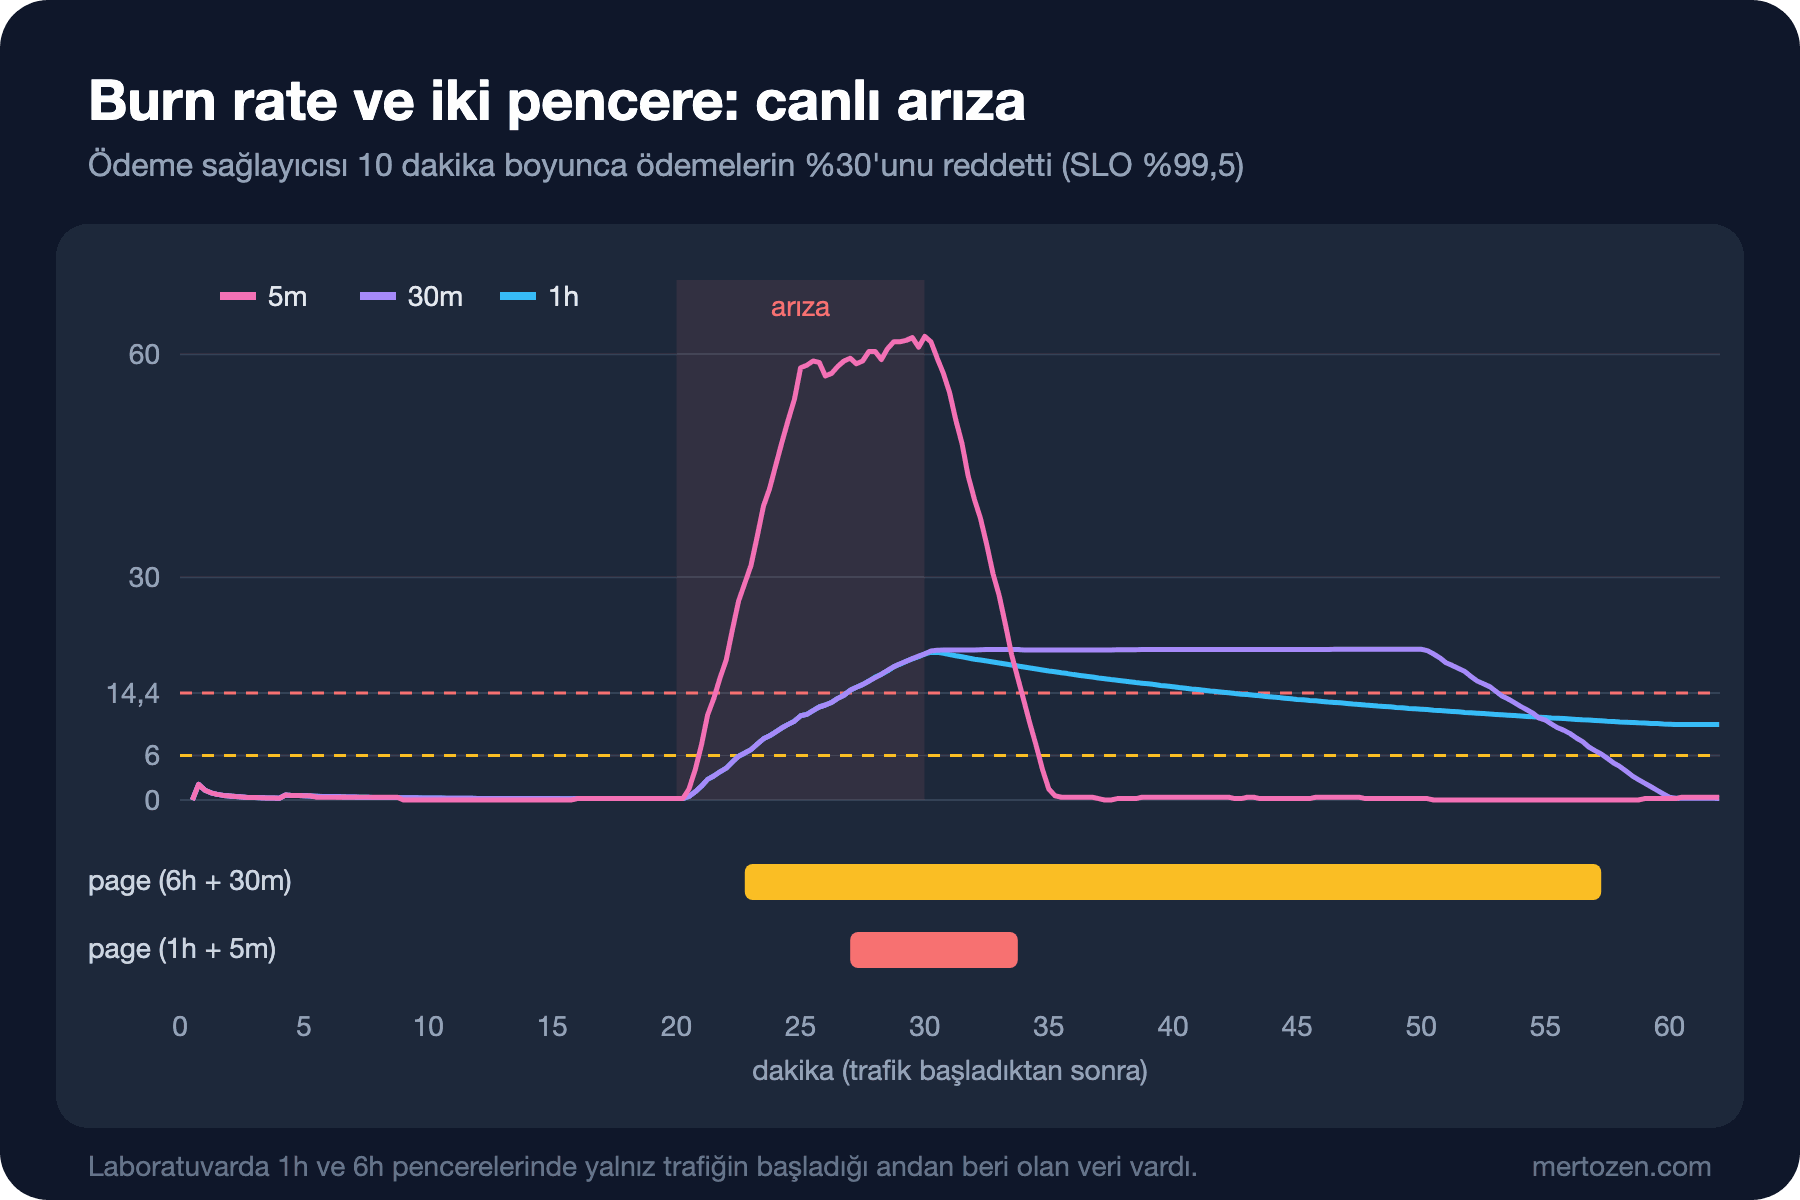
ALERTS serisinden okunan zamanlar (UTC (eşgüdümlü evrensel saat)):
- 20:43:05: ticket 15 saniyeliğine çaldı. Trafiğin ilk dakikasında gelen tek bir 502, "3 günlük" pencerede yalnız bir dakikalık veri olduğu için yüzde 0,5'i aştı.
- 21:02:20: arıza başladı. 21:03:05'te ticket tekrar çaldı ve deneme bitene kadar susmadı.
- 21:05:05: 6 saatlik page çaldı, arızadan 2 dakika 45 saniye sonra.
- 21:09:20: 1 saatlik page çaldı, arızadan 7 dakika sonra.
- 21:12:20: arıza bitti. 21:16:05'te 1 saatlik page sustu (3 dakika 45 saniye sonra); 6 saatlik page ise 21:39:35'e kadar, 27 dakika daha çaldı.
Reset time farkı figürde açıkça görülüyor: 1 saatlik page'in kısa penceresi 5 dakika, 6 saatlik page'inki 30 dakika. 1 saatlik pencere arıza bittiğinde hâlâ yüzde 9,8 hata oranı gösteriyordu; kısa pencere olmasaydı page, saatin geri kalanında da çalmaya devam ederdi.
Ama bu laboratuvarın asıl dersi, burada çalan iki page'in production'da çalmayacak olması. Prometheus bu denemede yalnızca bir saattir çalışıyordu: "1 saatlik" ve "6 saatlik" pencereler aslında trafiğin başladığı andan beri olan 20–30 dakikayı görüyordu ve figürdeki 30m ile 1h çizgilerinin arıza bitene kadar üst üste olmasının sebebi bu. Dolu bir 1 saatlik pencerede yüzde 30 hata oranının yüzde 7,2'ye ulaşması 60 × 0,072 / 0,3 = 14,4 dakika sürerdi; arıza 10 dakikada bitti ve pencere en fazla yüzde 5'e çıkardı. 6 saatlik pencerede yüzde 3'e ulaşmak için 36 dakika gerekirdi. Bu arıza 30 günlük bütçenin yaklaşık yüzde 1,4'ünü harcadı (3 dakikalık tam kesintiye eşdeğer, bütçe 216 dakika); Workbook'un eşikleri bunu bilerek page değeri taşımayan bir olay sayıyor. Yeni açılmış bir Prometheus'ta, yeni deploy edilmiş ve metric'leri sıfırdan başlayan bir serviste ya da veri kaybından sonra uzun pencereler aynı şekilde kısa pencere gibi davranır; bu dönemde gelen page'leri bu gözle değerlendir.
Sloth ve Pyrra
Bu rule'ları elle yazmak öğretici, ama her SLO için beş recording rule ve üç alert kopyalamak hataya açık. Sloth bir SLO tanımından bütün rule'ları üretiyor. Aynı availability SLO'su Sloth'un formatında:
# Aynı availability SLO'su Sloth spec'i olarak. Sloth recording rule'ları ve burn-rate alert'lerini üretir:
#   sloth generate -i deploy/slo/checkout.sloth.yaml -o checkout.sloth.rules.yaml
# Elle yazdığımız rule'ları kullanmaya devam ediyoruz (deploy/prometheus/rules/slo-alerts.yaml); bu dosya karşılaştırma için.
version: "prometheus/v1"
service: "bookstore-api"
labels:
  owner: "bookstore-team"
slos:
  - name: "checkout-availability"
    objective: 99.5
    description: "Checkout requests that did not fail on our side."
    sli:
      events:
        error_query: sum(rate(http_server_request_duration_seconds_count{job="bookstore-api",http_route="/api/orders/",http_request_method="POST",http_response_status_code=~"5..|429"}[{{.window}}]))
        total_query: sum(rate(http_server_request_duration_seconds_count{job="bookstore-api",http_route="/api/orders/",http_request_method="POST",http_response_status_code=~"[235]..|429"}[{{.window}}]))
    alerting:
      name: CheckoutAvailabilityBudgetBurn
      page_alert:
        labels:
          severity: page
      ticket_alert:
        labels:
          severity: ticket
sloth generate -i deploy/slo/checkout.sloth.yaml -o checkout.sloth.rules.yaml
# checkout.sloth.rules.yaml: 15 recording rule, 2 alert; page alert'i:
- alert: CheckoutAvailabilityBudgetBurn
expr: |
(
max(slo:sli_error:ratio_rate5m{sloth_id="bookstore-api-checkout-availability", sloth_service="bookstore-api", sloth_slo="checkout-availability"} > (14.4 * 0.005)) without (sloth_window)
and
max(slo:sli_error:ratio_rate1h{sloth_id="bookstore-api-checkout-availability", sloth_service="bookstore-api", sloth_slo="checkout-availability"} > (14.4 * 0.005)) without (sloth_window)
)
or
(
max(slo:sli_error:ratio_rate30m{sloth_id="bookstore-api-checkout-availability", sloth_service="bookstore-api", sloth_slo="checkout-availability"} > (6 * 0.005)) without (sloth_window)
and
max(slo:sli_error:ratio_rate6h{sloth_id="bookstore-api-checkout-availability", sloth_service="bookstore-api", sloth_slo="checkout-availability"} > (6 * 0.005)) without (sloth_window)
)
labels:
severity: page
sloth_severity: page
annotations:
summary: '{{$labels.sloth_service}} {{$labels.sloth_slo}} SLO error budget burn
...Sloth ürettiği rule'lara bütçe takibi için ek seriler de koyuyor (slo:period_error_budget_remaining:ratio gibi). Ürettiği page alert'i bizim iki page satırımızla aynı, ama ticket tarafı farklı: 2 saat/1 gün pencerelerinde burn rate 3 ve 6 saat/3 gün pencerelerinde burn rate 1. Hangisinin doğru olduğu değil, ekibin hangisini seçtiği önemli; tabloyu dokümana yazmak bunun için. Pyrra (Prometheus topluluğu altındaki bir başka SLO aracı, şu anki sürümü 0.10.2) benzer rule'ları üretiyor ve üstüne SLO'ları ve kalan bütçeyi gösteren bir web arayüzü ekliyor; Kubernetes'te CRD (Custom Resource Definition; Kubernetes API'sine eklenen özel kaynak türü) olarak, dışında dosyadan çalışıyor. Pyrra'yı bu yazıda çalıştırmadık, yalnız dokümanından anlatıyoruz.
Üretimde Dikkat
Düşük trafik. Serinin önceki yazısında gördüğümüz gibi günde 40 siparişlik kurumsal portalda tek bir hata 5 dakikalık pencerede yüzde 100 hata oranı demek. Kısa pencere bir istekle eşiği aşar, uzun pencere birkaç hatayla. Seçenekler: synthetic trafik, minimum istek sayısı şartı (and sum(rate(…[1h])) > 0.1 gibi), ya da o servis için page yerine yalnız ticket.
Deploy anındaki sıçramalar. Rolling deploy sırasında kapanan instance'lardaki birkaç yarım istek 5 dakikalık pencerede belirgin bir hata oranı üretebilir, ama 1 saatlik pencerede yüzde 7,2'ye ulaşmaz. Multiwindow yaklaşımın en büyük faydası bu: kısa sıçramalarda sessiz kalıyor. Yine de sık deploy edilen bir serviste graceful shutdown'ı (Deployment Stratejileri serisinin zero-downtime ön koşulları yazısı) düzgün kurmak gerekiyor.
Her servise ayrı page. On mikroservisin her biri için ayrı burn rate alert'i, bir veritabanı arızasında on ayrı telefon çağrısı demek. Page'i kullanıcı yolculuğuna bağla (checkout, arama), servislere değil. Alertmanager'da gruplama ve inhibition bu yükü azaltıyor; bir sonraki yazıda bakıyoruz.
Latency SLO'su için de aynı kalıp. Latency'de hata oranı "800 ms'yi aşan geçerli isteklerin oranı" ve izin verilen oran yüzde 1; eşikler 14,4 × 0,01 ve 6 × 0,01 oluyor.
Sık Düşülen Tuzaklar
Tek pencere. Yalnız 5 dakikalık pencereye bakan bir alert her kısa sıçramada çalar; yalnız 1 saatlik pencereye bakan bir alert arıza bittikten sonra bir saat çalmaya devam eder. İkisi birlikte.
Uzun pencereyi kısa veriyle test etmek. Yukarıdaki ilk test dosyası gibi; uzun pencerenin dolu olduğu bir senaryo yazmadan "alert'im doğru" demek yanıltıcı.
Eşiği SLO'dan bağımsız seçmek. "Hata oranı yüzde 5'i geçerse page" gibi bir eşik, SLO yüzde 99,9 olduğunda çok geç, yüzde 95 olduğunda çok erken çalar. Eşik her zaman burn rate × izin verilen hata oranı.
for ile bekleme süresini uzatmak. "Yanlış alarm çok, for: 15m ekleyelim" detection time'a 15 dakika ekler ve tam arıza sırasında bütçenin bir bölümünü sessizce harcar. Yanlış alarm çoksa sebep genelde pencere ya da SLI tanımı.
Küçük Bir Deneme
★☆☆ slo-alerts.test.yaml'a yüzde 50 hata oranlı bir senaryo ekle. Önce 1 saatlik page'in kaçıncı dakikada çalacağını hesapla (60 × 0,072 / 0,5), sonra testi o dakikanın bir öncesi ve bir sonrası için yaz.
★★☆ Checkout latency SLO'su (yüzde 99'u 800 ms altında) için aynı üç alert'i yaz. Hata oranı, le="0.8" bucket'ının dışında kalan geçerli isteklerin oranı. Sahte sağlayıcının slowRatio'sunu 0,2 yapıp hangi alert'in çaldığına bak.
★★★ Kısa pencerenin işini gösteren bir test yaz: 10 dakikalık yüzde 50 hata ve ardından sakin bir saat. Kısa pencereyi kaldırdığında (yalnız 1 saatlik koşul) alert'in arıza bittikten sonra ne kadar daha çaldığını promtool ile ölç.
Alert artık doğru zamanda çalıyor. Ama gece ikide telefonu çalan kişinin ne yapacağını bilmesi gerekiyor. Bir sonraki yazıda on-call düzenini (rotation, escalation, handoff) kuruyor, Alertmanager'da page ile ticket'ı ayırıyor ve bu alert için ilk beş dakikası gerçek bir arızada denenmiş bir runbook yazıyoruz.