

SLI Seçmek: Kullanıcı Yolculuğundan Ölçülebilir Sinyale

İyi bir SLI kullanıcının yolculuğundan çıkar ve iyi olayların geçerli olaylara oranıdır; 4xx ile health check paydaya girmez. Bookstore'un checkout'u için ASP.NET Core'un http.server.request.duration histogram'ından availability ve latency SLI'ları yazıyor, bütün endpoint'leri karıştırmanın ve ortalamanın hatayı nasıl gizlediğini, API kapalıyken uygulama metric'inin neden hiçbir şey görmediğini ölçüyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10, OpenTelemetry .NET 1.21 ve Prometheus 3.16.0 (resmi prom/prometheus image'ı, OTLP (OpenTelemetry Protocol; telemetry verisini taşıyan protokol) receiver'ı açık) ile denenmiştir.
Önce Tahmin Et
Bookstore'a (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) saniyede dört kullanıcı yolculuğu gönderen bir trafik aracı çalışırken API process'ini tam 60 saniye kapattık. O dakikada trafik aracı 491 isteğe hiç cevap alamadı ve tek bir sipariş verilemedi. Aynı dakikalarda, uygulamanın kendi metric'inden hesapladığımız checkout availability SLI'ı (Service Level Indicator; servisin kullanıcıya ne kadar iyi hizmet verdiğini gösteren ölçüm) ne gösterdi: yüzde 70 mi, yüzde 90 mı, yoksa başka bir şey mi? İkinci soru: ödeme sağlayıcısı dört dakika boyunca isteklerin yüzde 5'ini reddettiğinde API'nin bütün endpoint'lerinin başarı oranı yüzde 98,96 çıktı. Checkout yapmaya çalışan müşteri için gerçek oran neydi? Cevaplar yazının ortasında.
Kritik Kullanıcı Yolculuklarından Başla
SLI seçmeye metric listesinden değil, kullanıcıdan başlanır. SRE (Site Reliability Engineering; güvenilirliği yazılım mühendisliğiyle yönetme disiplini) üzerine Google'ın yazdığı Workbook'un SLO (Service Level Objective; SLI için konan hedef) uygulamasını anlatan bölümü bunun için CUJ (Critical User Journey; kullanıcının ürünü kullanırken izlediği ve vazgeçemeyeceği adım dizisi) kavramını kullanıyor. Bir online alışveriş sitesi için verdiği örnekler Bookstore'a birebir uyuyor. Bookstore için üç CUJ çıkardık: kitap aramak, sepete eklemek ve ödeme yapmak. Her yolculuk API'de bir ya da birkaç endpoint'e karşılık geliyor:
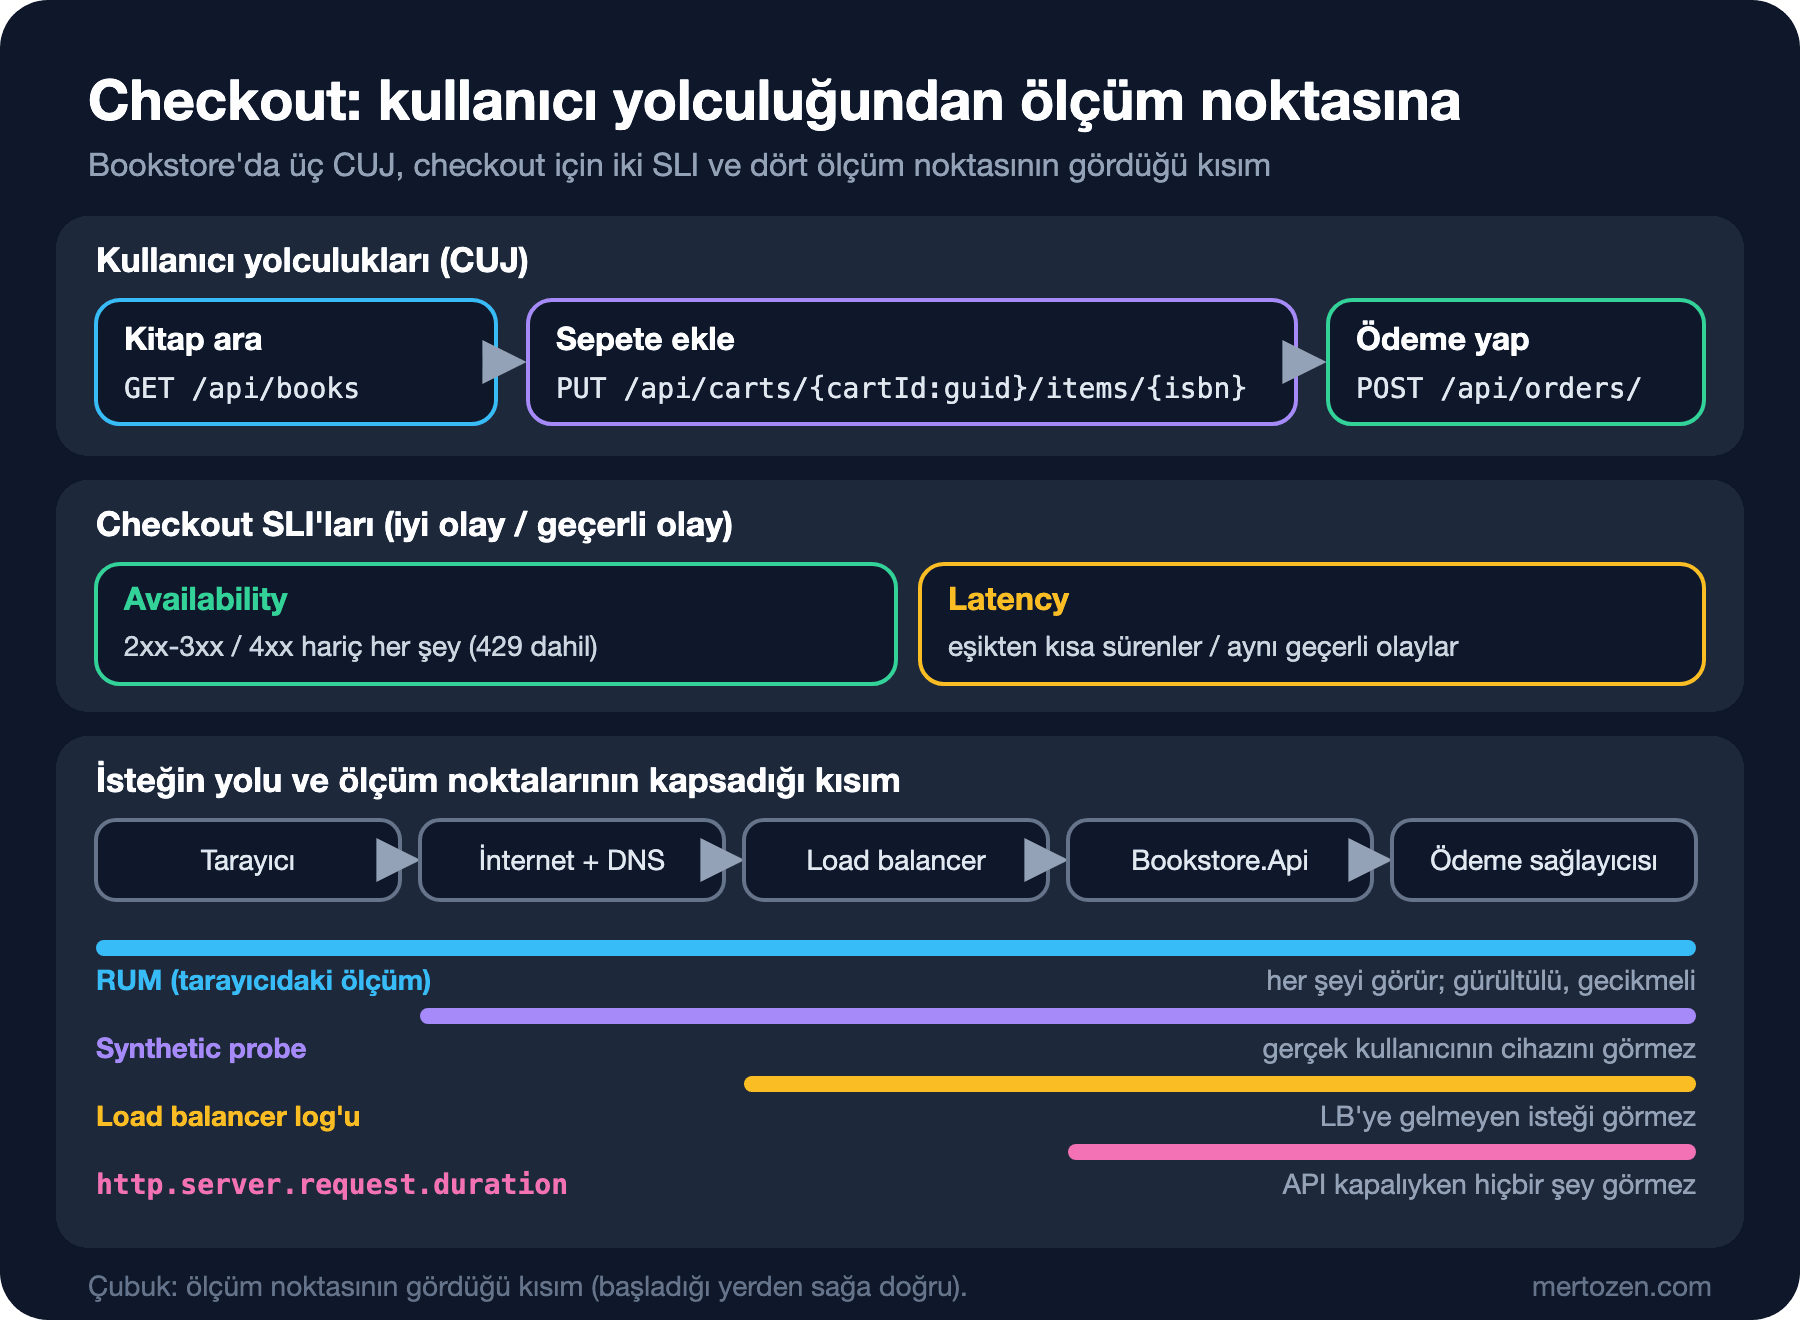
Bir yolculuk birden çok çağrıdan oluşabilir; "kitap ara" arama listesini ve kitap detayını içeriyor. SLI'ı her endpoint için ayrı tanımlamak yerine, yolculuğun en çok önemsenen adımına bağlamak daha anlamlı. Bu yazıda checkout'a, yani POST /api/orders çağrısına odaklanıyoruz: Bookstore'un para kazandığı yer orası ve dış bir bağımlılığa, ödeme sağlayıcısına gidiyor.
SLI Türleri
Yolculuk belli olunca "bu yolculukta kullanıcı neyi kötü deneyim sayar" sorusu SLI türünü seçer:
- Availability: istek başarılı cevaplandı mı? Checkout için ana SLI.
- Latency: cevap yeterince hızlı geldi mi? Ödeme sayfasında 5 saniye bekleyen müşteri sayfayı yeniler ya da vazgeçer.
- Freshness: gösterilen veri ne kadar güncel? Katalogdaki stok bilgisinin depo girişlerinden kaç dakika geride olduğu.
- Correctness: cevap doğru mu? Sepet toplamının satır toplamlarıyla tutması; HTTP 200 dönen yanlış bir toplam availability'yi bozmaz ama müşteriyi kaybettirir.
- Throughput: belli bir sürede ne kadar iş bitti? Kurumsal siparişlerin toplu import'unda saatte işlenen satır sayısı.
Request/response şeklindeki bir API için availability ve latency neredeyse her zaman yeterli başlangıç. Freshness ve correctness genelde ayrı bir ölçüm gerektirir (bir job'un son başarılı çalışma zamanı, örnekleme ile doğrulama) ve bir sonraki adımdır.
SLI = İyi Olay / Geçerli Olay
SLI'ı bir oran olarak tanımlamak işi çok kolaylaştırıyor: iyi olayların sayısı bölü geçerli olayların sayısı. Sonuç 0 ile 1 arasında bir sayı; yüzde 100 her şeyin yolunda olduğu, yüzde 0 hiçbir şeyin çalışmadığı anlamına geliyor. Bütün SLI'lar aynı ölçekte olduğu için hedef koymak ve error budget (hata bütçesi) hesaplamak da aynı formülle yapılıyor.
Request-based SLI her isteği bir olay sayar: "son 30 günde geçerli checkout isteklerinin yüzde kaçı başarılı?" Window-based SLI ise zamanı dilimlere böler ve her dilimi iyi ya da kötü sayar: "5 dakikalık dilimlerin yüzde kaçında p99 800 ms'nin altındaydı?" Veritabanı Performansı ve Scaling serisinin son yazısındaki "Siparişlerim" hedefi bu ikinci türdendi. Window-based SLI trafiğin az olduğu saatlerdeki tek bir yavaş isteği büyütür, yoğun saatlerdeki bin hatayı ise tek bir kötü dilime indirger. Kullanıcının yaşadığını sayan request-based SLI çoğu API için daha dürüst; bu seride onu kullanıyoruz.
Formülün zor tarafı paydada: hangi istek "geçerli"? Kullanıcının hatası olan istekler senin servisinin güvenilirliğini ölçmez. Var olmayan bir ISBN (kitabın uluslararası standart numarası) için dönen 404, validation hatası için dönen 400, yetkisiz istek için dönen 401 doğru cevaplardır. Bunları "kötü" saymak SLI'ı kullanıcı davranışına bağlar; "iyi" saymak ise paydayı şişirir. En temiz yol 4xx'i geçerli olaylardan çıkarmak. Bir istisna var: 429 Too Many Requests. Müşteriyi sen yavaşlatıyorsan bu senin kapasite sorunun; 429 geçerli ve kötü bir olaydır. Health check istekleri de geçerli olay değil: kullanıcı değil load balancer çağırıyor ve neredeyse hiç hata vermiyor.
Bookstore.Api'den Metric'e
ASP.NET Core her isteğin süresini http.server.request.duration histogram'ına yazıyor; route template'i, HTTP method'u ve status code'u etiket olarak taşıyor. Bunu dışarı vermek için OpenTelemetry'nin metric tarafı yeterli. Kurulumun ayrıntıları Observability serisinde; burada yalnız SLI için gereken kısım var:
builder.Services.AddOpenTelemetry()
    .ConfigureResource(resource => resource
        .AddService(serviceName: "bookstore-api", serviceVersion: version)
        .AddAttributes([new("deployment.environment.name", builder.Environment.EnvironmentName.ToLowerInvariant())])
        .AddEnvironmentVariableDetector())
    .WithMetrics(metrics => metrics
        .AddAspNetCoreInstrumentation()
        .AddHttpClientInstrumentation())
    // Metric'lerin nereye gideceğini OTEL_EXPORTER_OTLP_ENDPOINT / _PROTOCOL belirler (burada: Prometheus'un OTLP receiver'ı).
    .UseOtlpExporter();
// Load balancer ve Kubernetes probe'ları için; bir kullanıcı yolculuğu değil, bu yüzden SLI'ların dışında.
app.MapHealthChecks("/health");Prometheus'u OTLP receiver'ı açık başlattık ve API'ye metric'leri oraya push etmesini söyledik. Varsayılan export aralığı 60 saniye; laboratuvarda 15 saniyeye indirdik:
docker run -d --name bookstore-prometheus -p 9090:9090 -v ${PWD}/deploy/prometheus:/etc/prometheus/bookstore:ro prom/prometheus:v3.16.0 --config.file=/etc/prometheus/bookstore/prometheus.yaml --web.enable-otlp-receiver --web.enable-lifecycle$env:OTEL_EXPORTER_OTLP_ENDPOINT = "http://localhost:9090/api/v1/otlp"
$env:OTEL_EXPORTER_OTLP_PROTOCOL = "http/protobuf"
$env:OTEL_METRIC_EXPORT_INTERVAL = "15000"
dotnet run --project src/Bookstore.ApiÖdeme sağlayıcısının yerine geçen tools/Bookstore.FakePaymentProvider varsayılan olarak isteklerin binde birini 503 ile reddediyor, binde ikisini 1,5 saniye bekletiyor; PUT /admin/faults ile bu oranlar çalışırken değiştirilebiliyor. tools/Bookstore.Traffic üç CUJ'u saniyede dört kez çalıştırıyor, her 20 yolculuktan birinde var olmayan bir kitabı istiyor ve beş saniyede bir /health'i çağırıyor. Prometheus'ta checkout'un başarısız bir isteğine ait bucket serisi şöyle görünüyor:
{__name__="http_server_request_duration_seconds_bucket", deployment_environment_name="development", error_type="502", http_request_method="POST", http_response_status_code="502", http_route="/api/orders/", instance="8c0301ff-95fe-4d8f-accd-f6e63843bd9e", job="bookstore-api", le="1", network_protocol_version="1.1", service_version="1.0.0", url_scheme="http"} 1job resource'taki service.name'den, instance ise SDK'nın her process için ürettiği service.instance.id'den geliyor. http_route ham URL değil route template'i; MapGroup("/api/orders") altındaki MapPost("/") yüzünden sonunda bir eğik çizgi var. Sorguda değeri tam olarak böyle yazmak gerekiyor.
SLI'ları recording rule olarak yazdık. Her rule bir sonraki yazıda hedefle karşılaştırılacak bir oran üretiyor:
# Bookstore'un checkout yolculuğunun (POST /api/orders) SLI'ları, ASP.NET Core'un http.server.request.duration'ından.
# SLI = iyi olaylar / geçerli olaylar. 4xx cevaplar istemcinin hatası, geçerli olay değil;
# 429 hariç: müşteriyi biz yavaşlatıyorsak bu bizim hatamız.
groups:
  - name: bookstore-sli
    rules:
      - record: sli:checkout_valid:rate5m
        expr: |
          sum(rate(http_server_request_duration_seconds_count{job="bookstore-api", http_route="/api/orders/",
            http_request_method="POST", http_response_status_code=~"[235]..|429"}[5m]))

      # Availability: bizim tarafımızda hata vermeyen geçerli istekler.
      - record: sli:checkout_available:rate5m
        expr: |
          sum(rate(http_server_request_duration_seconds_count{job="bookstore-api", http_route="/api/orders/",
            http_request_method="POST", http_response_status_code=~"[23].."}[5m]))
      - record: sli:checkout_availability:ratio_rate5m
        expr: sli:checkout_available:rate5m / sli:checkout_valid:rate5m

      # Latency: 1 saniye içinde biten geçerli istekler (le, histogram'ın bucket sınırlarından biri olmalı).
      - record: sli:checkout_fast:rate5m
        expr: |
          sum(rate(http_server_request_duration_seconds_bucket{job="bookstore-api", http_route="/api/orders/",
            http_request_method="POST", http_response_status_code=~"[235]..|429", le="1"}[5m]))
      - record: sli:checkout_latency:ratio_rate5m
        expr: sli:checkout_fast:rate5m / sli:checkout_valid:rate5m
Latency SLI'ında eşik bir bucket sınırı olmak zorunda; ASP.NET Core'un varsayılan sınırları 0,005 ile 10 saniye arasında 14 değer (… 0,5, 0,75, 1, 2,5 …). Histogram "1 saniyenin altında kaç istek var" sorusunu tam cevaplar, "800 ms'nin altında kaç istek var" sorusunu cevaplayamaz. Eşiği seçmek bir sonraki yazının konusu.
4xx'i ve Bütün Endpoint'leri Karıştırmak
Ödeme sağlayıcısının hata oranını dört dakikalığına yüzde 5'e çıkardık (aynı anda isteklerin yüzde 3'ünü 1,5 saniye bekletti) ve aynı pencereyi iki farklı soruyla sorguladık. Önce checkout'un availability'si:
sum(increase(http_server_request_duration_seconds_count{job="bookstore-api", http_route="/api/orders/", http_request_method="POST", http_response_status_code=~"[23].."}[4m]))
/
sum(increase(http_server_request_duration_seconds_count{job="bookstore-api", http_route="/api/orders/", http_request_method="POST", http_response_status_code=~"[235]..|429"}[4m]))

{} 0.9461988304093567
Sonra çoğu ekibin ilk yazdığı sorgu, bütün endpoint'lerde 5xx olmayan isteklerin oranı:
sum(increase(http_server_request_duration_seconds_count{job="bookstore-api", http_response_status_code!~"5.."}[4m]))
/
sum(increase(http_server_request_duration_seconds_count{job="bookstore-api"}[4m]))

{} 0.9895715257311266
Önce Tahmin Et'teki ikinci sorunun cevabı bu: ödeme yapmaya çalışan müşterilerin yüzde 5,4'ü hata aldı, ama "API'nin başarı oranı" yüzde 98,96 gösterdi. Sebep payda: aynı dört dakikada 961 arama, 960 kitap detayı, sepet çağrıları ve 48 health check isteği de sayıldı ve hepsi başarılıydı. Bir yolculuğun hatası, yolculuğa ait olmayan isteklerin arasında eriyor.
4xx'in etkisini kitap detayında gördük. Trafiğin yüzde 5'i var olmayan bir ISBN istiyor. 404'ü kötü olay sayan SLI, hiçbir arıza olmayan 3 dakikalık bir pencerede 0,9500756429652042 döndü; 4xx'i paydadan çıkaran SLI ise 1. İlk SLI'a yüzde 99 hedefi koysaydık, hiçbir şey bozuk değilken error budget her gün tükenirdi.
Ölçüm Noktası: Kim Neyi Göremez?
Aynı SLI farklı yerlerden ölçülebilir ve her yerin bir kör noktası var. Uygulama metric'i (bizim http.server.request.duration) en zengin etiketleri taşıyor ama yalnız Kestrel'e ulaşan istekleri görüyor. Load balancer log'u uygulamanın çöktüğü anı da görür, ama load balancer'a hiç ulaşmayan istekleri (DNS hatası, yanlış sertifika) görmez. Synthetic probe (dışarıdan düzenli aralıkla gönderilen yapay istek) API kapalıyken de çalışır, ama gerçek kullanıcının cihazını ve gerçek veri çeşitliliğini taşımaz. RUM (Real User Monitoring; ölçümün kullanıcının tarayıcısında yapılması) en çok şeyi görür, ama en gürültülü olanıdır ve verisi geç gelir.
Önce Tahmin Et'teki ilk soruyu bu yüzden sorduk. API'yi 20:20:24'te durdurup 20:21:24'te tekrar başlattık. Trafik aracının o dakikaki satırı:
20:20 UTC book=240 cart=228 checkout=228 health=12 search=240 5xx=0 no-answer=0 404=12 slowest-checkout=1512ms
20:21 UTC book=240 health=12 search=240 5xx=0 no-answer=491 404=0 slowest-checkout=0ms
20:22 UTC book=240 cart=225 checkout=225 health=12 search=240 5xx=0 no-answer=7 404=12 slowest-checkout=1517ms
Recording rule'un aynı dakikalardaki değerleri (her satır 30 saniye; zamanlar UTC (eşgüdümlü evrensel saat)):
20:19:54 0.9538
20:20:24 0.9575
20:20:54 0.9587
20:21:24 0.9602
20:21:54 0.9647
20:22:24 0.9757
Kapalı geçen dakikada SLI düşmedi, tersine yükseldi; çünkü 5 dakikalık pencereden ödeme hatalarının olduğu dakikalar çıkıyordu. Cevap alamayan istekler uygulamaya hiç ulaşmadığı için ne payda ne pay oldu. Tek iz, geçerli olay hızındaki düşüş: sli:checkout_valid:rate5m saniyede 3,8'den 2,77'ye indi. Uygulama metric'i bir SLI için iyi bir başlangıç, ama tek başına "servis kapalı" durumunu göremez. Bunu kapatmak için ya load balancer metric'ini kullanırsın ya da checkout'u dışarıdan çağıran bir synthetic probe eklersin; Observability serisinin ilerideki alerting yazısı blackbox probe'larını bu iş için kuruyor.
Üretimde Dikkat
Birden çok instance varken önce topla, sonra böl. Rule'larda sum(rate(…)) bölmeden önce yapılıyor; her instance'ın kendi oranını hesaplayıp ortalamasını almak, az trafik alan instance'a gereğinden fazla ağırlık verir.
Restart serileri değiştirir. Yukarıdaki instance etiketi her process başlangıcında yeni bir değer alıyor; deploy'dan sonra eski seriler durur, yenileri başlar. rate ve sum bunu doğru karşılar, ama bir dashboard'da instance'a göre gruplanmış eski seriler bir süre "takılı" görünür.
Export aralığını bil. OTLP exporter'ın varsayılanı 60 saniye. 5 dakikalık bir pencerede bu yalnız beş örnek demek; kısa bir kesinti bir örnek kadar gecikmeyle görünür. Scrape kullanıyorsan aynı şey scrape aralığı için geçerli.
SLI tanımını kodla birlikte değiştir. Route template'i değiştiren bir refactor (/api/orders/ yerine /api/v2/orders) SLI'ı sessizce sıfır trafiğe düşürür. Rule dosyası repoda, API ile aynı pull request'te güncellenmeli.
Sık Düşülen Tuzaklar
Ortalama latency'yi SLI yapmak. Arıza penceresinde checkout'un ortalama süresi 0,117 saniye çıktı, arızasız pencerede 0,098 saniye: neredeyse fark yok. Aynı pencerede isteklerin yüzde 98,1'i 1 saniyenin altındaydı (arızasız pencerede yüzde 99,84) ve p99 0,247 saniyeden 1,698 saniyeye çıktı. Ortalama, yavaş kalan yüzde 2'yi hızlı yüzde 98'in arasında gizledi.
CPU'yu SLI sanmak. CPU yüzde 90'dayken kullanıcı hiçbir şey hissetmeyebilir, yüzde 10'dayken ödeme sağlayıcısı yüzünden her checkout hata verebilir. CPU bir neden sinyali; SLI belirtiyi, yani kullanıcının yaşadığını ölçmeli.
Cardinality patlaması. Bizde bucket serilerinin toplamı 120: altı route template, birkaç status code, 15 bucket. Etiket ham URL olsaydı her sepet ID'si (/api/carts/0193…/items/…) yeni bir seri açardı ve birkaç saatte yüz binlerce seriye ulaşırdı. ASP.NET Core route template'i kullandığı için bu varsayılan olarak sorun değil; kendi metric'ine etiket eklerken aynı kuralı uygula.
Paydayı unutmak. "Son 5 dakikada 3 hata" bir SLI değil; 3 hata saniyede 50 istekte önemsiz, dakikada 5 istekte felaket. Her zaman oran.
Küçük Bir Deneme
★☆☆ "Kitap ara" yolculuğu için GET /api/books üzerinde bir availability SLI'ı recording rule'u yaz. Trafik çalışırken sağlayıcının hata oranını PUT /admin/faults ile artır; arama SLI'ı neden hiç etkilenmiyor?
★★☆ Checkout için ikinci bir latency SLI'ı yaz: eşik 0,5 saniye. Sağlayıcının slowRatio değerini 0,05 ve slowDelayMs'yi 600 yap; iki eşikteki SLI'ların farkını açıkla.
★★★ API'nin önüne bir synthetic probe koy: dakikada bir sepet açıp sipariş veren küçük bir job (her denemenin başarısını probe_success gibi bir gauge'a yazsın). API'yi tekrar 60 saniye durdur ve probe'un o dakikayı uygulama metric'inin aksine yakaladığını göster.
Elimizde artık checkout için ölçülebilir iki SLI var. Bir sonraki yazıda bunlara hedef koyuyoruz: SLA (Service Level Agreement; müşteriye verilen, yaptırımı olan söz), SLO ve SLI farkı, nine'ların matematiği, 800 ms eşiği için histogram'a bucket eklemek ve error budget bittiğinde ne olacağını önceden yazan bir policy.