

Incident Management: Severity, Incident Commander, İletişim ve Önce Mitigation

Incident yönetimi, arızayı tek bir karar noktasından (incident commander) yönetmek ve sebebi aramadan önce müşterinin yaşadığı etkiyi durdurmaktır; severity tanımları, roller ve kollar önceden hazırlanır. Bookstore'a restart gerektirmeyen bir ödeme timeout'u ve kill switch ekliyor, ödeme sağlayıcısının önce yavaşlayıp sonra çöktüğü bir tabletop exercise'ı laboratuvarda oynuyor ve her kararın etkisini ölçüyoruz.
Sürüm notu: Bu yazıdaki örnekler .NET 10, Prometheus 3.16.0 ve SQL Server 2025 ile laboratuvarda denenmiştir; komutlar bash ile çalıştırıldı. Tabletop exercise'taki insan kararları senaryoya önceden yazıldı; status page ve sohbet aracı kullanılmadı.
Önce Tahmin Et
Saat 22:10, UTC (eşgüdümlü evrensel saat). Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) ödeme sağlayıcısı her isteğe 4 saniyede cevap vermeye başladı; Bookstore.Api ise ödeme için en fazla 3 saniye bekliyor. Sonuç: her checkout 3 saniye sonra 502 alıyor, sipariş iptal ediliyor ve müşterinin sepeti siliniyor. Nöbetçi Emre'nin elinde dört seçenek var: sağlayıcının düzelmesini beklemek, API'yi restart etmek, ödeme timeout'unu yükseltmek, checkout'u geçici olarak kapatmak. Hangisini önce yaparsın, hangisini asla yapmazsın? İkinci soru: bu bir incident mi, öyleyse severity'si ne? Üçüncüsü: sağlayıcı birkaç dakika sonra tamamen çökerse (her isteğe 503) kararın değişir mi? Cevaplar yazının ortasındaki tabletop exercise'ta.
Incident'ı İlan Etmek
Bir önceki yazıdaki runbook bir alert'in ilk beş dakikasını kapsıyordu: tek kişi, tek alert, bilinen sebepler. Incident ise tek kişiyi aşan, koordinasyon isteyen bir arıza. Incident management bunun için önceden kararlaştırılmış kurallar: amacı teknik sorunu çözmek değil, çözen insanların birbirinin işini bozmamasını, kimsenin bilgisiz kalmamasını ve kararların tek bir yerden çıkmasını sağlamak.
İlk karar, olayın incident olup olmadığı. Google'ın SRE (Site Reliability Engineering; güvenilirliği yazılım mühendisliğiyle yönetme disiplini) kitabının "Managing Incidents" bölümü bunun için üç soru öneriyor: sorunu çözmek için ikinci bir ekip gerekiyor mu, kesinti müşteriye görünüyor mu, bir saatlik yoğun incelemeye rağmen sorun çözülmedi mi? Birine evet cevabı yeterli. Aynı bölüm erken ilan etmeyi açıkça tavsiye ediyor: incident'ı ilan edip basit bir düzeltmeyle kapatmak, saatler sonra sıfırdan bir süreç kurmaktan iyidir.
Bookstore'un kuralı bu üç sorunun ekibe uyarlanmış hâli ve repoda docs/incidents/README.md dosyasında duruyor:
## Declare early
Declare an incident (post in `#incident` and start a document from `TEMPLATE.md`) if any of these is true:
- Customers can see the problem (checkout, search or the institutional portal fails or is clearly slow).
- A second person or another team is needed to fix it.
- The on-call has not found a cause or a mitigation in 30 minutes.
- A runbook says so (e.g. checkout error ratio above 50 % for 15 minutes).

Declaring costs one message. Closing a small incident after ten minutes is fine; a late declaration is not.
Eşiğin düşük olması bilinçli. İlan etmenin maliyeti bir mesaj; geç ilan etmenin maliyeti ise kimsenin müşteriye haber vermediği, iki kişinin aynı anda farklı şeyleri değiştirdiği ve sonradan kimsenin ne zaman ne yapıldığını hatırlamadığı bir gece.
Severity Seviyeleri
Severity (bir incident'ın ciddiyet derecesi), kaç kişinin çağrılacağını, müşteriye ne zaman haber verileceğini ve postmortem gerekip gerekmediğini belirliyor. Ölçek şirketten şirkete değişiyor; çoğu şirket SEV (severity) ya da P (priority, öncelik) harflerine bir numara ekliyor ve küçük numara daha ağır demek. PagerDuty'nin açık incident response dokümanı beş seviye tanımlıyor. Önemli olan her seviyenin kullanıcı etkisiyle somut tanımlanması. "Kritik sorun" tanımı gece 02:00'de işe yaramaz; "checkout'ların yarısından fazlası 5 dakikadır başarısız" yarar. Bookstore dört seviye kullanıyor: SEV1 (en ağır), SEV2 (ağır), SEV3 (küçük etki) ve SEV4 (henüz müşteri etkisi yok).
| Seviye | Bookstore için anlamı | Örnek | Müdahale |
|---|---|---|---|
| SEV1 | Müşterilerin çoğu satın alamıyor ya da veri veya para yanlış | checkout'ların yüzde 50'den fazlası 5 dakikadır başarısız; iki kez çekilen ödeme | hemen IC (incident'ı yöneten kişi), herkes çağrılır, status page 15 dakikada, sonra 30 dakikada bir güncelleme |
| SEV2 | Kritik bir yolculuk müşterilerin bir kısmı için bozuk | checkout'ların yüzde 10'undan fazlası 15 dakikadır başarısız; kurumsal portal kapalı | hemen IC, status page 30 dakikada, sonra 30 dakikada bir güncelleme |
| SEV3 | Küçük etki ya da geçici bir çözüm var | bir kategoride arama yavaş; back office raporu çalışmıyor | nöbetçi çözer, IC gerekmez |
| SEV4 | Henüz müşteri etkisi yok | disk yavaşça doluyor; sertifikanın bitmesine 10 gün var | ticket |
İki kural tablo kadar önemli. Birincisi, emin değilsen yüksek olanı seç: PagerDuty'nin dokümanı da SEV2 mi SEV1 mi karar veremediğinde yükseğini almayı söylüyor. İkincisi, incident sırasında severity tartışılmaz; tartışma postmortem'in işi. Önce Tahmin Et'teki ikinci sorunun cevabı da buradan çıkıyor: checkout'ların tamamı başarısız ve müşteri bunu görüyor, yani SEV1.
Roller: Incident Commander ve Diğerleri
Incident'ın en önemli rolü incident commander (IC): incident'ı yöneten ve son kararı veren kişi. Google'ın incident yönetimi, itfaiyecilerin büyük yangınlar için geliştirdiği ICS (Incident Command System; olay yerinde tek komuta zinciri kuran yönetim sistemi) modelinden geliyor ve bu modelin temel fikri tek karar noktası. IC komut çalıştırmaz, dashboard'a bakmaz; işi karar vermek, işleri isimle dağıtmak, sıradaki güncellemenin saatini belirlemek ve incident'ın bittiğini ilan etmek. PagerDuty'nin IC eğitim dokümanından iki pratik öneri: işi "biri şuna bakabilir mi?" diye değil, "Ayşe, 10 dakika içinde sağlayıcının status sayfasına bak ve bana dön" diye isimle ve süreyle ver; karar alırken "herkes katılıyor mu?" yerine "güçlü bir itirazı olan var mı?" diye sor.
Diğer roller şunlar: ops lead (sistemi inceleyen ve production'da değişiklik yapan tek kişi ya da grup), comms lead (status page'i, müşteri hizmetlerini ve yönetimi bilgilendiren kişi) ve scribe (zaman çizelgesini tutan kişi).
Üç kişilik Bookstore ekibinde dört ayrı kişi yok. Rollerin birleşmesi normal, ama hangi şapkayı kimin taktığı açık olmalı. Bookstore'da page'i alan nöbetçi ops lead oluyor; ikinci gelen kişi IC oluyor ve zaman çizelgesini de o tutuyor; Selin (Product Owner) comms lead. IC rolünün devri de sesli yapılıyor: "IC'yi Ayşe'ye devrediyorum." "IC benim." Sessiz devir, iki kişinin kendini IC sandığı ya da kimsenin IC olmadığı bir çağrı demek.
Önce Mitigation, Sonra Root Cause
Incident sırasında amaç sebebi bulmak değil, müşterinin yaşadığı etkiyi durdurmak. SRE kitabının "Managing Incidents" bölümü önceliği tek cümlede veriyor: "Stop the bleeding, restore service, and preserve the evidence for root-causing." Yani önce kanamayı durdur, servisi geri getir, root cause (bir arızanın asıl sebebi) için kanıtları koru. Google'ın SRE Workbook'u bu tür hızlı müdahalelere generic mitigation diyor: sebep tam anlaşılmadan uygulanabilen, kaba ama hızlı adımlar. Rollback, trafiği başka bölgeye çekmek, kapasite eklemek ve kill switch (bir özelliği deploy olmadan anında kapatan ayar) bunlara örnek.
Generic mitigation'ın şartı, incident'tan önce hazırlanmış olması; gece yarısı yeni bir deploy hazırlamak mitigation değil, ikinci bir risk. Bookstore'da ödeme tarafı için böyle bir kol yoktu: serinin ikinci yazısında yazdığımız Payments module'ünde timeout HttpClient.Timeout ile uygulama açılırken bir kez ayarlanıyordu ve checkout'u kapatmanın tek yolu bir deploy'du. Bu yazıda iki kol (lever) ekliyoruz. İkisi de restart gerektirmeden, uygulamanın yanındaki küçük bir dosyadan okunuyor:
// Bookstore.Api/Program.cs
WebApplicationBuilder builder = WebApplication.CreateBuilder(args);
// Incident kolları (kill switch, ödeme timeout'u) değişiklikleri izlenen küçük ve ayrı bir dosyada.
// En son eklendiği için appsettings*.json ve environment variable'ların önüne geçer. Bkz. docs/incidents/levers.md.
builder.Configuration.AddJsonFile(builder.Configuration["SwitchesFile"] ?? "switches.json", optional: true, reloadOnChange: true);
// Bookstore.Api/Payments/PaymentsOptions.cs
// "Payments" section'ına bağlanır. TimeoutSeconds ve CheckoutEnabled incident kollarıdır: her checkout'ta
// IOptionsMonitor üzerinden okunur, böylece switches.json'daki değişiklik restart ya da deploy olmadan geçerli olur.
public sealed class PaymentsOptions
{
public const string SectionName = "Payments";
[Required]
public Uri? BaseAddress { get; set; }
// Bir yetkilendirmenin en fazla ne kadar sürebileceği; aşılırsa checkout vazgeçer ve 502 döner.
[Range(1, 30)]
public int TimeoutSeconds { get; set; } = 3;
// Kill switch: false, checkout'u sipariş oluşmadan durdurur (503 + Retry-After, sepet korunur).
public bool CheckoutEnabled { get; set; } = true;
}Timeout artık HttpClient'ın değil, her çağrının kendi CancellationTokenSource'u. IOptionsMonitor dosya değişince yeni değeri veriyor ve bir sonraki çağrı onu kullanıyor:
internal sealed class PaymentGatewayClient(HttpClient http, IOptionsMonitor<PaymentsOptions> options) : IPaymentGateway
{
    public async Task<PaymentResult> AuthorizeAsync(PaymentRequest request, CancellationToken ct)
    {
        // Her çağrıda okunur: incident commander timeout'u switches.json'dan restart olmadan yükseltebilir.
        using CancellationTokenSource timeout = CancellationTokenSource.CreateLinkedTokenSource(ct);
        timeout.CancelAfter(TimeSpan.FromSeconds(options.CurrentValue.TimeoutSeconds));

        using HttpRequestMessage message = new(HttpMethod.Post, "/v1/charges")
        {
            Content = JsonContent.Create(new { request.OrderId, request.Amount, request.Currency })
        };
        message.Headers.Add("Idempotency-Key", $"order-{request.OrderId}");

        using HttpResponseMessage response = await http.SendAsync(message, timeout.Token);
        response.EnsureSuccessStatusCode();
        return await response.Content.ReadFromJsonAsync<PaymentResult>(timeout.Token)
            ?? throw new InvalidOperationException("The payment provider returned an empty body.");
    }
}
Kill switch ise checkout'un en başında, veritabanına hiçbir şey yazılmadan önce kontrol ediliyor. Yeri bilinçli: mevcut akışta sipariş önce PaymentPending olarak kaydediliyor ve sepet siliniyor, ödeme başarısız olursa sipariş iptal ediliyor. Yani her başarısız ödeme, müşterinin sepetini de kaybetmesi demek. Kill switch açıkken sipariş hiç oluşmuyor, stok ayrılmıyor, sepet yerinde kalıyor ve müşteri 3 saniye beklemeden net bir mesaj alıyor:
public async Task<PlaceOrderOutcome> PlaceOrderAsync(PlaceOrderRequest request, CancellationToken ct)
{
    // Kill switch, hiçbir şey yazılmadan önce kontrol edilir: sipariş yok, stok ayrılmaz, sepet olduğu gibi kalır.
    if (!paymentOptions.CurrentValue.CheckoutEnabled)
    {
        return new PlaceOrderOutcome.CheckoutPaused();
    }
    ...
}

// OrderingModule.PlaceOrder
PlaceOrderOutcome.CheckoutPaused =>
    TypedResults.Problem("Checkout is paused while the payment provider has problems. Your cart is kept; please try again in a few minutes.",
        statusCode: StatusCodes.Status503ServiceUnavailable),
Endpoint aynı durumda Retry-After: 300 header'ını da ekliyor. Bu 503 de SLI'da (Service Level Indicator; servisin kullanıcı açısından ne kadar iyi çalıştığını ölçen oran) başarısız sayılıyor; kill switch error budget'ı kurtarmıyor, müşterinin kaybını küçültüyor. Yeni integration testi bu davranışı sabitliyor (503, Retry-After, sepet ve stok yerinde); testler 13'te 13 geçti. Kill switch'in deploy stratejisindeki yeri Deployment Stratejileri serisinin "Rollback mı Roll Forward mı?" yazısında, doğru timeout değerini seçmek System Design serisinin reliability pattern'leri yazısında; burada yalnız incident sırasında elde hazır olmalarıyla ilgileniyoruz.
Tabletop Exercise: Ödeme Sağlayıcısı Yavaşladığında
Tabletop exercise, ekibin bir arıza senaryosunu masa başında adım adım oynaması: biri senaryoyu anlatır, diğerleri rollerine göre "şimdi ne yaparım?" sorusunu cevaplar. Biz senaryoyu laboratuvarda gerçek sistem üzerinde oynadık: sahte ödeme sağlayıcısı, dakikada yaklaşık 228 checkout üreten trafik aracı (saniyede 4 kullanıcı yolculuğu), Prometheus ve önceki yazıların SLO (Service Level Objective; servisin hedeflenen güvenilirlik seviyesi) alert'leri. Rolleri Ayşe (IC), Emre (ops lead) ve Selin (comms lead) üstlendi. İnsan kararları senaryoya önceden yazıldı ve sabit dakikalarda uygulandı; ölçülen her şey gerçek koşudan. Senaryonun adımları ve kararlar şunlardı (API'yi switches.json'un yolunu veren SwitchesFile ayarıyla başlattık):
# 22:09:47 senaryo: sağlayıcı her ödemeye 4 saniyede cevap veriyor (Bookstore'un ödeme timeout'u 3 saniye)
curl -X PUT http://localhost:5090/admin/faults -H "content-type: application/json" -d '{"slowRatio":1,"slowDelayMs":4000}'
# 22:14:47 IC kararı: sağlayıcı yavaş ama cevap veriyor, timeout'u 6 saniyeye çıkar
echo '{ "Payments": { "TimeoutSeconds": 6, "CheckoutEnabled": true } }' > switches.json
# 22:19:47 senaryo: sağlayıcı her ödemeye 503 dönüyor
curl -X PUT http://localhost:5090/admin/faults -H "content-type: application/json" -d '{"failRatio":1}'
# 22:21:47 IC kararı: timeout bir 503'ü düzeltemez, kill switch
echo '{ "Payments": { "TimeoutSeconds": 6, "CheckoutEnabled": false } }' > switches.json
# 22:25:47 senaryo: sağlayıcı düzeldi
curl -X PUT http://localhost:5090/admin/faults -H "content-type: application/json" -d '{"failRatio":0.001,"slowRatio":0.002,"slowDelayMs":1500}'
# 22:27:47 kapanış: kollar varsayılana döner
echo '{ "Payments": { "TimeoutSeconds": 3, "CheckoutEnabled": true } }' > switches.json
Trafik aracının dakikalık özetinden ilgili satırlar (arama, kitap, sepet ve health sütunlarını çıkardık; her satır, yazıldığı saatten önceki bir dakikayı özetliyor):
22:09 UTC checkout=228 5xx=0 slowest-checkout=158ms
22:10 UTC checkout=216 5xx=216 slowest-checkout=3106ms
22:14 UTC checkout=228 5xx=228 slowest-checkout=3032ms
22:15 UTC checkout=225 5xx=12 slowest-checkout=4032ms
22:16 UTC checkout=227 5xx=0 slowest-checkout=4067ms
22:19 UTC checkout=228 5xx=0 slowest-checkout=4038ms
22:20 UTC checkout=244 5xx=228 slowest-checkout=4021ms
22:21 UTC checkout=228 5xx=228 slowest-checkout=34ms
22:22 UTC checkout=228 5xx=228 slowest-checkout=7ms
22:27 UTC checkout=228 5xx=228 slowest-checkout=1ms
22:28 UTC checkout=228 5xx=3 slowest-checkout=1631ms
22:29 UTC checkout=228 5xx=1 slowest-checkout=154ms
Siparişlerin durumunu da veritabanından yarım dakikada bir okuduk; özet satırlar:
SELECT Status, COUNT(*) FROM ordering.Orders GROUP BY Status;  SELECT COUNT(*) FROM ordering.Carts;

22:09:04  Cancelled 1     Paid 748                    carts 0
22:15:07  Cancelled 1141  Paid 973   PaymentPending 15  carts 0
22:19:09  Cancelled 1142  Paid 1893  PaymentPending 15  carts 0
22:22:11  Cancelled 1599  Paid 2050                   carts 92
22:27:13  Cancelled 1599  Paid 2050                   carts 1241
22:32:16  Cancelled 1600  Paid 3071                   carts 1370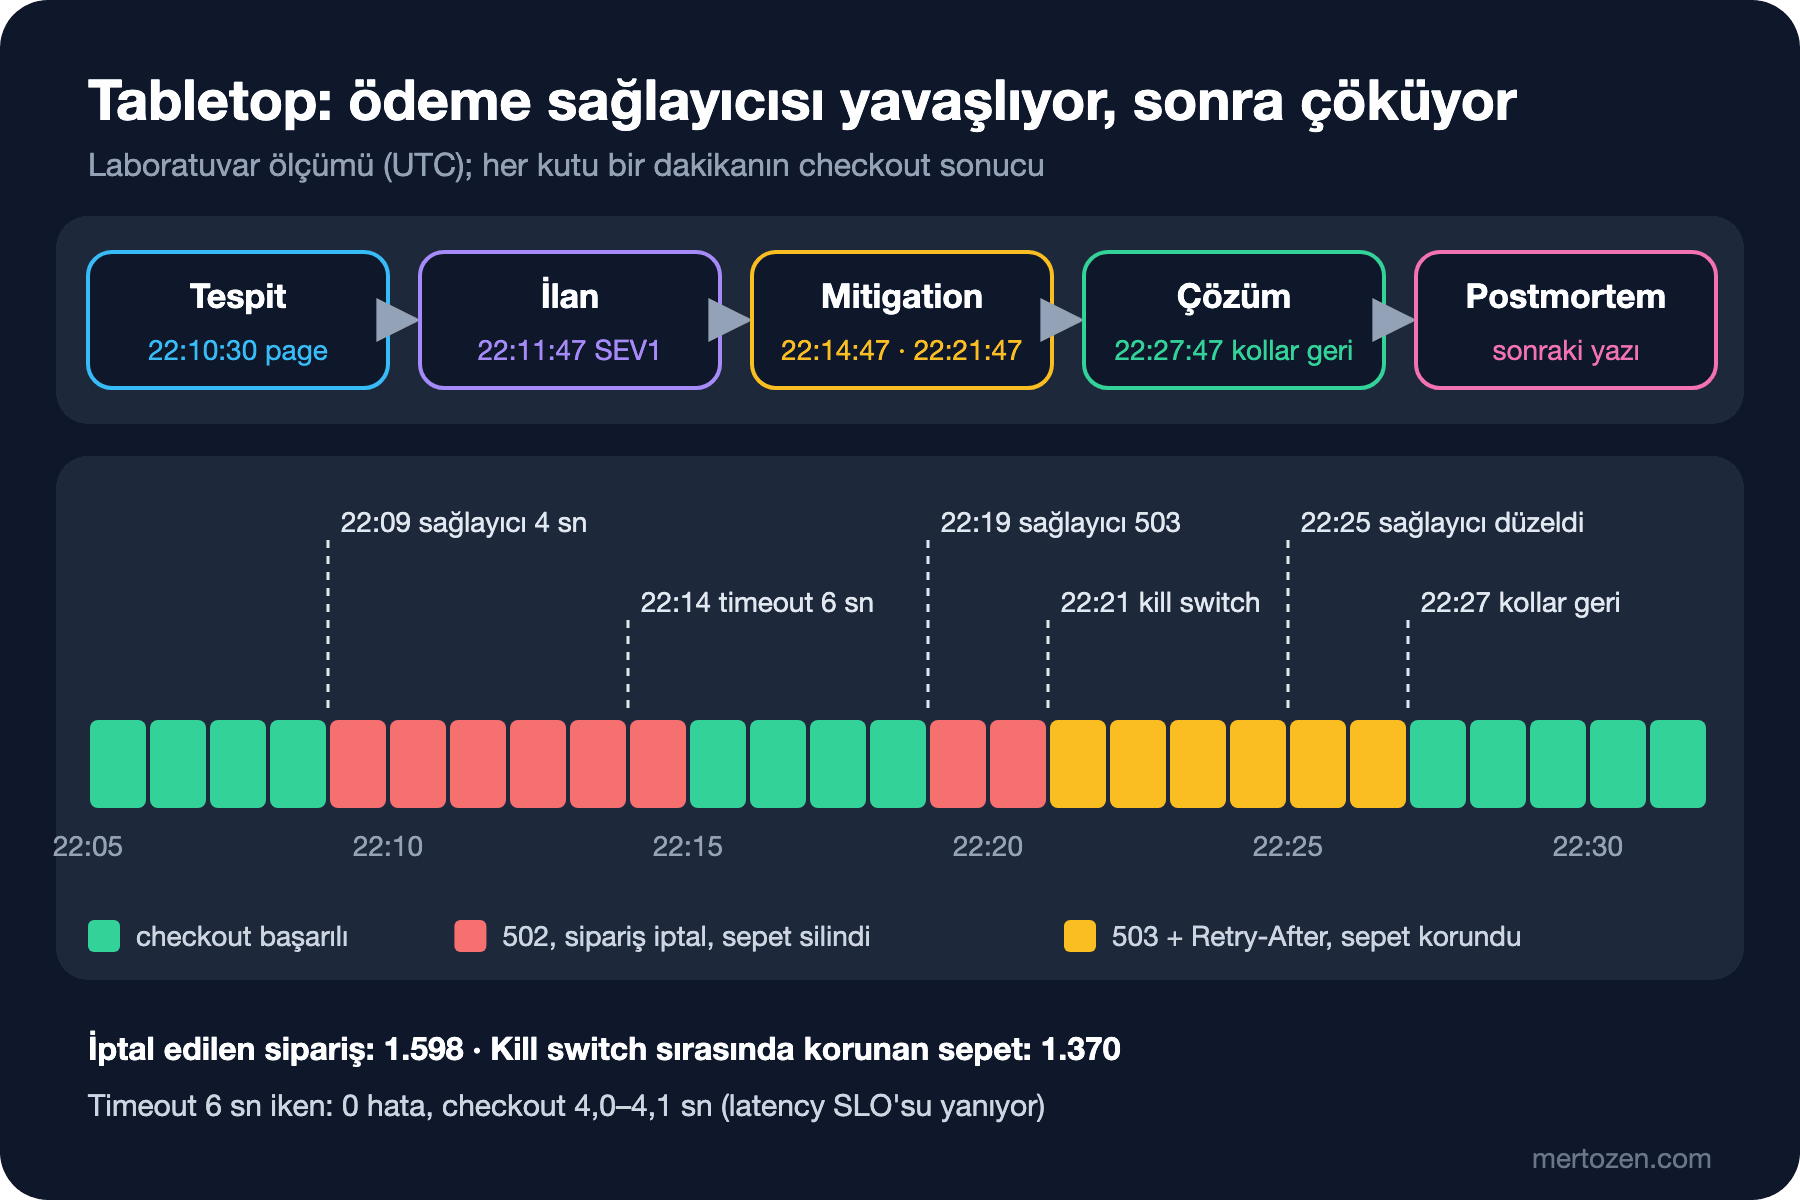
Sayılar Önce Tahmin Et'in cevaplarını veriyor. Sağlayıcı yavaşken (22:09:47–22:14:47) bütün checkout'lar yaklaşık 3,1 saniyede 502 aldı ve beş dakikada 1.140 sipariş iptal edildi; her biri bir müşterinin silinen sepeti. Timeout'u 6 saniyeye çıkaran kol, bir dakika içinde hataları sıfırladı: 22:16'dan sonra 5xx yok, en yavaş checkout 4,07 saniye. Restart gerekmedi. Bedeli latency SLO'su: 800 ms hedefli SLO için bu beş dakikada her checkout "yavaş" sayıldı. Bu bilinçli bir takas: müşterinin 4 saniye bekleyip ödemesini yapması, 3 saniye bekleyip sepetini kaybetmesinden iyidir.
Sağlayıcı 503 dönmeye başlayınca (22:19:47) timeout kolunun anlamı kalmadı: hatalar artık milisaniyeler içinde geliyordu ve iki dakikada 457 sipariş daha iptal edildi. Kill switch açıldıktan sonra checkout 1–7 ms içinde 503 döndü, iptal edilen sipariş sayısı 1.599'da durdu ve sepetler yerinde kaldı; kill switch kapanana kadar 1.370 sepet korundu. Bir checkout'un kill switch altındaki cevabı:
HTTP/1.1 503 Service Unavailable
Content-Type: application/problem+json
Retry-After: 300

{"type":"https://tools.ietf.org/html/rfc9110#section-15.6.4","title":"Service Unavailable","status":503,"detail":"Checkout is paused while the payment provider has problems. Your cart is kept; please try again in a few minutes.","traceId":"00-1ee648b3ee0a7e2034d3ac92b73879c0-4bf0f99da7ab89cc-02"}
ALERTS serisinden okunan aralıklar: 6 saatlik page 22:10:30'dan 22:33:00'a, 1 saatlik page 22:10:45–22:19:30 ve 22:20:45–22:32:30. Page'in 43 saniyede çalması laboratuvarın kısa pencerelerinden (serinin dördüncü yazısında açıkladık); production'da birkaç dakika sürer. Asıl gözlem şu: kill switch açıkken page susmadı, çünkü 503 de SLI'da başarısız bir checkout. Page "mitigation işe yarıyor mu?" sorusunu cevaplamıyor; IC bunun için iptal edilen sipariş sayısına ve 502 ile 503'ün oranına bakmalı.
Tabletop'un bulduğu en önemli eksik planda yoktu. Sağlayıcı 22:25:47'de düzeldi ama biz bunu görmedik: kill switch açıkken Bookstore.Api sağlayıcıyı hiç çağırmıyor, dolayısıyla runbook'un 3. adımındaki sorgu boş dönüyor. 22:21:40–22:25:40 arasında sağlayıcıya giden çağrı sayısı:
sum by (server_address, http_response_status_code, error_type) (increase(http_client_request_duration_seconds_count{job="bookstore-api", server_address="127.0.0.1"}[4m]))

{http_response_status_code="200", server_address="127.0.0.1"} 0
{error_type="503", http_response_status_code="503", server_address="127.0.0.1"} 0
{error_type="System.Threading.Tasks.TaskCanceledException", server_address="127.0.0.1"} 0
Kollar senaryodaki iki dakikalık gecikmeyle 22:27:47'de geri alındı; bu iki dakikada 456 checkout, sağlayıcı sağlıklıyken 503 aldı. Kill switch kendi kör noktasını yaratıyor: kapattığın bağımlılığın düzeldiğini görmek için ayrı bir sinyal (sağlayıcının status sayfası, ya da kill switch açıkken de çalışan küçük bir synthetic ödeme denemesi) gerekiyor. Bu, bir sonraki yazıdaki postmortem'in action item'larından biri olacak.
Scribe'ın zaman çizelgesi repoda docs/incidents/2026-11-14-tabletop-payment-provider.md olarak duruyor. Bir bölümü:
| Time | Who | What |
|---|---|---|
| 22:09:47 | scenario | Provider answers every charge after 4 s; our payment timeout is 3 s. Every checkout gets 502 after about 3 s. |
| 22:10:30 | Prometheus | CheckoutErrorBudgetBurn (6h, page) fires; 1h page at 22:10:45. |
| 22:11:47 | Ayse | Incident declared, SEV1 (all checkouts fail). Ayse IC, Emre ops lead, Selin comms lead. |
| 22:12 | Emre | Runbook step 3: provider calls end in TaskCanceledException, no status code. Provider is slow, not down. |
| 22:14:47 | Emre | Lever: Payments:TimeoutSeconds 3 → 6. |
| 22:21:47 | Emre | Lever: Payments:CheckoutEnabled → false (decided by Ayse: raising the timeout cannot help a 503). |
| 22:25:47 | scenario | Provider healthy again. We did not see it: with the kill switch on, nothing calls the provider. |
| 22:27:47 | Emre | Levers back to default (3 s, enabled). 456 checkouts got 503 while the provider was already healthy. |
Her satır bir olgu ya da bir karar, saati UTC ve sahibi belli; "sağlayıcıda sorun var gibi" bir satır değil. Önce Tahmin Et'teki ilk sorunun cevabı da burada: önce timeout'u yükselt (sağlayıcı yavaş ama cevap veriyor), restart'ı hiç yapma; sağlayıcı tamamen çöktüğünde kill switch'e geç. Severity SEV1.
İletişim: Tek Kanal, Status Page ve Sıradaki Güncelleme
İçeride kural basit: bir incident, bir kanal. Bookstore'da her incident için #incident-<tarih>-<konu> adında bir sohbet kanalı ve docs/incidents/TEMPLATE.md'den kopyalanan bir doküman açılıyor. SRE kitabı bu dokümanı "living incident document" (incident boyunca birden fazla kişinin aynı anda güncellediği canlı doküman) olarak anlatıyor; dağınık olabilir ama işe yarar olmalı ve postmortem'in ham maddesi oluyor.
# Incident: <short title>

Status: Investigating | Mitigated | Resolved · Severity: SEV<n> · Started: <UTC> · Declared: <UTC>
IC: <name> · Ops lead: <name> · Comms lead: <name> · Scribe: <name>
Channel: #incident-<yyyymmdd>-<topic> · Status page: <link>

## Now (the IC keeps this up to date)
- Impact: who cannot do what, since when, how many.
- Current hypothesis and what is being tried.
- Next update: <UTC>.

## Timeline (UTC, one line per fact or decision)
| Time | Who | What |
|---|---|---|

## Levers changed (must be reverted before close)
| Time | Lever | From → To | Reverted at |
|---|---|---|---|

## After
- Postmortem needed? (SEV1/SEV2, or more than 20 % of a 30-day error budget) Owner and date:
"Levers changed" tablosu tabletop'tan sonra eklendi: incident boyunca değiştirilen her kol, kapanıştan önce geri alınmalı ve geri alındığı saat yazılmalı. Unutulan bir kill switch, incident bittikten sonra da satışları durdurmaya devam eder.
Dışarıya iletişimin iki kuralı var. Birincisi, kesin olmayan bir şeyi söz olarak verme; "30 dakikada düzelecek" yerine "bir sonraki güncelleme 22:45'te" yaz. Atlassian'ın Statuspage şablonları da her mesajı (Investigating, Identified, Monitoring, Resolved) bir sonraki güncellemenin zamanıyla bitiriyor. İkincisi, sıklık severity'ye bağlı ve önceden yazılı: Bookstore'da SEV1'de status page 15 dakika içinde, sonra her 30 dakikada bir güncelleniyor; söyleyecek yeni bir şey olmasa da. Status page'in kendisinin de Bookstore'un altyapısından bağımsız bir yerde durması gerekiyor; serinin sekizinci yazısında Cloudflare ve Google Cloud vakalarında bunun neden önemli olduğunu göreceğiz.
Üretimde Dikkat
Kollar da kod gibi test edilir. Bizimkiler integration testi ve tabletop'ta denendi; docs/incidents/levers.md her kolun son denendiği tarihi yazıyor. Denenmemiş bir kol, ikinci bir incident başlatabilir.
Kolların kendisi de bir config değişikliği. switches.json bütün instance'lara aynı anda gidiyor ve yanlış bir değer hepsini aynı anda etkiler. Dosya bozuk ya da geçersiz olduğunda ne olduğunu serinin sekizinci yazısında ölçüyoruz.
IC'lik bir beceri ve pratik ister. Ekipte herkesin IC rolünü bir tabletop'ta en az bir kez üstlenmesi, gerçek bir gecede rolün ilk kez denenmesinden çok daha ucuz.
Sık Düşülen Tuzaklar
Herkesin debug etmesi. Beş kişi aynı anda log okuyup farklı düzeltmeler denediğinde ne olduğunu kimse bilmez. Production'ı yalnız ops lead değiştirir; diğerleri bulduklarını kanala yazar.
IC'nin klavyeye geçmesi. IC kendi debug etmeye başladığında kararlar ve iletişim durur; çağrıda bir süre kimse yönetmiyordur.
Restart'ı mitigation sanmak. Tabletop'ta restart hiçbir şeyi düzeltmezdi, yalnız işlenmekte olan checkout'ları düşürürdü.
Kapanışta kolları unutmak. Kill switch'in ya da yükseltilmiş timeout'un incident bittikten sonra açık kalması yeni bir incident'tır.
Küçük Bir Deneme
★☆☆ Kendi ekibin için bir severity tablosu yaz. Her seviyeyi kullanıcı etkisiyle ve bir sayıyla tanımla ("kritik" kelimesini kullanmadan) ve her seviye için status page'in ne zaman güncelleneceğini ekle.
★★☆ Laboratuvarda sahte ödeme sağlayıcısının slowDelayMs'sini 4000 yap ve switches.json'da TimeoutSeconds'ı 6'ya çıkar. Checkout latency SLO'sunun (800 ms) burn rate'ini Prometheus'ta izle: bu kol availability bütçesini korurken latency bütçesini ne hızla harcıyor? Hangi noktada kill switch'e geçmek daha doğru olur?
★★★ Ekibinle 30 dakikalık bir tabletop exercise yap. Senaryo: ödeme sağlayıcısı yavaşlıyor, 10 dakika sonra tamamen çöküyor. Bir kişi IC, biri ops lead, biri comms lead olsun; zaman çizelgesini TEMPLATE.md'ye yazın. Sonunda üç soruya cevap verin: ilan etmek kaç dakika sürdü, hangi kol eksikti, status page'e ilk mesaj ne zaman gitti?
Incident kapandı, kollar geri alındı. Geriye ne olduğunu, neden olduğunu ve tekrar olmaması için ne yapılacağını yazmak ve takip etmek kaldı. Bir sonraki yazıda postmortem sürecini, review toplantısını, action item takibini ve MTTR (bir arızanın ortalama düzeltilme süresi) gibi incident metriklerinin neden yanıltabileceğini bu tabletop'un postmortem'i üzerinden anlatıyoruz.