

PostgreSQL Nedir? SQL Server Geliştiricisi için Mimari: Process'ler, Shared Buffers, WAL ve MVCC

PostgreSQL her bağlantı için ayrı bir işletim sistemi process'i başlatır, belleğin çoğunu işletim sisteminin cache'ine bırakır ve bir satırın eski sürümünü ayrı bir version store'da değil tablonun içinde tutar; SQL Server bilen biri için farkların çoğu buradan çıkar. Gerçek çıktılarla postmaster ve backend'ler, 97. bağlantıdaki 53300 hatası, connection pool, shared_buffers, WAL ve checkpoint, xmin/xmax ile MVCC, kavram eşlemesi, lisans ve sürüm takvimi.
Sürüm notu: Bu yazıdaki örnekler PostgreSQL 18.7 (resmî postgres:18 Docker image'ı), .NET 10 ve Npgsql 10.0.3 ile çalıştırılmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) yıllardır SQL Server üzerinde çalışıyor. Ekip, lisans maliyeti yüzünden PostgreSQL'i deniyor ve ilk load test'te API'nin log'larında daha önce hiç görmediği bir hata çıkıyor. Sorunu küçültmek için şu kodu yazıyoruz: connection pooling kapalı, döngü 120 bağlantı açmaya çalışıyor ve hiçbirini kapatmıyor.
NpgsqlConnectionStringBuilder builder = new(connectionString) { Pooling = false };
await using NpgsqlDataSource dataSource = NpgsqlDataSource.Create(builder);

List<NpgsqlConnection> open = [];
try
{
    for (int i = 1; i <= 120; i++)
    {
        NpgsqlConnection connection = await dataSource.OpenConnectionAsync();
        open.Add(connection);
        if (i <= 3)
        {
            Console.WriteLine($"connection {i}: server process id {connection.ProcessID}");
        }
    }
}
catch (PostgresException ex)
{
    Console.WriteLine($"connection {open.Count + 1}: {ex.SqlState} {ex.MessageText}");
}
SQL Server'da bu döngü sorunsuz biter; varsayılan ayarlarda 32.767 kullanıcı bağlantısına kadar izin verir. PostgreSQL 18'in varsayılan ayarlarında kaçıncı bağlantıda ne olur? Bir de çıktıdaki "server process id" ne anlama geliyor: SQL Server'daki session id'nin karşılığı mı, yoksa gerçekten işletim sisteminde bir process mi?
connection 1: server process id 98
connection 2: server process id 99
connection 3: server process id 100
connection 98: 53300 remaining connection slots are reserved for roles with the SUPERUSER attribute
client backend processes on the server: 97
98. bağlantı reddedildi. max_connections varsayılan olarak 100; bunun 3'ü (superuser_reserved_connections) superuser'lara ayrılmış, yani normal bir uygulama rolü en fazla 97 bağlantı açabiliyor. Asıl önemli kısım ise ilk satırlarda: 98, 99, 100 birer session numarası değil, sunucuda o bağlantı için yeni başlatılmış birer işletim sistemi process'inin PID'si (process ID; işletim sisteminin process'e verdiği numara). Bu yazıda PostgreSQL'i bu noktadan açıyoruz: process modeli, bellek, WAL (Write-Ahead Log; değişikliğin veri dosyasından önce log'a yazılması kuralı) ve MVCC (Multi-Version Concurrency Control; okuyucuların satırın eski sürümünü okuyarak yazanı beklemediği eşzamanlılık yöntemi). Hepsini SQL Server'daki karşılığıyla yan yana koyacağız; çünkü SQL Server bilen biri için PostgreSQL'deki sürprizlerin çoğu bu dört konudan çıkıyor.
Process-per-Connection: postmaster ve Backend'ler
Denemeler için kalıcı bir lab kurmaya henüz gerek yok; 02'de kuracağız. Bu yazı için geçici bir container yeterli. PowerShell'de:
# Geçici PostgreSQL 18; --rm sayesinde durdurulunca silinir
$env:PG_LAB_PASSWORD = "<strong-password>"
docker run --rm -d --name pg-arch -e POSTGRES_PASSWORD=$env:PG_LAB_PASSWORD -p 5432:5432 postgres:18

# Container'ın içindeki process'ler
docker exec pg-arch ps -eo pid,ppid,cmd
PID PPID CMD
1 0 postgres
67 1 postgres: io worker 0
68 1 postgres: io worker 1
69 1 postgres: io worker 2
70 1 postgres: checkpointer
71 1 postgres: background writer
73 1 postgres: walwriter
74 1 postgres: autovacuum launcher
75 1 postgres: logical replication launcher
299 1 postgres: postgres postgres [local] SELECTPID 1, dokümantasyonda postmaster diye geçen ana process. Görevi 5432 portunu dinlemek, gelen bağlantının kimliğini doğrulamak ve o bağlantı için kendini fork ederek yeni bir backend process başlatmak. Son satırdaki 299 böyle bir backend: postgres rolüyle postgres database'ine bağlanmış ve o an bir SELECT çalıştırıyor. Bağlantı kapanınca bu process de sonlanır. Aradaki satırlar her zaman çalışan background process'ler:
checkpointer: belirli aralıklarla shared buffers'taki değişmiş (dirty) page'leri veri dosyalarına yazar ve checkpoint kaydı atar.background writer: dirty page'leri önden yavaş yavaş yazar ki backend'ler boş buffer bulmak için kendileri yazmak zorunda kalmasın.walwriter: WAL buffer'larını düzenli olarak diske yazar.autovacuum launcher: hangi tablonun temizliğe ihtiyacı olduğuna bakar ve gerektiğinde autovacuum worker'ları başlatır.io worker: PostgreSQL 18 ile gelen asynchronous I/O altyapısının varsayılan yöntemi (io_method = worker); okumaları backend adına bu process'ler yapar, varsayılan sayısı 3.logical replication launcher: logical replication subscription'ları için worker başlatır; burada boşta bekliyor.
Döngüyü superuser ile değil, sıradan bir uygulama rolüyle çalıştırıyoruz. Rolü oluşturup parolasını \password ile veriyoruz; böylece parola komut geçmişine düşmüyor. Kodun tamamı bu yazının snapshot'ında src/Bookstore.PgLab altında:
# Uygulama rolü; parolayı psql soracak
docker exec -it pg-arch psql -U postgres -c "CREATE ROLE bookstore_app LOGIN"
docker exec -it pg-arch psql -U postgres -c "\password bookstore_app"

$env:BOOKSTORE_PG = "Host=localhost;Port=5432;Database=postgres;Username=bookstore_app;Password=<app-password>"
dotnet run --project src/Bookstore.PgLab -- connections
dotnet run --project src/Bookstore.PgLab -- pool
Aynı tabloyu SQL ile de görebilirsin. pg_stat_activity her process için bir satır döndürür; SQL Server'daki sys.dm_exec_sessions ile sys.dm_exec_requests'in karışımı gibi düşünebilirsin:
SELECT pid, backend_type FROM pg_stat_activity ORDER BY backend_type, pid; pid | backend_type
-----+------------------------------
74 | autovacuum launcher
71 | background writer
70 | checkpointer
89 | client backend
67 | io worker
68 | io worker
69 | io worker
75 | logical replication launcher
73 | walwriter
(9 rows)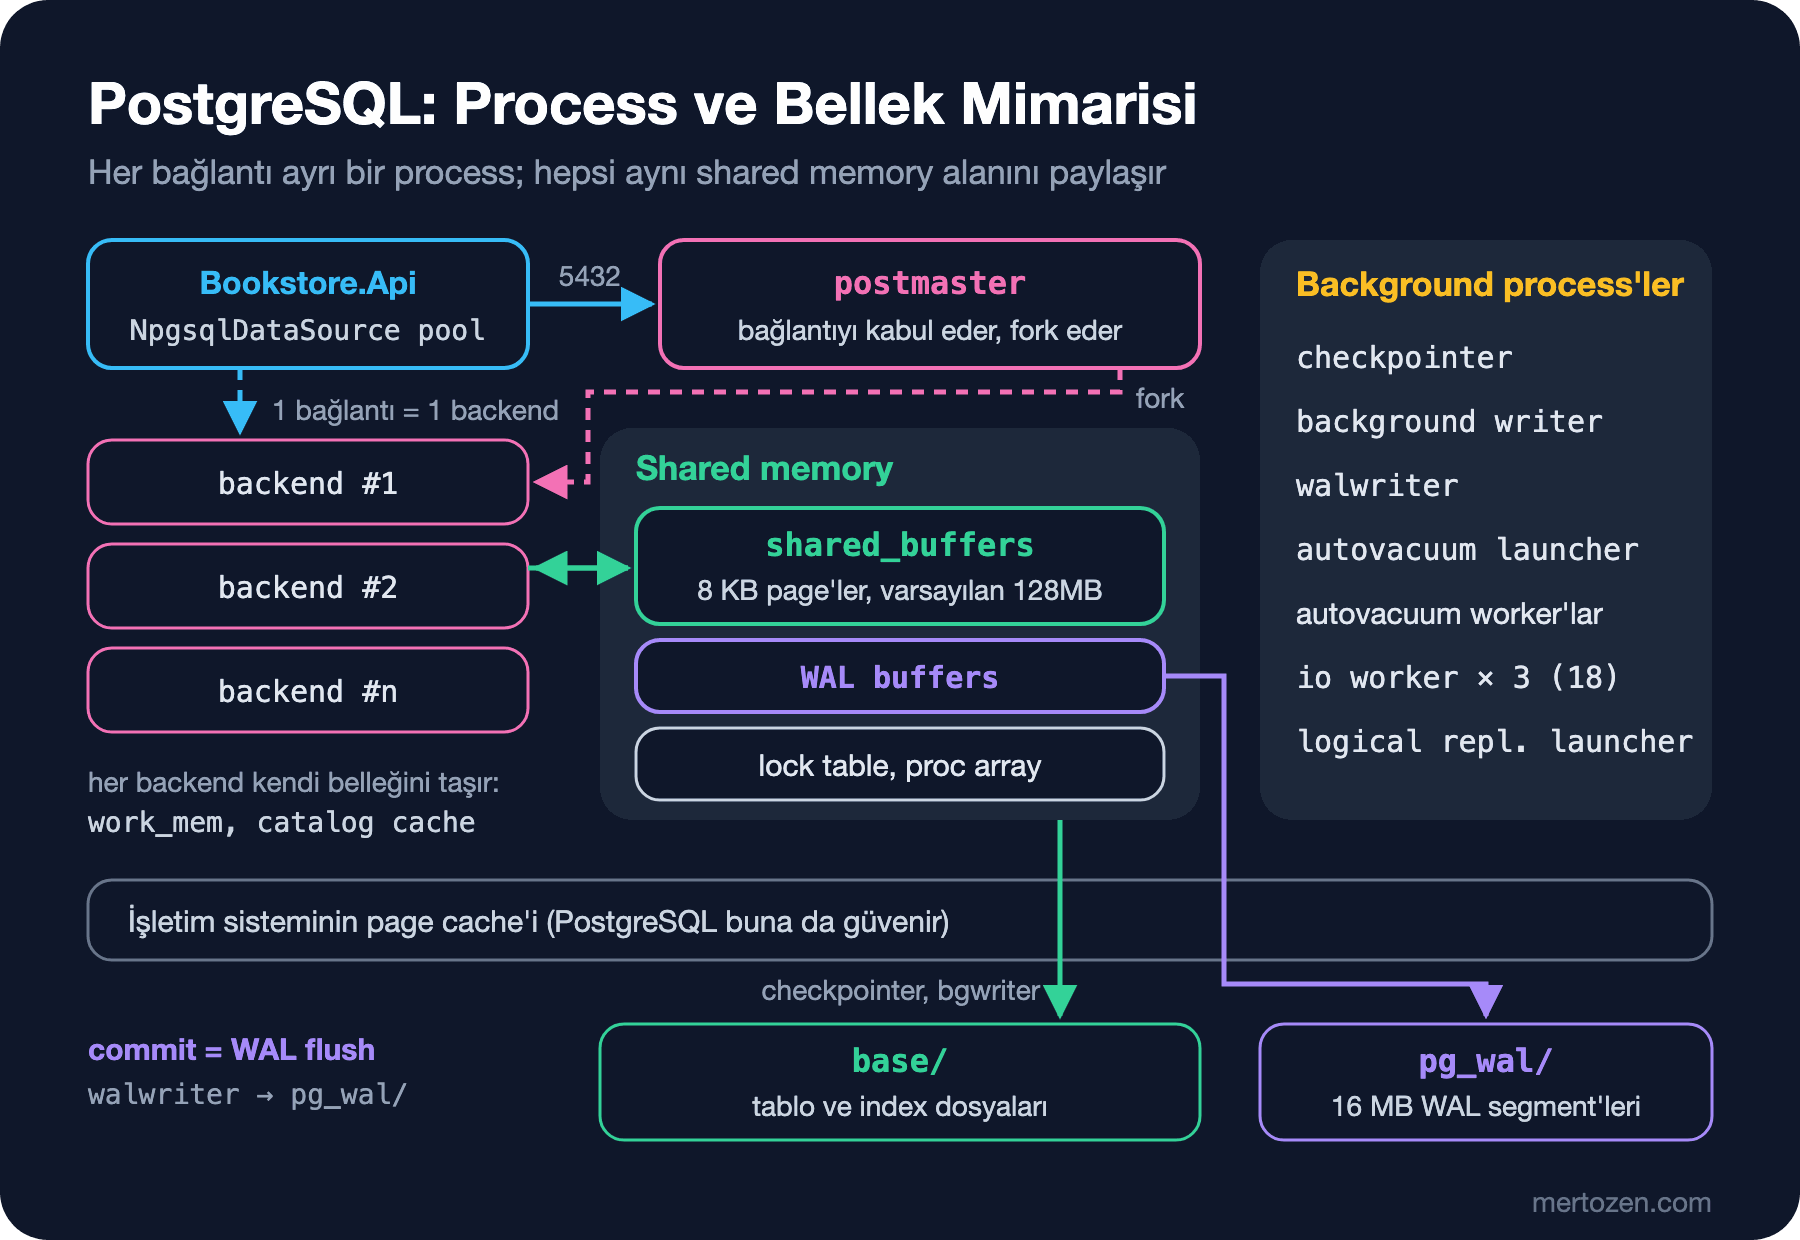
SQL Server'da durum farklı. SQL Server Derinlemesine serisinin ilk yazısında gördüğümüz gibi SQL Server tek bir process; içindeki SQLOS (SQL Server'ın kendi zamanlama ve bellek katmanı) scheduler'lar ve worker thread'lerle çalışır, bir bağlantı açmak yeni bir thread bile başlatmaz, yalnızca bir session nesnesi oluşturur. PostgreSQL'de ise her bağlantı gerçek bir process. Bu modelin sonuçları var. Bir sorgu hata verdiğinde ya da bağlantı koptuğunda yalnız o process etkilenir; ama bir backend beklenmedik şekilde çökerse postmaster, shared memory bozulmuş olabileceği için bütün backend'leri sonlandırır ve kısa bir crash recovery yapar. Asıl günlük etki ise bağlantı başına maliyet: process oluşturmak, kimlik doğrulamak, catalog cache'i doldurmak ve her process'in kendi özel belleği.
Bu yüzden PostgreSQL'de connection pool bir tercih değil, zorunluluk. Npgsql'de pooling varsayılan olarak açık ve Max Pool Size 100. Aynı makinede 200 isteği aynı anda gönderip pool'u 20 ile sınırladık, bir yandan da sunucudaki process sayısını izledik:
NpgsqlConnectionStringBuilder builder = new(connectionString) { MaxPoolSize = maxPoolSize };
await using NpgsqlDataSource pooled = NpgsqlDataSource.Create(builder);

await Parallel.ForEachAsync(Enumerable.Range(1, requests), new ParallelOptions { MaxDegreeOfParallelism = requests },
    async (_, ct) =>
    {
        await using NpgsqlCommand command = pooled.CreateCommand("SELECT pg_sleep(0.1)");
        await command.ExecuteNonQueryAsync(ct);
    });
200 queries, Max Pool Size=20
peak server processes for the app: 20
elapsed: 1.1 s200 istek 20 process ile bitti; 100 ms süren sorgular 20'şerli gruplar hâlinde sıraya girdi ve toplam 1,1 saniye sürdü. Pool limiti, sunucudaki process sayısının üst sınırı oldu. Dikkat etmen gereken nokta şu: bu limit uygulama instance'ı başına geçerli. Bookstore.Api'yi 8 instance ile çalıştırırsan ve her biri varsayılan 100'lük pool kullanırsa, en kötü durumda 800 bağlantı ister. Bu noktada PgBouncer gibi sunucu tarafında bir pool devreye girer; o konu Veritabanı Performansı ve Scaling serisinde.
Bellek: shared_buffers ve İşletim Sisteminin Page Cache'i
Bütün backend'lerin ortak kullandığı alan shared memory. En büyük parçası shared_buffers: veri dosyalarından okunan 8 KB'lık page'lerin tutulduğu cache. SQL Server'daki buffer pool'un karşılığı ama önemli bir farkla. SQL Server belleğin büyük kısmını alıp kendisi yönetmeyi tercih eder; PostgreSQL ise bilerek küçük bir pay alır ve gerisini işletim sisteminin page cache'ine bırakır. Dokümantasyon, en az 1 GB RAM'i olan ayrı bir veritabanı sunucusu için başlangıç değeri olarak belleğin %25'ini önerir ve %40'ın üzerine çıkmanın, işletim sistemi cache'iyle aynı veriyi iki kez tutmaya yol açacağı için, pek fayda getirmeyeceğini belirtir. Varsayılan değer 128MB.
İki katmanı görmek için 100.002 satırlık bir tablonun page'lerini pg_buffercache extension'ıyla shared buffers'tan çıkardık ve aynı sorguyu iki kez çalıştırdık:
CREATE EXTENSION pg_buffercache;
SELECT buffers_evicted FROM pg_buffercache_evict_relation('stock_items');
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF) SELECT sum(quantity_on_hand) FROM stock_items;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF) SELECT sum(quantity_on_hand) FROM stock_items;
buffers_evicted
-----------------
447
Aggregate (actual rows=1.00 loops=1)
Buffers: shared read=443 dirtied=443
-> Seq Scan on stock_items (actual rows=100002.00 loops=1)
Buffers: shared read=443 dirtied=443
Planning Time: 0.052 ms
Execution Time: 5.270 ms
Aggregate (actual rows=1.00 loops=1)
Buffers: shared hit=443
-> Seq Scan on stock_items (actual rows=100002.00 loops=1)
Buffers: shared hit=443
Planning Time: 0.015 ms
Execution Time: 2.903 msİlk çalıştırmada 443 page read, ikincide hit. Burada read, "shared buffers'ta yoktu, işletim sisteminden istendi" demek; diskten okundu demek değil. 443 page'in 5 ms'de gelmesi, bunların işletim sisteminin cache'inden geldiğini gösteriyor. PostgreSQL 18'de EXPLAIN ANALYZE artık BUFFERS bilgisini varsayılan olarak gösteriyor; plan okumayı 07'de ayrıntılı işleyeceğiz. dirtied=443 da ilginç: sadece okuyan bir sorgu page'leri değiştirdi. Bunun nedeni MVCC'nin hint bit'leri; yeni yüklenmiş satırları ilk okuyan sorgu, satırı yazan transaction'ın commit edildiğini page'e not eder. Bu ayrıntıya 08'de döneceğiz.
Shared memory dışında her backend'in kendi özel belleği var. En önemlisi work_mem (varsayılan 4MB): sort ve hash işlemleri bu sınıra kadar bellekte yapılır, aşınca diske taşar. Sınır sorgu başına değil, plan içindeki her sort ya da hash node'u başına geçerli. 97 bağlantının her biri iki hash join'li bir sorgu çalıştırırsa, teoride work_mem'in en az 200 katı bellek kullanılabilir. SQL Server'daki memory grant mekanizmasının merkezi kontrolü burada yok; bu yüzden work_mem'i yükseltirken bağlantı sayısını da hesaba katmak gerekir.
WAL ve Checkpoint
WAL, SQL Server'daki transaction log'un karşılığı ve aynı fikre dayanıyor: commit anında değişmiş page'leri diske yazmak yerine yalnızca değişikliğin kaydını sıralı olarak diske yazmak. Page'ler bellekte dirty kalır, checkpoint'te ya da background writer tarafından yazılır. Çökme olursa son checkpoint'ten sonraki WAL kayıtları yeniden uygulanır. WAL dosyaları pg_wal klasöründe 16 MB'lık segment'ler hâlinde durur. 100.000 satır ekleyip ne kadar WAL üretildiğine baktık:
SELECT pg_current_wal_lsn() AS before_lsn \gset
INSERT INTO stock_items SELECT g, g % 200 FROM generate_series(3, 100002) AS g;
SELECT pg_current_wal_lsn() AS after_lsn,
       pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), :'before_lsn')) AS wal_written,
       pg_size_pretty(pg_relation_size('stock_items')) AS table_size,
       pg_walfile_name(pg_current_wal_lsn()) AS wal_file;
after_lsn | wal_written | table_size | wal_file
-----------+-------------+------------+--------------------------
0/24C4D20 | 12 MB | 3544 kB | 000000010000000000000002
(1 row)LSN (Log Sequence Number; WAL içindeki byte konumu) pg_current_wal_lsn() ile okunur, iki LSN'in farkı üretilen WAL miktarını verir. Tablo 3,5 MB, primary key index'i 2,2 MB; üretilen WAL ise 12 MB. Fark şaşırtmasın: her satır ve her index girişi için ayrı bir WAL kaydı yazılıyor, kayıtların kendi başlıkları var ve checkpoint'ten sonra bir page ilk kez değiştiğinde page'in tamamı WAL'a yazılıyor (full_page_writes; yarım yazılmış page'e karşı koruma). Toplu yüklemelerde WAL hacmi, verinin kendisinden büyük olabilir. Replication ve point-in-time recovery de bu WAL akışını kullanır.
SELECT num_timed, num_requested, buffers_written FROM pg_stat_checkpointer;
CHECKPOINT;
SELECT num_timed, num_requested, buffers_written FROM pg_stat_checkpointer;
num_timed | num_requested | buffers_written
-----------+---------------+-----------------
0 | 1 | 0
num_timed | num_requested | buffers_written
-----------+---------------+-----------------
0 | 2 | 851Elle tetiklediğimiz checkpoint, eklemeden kalan 851 dirty buffer'ı veri dosyalarına yazdı. Normalde checkpoint ya checkpoint_timeout (varsayılan 5 dakika) dolunca ya da WAL max_wal_size'a (varsayılan 1GB) yaklaşınca kendiliğinden olur. num_requested değeri num_timed'a göre hızla artıyorsa, WAL limitin dolduğu için checkpoint'ler erken tetikleniyor demektir; bu, yoğun yazan sistemlerde ilk bakılacak metriklerden biri.
MVCC: Satırın Eski Sürümü Tablonun İçinde Kalır
MVCC iki veritabanında da var, ama eski sürümlerin nerede durduğu tamamen farklı. İki oturumla deneyelim. A oturumu stoğu güncelliyor ve üç saniye boyunca commit etmiyor; B oturumu o sırada aynı satırı okuyor:
CREATE TABLE stock_items (book_id int PRIMARY KEY, quantity_on_hand int NOT NULL);
INSERT INTO stock_items VALUES (1, 36), (2, 12);

/* A */
BEGIN;
UPDATE stock_items SET quantity_on_hand = 35 WHERE book_id = 1;
SELECT ctid, xmin, xmax, quantity_on_hand FROM stock_items WHERE book_id = 1;
SELECT pg_sleep(3);
COMMIT;

/* B, A commit etmeden önce */
SELECT ctid, xmin, xmax, quantity_on_hand FROM stock_items WHERE book_id = 1;
session | ctid | xmin | xmax | quantity_on_hand
----------+-------+------+------+------------------
[A] sees | (0,3) | 767 | 0 | 35
session | ctid | xmin | xmax | quantity_on_hand
----------+-------+------+------+------------------
[B] sees | (0,1) | 766 | 767 | 36
Time: 0.969 msB beklemedi (1 ms) ve eski değeri, 36'yı gördü. A ise kendi yazdığı 35'i görüyor. İki oturum aynı satırın iki farklı fiziksel kopyasını okudu: ctid satırın fiziksel adresi (page 0, satır 1 ve 3), xmin satırı oluşturan transaction'ın ID'si, xmax satırı silen ya da güncelleyen transaction'ın ID'si. PostgreSQL'de UPDATE, mevcut satırı yerinde değiştirmez; eskisinin xmax'ına kendi transaction ID'sini yazar ve yeni bir satır ekler. Hangi sürümün görüneceğine her sorgu kendi snapshot'ına göre karar verir. Page'in içine pageinspect extension'ıyla bakınca iki sürüm de orada:
CREATE EXTENSION pageinspect;
SELECT lp, t_xmin, t_xmax, t_ctid FROM heap_page_items(get_raw_page('stock_items', 0));
SELECT n_live_tup, n_dead_tup FROM pg_stat_user_tables WHERE relname = 'stock_items';
lp | t_xmin | t_xmax | t_ctid
----+--------+--------+--------
1 | 766 | 767 | (0,3)
2 | 766 | 0 | (0,2)
3 | 767 | 0 | (0,3)
n_live_tup | n_dead_tup
------------+------------
2 | 11 numaralı satır artık dead tuple: commit edilmiş bir transaction onu güncelledi ve onu görebilecek açık bir snapshot kalmadı, ama hâlâ page'te yer kaplıyor. Bu alanı geri kazanan işlem VACUUM:
VACUUM stock_items;
SELECT lp, lp_flags, t_xmin, t_xmax, t_ctid FROM heap_page_items(get_raw_page('stock_items', 0));
lp | lp_flags | t_xmin | t_xmax | t_ctid
----+----------+--------+--------+--------
1 | 2 | | |
2 | 1 | 766 | 0 | (0,2)
3 | 1 | 767 | 0 | (0,3)Eski sürümün verisi silindi; 1 numaralı yuvada yalnızca 3'e yönlendiren küçük bir işaret kaldı (lp_flags = 2, redirect). Bu yönlendirme HOT (Heap-Only Tuple; index'e yeni giriş eklemeden aynı page'e yazılan güncelleme) mekanizmasının bir parçası; ayrıntısı 08'de.
SQL Server'da varsayılan READ COMMITTED locking ile çalışır ve B, A commit edene kadar beklerdi. Okuyucunun beklememesi için RCSI (Read Committed Snapshot Isolation; okuyucunun son commit edilmiş sürümü gördüğü mod) açılır; bu durumda eski sürümler tempdb'deki version store'a, ADR (Accelerated Database Recovery; kurtarmayı hızlandıran özellik) açıksa veritabanının kendi PVS'sine (Persistent Version Store; eski sürümleri veritabanı içinde tutan alan) kopyalanır. SQL Server Derinlemesine serisinin isolation level yazısında bu mekanizmayı ayrıntılı gördük. PostgreSQL'de ayrı bir version store yok; eski sürüm tablonun kendisinde (heap'te) kalır ve READ COMMITTED varsayılan olarak RCSI gibi davranır. Bu tasarımın bedeli belli: dead tuple'lar temizlenmezse tablo ve index'ler şişer (bloat), uzun süre açık kalan bir transaction temizliği durdurur. Autovacuum bu yüzden kapatılacak bir şey değil, PostgreSQL'in çalışma modelinin parçası.
SQL Server Kavramlarının PostgreSQL Karşılıkları
İsimler bazen aynı, anlamları farklı. En sık karıştırılanlar:
| SQL Server | PostgreSQL | Fark |
|---|---|---|
| Instance | Cluster | Bir postmaster'ın yönettiği tek data directory; birden fazla makineden oluşan küme demek değil. |
| Database | Database | Aynı cluster'daki başka bir database'e sorgu içinden erişilemez; gerekiyorsa postgres_fdw ya da dblink. |
Schema (dbo) | Schema (public) | Hangi schema'ya bakılacağını search_path belirler. |
| Login + User | Role | Tek kavram; LOGIN yetkisi olan role bağlanabilir. |
| Filegroup | Tablespace | Farklı bir diske dizin göstermek; çoğu kurulumda gerekmez. |
| Transaction log (.ldf) | WAL (pg_wal) | 16 MB segment dosyaları; recovery model yok, arşivleme ayrı ayar. |
| Buffer pool | shared_buffers + OS page cache | PostgreSQL belleğin çoğunu işletim sistemine bırakır. |
| tempdb version store / PVS | Heap'teki eski tuple'lar | Temizliği VACUUM ve autovacuum yapar. |
| Session (thread) | Backend (process) | Bağlantı başına bir process; pool zorunlu. |
| SQL Server Agent | Yok | Zamanlanmış iş için pg_cron extension'ı ya da uygulama tarafı. |
"Cluster" kelimesi en çok kafa karıştıranı: PostgreSQL dokümantasyonunda database cluster, aynı sunucu process'inin yönettiği database'lerin toplamı demek. Role modelini ve uygulama rolü ile owner rolünü ayırmayı 02'de, yetkileri 14'te göreceğiz.
Lisans, Topluluk ve Sürüm Takvimi
PostgreSQL, PostgreSQL License ile dağıtılıyor: en serbest açık kaynak lisanslarına benzeyen, ticari kullanımı ve değiştirerek dağıtmayı serbest bırakan kısa bir lisans. Projenin sahibi tek bir şirket değil; geliştirme PostgreSQL Global Development Group adı altında, farklı şirketlerden ve bağımsız katkıcılardan oluşan bir toplulukla yürüyor. Bu, ürünün yol haritasının bir satıcının ticari kararlarına bağlı olmaması demek; öte yandan "destek" için kendi ekibine, bir danışmanlık firmasına ya da managed servis sağlayıcısına güvenirsin.
Sürüm politikası basit ve öngörülebilir. Her yıl, genelde eylül ya da ekim ayında bir major sürüm çıkar ve her major sürüm ilk çıkışından itibaren 5 yıl desteklenir. Hata ve güvenlik düzeltmeleri en az üç ayda bir minor sürümlerle gelir; minor güncelleme yalnızca binary değişimidir, veri dosyası formatı değişmez. Bu yazının yazıldığı hafta, 12 Kasım 2026'da 18.7, 17.12, 16.16, 15.20 ve 14.25 yayınlandı. 14.25, PostgreSQL 14'ün son sürümü; 14 artık destek dışı. PostgreSQL 18, 25 Eylül 2025'te çıktı ve 14 Kasım 2030'a kadar destekleniyor. Major sürümler arasında geçiş ise pg_upgrade ya da dump/restore ister; bunu 14. yazıda göreceğiz. Bu seri PostgreSQL 18 tabanlı; 19 henüz release candidate aşamasında ve yalnızca son yazıda ele alınacak.
Ne Zaman PostgreSQL, Ne Zaman SQL Server?
Kararı genelde teknik üstünlük değil, maliyet ve ekip belirler. Yine de tartılması gereken somut başlıklar var:
Lisans: PostgreSQL'in lisans maliyeti yok. SQL Server'da Express ücretsiz ama SQL Server 2025'te bile database başına 50 GB, en fazla 4 core ve yaklaşık 1,4 GB buffer pool ile sınırlı; Developer sürümü production'da kullanılamaz; Standard ve Enterprise core başına lisanslanır. Bookstore gibi büyümesi belirsiz bir üründe bu fark, özellikle çok sayıda ortam (test, staging, müşteri başına kurulum) olduğunda belirleyici olur.
Ekosistem: PostgreSQL'in extension mekanizması güçlü. PostGIS ile coğrafi veri, pg_trgm ile benzerlik araması, pgvector ile vektör araması aynı veritabanında yapılabilir. JSONB (JSON'ın ayrıştırılıp binary olarak saklandığı tip), array ve range tipleri gibi PostgreSQL'e özgü tipler de bu serinin 03 ve 05. yazılarının konusu.
Managed seçenekler: Azure Database for PostgreSQL (flexible server), Amazon RDS (Relational Database Service; Amazon'un managed veritabanı servisi) for PostgreSQL ve Aurora PostgreSQL, Google Cloud SQL. Managed serviste superuser yetkisi verilmez ve kurulabilecek extension'lar bir izin listesiyle sınırlıdır; 13. yazıda buna bakacağız.
SQL Server'ın güçlü olduğu yerler: Windows authentication ve Active Directory ile entegrasyon, SSMS (SQL Server Management Studio, Microsoft'un yönetim aracı) ve Query Store gibi tek elden gelen araçlar, SSIS (SQL Server Integration Services; veri aktarım servisi) gibi aynı lisansla gelen ek servisler, built-in Always On availability group. PostgreSQL'in streaming replication'ı çekirdekte var ama otomatik failover için Patroni gibi harici bir araç ya da managed servis gerekir. Ekip yıllardır T-SQL yazıyor, execution plan'ı SSMS'te okuyor ve operasyon tarafında SQL Server DBA'i (veritabanı yöneticisi) varsa, geçişin gerçek maliyeti lisans tasarrufundan büyük olabilir.
Kısaca: yeni bir projede, özellikle Linux ve container ağırlıklı bir ortamda ve bulutta, PostgreSQL güçlü bir varsayılan. Mevcut ve büyük bir SQL Server yatırımı, Microsoft ekosistemine sıkı bağlılık ya da ekipte PostgreSQL operasyon deneyimi hiç yoksa, SQL Server'da kalmak çoğu zaman daha az risklidir.
Üretimde Dikkat
Bağlantı sayısı: max_connections'ı 1000'e çıkarmak, process modelinde kalıcı bir çözüm değil. Her process bellek ve CPU zamanı ister, aynı anda çalışan çok sayıda process lock ve snapshot hesaplarında rekabet yaratır. Önce uygulama tarafındaki pool'ları topla: instance sayısı çarpı Max Pool Size, max_connections'tan küçük olmalı ve yönetim araçlarına, migration'a, izleme ajanlarına pay kalmalı. Yetmiyorsa PgBouncer.
İzleme: pg_stat_activity'deki state kolonu en değerli tek sinyal. idle in transaction durumunda uzun süre bekleyen bir bağlantı hem lock tutar hem de VACUUM'un dead tuple'ları temizlemesini engeller. Checkpoint tarafında pg_stat_checkpointer'daki num_requested artışını izle.
Disk: WAL için ayrı bir alan planla. Arşivleme başarısız olursa ya da bir replication slot tüketilmezse pg_wal durmadan büyür ve disk dolunca veritabanı durur. Bu, SQL Server'da full recovery model'de log backup almamaya benzer bir sonuç doğurur.
Sık Düşülen Tuzaklar
Her istekte yeni bir NpgsqlDataSource oluşturmak: her data source kendi pool'unu taşır, istek başına oluşturulan data source pool'u boşa çıkarır ve her istek yeni bir process başlatır. Data source uygulama boyunca tek olmalı; dependency injection ile kaydını 11. yazıda göreceğiz.
EXPLAIN çıktısındaki read'i disk okuması sanmak: yalnızca shared buffers'ta bulunamadığını söyler. Gerçek disk okumasını ayırt etmek için track_io_timing ve işletim sistemi metrikleri gerekir.
Transaction'ı açık bırakmak: SQL Server'da RCSI açıkken uzun bir transaction tempdb'yi büyütür; PostgreSQL'de aynı hata doğrudan tablolarını büyütür, çünkü eski sürümler tablonun içinde.
Database'ler arası sorgu beklemek: SQL Server'daki OtherDb.dbo.Books gibi üç parçalı isimlerin PostgreSQL'de karşılığı yok. Aynı uygulamanın birlikte sorgulanan verileri tek database'te, gerekirse farklı schema'larda durmalı.
Küçük Bir Deneme
★☆☆ Geçici container'da SHOW max_connections; ve SHOW superuser_reserved_connections; değerlerine bak. Ardından ALTER SYSTEM SET max_connections = 20; çalıştır, container'ı yeniden başlat ve bu yazıdaki döngünün kaçıncı bağlantıda durduğunu tahmin edip doğrula.
★★☆ İki psql oturumu aç. Birinde BEGIN; yazıp herhangi bir satırı güncelle ve bekle. Diğerinde SELECT pid, state, xact_start FROM pg_stat_activity; ile ilk oturumun idle in transaction göründüğünü bul. Sonra güncellenen tabloda VACUUM VERBOSE çalıştır ve kaç dead tuple'ın temizlenemediğini çıktıdan oku.
★★★ Pool demosunu Max Pool Size=5 ve Timeout=1 ile çalıştır. Bazı isteklerin pool'dan bağlantı bekleyerek zaman aşımına uğradığını gör ve hata mesajını sunucunun 53300 hatasıyla karşılaştır: hangisi uygulamanın, hangisi veritabanının koyduğu sınır?
Bir sonraki yazıda geçici container'ı bırakıp kalıcı bir lab kuruyoruz: PostgreSQL 18 image'ının değişen volume yolu, psql'in günlük komutları, Bookstore şemasının PostgreSQL'e taşınması ve uygulama rolünü superuser'dan ayırmak.