

PostgreSQL Index Türleri: B-tree, Hash, GIN, GiST, SP-GiST, BRIN ve Partial/Expression Index

PostgreSQL'de index türünü kolonun tipi değil sorgunun biçimi belirler: eşitlik ve aralık için B-tree, array/JSONB ve ILIKE '%...%' için GIN, çakışma için GiST, zamana göre büyüyen tablolar için BRIN. 18'in skip scan'iyle 10.328 yerine 26 page okuyan sorgu, deduplication, INCLUDE ve index-only scan, 21 MB'lık B-tree yerine 24 kB'lık BRIN, hash, partial ve expression index, INVALID kalan CONCURRENTLY index'i ve HOT update'i bozan index.
Sürüm notu: Bu yazıdaki örnekler PostgreSQL 18.7 (resmî postgres:18 Docker image'ı) üzerinde, 02'de kurduğumuz Bookstore lab'ında, şema yeniden yüklendikten hemen sonra çalıştırılmıştır; karşılaştırma için bir sorgu PostgreSQL 17.11'de de denenmiştir.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için arka ofis ekranı siparişleri durumuna göre listeliyor, bu yüzden orders tablosunda (status, created_at) index'i var. Raporlama ekibi ise durumdan bağımsız olarak "dünkü siparişleri" soruyor; sorguda status hiç geçmiyor. Planları sade tutmak için oturumda paralel sorguyu kapattık:
SET max_parallel_workers_per_gather = 0;
CREATE INDEX ix_orders_status_created_at ON orders (status, created_at);
ANALYZE orders;

EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT count(*) FROM orders
WHERE created_at >= timestamptz '2026-10-20' AND created_at < timestamptz '2026-10-21';
SQL Server'da cevap bellidir: index'in ilk kolonu koşulda yoksa seek yapılamaz, ya tüm index ya da tablo taranır. PostgreSQL 18 ne yapar? Aynı veriyi PostgreSQL 17.11'e de yükleyip sorguyu orada da çalıştırdık.
/* PostgreSQL 18.7 */
 Aggregate (actual rows=1.00 loops=1)
   Buffers: shared hit=11 read=15
   ->  Index Only Scan using ix_orders_status_created_at on orders (actual rows=640.00 loops=1)
         Index Cond: ((created_at >= '2026-10-20 00:00:00+00'::timestamp with time zone) AND (created_at < '2026-10-21 00:00:00+00'::timestamp with time zone))
         Heap Fetches: 0
         Index Searches: 6
         Buffers: shared hit=11 read=15

/* PostgreSQL 17.11 */
 Aggregate (actual rows=1 loops=1)
   Buffers: shared hit=2368 read=7960
   ->  Seq Scan on orders (actual rows=640 loops=1)
         Filter: ((created_at >= '2026-10-20 00:00:00+00'::timestamp with time zone) AND (created_at < '2026-10-21 00:00:00+00'::timestamp with time zone))
         Rows Removed by Filter: 999360
         Buffers: shared hit=2368 read=7960
17'de bir milyon satırın hepsi okundu: 10.328 page. 18'de aynı index kullanıldı ve 26 page yetti. Planın altındaki Index Searches: 6 satırı ne olduğunu anlatıyor: PostgreSQL 18'in skip scan özelliği, index'in ilk kolonunun beş farklı değeri için ayrı ayrı arama yaptı, yani status = 'Cancelled' AND created_at ..., status = 'Delivered' AND created_at ... şeklinde beş küçük aralık okudu. Bu yazıda PostgreSQL'in index türlerini tek tek deniyoruz: B-tree'nin 18'deki yenilikleri, covering index, PostgreSQL'e özgü diğer index türleri, partial ve expression index, CREATE INDEX CONCURRENTLY ve index'lerin yazma tarafındaki bedeli.
B-tree: Skip Scan, Deduplication ve Kolon Sırası
B-tree PostgreSQL'in varsayılan index'i ve vakaların çoğunda doğru cevap: eşitlik, aralık, ORDER BY, IS NULL ve prefix'li LIKE 'abc%' (uygun collation ile) sorgularını karşılar. Yapısını Algoritmalar ve Data Structure'lar serisinin balanced tree yazısında görmüştük. SQL Server'dan en önemli farkı şu: PostgreSQL'de clustered index yok. Tablo her zaman bir heap; primary key dahil bütün index'ler tablodaki satırın fiziksel adresini (ctid) gösteren ayrı yapılar.
Skip scan çok kolonlu index'te kolon sırası kuralını gevşetiyor ama kaldırmıyor. Yukarıdaki sorgu hızlıydı çünkü status'un yalnızca beş farklı değeri var; ilk kolonda yüz binlerce farklı değer olsaydı planner bu kadar çok küçük aramayı pahalı bulur ve kullanmazdı. Genel kural hâlâ geçerli: önce eşitlikle aranan kolonlar, sonra aralık ya da sıralama kolonu. Skip scan, "bu sorgu için ayrı bir index açmaya değer mi?" sorusunda elini güçlendiren bir yedek.
PostgreSQL 13'ten beri B-tree aynı değeri tekrar eden key'leri tek bir girişte topluyor (deduplication). Aynı kolona bunu kapatarak ikinci bir index kurup boyutlara baktık:
CREATE INDEX ix_orders_status ON orders (status);
CREATE INDEX ix_orders_status_nodedup ON orders (status) WITH (deduplicate_items = off);
indexrelname | size
-----------------------------+---------
ix_orders_status | 6904 kB
ix_orders_status_created_at | 39 MB
ix_orders_status_nodedup | 30 MBBeş farklı değeri olan bir milyon satırlık kolonda deduplication index'i 30 MB'tan 6,9 MB'a indirdi. Aynı tabloda (status, created_at) index'i ise 39 MB: ikinci kolon her girişi tekil yaptığı için orada birleştirilecek tekrar yok.
Covering Index ve Index-Only Scan
Müşterinin sipariş geçmişi ekranı: müşteri numarasına göre filtrele, tarihe göre sırala, üç kolon göster. Şemada yalnızca customer_id üzerinde bir index var:
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT order_number, created_at, total_amount FROM orders WHERE customer_id = 42 ORDER BY created_at DESC;
Sort (actual rows=473.00 loops=1)
Sort Key: created_at DESC
Sort Method: quicksort Memory: 47kB
Buffers: shared hit=62 read=405
-> Bitmap Heap Scan on orders (actual rows=473.00 loops=1)
Recheck Cond: (customer_id = 42)
Heap Blocks: exact=464
Buffers: shared hit=62 read=405
-> Bitmap Index Scan on ix_orders_customer_id (actual rows=473.00 loops=1)
Index Cond: (customer_id = 42)473 sipariş 464 farklı page'e dağılmış; her biri için tabloya gidildi ve sonuç bellekte sıralandı. SQL Server Derinlemesine serisinin nonclustered index yazısındaki key lookup sorununun PostgreSQL hâli bu. Çözüm de aynı: sıralama kolonunu key'e, gösterilen kolonları INCLUDE'a koymak.
CREATE INDEX ix_orders_customer_created_incl ON orders (customer_id, created_at DESC)
    INCLUDE (order_number, total_amount);
Index Only Scan using ix_orders_customer_created_incl on orders (actual rows=473.00 loops=1)
Index Cond: (customer_id = 42)
Heap Fetches: 0
Index Searches: 1
Buffers: shared hit=1 read=6467 page'ten 7 page'e indi ve Sort operator'ü kayboldu. Heap Fetches: 0 önemli bir ayrıntı: PostgreSQL'de satırın görünürlük bilgisi (01'de gördüğümüz xmin/xmax) index'te değil tabloda durur. Index-only scan, tabloya gitmeden cevap verebilmek için visibility map'e (hangi page'lerdeki bütün satırların herkese görünür olduğunu tutan harita) bakar. Map'i VACUUM günceller; sık güncellenen ve yeterince vacuum'lanmayan bir tabloda Heap Fetches yükselir ve index-only scan avantajını kaybeder. Bu yüzden covering index'in değeri autovacuum'un sağlığına bağlı; 08'de bu ilişkiye döneceğiz.
GIN ve pg_trgm: ILIKE '%...%' Araması
GIN (Generalized Inverted Index; bir satırdaki çok sayıda değeri ayrı ayrı index'leyen yapı) array, JSONB (JSON'ın ayrıştırılıp binary saklandığı tip) ve full-text için kullanılıyor; JSONB tarafını 05'te gördük, full-text 10'da. Burada en pratik kullanımına bakalım: kitap adında ortasından arama. B-tree baştan sabitlenmemiş bir LIKE '%...%' sorgusuna yardım edemez. pg_trgm extension'ı metni üç harflik parçalara (trigram) bölüp GIN ile index'liyor; extension "trusted" olduğu için owner rolü kurabiliyor:
CREATE EXTENSION IF NOT EXISTS pg_trgm;
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT count(*) FROM books WHERE title ILIKE '%hobbit #12%';
CREATE INDEX ix_books_title_trgm ON books USING gin (title gin_trgm_ops);
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT count(*) FROM books WHERE title ILIKE '%hobbit #12%';
Aggregate (actual rows=1.00 loops=1)
Buffers: shared hit=444
-> Seq Scan on books (actual rows=56.00 loops=1)
Filter: (title ~~* '%hobbit #12%'::text)
Rows Removed by Filter: 39944
Aggregate (actual rows=1.00 loops=1)
Buffers: shared hit=31
-> Bitmap Heap Scan on books (actual rows=56.00 loops=1)
Recheck Cond: (title ~~* '%hobbit #12%'::text)
Heap Blocks: exact=14
-> Bitmap Index Scan on ix_books_title_trgm (actual rows=56.00 loops=1)
Index Cond: (title ~~* '%hobbit #12%'::text)444 page'lik taramadan 31 page'e. Index 1.480 kB ve büyük/küçük harf duyarsız (ILIKE) aramayı da karşılıyor. Arama terimi en az üç karakter olmalı; tek harflik ya da çok genel terimlerde index'ten fayda azalır. Typo toleranslı benzerlik araması (similarity, % operatörü) 10. yazının konusu.
GiST, SP-GiST, BRIN ve Hash
GiST (Generalized Search Tree; range, geometri gibi "örtüşme" ve "yakınlık" sorulan tipleri index'leyebilen yapı) ile 04'te tanıştık: exclusion constraint ve temporal primary key arkasında bir GiST index çalışıyordu. Range'lerde && ve @>, PostGIS'te geometri sorguları ve "en yakın 10 mağaza" gibi KNN (k-nearest neighbor; en yakın k komşu) sıralamaları GiST'in işi. Bölümlenmiş arama ağaçları (SP-GiST; Space-Partitioned GiST, veriyi örtüşmeyen parçalara bölen yapı) ise prefix ağaçları, quadtree gibi dengesiz yapılar için: IP adresleri (inet), metin prefix'i, nokta verisi. Bookstore'da şu an SP-GiST gerektiren bir sorgu yok; varlığını bilmek yeterli.
BRIN (Block Range Index; ardışık page gruplarının en küçük ve en büyük değerini tutan özet index) ise büyük ve zamana göre büyüyen tablolar için. Siparişler oluşturulma sırasına göre eklendiği için created_at'in fiziksel sırayla korelasyonu tam 1:
SELECT attname, correlation FROM pg_stats
WHERE tablename = 'orders' AND attname IN ('created_at', 'customer_id', 'total_amount') ORDER BY 1;
CREATE INDEX ix_orders_created_at_btree ON orders (created_at);
CREATE INDEX ix_orders_created_at_brin ON orders USING brin (created_at);
attname | correlation
--------------+----------------
created_at | 1
customer_id | 0.033856127
total_amount | -0.00050482864
indexrelname | size
----------------------------+-------
ix_orders_created_at_brin | 24 kB
ix_orders_created_at_btree | 21 MBAynı kolon için B-tree 21 MB, BRIN 24 kB. B-tree'yi silip bir günün siparişlerini sorduk:
 Aggregate (actual rows=1.00 loops=1)
   Buffers: shared hit=133
   ->  Bitmap Heap Scan on orders (actual rows=720.00 loops=1)
         Recheck Cond: ((created_at >= '2026-10-01 00:00:00+00'::timestamp with time zone) AND (created_at < '2026-10-02 00:00:00+00'::timestamp with time zone))
         Rows Removed by Index Recheck: 11696
         Heap Blocks: lossy=128
         ->  Bitmap Index Scan on ix_orders_created_at_brin (actual rows=1280.00 loops=1)
BRIN satırları değil page aralıklarını bulur (lossy=128): varsayılan olarak 128 page'lik blokların özetini tutar, eşleşen bloğu bütünüyle okur ve satırları tek tek yeniden kontrol eder. 720 satır için 12.416 satır okundu, ama 1 milyonluk tablonun yalnızca 133 page'i. BRIN'in çalışması tamamen korelasyona bağlı: customer_id gibi rastgele dağılmış bir kolonda her blok neredeyse her değeri kapsar ve index işe yaramaz. Sipariş event'leri, log, ölçüm ve audit tabloları BRIN'in en çok işe yaradığı yerler; güncelleme ve silme fiziksel sırayı bozdukça etkisi azalır.
Hash index yalnızca eşitliği destekler. PostgreSQL 10'dan beri WAL (Write-Ahead Log; değişikliklerin önce yazıldığı log) ile korunuyor ve replikasyonda güvenle kullanılabiliyor; ondan önceki "hash index kullanma" uyarısı artık geçerli değil. Ama çoğu durumda avantajı da yok:
CREATE INDEX ix_orders_order_number_hash ON orders USING hash (order_number);
EXPLAIN (COSTS OFF) SELECT * FROM orders WHERE order_number > 'BK-00999990';
indexrelname | size
-----------------------------+-------
ix_orders_order_number_hash | 32 MB
ux_orders_order_number | 30 MB
Index Scan using ux_orders_order_number on orders
Index Cond: ((order_number)::text > 'BK-00999990'::text)Kısa sipariş numaralarında hash index B-tree'den küçük bile değil ve aralık sorgusu için planner B-tree'ye döndü; ayrıca hash index unique olamaz. Anlamlı olduğu yer, çok uzun değerler (URL, uzun hash) üzerinde yalnızca eşitlik aranan kolonlar: B-tree değerin tamamını saklar, hash index yalnızca 4 byte'lık hash'ini.
Partial ve Expression Index
Partial index tablonun yalnızca bir koşulu sağlayan satırlarını index'ler. Bir milyon siparişin 4.800'ü Pending; operasyon ekranı yalnızca bunlarla ilgileniyor:
CREATE INDEX ix_orders_pending ON orders (created_at) WHERE status = 'Pending';
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT order_id, created_at FROM orders WHERE status = 'Pending' ORDER BY created_at LIMIT 20;
EXPLAIN (COSTS OFF)
SELECT order_id FROM orders WHERE status IN ('Pending', 'PaymentPending') ORDER BY created_at LIMIT 20;
partial_size
--------------
128 kB
Limit (actual rows=20.00 loops=1)
Buffers: shared hit=1 read=2
-> Index Scan using ix_orders_pending on orders (actual rows=20.00 loops=1)
Limit
-> Sort
Sort Key: created_at
-> Seq Scan on orders
Filter: (status = ANY ('{Pending,PaymentPending}'::text[]))128 kB'lık index 3 page okuyarak cevap verdi. İkinci sorgu ise index'i kullanamadı: partial index ancak sorgunun koşulu index'in koşulunu mantıksal olarak kapsıyorsa kullanılır, IN ('Pending', 'PaymentPending') ise status = 'Pending''i garanti etmiyor. SQL Server'daki filtered index'in karşılığı; Çözüm Desenleri serisinin soft delete yazısındaki WHERE deleted_at IS NULL unique index'i de bu yapıyla kurulur.
Expression index ise bir ifadenin sonucunu index'ler. E-posta ile girişte büyük/küçük harf farkını yok saymak için:
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF, SUMMARY OFF)
SELECT customer_id FROM customers WHERE lower(email) = 'customer42@example.com';
CREATE INDEX ix_customers_email_lower ON customers (lower(email));
Seq Scan on customers (actual rows=1.00 loops=1)
Filter: (lower(email) = 'customer42@example.com'::text)
Rows Removed by Filter: 99999
Buffers: shared read=1165
Bitmap Heap Scan on customers (actual rows=1.00 loops=1)
Recheck Cond: (lower(email) = 'customer42@example.com'::text)
-> Bitmap Index Scan on ix_customers_email_lower (actual rows=1.00 loops=1)
Index Cond: (lower(email) = 'customer42@example.com'::text)
Buffers: shared read=3email üzerindeki unique index, lower(email) sorgusuna yardım etmedi; ifade birebir aynı olmalı. SQL Server'da aynı iş için önce computed column açıp onu index'lemek gerekir. Buraya kadar gördüklerimizi sorgunun biçimine göre bir araya koyalım:
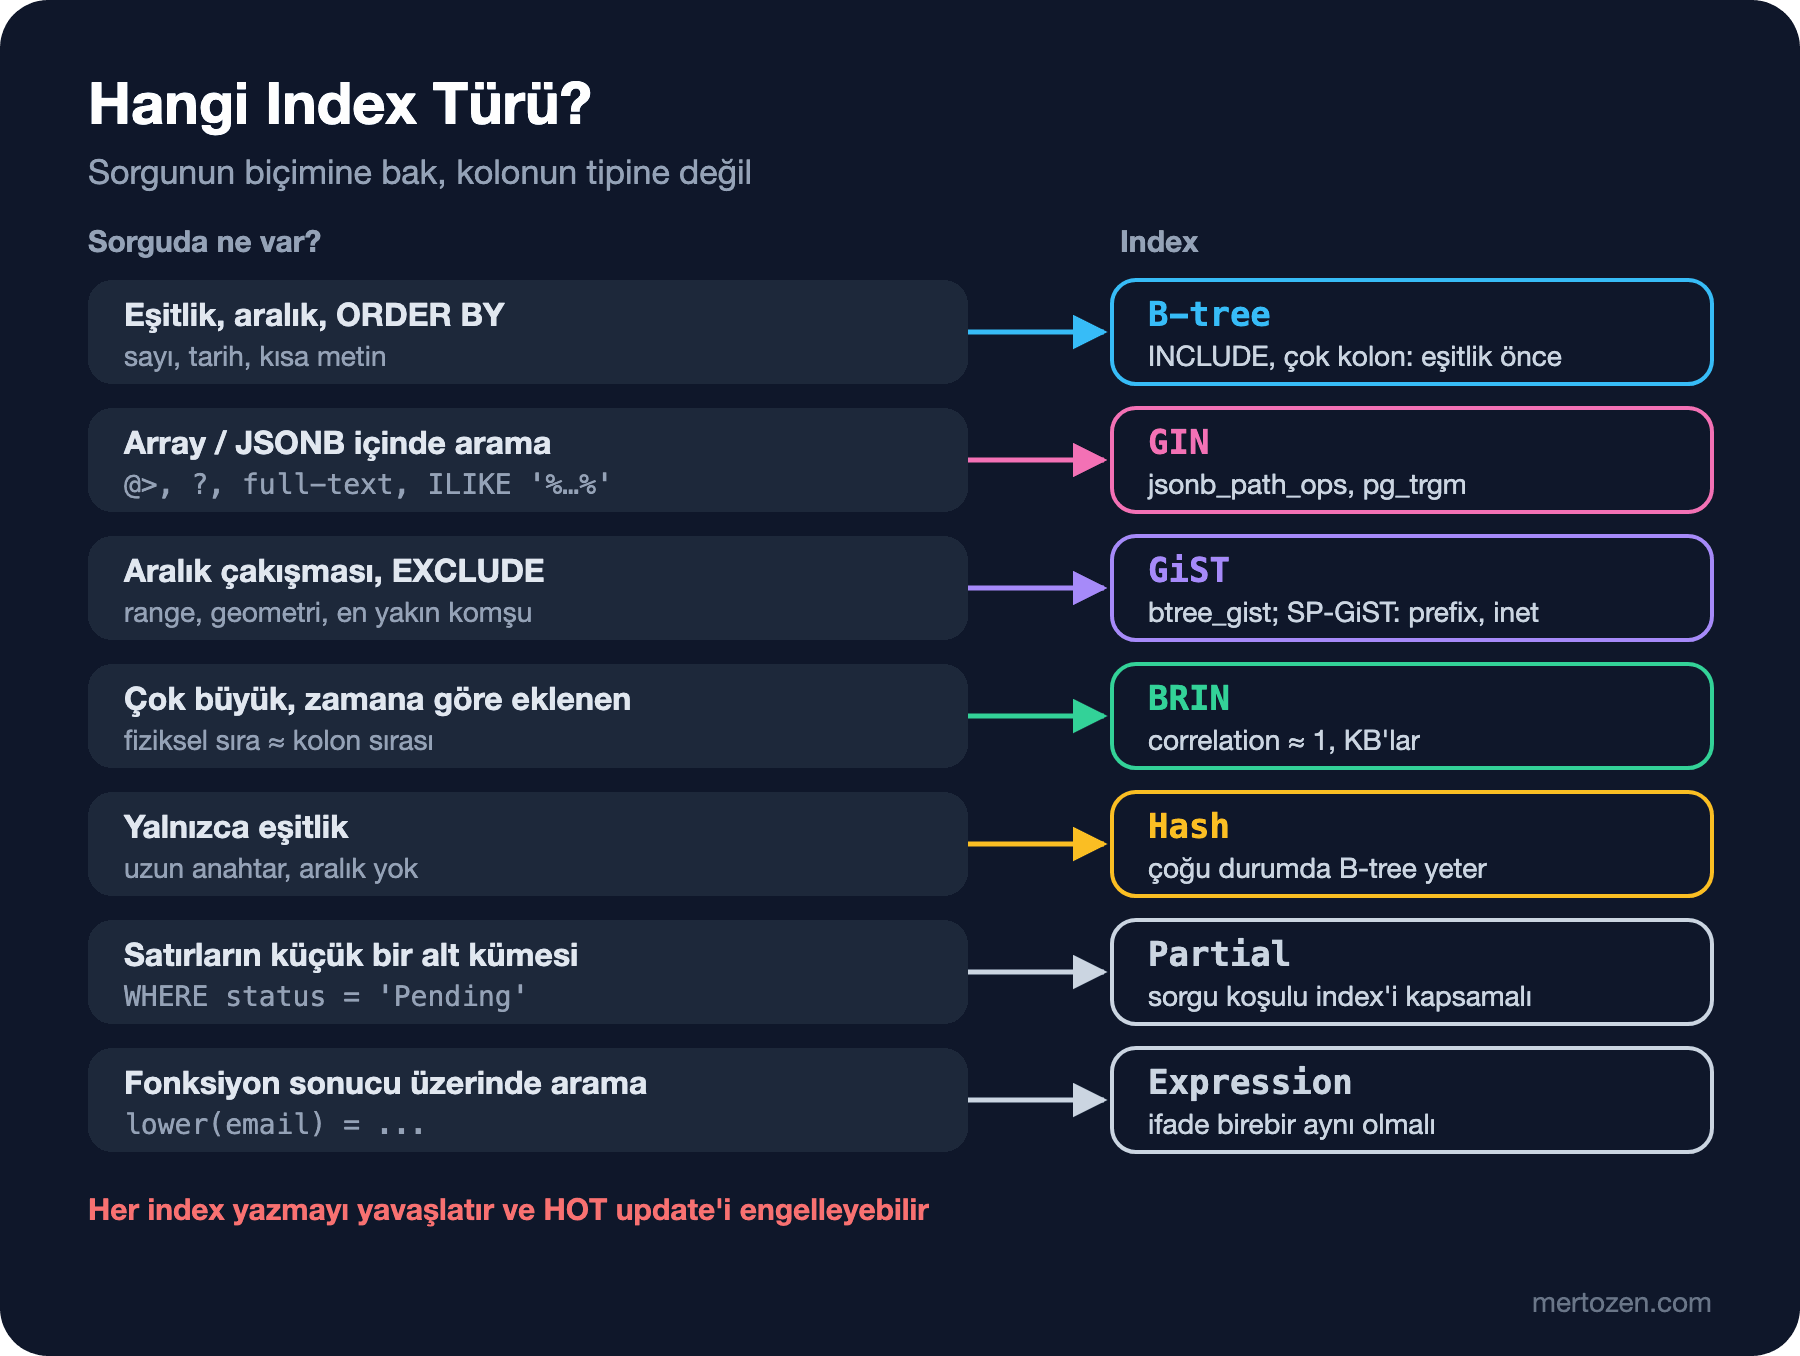
CREATE INDEX CONCURRENTLY ve INVALID Index
Normal CREATE INDEX süre boyunca tabloya yazmayı engeller (okuma serbest). Production'da büyük bir tabloya index eklemenin yolu CONCURRENTLY: tabloyu iki kez tarar, yazma işlemlerini engellemez, ama transaction içinde çalışamaz ve başarısız olursa arkasında iz bırakır. Soyadı ve adın tekil olduğunu varsayan bir unique index deneyelim:
CREATE UNIQUE INDEX CONCURRENTLY ux_customers_last_first ON customers (last_name, first_name);
SELECT indexrelid::regclass AS index_name, indisvalid, indisready FROM pg_index
WHERE indexrelid = 'ux_customers_last_first'::regclass;
\d customers
ERROR: could not create unique index "ux_customers_last_first"
DETAIL: Key (last_name, first_name)=(Borg, Linus) is duplicated.
index_name | indisvalid | indisready
-------------------------+------------+------------
ux_customers_last_first | f | f
Indexes:
"customers_pkey" PRIMARY KEY, btree (customer_id)
"ux_customers_email" UNIQUE, btree (email)
"ux_customers_last_first" UNIQUE, btree (last_name, first_name) INVALIDKomut hata verdi ama index silinmedi; INVALID olarak kaldı. Sorgular bu index'i kullanmaz, ama yerine göre yazmalarda güncellenmeye devam edebilir ve aynı adla yeniden oluşturmak istediğinde "already exists" hatası alırsın. Doğru temizlik DROP INDEX CONCURRENTLY ux_customers_last_first;, ardından sorunu giderip yeniden denemek. Migration araçlarında (EF Core migration'ında CONCURRENTLY kullanımı 12. yazıda) başarısız bir deploy'dan sonra pg_index'te indisvalid = false olan index kalıp kalmadığını kontrol etmek iyi bir alışkanlık.
Kullanılmayan Index'ler ve Yazma Maliyeti
Her index okumayı hızlandırma ihtimali taşır ama yazmayı kesin olarak yavaşlatır: her INSERT her index'e bir giriş ekler. PostgreSQL'de bunun bir bedeli daha var: HOT (Heap-Only Tuple; index'lenmiş kolon değişmediğinde yeni satır sürümünü aynı page'e yazıp index'e dokunmayan güncelleme) update. Page'lerinde boş yer bırakılmış (fillfactor = 80) bir stok tablosu kopyasında, önce index'siz bir kolonu güncelledik, sonra o kolona index ekleyip başka satırlarda aynı güncellemeyi yaptık:
CREATE TABLE stock_demo WITH (fillfactor = 80) AS SELECT * FROM stock_items;
ALTER TABLE stock_demo ADD PRIMARY KEY (book_id);
UPDATE stock_demo SET quantity_reserved = quantity_reserved + 1 WHERE book_id % 100 = 0;
SELECT n_tup_upd, n_tup_hot_upd FROM pg_stat_user_tables WHERE relname = 'stock_demo';
CREATE INDEX ix_stock_demo_reserved ON stock_demo (quantity_reserved);
UPDATE stock_demo SET quantity_reserved = quantity_reserved + 1 WHERE book_id % 100 = 50;
SELECT n_tup_upd, n_tup_hot_upd FROM pg_stat_user_tables WHERE relname = 'stock_demo';
n_tup_upd | n_tup_hot_upd
-----------+---------------
400 | 400
n_tup_upd | n_tup_hot_upd
-----------+---------------
800 | 400İlk 400 güncellemenin hepsi HOT oldu; index eklendikten sonraki 400'ün hiçbiri. HOT olmayan her güncelleme tablodaki her index'e yeni bir giriş yazar, index'leri şişirir ve VACUUM'a daha çok iş bırakır. Sık güncellenen kolonları (stok, durum, sayaç) index'lemeden önce bunun bedelini düşün; HOT ve fillfactor ayrıntıları 08'de.
Hangi index'in hiç kullanılmadığını pg_stat_user_indexes söyler:
SELECT indexrelname, idx_scan, pg_size_pretty(pg_relation_size(indexrelid)) AS size
FROM pg_stat_user_indexes
WHERE schemaname = 'public' AND relname IN ('orders', 'order_items', 'books')
ORDER BY pg_relation_size(indexrelid) DESC;
indexrelname | idx_scan | size
-------------------------+----------+---------
order_items_pkey | 0 | 54 MB
ix_order_items_order_id | 0 | 39 MB
ux_orders_order_number | 1 | 30 MB
orders_pkey | 2 | 21 MB
ix_order_items_book_id | 0 | 17 MB
ix_orders_customer_id | 1 | 9064 kB
ux_books_isbn | 0 | 1248 kB
books_pkey | 1 | 896 kB
ix_books_author_id | 0 | 408 kBLab'da şema yeni yüklendiği için sayaçlar neredeyse sıfır; production'da aynı sorgu haftalarca biriken istatistiğe bakar. idx_scan = 0 olan büyük bir index silme adayıdır, ama karar vermeden önce üç şeyi kontrol et: sayaçlar en son ne zaman sıfırlandı (pg_stat_reset, major upgrade), istatistikler her sunucuda ayrı tutulduğu için replica'larda bu index kullanılıyor mu, ve index bir unique ya da primary key constraint'ini mi taşıyor (o zaman kullanılmasa da gerekli). SQL Server'daki sys.dm_db_index_usage_stats'ın karşılığı.
SQL Server'dan gelenlerin sorduğu son soru: tabloyu bir index'e göre fiziksel olarak sıralamak mümkün mü? CLUSTER orders USING ix_orders_customer_id tabloyu o sıraya göre bir kez yeniden yazar, ama süre boyunca tabloyu tamamen kilitler ve sonradan eklenen satırlarda bu sıra korunmaz; SQL Server'daki clustered index gibi kalıcı bir düzen değil. PostgreSQL 19 bu işi kilitlemeden yapabilen REPACK komutunu getiriyor; serinin son yazısında.
Üretimde Dikkat
Index'i CONCURRENTLY ile ekle ve sil; uzun süren normal bir CREATE INDEX, tablo üzerindeki bütün yazmaları bekletir. CONCURRENTLY de bedava değil: tabloyu iki kez tarar, başlamadan önce tablodaki açık transaction'ların bitmesini bekler ve uzun bir transaction varsa saatlerce asılı kalabilir. lock_timeout ve statement_timeout ile sınırla.
Index'leri bellekle birlikte düşün: shared buffers ve işletim sistemi cache'i, sık kullanılan index'lerin üst seviyelerini tutabilmeli. Lab'daki order_items tablosunun kendisi 124 MB, yalnızca üç index'i ise toplam 109 MB. Gereksiz her index, cache'te sık kullanılan veriyle aynı yer için yarışır.
Büyük bir tabloya index eklemeden önce EXPLAIN ile index'in gerçekten seçileceğini, ekledikten sonra da pg_stat_user_indexes ile kullanıldığını doğrula. Planner'ın kararını 07'de okumayı öğreneceğiz.
Sık Düşülen Tuzaklar
Her kolona ayrı index: WHERE customer_id = ? AND status = ? gibi sorgular için iki tek kolonlu index yerine bir çok kolonlu index çoğu zaman daha iyi. PostgreSQL iki index'i bitmap ile birleştirebilir (BitmapAnd), ama bu, doğru sıralanmış tek bir index'ten pahalıdır.
Foreign key kolonlarını index'siz bırakmak: SQL Server gibi PostgreSQL de foreign key için otomatik index oluşturmaz. Parent satır silindiğinde ya da güncellendiğinde child tablo taranır; Bookstore şemasında bu yüzden ix_order_items_order_id gibi index'ler baştan var.
Fonksiyonla sarılmış kolona normal index'in yardım edeceğini sanmak: lower(email), created_at::date ya da (attributes ->> 'pages')::int gibi ifadeler için expression index gerekir, ya da sorguyu created_at >= ... AND created_at < ... biçiminde yeniden yazmak.
Başarısız CONCURRENTLY'den kalan INVALID index'i fark etmemek: hem disk kaplar hem de yazmaları yavaşlatabilir. SELECT indexrelid::regclass FROM pg_index WHERE NOT indisvalid; düzenli kontrol listende olsun.
Küçük Bir Deneme
★☆☆ order_items üzerinde (book_id) ve (book_id, order_id) index'lerinin boyutlarını karşılaştır. Deduplication hangisinde daha çok işe yarıyor, neden?
★★☆ shipments tablosunda shipped_at için B-tree ve BRIN index kur. pg_stats'taki korelasyona bakarak hangisinin bir haftalık aralık sorgusunda daha iyi olacağını tahmin et ve EXPLAIN (ANALYZE, BUFFERS) ile doğrula.
★★★ "Son 30 günde en çok satan kitaplar" sorgusu için orders ve order_items üzerinde bir index stratejisi tasarla. Önce index'siz planı kaydet, sonra index'leri ekle ve iki planın okuduğu page sayılarını karşılaştır. Bu sorguyu bir sonraki yazıda ayrıntılı okuyacağız.
Bir sonraki yazıda bu yazıdaki planları okurken üstünden geçtiğimiz şeyleri ayrıntılı açıyoruz: EXPLAIN (ANALYZE, BUFFERS), scan ve join node'ları, planner statistics ve yavaş sorguyu bulmak için pg_stat_statements.