

Node.js Stream'leri: Readable, Writable, Transform, pipeline() ve Backpressure

Node.js stream'leri veriyi parça parça işler; write() false döndüğünde drain'i beklemek, yani backpressure'a uymak belleği sabit tutar ve pipeline() bunu hata yönetimiyle birlikte her aşamaya bağlar. Gerçek ölçümlerle false'u yok sayan producer'ın heap'i 182 MB'a çıkarması, pipe()'ın kaynak dosyayı açık bırakması, 505 MB'lık Bookstore sipariş export'unun 147 MB RSS ile stream edilmesi ve aynı işin bellekte 993 MB tutması.
Sürüm notu: Bu yazıdaki örnekler Node.js 26.13.1 (LTS) ve TypeScript 7.0.2 ile çalıştırılmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore'da (bir online kitapçı) sipariş satırlarını bir hedefe yazıyoruz. Hedef yavaş: her chunk için 1 ms harcıyor, tıpkı yavaş bir client ya da meşgul bir disk gibi. Döngü 200.000 satırı arka arkaya yazıyor:
import { Writable } from "node:stream";

// Yavaş bir hedef: chunk başına 1 ms harcıyor (yavaş bir client, meşgul bir disk)
const slow = new Writable({
    write(chunk, encoding, callback) {
        setTimeout(callback, 1);
    },
});

let firstFalse = 0;
for (let i = 1; i <= 200_000; i++) {
    const ok = slow.write(`ORD-${100000 + i},9780441172719,2,349.90\n`);
    if (!ok && firstFalse === 0) {
        firstFalse = i;
    }
}
console.log(`highWaterMark: ${slow.writableHighWaterMark} bytes`);
console.log(`write() first returned false at line ${firstFalse}`);
console.log(`loop finished, buffered in memory: ${(slow.writableLength / 1024 / 1024).toFixed(1)} MB`);
// Demoyu burada durdur; 200.000 chunk'ı boşaltmak dakikalar sürer
slow.destroy();
Hedefin buffer'ı dolunca ne olur? write() bekler mi, hata mı fırlatır, satırları atar mı?
node labs/09/guess.tshighWaterMark: 65536 bytes
write() first returned false at line 1928
loop finished, buffered in memory: 6.5 MBHiçbiri. 1928. satırda buffer 64 KiB'ı geçti ve write() false döndürdü, ama yazmayı reddetmedi: döngü devam etti ve 200.000 satırın tamamı bellekte biriktirildi. false bir "dur" komutu değil, bir rica: "buffer'ım doldu, drain event'ini bekle". Ricaya uymayan bir producer, hedef ne kadar yavaşsa belleği o kadar doldurur. C#'ta await stream.WriteAsync(...) hedef hazır olana kadar seni zaten bekletir; Node'da write() await edilmez ve beklemek senin sorumluluğundur.
Bu kontrol mekanizmasına backpressure denir ve stream'lerin varlık sebebi budur. Bu yazıda dört stream tipini, backpressure'ı, pipeline()'ı, for await ile tüketmeyi ve Web Streams köprüsünü görüyoruz. Sonunda Bookstore'a 500 MB'lık bir sipariş export'unu sabit bellekle üreten bir endpoint ekliyoruz.
Dört Stream Tipi ve highWaterMark
Node'da stream'ler EventEmitter'dan türeyen dört class'tır:
- Readable: veri kaynağı.
fs.createReadStream, HTTP server'dakireq, client tarafında gelen response. - Writable: veri hedefi.
fs.createWriteStream, HTTP server'dakires,process.stdout. - Duplex: iki yönü birbirinden bağımsız olan, hem okunan hem yazılan stream. TCP socket'i.
- Transform: yazılanı dönüştürüp okunur hâle getiren Duplex.
zlib.createGzip(), şifreleme, CSV'ye (virgülle ayrılmış değerler) dönüştürme.
Her stream'in bir iç buffer'ı ve highWaterMark adında bir eşiği var. Byte stream'lerde varsayılan 64 KiB; Node 22'de 16 KiB'tan yükseltildi. objectMode'da stream byte yerine JavaScript object'leri taşır ve eşik object sayısıdır: varsayılan 16. Eşik bir sınır değil, bir işarettir: Writable'da buffer eşiği geçince write() false döner, Readable'da buffer eşiğe ulaşınca kaynaktan okuma durur.
.NET tarafında en yakın karşılık System.IO.Stream ve daha yeni olan System.IO.Pipelines. Pipelines'ta da PauseWriterThreshold ve ResumeWriterThreshold ile aynı fikir var; fark, C#'ta beklemenin await FlushAsync() ile dile gömülü olması.
Backpressure'a Uymak
Önce Tahmin Et'teki döngüyü iki şekilde, bu kez 1.000.000 satırla ve her chunk'ı bir event loop turunda işleyen bir hedefle çalıştıralım:
import { Writable } from "node:stream";
import { once } from "node:events";

// Producer'dan yavaş bir hedef: chunk başına bir event loop turu
function slowDestination(): Writable {
    return new Writable({
        write(chunk, encoding, callback) {
            setImmediate(callback);
        },
    });
}

async function produce(respectBackpressure: boolean): Promise<void> {
    const out = slowDestination();
    let peak = 0;
    let peakHeap = 0;
    const started = performance.now();
    for (let i = 1; i <= 1_000_000; i++) {
        const ok = out.write(`ORD-${100000 + i},9780441172719,2,349.90\n`);
        peak = Math.max(peak, out.writableLength);
        if (i % 10_000 === 0) {
            peakHeap = Math.max(peakHeap, process.memoryUsage().heapUsed);
        }
        if (!ok && respectBackpressure) {
            // Hedef buffer'ını boşaltana kadar bekle
            await once(out, "drain");
        }
    }
    out.end();
    await once(out, "finish");
    const label = respectBackpressure ? "await drain" : "ignore false";
    console.log(`${label.padEnd(13)} peak buffer ${(peak / 1024 / 1024).toFixed(2).padStart(6)} MB, peak heap ${(peakHeap / 1024 / 1024).toFixed(0).padStart(3)} MB, ${Math.round(performance.now() - started)} ms`);
}

await produce(process.argv[2] !== "ignore");
node labs/09/backpressure.ts ignore
node labs/09/backpressure.tsignore false peak buffer 32.52 MB, peak heap 182 MB, 15398 ms
await drain peak buffer 0.06 MB, peak heap 21 MB, 14667 msToplam süre neredeyse aynı, çünkü darboğaz hedef. Fark bellekte: false'u yok sayan sürüm 32,5 MB veriyi buffer'da tuttu ve heap 182 MB'a çıktı; her küçük string için ayrı bir buffer kaydı tutulduğu için heap, verinin beş katından fazla. drain'i bekleyen sürümde buffer 64 KiB'ın üzerine hiç çıkmadı. Bir HTTP sunucusunda "hedef" yavaş bir mobil client olabilir; backpressure'ı yok sayan bir endpoint, aynı anda indiren on yavaş client ile process'i belleksiz bırakabilir.
İyi haber: write()/drain döngüsünü çoğu zaman elle yazmazsın. Stream'leri birbirine bağladığında backpressure'ı Node yönetir. Asıl soru, nasıl bağladığın.
pipe() Neden Yetmez: stream/promises pipeline()
Stream'leri bağlamanın eski yolu source.pipe(destination). Backpressure'ı doğru yönetir, ama hataları yönetmez. Ortadaki aşaması üçüncü chunk'ta hata veren bir zinciri iki yolla kuralım:
import { createReadStream } from "node:fs";
import { Transform, Writable } from "node:stream";
import { pipeline } from "node:stream/promises";

// Üçüncü chunk'ta hata veren bir transform (dosyanın ortasında bozuk veri)
function failingTransform(): Transform {
    let chunks = 0;
    return new Transform({
        transform(chunk, encoding, callback) {
            chunks++;
            callback(chunks === 3 ? new Error("bad row in chunk 3") : null, chunk);
        },
    });
}

const input = import.meta.filename;
// Gelen her şeyi atar
const sink = () => new Writable({ write: (chunk, encoding, callback) => callback() });

if (process.argv[2] === "pipe") {
    const source = createReadStream(input, { highWaterMark: 256 });
    const transform = failingTransform();
    transform.on("error", (err) => console.log(`pipe: transform error: ${err.message}`));
    source.pipe(transform).pipe(sink());
    setTimeout(() => console.log(`pipe: source destroyed? ${source.destroyed}, file closed? ${source.closed}`), 100);
} else {
    const source = createReadStream(input, { highWaterMark: 256 });
    try {
        await pipeline(source, failingTransform(), sink());
    } catch (err) {
        console.log(`pipeline: rejected with: ${(err as Error).message}`);
    }
    console.log(`pipeline: source destroyed? ${source.destroyed}, file closed? ${source.closed}`);
}
pipe: transform error: bad row in chunk 3
pipe: source destroyed? false, file closed? false
pipeline: rejected with: bad row in chunk 3
pipeline: source destroyed? true, file closed? truepipe() ile hata yalnız hata veren stream'de kaldı: kaynak dosya açık, kimse onu kapatmıyor. Her istekte bir dosya açan bir sunucuda bu, yavaş yavaş biriken bir file descriptor leak'i. Transform'un error'ını dinlemeseydik process çökerdi (07). pipeline() ise zincirin her aşamasına hem backpressure'ı hem hata yönetimini bağlıyor: bir aşama hata verirse ya da kapanırsa hepsini destroy ediyor ve tek bir promise reject oluyor. Kural: yeni kodda pipe() değil, node:stream/promises'tan pipeline().
Readable.from, for await ve Web Streams
Bir Readable'ı tüketmenin en okunur yolu for await: Readable'lar async iterable ve döngü, gövde işini bitirene kadar bir sonraki chunk'ı istemiyor, yani backpressure kendiliğinden işliyor. Ters yönde Readable.from(), bir array'i, generator'ı ya da async generator'ı Readable'a çeviriyor; generator'lar sayesinde veri ancak istendiğinde üretiliyor. Generator ve async iterator'ın kendisi JavaScript İleri serisinde anlatıldı.
Tarayıcıdan gelen bir standart daha var: Web Streams (ReadableStream, WritableStream, TransformStream). Node'un global fetch'i response body'sini bir web ReadableStream olarak veriyor. İki dünya arasında köprü Readable.fromWeb() ve Readable.toWeb(). Aşağıdaki client, birazdan yazacağımız export endpoint'inden 1 milyon satırı satır satır okuyor; node:readline bir Node stream'i beklediği için body'yi köprüden geçiriyoruz:
import { Readable } from "node:stream";
import type { ReadableStream as NodeReadableStream } from "node:stream/web";
import { createInterface } from "node:readline";

const base = process.env.API_URL ?? "http://127.0.0.1:3000";

// 1) Export'u satır satır oku: fetch bir web ReadableStream veriyor, readline Node stream'i istiyor
const response = await fetch(`${base}/api/orders/export?rows=1000000`, { headers: { "accept-encoding": "gzip" } });
console.log(`content-encoding: ${response.headers.get("content-encoding")}`);
// fetch'in body'si DOM lib'iyle tiplenmiş; runtime'da Node'un stream/web tipiyle aynı object
const body = response.body as NodeReadableStream<Uint8Array>;
const lines = createInterface({ input: Readable.fromWeb(body), crlfDelay: Infinity });

let count = 0;
let deliveredRevenue = 0;
for await (const line of lines) {
    if (count++ === 0) {
        continue; // başlık satırı
    }
    const fields = line.split(",");
    if (fields[8] === "Delivered") {
        deliveredRevenue += Number(fields[5]) * Number(fields[6]);
    }
}
console.log(`rows: ${count - 1}, delivered revenue: ${deliveredRevenue.toFixed(2)} TRY, heap ${(process.memoryUsage().heapUsed / 1024 / 1024).toFixed(0)} MB`);

// 2) Yarıda vazgeç: sunucu satır üretmeyi bırakmalı
const controller = new AbortController();
const big = await fetch(`${base}/api/orders/export?rows=5300000`, { signal: controller.signal });
let received = 0;
try {
    for await (const chunk of big.body!) {
        received += chunk.byteLength;
        if (received > 50 * 1024 * 1024) {
            controller.abort();
        }
    }
} catch (err) {
    console.log(`client stopped after ${(received / 1024 / 1024).toFixed(0)} MB: ${(err as Error).name}`);
}
Tipteki cast bir TypeScript ayrıntısı: fetch'in tipi DOM (tarayıcı API'lerinin tip tanımları) kütüphanesinden, Readable.fromWeb'in parametresi @types/node'dan geliyor ve TypeScript 7 ikisini uyumsuz sayıyor. Runtime'da aynı object. fetch gzip'li cevabı kendisi açıyor, bu yüzden readline'a düz metin geliyor. Çıktıyı Bookstore bölümünde göreceğiz.
Bookstore: 500 MB'lık Sipariş Export'u
Muhasebe ekibi yılın bütün sipariş satırlarını CSV olarak istiyor: 5,3 milyon satır, yaklaşık 505 MB. Veritabanına 13'te geçeceğiz; şimdilik satırları deterministik olarak üreten bir generator var. Önemli olan, satırların tek tek ve ancak istendiğinde üretilmesi:
const HEADER = "orderId,createdAtUtc,customerId,isbn,title,quantity,unitPrice,currency,status\n";
const START = Date.UTC(2026, 0, 1);

// SQL Server yazısına kadar sentetik sipariş satırları; tembel üretilir, her seferinde bir satır
export function* generateOrderRows(count: number): Generator<OrderExportRow> {
    const books = listBooks();
    for (let i = 0; i < count; i++) {
        const book = books[i % books.length];
        yield {
            orderId: `ORD-${100001 + i}`,
            createdAtUtc: new Date(START + i * 7_000).toISOString(),
            customerId: `customer-${String(i % 50_000).padStart(5, "0")}`,
            isbn: book.isbn,
            title: book.title,
            quantity: (i % 3) + 1,
            unitPrice: book.price,
            currency: book.currency,
            status: ORDER_STATUSES[i % ORDER_STATUSES.length],
        };
    }
}

// RFC 4180 tırnaklama: değer virgül, tırnak ya da satır sonu içeriyorsa tırnak içine al
function csvField(value: string | number): string {
    const text = String(value);
    return /[",\r\n]/.test(text) ? `"${text.replaceAll('"', '""')}"` : text;
}

export function toCsvLine(row: OrderExportRow): string {
    return [row.orderId, row.createdAtUtc, row.customerId, row.isbn, row.title, row.quantity, row.unitPrice.toFixed(2), row.currency, row.status]
        .map(csvField)
        .join(",") + "\n";
}

// Object mode girer, metin çıkar; her satır için ayrı küçük bir string yerine birkaç KB'lık chunk'lar üretir
export function csvTransform(batchSize = 200): Transform {
    let batch: string[] = [HEADER];
    return new Transform({
        writableObjectMode: true,
        transform(row: OrderExportRow, encoding, callback) {
            batch.push(toCsvLine(row));
            if (batch.length >= batchSize) {
                const chunk = batch.join("");
                batch = [];
                callback(null, chunk);
            } else {
                callback();
            }
        },
        flush(callback) {
            callback(null, batch.join(""));
        },
    });
}csvTransform'un girişi object mode (writableObjectMode), çıkışı metin. Satırları 200'lük gruplar hâlinde birleştirmemizin nedeni backpressure deneyinde gördüğümüz chunk başına maliyet. flush, kaynak bittiğinde son yarım grubu gönderiyor. Route, aşamaları client'ın Accept-Encoding'ine göre kuruyor ve hepsini pipeline() ile response'a bağlıyor:
// GET /api/orders/export?rows=N: CSV, client kabul ediyorsa gzip'li
export async function handleOrderExport(req: IncomingMessage, res: ServerResponse, url: URL): Promise<void> {
    const rows = Number(url.searchParams.get("rows") ?? 100_000);
    const gzip = /\bgzip\b/.test(req.headers["accept-encoding"] ?? "");
    const started = performance.now();

    res.writeHead(200, {
        "content-type": "text/csv; charset=utf-8",
        "content-disposition": 'attachment; filename="orders.csv"',
        ...(gzip ? { "content-encoding": "gzip" } : {}),
    });

    const stages = gzip ? [csvTransform(), createGzip()] : [csvTransform()];
    try {
        // pipeline backpressure'ı bütün aşamalara bağlar ve hata olursa hepsini destroy eder
        await pipeline(orderRowStream(rows), ...stages, res);
        log("info", "order export finished", { rows, gzip, durationMs: Math.round(performance.now() - started) });
    } catch (err) {
        // İndirmenin ortasında bağlantıyı kesen client buraya ERR_STREAM_PREMATURE_CLOSE olarak düşer
        log("warn", "order export aborted", { error: (err as NodeJS.ErrnoException).code ?? (err as Error).message, durationMs: Math.round(performance.now() - started) });
    }
}orderRowStream(rows), Readable.from(generateOrderRows(rows))'u döndürüyor. Zinciri görsel olarak şöyle düşünebilirsin:
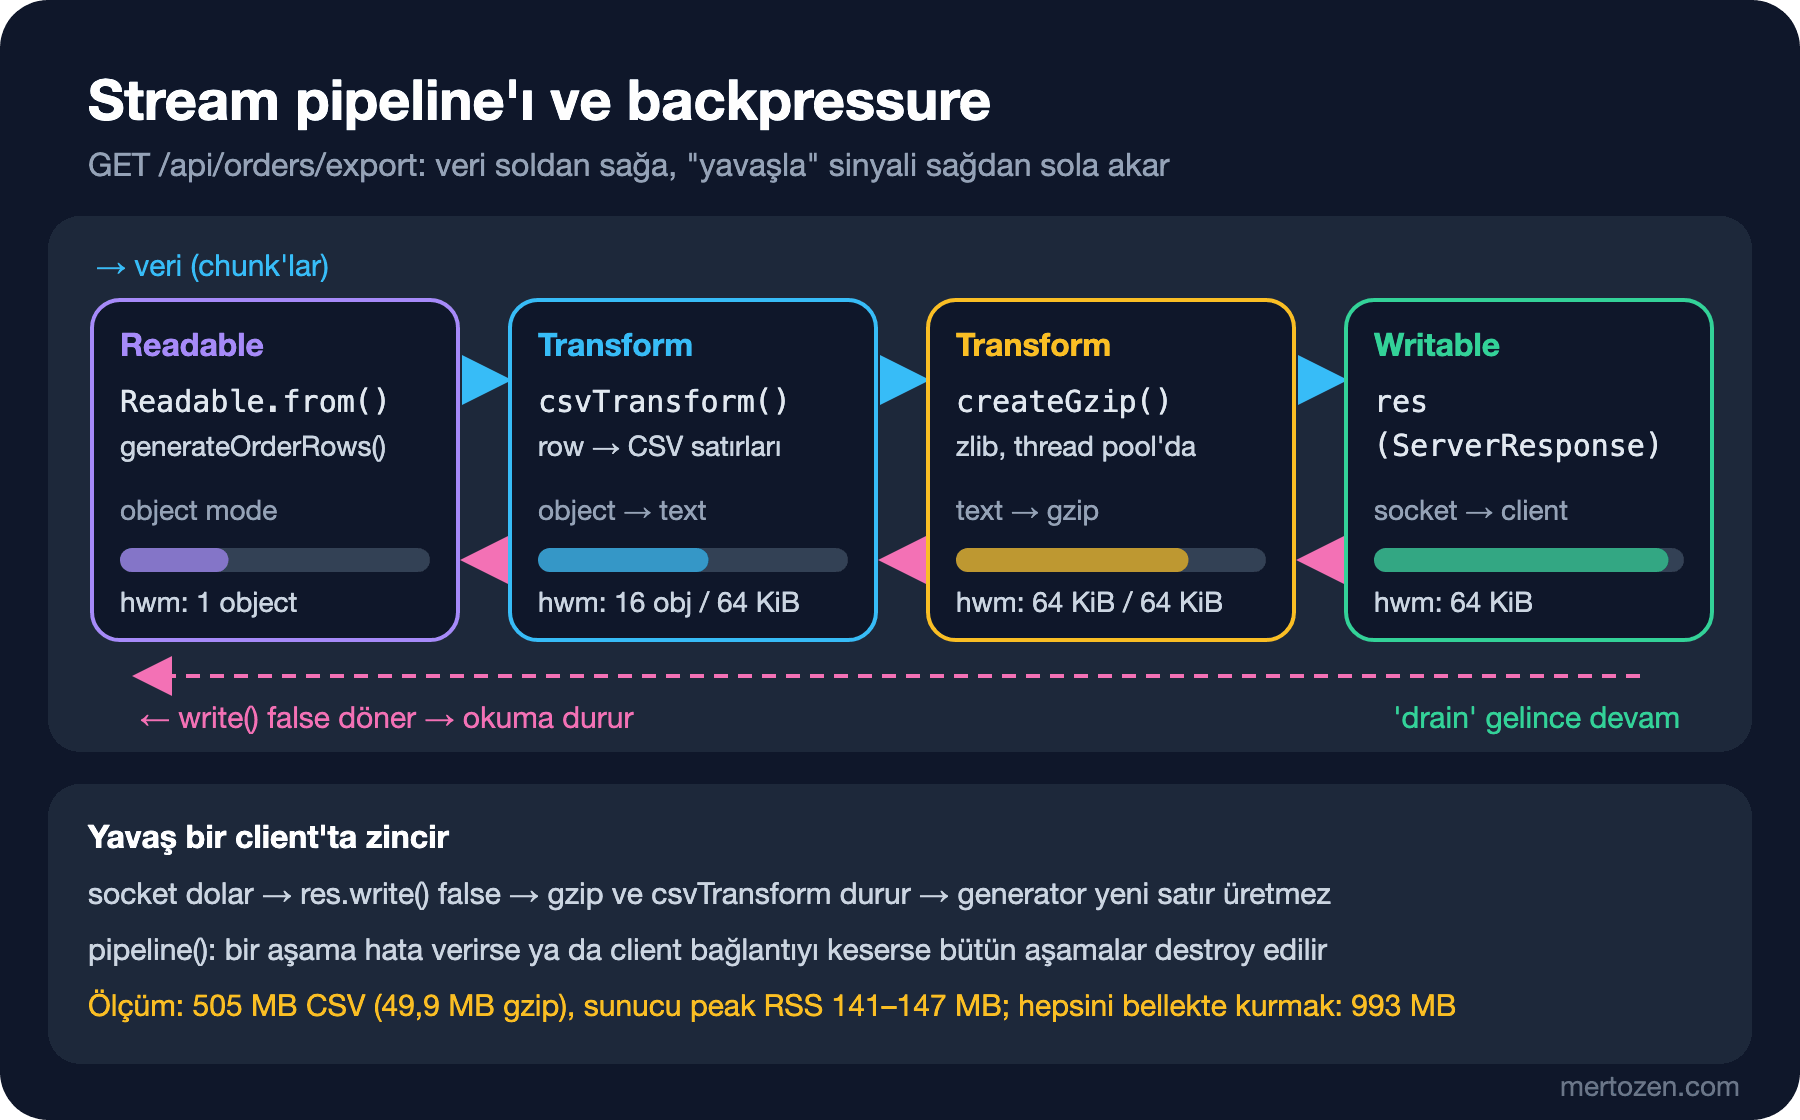
Ölçelim. Sunucuyu başlattım, export'u önce düz, sonra gzip'li indirdim ve bu sırada sunucu process'inin RSS'ini (Resident Set Size; process'in fiziksel bellekte kapladığı alan) 50 ms'de bir örnekledim:
curl -s "http://127.0.0.1:3000/api/orders/export?rows=3"
curl -s -o orders.csv -w "plain: %{size_download} bytes, ttfb %{time_starttransfer}s, total %{time_total}s\n" "http://127.0.0.1:3000/api/orders/export?rows=5300000"
curl -s -H "Accept-Encoding: gzip" -o orders.csv.gz -w "gzip: %{size_download} bytes, ttfb %{time_starttransfer}s, total %{time_total}s\n" "http://127.0.0.1:3000/api/orders/export?rows=5300000"
orderId,createdAtUtc,customerId,isbn,title,quantity,unitPrice,currency,status
ORD-100001,2026-01-01T00:00:00.000Z,customer-00000,9780441172719,Dune,1,349.90,TRY,Pending
ORD-100002,2026-01-01T00:00:07.000Z,customer-00001,9780547928227,The Hobbit,2,289.50,TRY,Paid
ORD-100003,2026-01-01T00:00:14.000Z,customer-00002,9780141439600,Middlemarch,3,310.00,TRY,Shipped
plain: 504985079 bytes, ttfb 0.003997s, total 5.175213s
gzip: 49924987 bytes, ttfb 0.003204s, total 5.947556sBoştaki process 85 MB RSS kullanıyordu; 505 MB'lık export sırasında en yüksek değer düzde 141 MB, gzip'te 147 MB oldu. İlk byte 4 ms'de geldi. Karşılaştırma için aynı CSV'yi "basit" yoldan, yani bütün satırları bir string'de birleştirip gzipSync ile sıkıştırarak üreten bir script yazdım:
// "Basit" yol: CSV'nin tamamını bellekte kur, sonra tek seferde sıkıştır
const rows = Number(process.argv[2] ?? 5_300_000);
const started = performance.now();
let peakRss = 0;
const lines: string[] = [];
for (const row of generateOrderRows(rows)) {
    lines.push(toCsvLine(row));
    if (lines.length % 100_000 === 0) {
        peakRss = Math.max(peakRss, process.memoryUsage().rss);
    }
}
try {
    const csv = lines.join("");
    const gzipped = gzipSync(csv);
    peakRss = Math.max(peakRss, process.memoryUsage().rss);
    console.log(`${rows} rows: csv ${(csv.length / 1e6).toFixed(0)} MB, gzip ${(gzipped.length / 1e6).toFixed(1)} MB, peak rss ${(peakRss / 1024 / 1024).toFixed(0)} MB, ${Math.round(performance.now() - started)} ms before the first byte`);
} catch (err) {
    console.log(`${rows} rows: ${(err as Error).name}: ${(err as Error).message} after ${Math.round(performance.now() - started)} ms, peak rss ${(peakRss / 1024 / 1024).toFixed(0)} MB`);
}
node labs/09/naive-export.ts 5300000
node labs/09/naive-export.ts 60000005300000 rows: csv 505 MB, gzip 49.9 MB, peak rss 993 MB, 6924 ms before the first byte
6000000 rows: RangeError: Invalid string length after 5861 ms, peak rss 485 MBBasit yol 993 MB'a çıktı ve client ilk byte'ı ancak 6,9 saniye sonra alabilirdi; bu sürede gzipSync event loop'u da blokladı. 6 milyon satırda ise hiç sonuç yok: V8'de (Node'un JavaScript engine'i) bir string'in uzunluğu yaklaşık 512 MB ile sınırlı (buffer.constants.MAX_STRING_LENGTH bu makinede 536.870.888 karakter) ve join RangeError fırlattı. Stream'li sürümde ise satır sayısının bir sınırı yok; bellek, satır sayısından bağımsız.
Client tarafındaki koşunun çıktısı ve sunucunun log'u:
content-encoding: gzip
rows: 1000000, delivered revenue: 119440060.40 TRY, heap 14 MB
client stopped after 50 MB: AbortError
{"time":"2026-11-14T18:50:36.334Z","level":"info","requestId":"e819714c-6e0c-4f19-89fe-79c3b72b3cb2","msg":"order export finished","rows":1000000,"gzip":true,"durationMs":1145}
{"time":"2026-11-14T18:50:37.015Z","level":"warn","requestId":"12f3eb03-3527-4851-a7a5-99b632f5dd89","msg":"order export aborted","error":"ERR_STREAM_PREMATURE_CLOSE","durationMs":680}Client 1 milyon satırı 14 MB heap ile işledi. İkinci istekte client 50 MB'ta vazgeçti; sunucu bunu ERR_STREAM_PREMATURE_CLOSE olarak gördü ve export 680 ms'de durdu. Tam export 5,2 saniye sürüyordu, yani generator gerçekten satır üretmeyi bıraktı. pipeline() olmasaydı kapanan socket'e rağmen generator boşuna dönmeye devam edebilirdi. Bu, 07'de kurmayı ertelediğimiz "client gitti" iptalinin stream tarafı; ASP.NET Core'daki HttpContext.RequestAborted'ın yaptığını burada pipeline yapıyor.
Üretimde Dikkat
Büyük cevapları stream et, büyük request body'lerine sınır koy. 06'da 85 MB'lık bir JSON.parse'ın event loop'u 149 ms durdurduğunu görmüştük; export, rapor ve dosya indirme gibi cevaplar stream ile üretilmeli. Gelen body'leri stream olarak okurken de toplam boyutu say ve sınırı aşınca isteği kes; bunu 10'da yazacağız.
Sıkıştırmayı nerede yaptığına karar ver. Async zlib thread pool'da çalışıyor ve export sırasında 4 thread'in birini meşgul ediyor. Önünde Nginx ya da YARP (Microsoft'un .NET ile yazılmış reverse proxy'si) gibi bir reverse proxy ya da CDN (içeriği kullanıcıya yakın sunuculardan dağıtan ağ) varsa sıkıştırmayı orada yapmak daha ucuz olabilir; iki yerde birden sıkıştırma.
Uzun süren indirmelerde aradaki katmanları hesaba kat. Node'un HTTP sunucusu cevabın süresini kendisi sınırlamıyor: requestTimeout (varsayılan 300 saniye) yalnız isteğin client'tan alınmasını kapsıyor. Bunu denedim: requestTimeout'u 1 saniyeye indirince 3 saniye süren bir cevap sorunsuz tamamlandı. Ayarları 10'da göreceğiz. Ama önündeki load balancer'ın ya da reverse proxy'nin kendi timeout'ları var. Gerçekten büyük export'lar için en sağlamı işi arka planda yapıp dosyayı object storage'a koymak ve client'a bir indirme linki vermek.
Hata stream başladıktan sonra olursa status kodu artık değiştirilemez: 200 ve header'lar çoktan gitti. Client yarım bir dosya alır; sunucu bağlantıyı keserek bunu belli eder. Export'un sonuna bir satır sayısı ya da checksum koymak, client'ın yarım dosyayı fark etmesini kolaylaştırır.
Sık Düşülen Tuzaklar
Büyük dosyayı readFile ile okumak. 08'deki CSV içe aktarma küçük dosyalar içindi; yüz MB'lık bir dosyayı createReadStream ve readline ile satır satır oku.
Error handler'sız pipe(). Hata kaynağı açık bırakır, dinlenmeyen error process'i düşürür. pipeline() kullan.
Stream'i iki kez tüketmek. Bir Readable bir kez okunur; ikinci for await ya da ikinci pipeline boş döner. Aynı veriyi iki hedefe göndermek gerekiyorsa kaynağı iki kez oluştur ya da bilinçli olarak tee'le.
write()'ın dönüş değerini yok saymak. Elle yazdığın her döngüde false gelince drain'i bekle.
Chunk başına çok küçük veri yazmak. Her satırı ayrı chunk olarak yazmak doğru çalışır ama yavaştır; satırları gruplayarak yaz.
Küçük Bir Deneme
★☆☆ csvTransform'u batchSize 1 ve 2.000 ile çalıştırıp 1 milyon satırlık export'un süresini ölç. Fark nereden geliyor?
★★☆ Export'a status query parametresi ekle (örneğin ?status=Delivered) ve filtreyi csvTransform'dan önce çalışan ayrı bir object mode Transform olarak yaz. Bellek kullanımı değişiyor mu?
★★★ 08'deki katalog içe aktarmayı createReadStream, readline ve for await ile yeniden yaz ve 1 milyon satırlık bir CSV ile dene. BOM'u (08'deki görünmez encoding işareti) ve Türkçe karakterleri hâlâ doğru işlediğinden emin ol.
Şimdiye kadar src/server.ts'teki if zinciri ile idare ettik. Bir sonraki yazıda node:http'nin kendisine yakından bakıyoruz: request body'sini boyut limitiyle okumak, header'lar, keep-alive ve timeout ayarları, elle yazılmış bir routing tablosu ve POST /api/orders. Sonunda bir framework'e neden ihtiyaç duyduğumuzun listesini çıkaracağız.