

Internal Linking: Anchor Text, Orphan Sayfalar, Link Derinliği ve C# ile Kendi Link Graph'ını Çıkarmak
Internal link'ler Google'a hem yeni sayfaları keşfettirir hem de anchor text ile ne hakkında olduklarını anlatır; önemli her sayfa sitedeki en az bir sayfadan gerçek bir <a href> link'i almalıdır. Crawlable link kurallarını, anchor text'i, orphan sayfaları ve link derinliğini anlatıyor, .NET 10 ve AngleSharp ile sitemap'ten başlayan bir crawler yazıp orphan, derin sayfa, redirect zinciri ve nofollow'u raporluyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve AngleSharp 1.10.3 ile derlenip denenmiştir; Google'ın link best practices dokümanının ve Search Console Links raporunun Kasım 2026 hâlini esas alır.
Önce Tahmin Et
Bookstore blog'unda iki yeni yazı var. "Dapper ile Toplu Insert" sitemap'te; ona giden tek yol, Entity Framework Core (EF Core) ile Dapper'ı karşılaştıran yazıdaki bir metin parçası: tıklayınca JavaScript ile yeni sayfaya gidiyor. "Kitap Önerileri 2023" ise blog listesinin üçüncü sayfasında, ana sayfadan dört tık uzakta. Bir de ekip, sayfa düzenindeki "Hakkımızda" link'ine "önemli değil" diye rel="nofollow" koymuş. Sence Google bu iki yazıyı link'ler üzerinden bulabilir mi? Bulduğunda onlar hakkında ne anlar? Ve nofollow, link'in gittiği sayfa için bir şey değiştirir mi?
Google Link'leri Ne İçin Kullanır?
Google'ın link'lerle iki işi var. Birincisi keşif: Google'ın başlangıç rehberine (SEO Starter Guide) göre Google'ın bulduğu yeni sayfaların çoğu link'ler üzerinden geliyor. Sitemap yardımcı olur, ama bir sayfanın sitenin geri kalanıyla bağı yoksa Google'ın gözünde o sayfa sitenin bir parçası gibi durmaz. İkincisi bağlam: link'in metni (anchor text) ve çevresindeki cümle, hem okura hem Google'a hedef sayfanın ne hakkında olduğunu söyler. Google'ın link best practices dokümanının internal link için verdiği kural kısa: önemsediğin her sayfa, sitedeki en az bir başka sayfadan link almalı.
Internal linking, önceki yazıda kurduğumuz mimariyi ayakta tutan şey. Hub ile cluster arasındaki ilişki, seri içindeki sıra ve cannibalization çözümündeki "ayrı sayfaya link ver" kararı, hepsi link olarak sayfada yer alıyor.
Crawlable Link: Google Neyi Link Sayar?
Google bir link'i genellikle yalnız href attribute'u olan bir <a> element'iyse takip edebiliyor. href'in değeri tam bir URL, kök göreli bir path ya da göreli bir path olabilir; class veya onclick gibi ek attribute'lar sorun değil. Dokümanın önermediği örnekler ise bir frontend geliştiricisine tanıdık gelecek: <a routerLink="..."> gibi href'siz link'ler, <span href="..."> ve yalnız onclick ile çalışan element'ler. javascript:goTo('products') gibi gerçek bir adrese çözülmeyen href değerleri de önerilmiyor.
JavaScript ile sonradan eklenen link'ler, render edilmiş HTML'de aynı <a href> biçiminde duruyorsa crawl edilebilir. Bunu URL Inspection aracında render edilmiş HTML'e bakarak doğrulayabilirsin. Googlebot'un JavaScript'i nasıl render ettiğini Teknik SEO serisinin JavaScript SEO yazısında anlattık. Bookstore'daki "Dapper ile Toplu Insert" yazısına giden yol tam olarak önerilmeyen türden: <span onclick="location.href='...'">. Okur tıklayınca sayfa açılıyor, ama crawler için orada bir link yok.
Anchor Text
Anchor text, link'in görünen metni. Google'ın önerisi, açıklayıcı, makul uzunlukta ve hem bulunduğu sayfayla hem hedef sayfayla ilgili olması; iyi bir test, metnin bağlamından koparıldığında da anlamlı kalıp kalmadığı. "Buraya tıklayın", "devamını oku", "bu yazı" gibi genel metinler bu testi geçemiyor. Çok uzun anchor'lar da önerilmiyor; doküman uzun bir cümleyi asıl anlamı taşıyan birkaç kelimeye indirmeyi öneriyor.
Diğer uç da sorunlu: anchor'ı keyword'lerle doldurmak. Doküman, okura yardım etmeyen bir keyword'ü anchor'a eklememeyi açıkça söylüyor. Link'in çevresindeki cümle de önemli; birkaç kelimeyi ayrı ayrı link'leyip art arda dizmek yerine link'leri bağlam içinde, aralarında metinle vermek gerekiyor. Görsel bir link'se, görselin alt metni anchor text yerine geçiyor; boş alt, açıklamasız bir link demek.
Bookstore'dan iki örnek: "EF Core ile şema değişiklikleri için buraya tıklayın" cümlesindeki "buraya tıklayın" hiçbir şey anlatmıyor; aynı link "şema değişikliklerini EF Core migration'larıyla yönetmek" metniyle verildiğinde hem okur hem Google hedefi anlıyor. Öte yandan "ef core migration ef core migration nasıl yapılır rehberi" gibi bir anchor, aynı bilgiyi okuru yorarak veriyor.
Orphan Sayfa, Derinlik ve Seri Navigasyonu
Orphan sayfa, sitede hiçbir sayfadan link almayan sayfa. Sitemap'te olabilir, Google onu sitemap'ten keşfedebilir, ama sitenin geri kalanıyla bağı yok: ne bir anchor text onu anlatıyor ne de okur ona sitede gezinerek ulaşabiliyor. CMS'te (içerik yönetim sistemi) listeye girmeyen, yanlış kategoride kalan ya da yalnız bir JavaScript düğmesiyle bağlanan yazılar tipik orphan'lardır.
Link derinliği, bir sayfaya ana sayfadan en az kaç tıkla ulaşıldığı. Google bir derinlik sınırı açıklamıyor; ama derin sayfalara giden yol çoğu zaman tek bir sayfalama zincirinden geçiyor ve bu sayfalar az link alıyor. En yaygın neden sayfalama: blog listesi 12'şer yazı gösteriyorsa, iki yıllık bir yazı onuncu sayfada, yani ana sayfadan on tıktan fazla uzakta. Seri yapısı bu derinliği kısaltıyor: seri hub'ı her yazıya doğrudan link veriyor, yazı sayfasındaki seri listesi ve önceki/sonraki kartları da kardeş yazıları birbirine bağlıyor. mertozen.com'da bir yazıyı açtığında serinin bütün yazıları kenar panelinde link olarak duruyor; yani bir serinin herhangi bir yazısına ulaşan crawler, serinin geri kalanına bir tık uzakta.
Editoryal link ile otomatik "ilgili yazılar" arasındaki fark da önemli. Otomatik bölüm, etiket veya kategori eşleşmesine göre link üretir; işe yarar ama bağlam taşımaz. Editoryal link ise yazarın metnin içinde, tam okurun ihtiyaç duyduğu yerde verdiği link: "geri alma adımlarını ayrı yazıda anlattık" gibi. Google için de bağlamı en zengin olan bu.
C# ile Kendi Link Graph'ını Çıkarmak
Bu sorunları sitende bulmanın en güvenilir yolu, sitene bir crawler gibi bakmak: sitemap'teki URL'leri al, ana sayfadan başlayıp link'leri takip et, ulaşamadıklarını ve derinlikleri raporla. HTML'i regex ile ayrıştırmak yerine gerçek bir HTML parser kullanacağız. İki yaygın seçenek var: AngleSharp ve HtmlAgilityPack. İkisi de MIT (ticari kullanıma da izin veren serbest yazılım lisansı) lisanslı ve bakımı sürüyor: AngleSharp'ın son kararlı sürümü 1.10.3 (13 Kasım 2026), HtmlAgilityPack'inki 1.13.1 (12 Ekim 2026). AngleSharp HTML'i WHATWG'nin (HTML standardını yöneten, tarayıcı üreticilerinin kurduğu topluluk) tarayıcılar için tanımladığı ayrıştırma kurallarıyla işliyor ve CSS selector'larını destekliyor; HtmlAgilityPack daha eski, XPath ağırlıklı ve hatalı HTML'e toleranslı. Bu örnekte CSS selector'ları için AngleSharp'ı seçtik.
dotnet new console -n LinkGraph -f net10.0
dotnet add package AngleSharp --version 1.10.3
Hedef, yerelde çalışan küçük bir Bookstore blog'u (http://localhost:5281): ana sayfa, üç sayfalık blog listesi, EF Core seri sayfası, Hakkımızda sayfası ve dokuz yazı. Yazılardan biri yalnız sitemap'te, biri yalnız bir onclick ile bağlı, bir link de iki adımlı bir 301 zincirinden geçiyor. Crawler'ı kendi siten dışında bir siteye karşı çalıştırma.
using System.Xml.Linq;
using AngleSharp.Dom;
using AngleSharp.Html.Parser;

Uri root = new(args.Length > 0 ? args[0] : "http://localhost:5281/");
using HttpClient http = new(new HttpClientHandler { AllowAutoRedirect = false }) { Timeout = TimeSpan.FromSeconds(10) };
HtmlParser parser = new();

// 1) sitemap.xml: "bu sayfalar önemli" dediğimiz URL'ler
XNamespace ns = "http://www.sitemaps.org/schemas/sitemap/0.9";
XDocument sitemap = XDocument.Parse(await http.GetStringAsync(new Uri(root, "/sitemap.xml")));
HashSet<string> inSitemap = [.. sitemap.Descendants(ns + "loc").Select(l => new Uri(l.Value).PathAndQuery)];

// 2) Ana sayfadan BFS: depth = ana sayfadan en az kaç tıkla ulaşılıyor
Dictionary<string, int> depth = new() { ["/"] = 0 };
Queue<string> queue = new(["/"]);
Dictionary<string, List<string>> chains = [];
List<Link> links = [];
List<string> scriptOnly = [];

while (queue.TryDequeue(out string? page))
{
    using HttpResponseMessage response = await http.GetAsync(new Uri(root, page));
    if (response.Content.Headers.ContentType?.MediaType != "text/html")
    {
        continue;
    }
    IDocument doc = await parser.ParseDocumentAsync(await response.Content.ReadAsStringAsync());
    foreach (IElement a in doc.QuerySelectorAll("a[href]"))
    {
        Uri target = new(new Uri(root, page), a.GetAttribute("href")!);
        if (target.Host != root.Host)
        {
            continue;
        }
        string href = target.PathAndQuery;
        string final = await ResolveAsync(href);
        links.Add(new Link(page, href, final, a.TextContent.Trim(), a.GetAttribute("rel") ?? ""));
        if (depth.TryAdd(final, depth[page] + 1))
        {
            queue.Enqueue(final);
        }
    }
    // <a href> olmayan "link"ler: crawler bunları takip etmez
    scriptOnly.AddRange(doc.QuerySelectorAll("[onclick]").Select(e => $"{page}: \"{e.TextContent.Trim()}\" ({e.GetAttribute("onclick")})"));
}

// 3) Rapor
Console.WriteLine($"{"page",-36}{"depth",6}{"inbound",9}");
foreach ((string path, int d) in depth.OrderBy(x => x.Value).ThenBy(x => x.Key))
{
    int inbound = links.Where(l => l.Final == path && l.From != path).Select(l => l.From).Distinct().Count();
    Console.WriteLine($"{path,-36}{d,6}{inbound,9}");
}

Console.WriteLine("\norphans (in sitemap, not reachable by links):");
inSitemap.Except(depth.Keys).Order().ToList().ForEach(p => Console.WriteLine($"  {p}"));

Console.WriteLine("\ndeep pages (depth >= 4):");
depth.Where(x => x.Value >= 4).ToList().ForEach(x => Console.WriteLine($"  {x.Key} ({x.Value} clicks)"));

Console.WriteLine("\nlinks through redirects:");
foreach (Link l in links.Where(l => l.Href != l.Final).DistinctBy(l => (l.From, l.Href)))
{
    Console.WriteLine($"  {l.From}: {string.Join(" -> ", chains[l.Href])}");
}

string[] generic = ["click here", "read more", "here", "more", "this"];
Console.WriteLine("\ngeneric anchor text:");
foreach (IGrouping<string, Link> g in links.Where(l => generic.Contains(l.Anchor.ToLowerInvariant())).GroupBy(l => l.Anchor))
{
    Console.WriteLine($"  \"{g.Key}\" x{g.Count()} (e.g. {g.First().From} -> {g.First().Final})");
}

Console.WriteLine($"\ninternal nofollow links: {links.Count(l => l.Rel.Contains("nofollow"))} (pages: {links.Where(l => l.Rel.Contains("nofollow")).Select(l => l.From).Distinct().Count()})");
Console.WriteLine("\nscript-only links:");
scriptOnly.ForEach(s => Console.WriteLine($"  {s}"));

async Task<string> ResolveAsync(string path)
{
    if (chains.TryGetValue(path, out List<string>? known))
    {
        return known[^1];
    }
    List<string> hops = [path];
    for (int i = 0; i < 5; i++)
    {
        using HttpResponseMessage r = await http.GetAsync(new Uri(root, hops[^1]));
        if ((int)r.StatusCode is < 300 or > 399 || r.Headers.Location is null)
        {
            break;
        }
        hops.Add(new Uri(new Uri(root, hops[^1]), r.Headers.Location).PathAndQuery);
    }
    chains[path] = hops;
    return hops[^1];
}

record Link(string From, string Href, string Final, string Anchor, string Rel);
BFS (Breadth-First Search; graph'ı katman katman gezen arama algoritması), her sayfaya ilk ulaştığı yolu en kısa yol olarak bulduğu için depth'i doğrudan veriyor; algoritmanın kendisini Algoritmalar ve Data Structures serisinin "Graph Temelleri" yazısında anlattık. Redirect'leri HttpClient'ın otomatik takip etmesine bırakmadık; ResolveAsync her adımı kaydediyor, böylece zinciri görebiliyoruz.
Raporu Okumak
dotnet run çıktısı:
page                                 depth  inbound
/                                        0       12
/about                                   1       12
/blog                                    1       12
/blog/ef-core-10-yenilikleri             1        4
/series/ef-core                          1        1
/blog?page=2                             2        1
/blog/ef-core-migration-geri-alma        2        4
/blog/ef-core-migration-rehberi          2        4
/blog?page=3                             3        1
/blog/aspnet-core-di-lifetime            3        2
/blog/dependency-injection-nedir         3        2
/blog/ef-core-vs-dapper                  3        1
/blog/kitap-onerileri-2023               4        1

orphans (in sitemap, not reachable by links):
  /blog/dapper-ile-toplu-insert
  /blog/ef-core-8-yenilikleri

deep pages (depth >= 4):
  /blog/kitap-onerileri-2023 (4 clicks)

links through redirects:
  /blog/ef-core-vs-dapper: /blog/ef-core-migration -> /blog/ef-core-migrations -> /blog/ef-core-migration-rehberi

generic anchor text:
  "Read more" x7 (e.g. /blog -> /blog/ef-core-10-yenilikleri)
  "click here" x1 (e.g. /blog/ef-core-vs-dapper -> /blog/ef-core-migration-rehberi)

internal nofollow links: 13 (pages: 13)

script-only links:
  /blog/ef-core-vs-dapper: "bulk insert with Dapper" (location.href='/blog/dapper-ile-toplu-insert')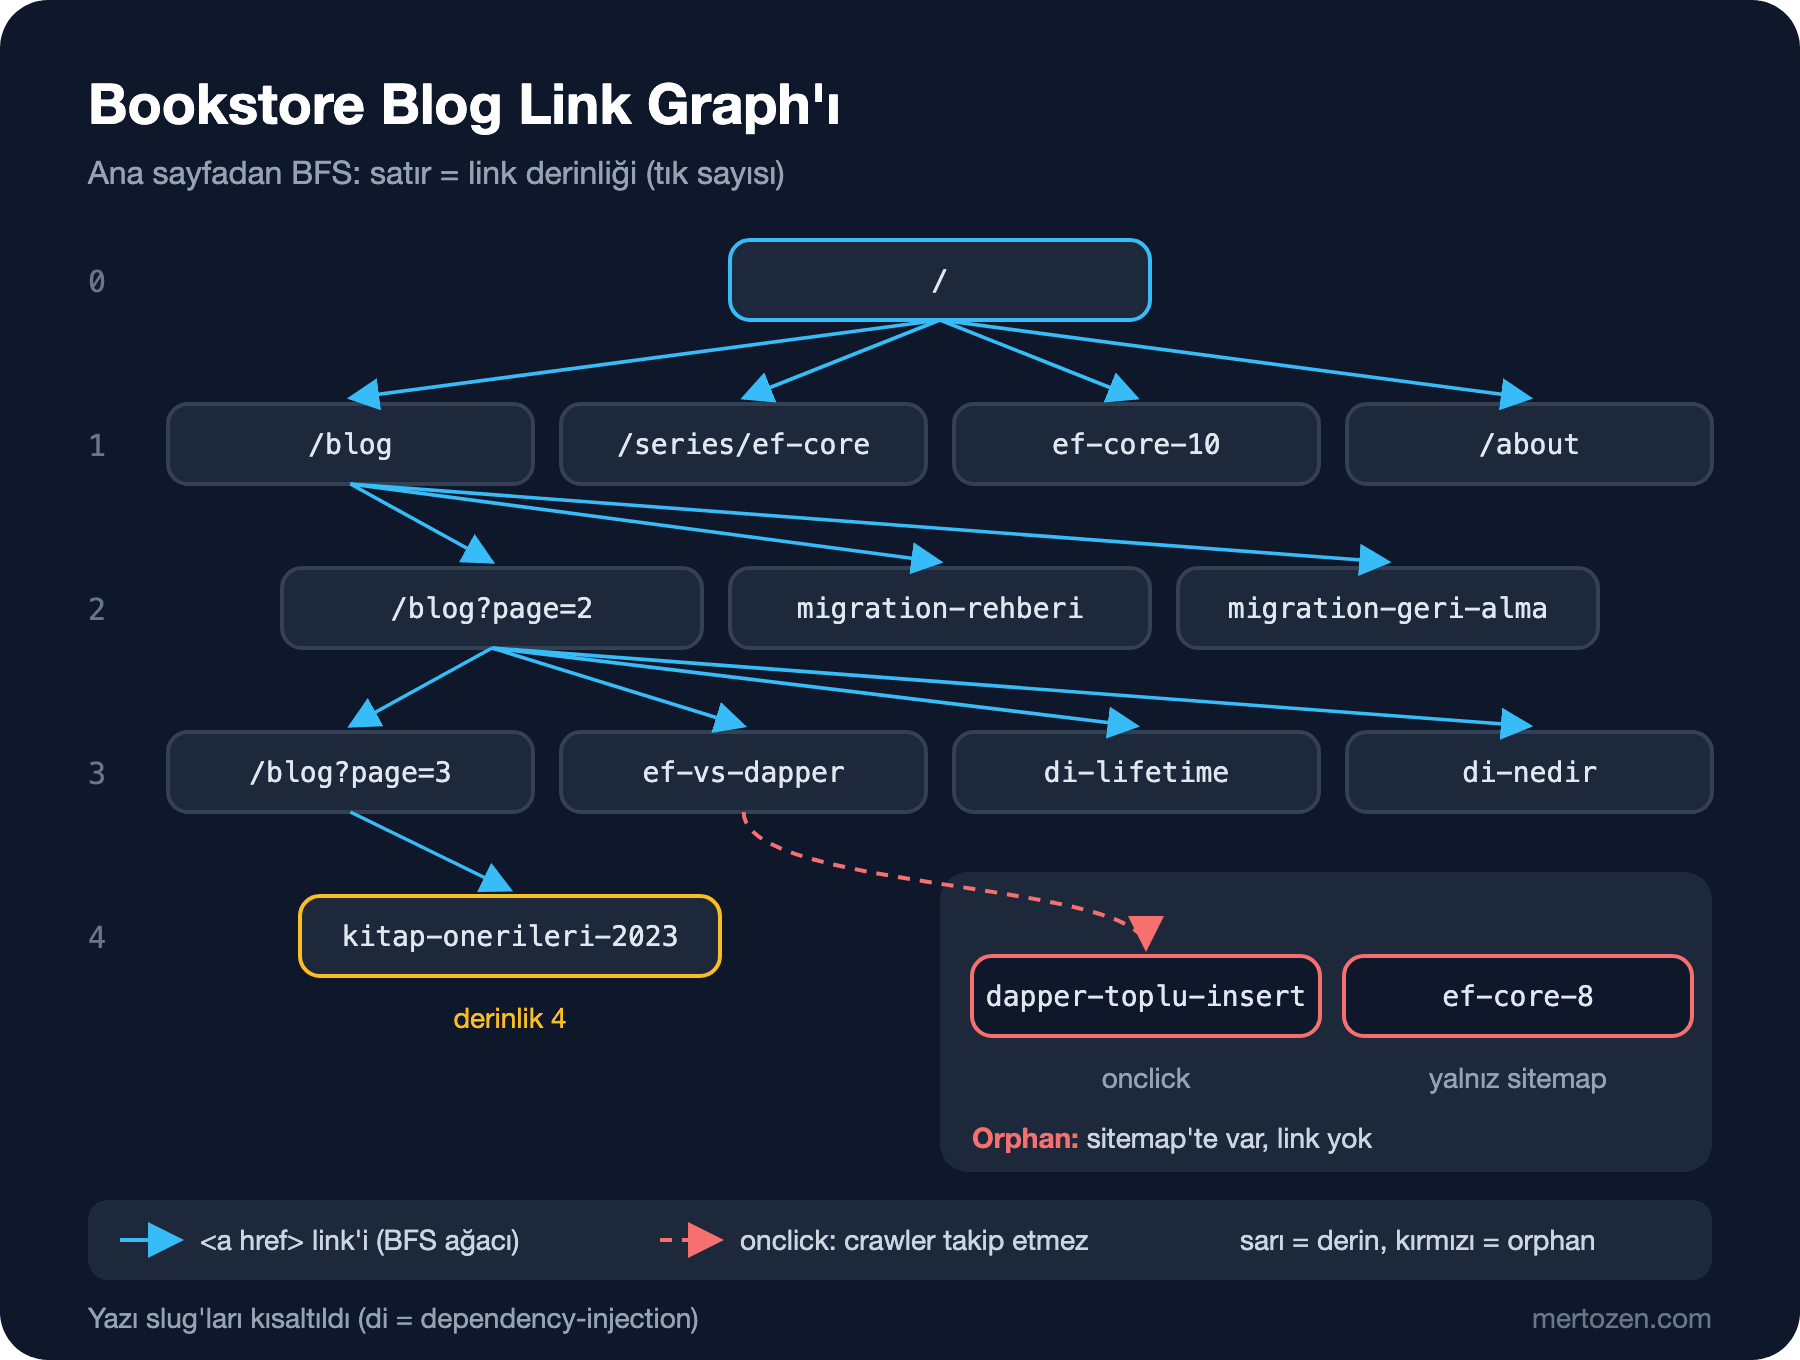
Rapordaki her bölüm bir işe dönüşüyor. İki orphan var: ef-core-8-yenilikleri yalnız sitemap'te, hiçbir sayfa ona link vermiyor; dapper-ile-toplu-insert'e giden tek yol bir onclick ve rapor onu "script-only links" altında ayrıca gösteriyor. Düzeltme: span'i gerçek bir <a href>'e çevirmek ve iki yazıyı ilgili yazılardan ya da bir seri sayfasından link'lemek.
Derinlik tablosunda seri sayfasının etkisi görünüyor: EF Core serisinin yazıları seri hub'ı sayesinde 2. katmanda. Dependency injection yazıları ise yalnız sayfalama üzerinden ulaşılabildiği için 3. katmanda; "Kitap Önerileri 2023" sayfalamanın sonunda, 4 tık uzakta. Bu yazıları bir hub'a bağlamak derinliği kısaltır.
"click here" link'i iki adımlı bir 301 zincirinden geçiyor. Zincir sonunda doğru sayfaya varıyor, ama her internal link'in doğrudan son URL'ye gitmesi hem crawler hem okur için daha temiz; düzeltme, eski link'i yeni URL ile güncellemek. Generic anchor bölümü 7 "Read more" ve bir "click here" buldu; "Read more" link'lerinin yanında açıklayıcı başlık link'i olduğu için bu daha az sorunlu, ama "click here" hedef hakkında hiçbir şey söylemiyor. Son olarak /about sayfası 12 sayfadan link alıyor ve bu link'lerin hepsi nofollow; kendi sayfana nofollow vermek hiçbir şey kazandırmıyor, aşağıda neden olduğuna bakacağız.
Search Console Links Raporuyla Karşılaştırma
Search Console'un Links raporunda internal link'ler için ayrı bir tablo var: sitende en çok internal link alan sayfalar ve her birine link veren sayfalar. Bu tablo, Google'ın gözünden bakmanın en doğrudan yolu, ama kendi crawler'ının yerine geçmiyor. Rapor bir örneklem; tablolar 1.000 satırla sınırlı, hedef sayfalar canonical URL'lerine göre gruplanıyor, index'lenmemiş sayfalar dışarıda kalabiliyor ve geçmişte bulunup artık var olmayan link'ler de listede görünebiliyor. Raporda bir link'in nofollow olup olmadığı da yazmıyor.
İkisini birlikte kullan: kendi crawler'ın sitenin bugünkü hâlini, deploy'dan hemen sonra gösterir; Search Console ise Google'ın gerçekte ne bulduğunu, gecikmeli ve örneklenmiş olarak gösterir. Crawler'ında çok link alan ama Search Console'da hiç görünmeyen bir sayfa, Google'ın o sayfayı index'lemediğine ya da başka bir canonical seçtiğine işaret edebilir.
Üretimde Dikkat
Crawler'ı nazik çalıştır. Kendi production sitende bile istekleri sırayla ve aralarında kısa bir bekleme ile gönder; mümkünse staging ortamında çalıştır. Başkasının sitesini taramak için önce izin ve robots.txt kurallarına uyum gerekir.
Render'a dikkat et. Bu crawler ham HTML'i okuyor. Link'leri JavaScript ile üretilen bir sitede, örneğin CSR (sayfanın tarayıcıda JavaScript ile oluşturulması) kullanan bir Angular uygulamasında, link'leri ancak headless bir tarayıcıyla, örneğin Playwright ile render ettikten sonra görebilirsin.
CI'a koy. Raporu her deploy'dan sonra staging'e karşı çalıştırıp yeni orphan veya yeni redirect zinciri çıktığında pipeline'ı uyarıyla durdurmak, sorunları yayından önce yakalar.
Büyük sitede bellek ve süre. Binlerce sayfada link listesini bellekte tutmak yerine edge'leri bir dosyaya veya veritabanına yaz; istekleri sınırlı paralellikle (ör. Parallel.ForEachAsync ve düşük bir MaxDegreeOfParallelism) gönder.
Sık Düşülen Tuzaklar
Footer'a veya sidebar'a yüzlerce link koymak. Google ideal bir link sayısı vermiyor, ama bir sayfada aşırı fazla link olmasının büyük ihtimalle fazla olduğunu söylüyor. Her sayfada tekrar eden yüzlerce kategori ve etiket link'i okura yardım etmiyor ve gerçek, bağlamlı link'leri gölgede bırakıyor.
Internal link'te nofollow kullanmak. Google nofollow'u güvenmediğin kaynaklara verilen link'ler için öneriyor ve 2020'den beri onu crawling ve indexing için bir ipucu olarak değerlendiriyor. Kendi sayfana nofollow vermek, o sayfayı korumaz ya da başka sayfaları güçlendirmez; yalnız kendi sitende bir sayfayla bağını zayıflatır. Bir sayfa aramada olmamalıysa doğru araç noindex.
Kırık internal link ve redirect zinciri. URL değişikliklerinden sonra eski link'leri güncellememek, okuru ve crawler'ı her seferinde bir veya daha fazla redirect'ten geçirir. Redirect'in kendisini Teknik SEO serisinin redirect yazısında ele aldık; içerik tarafındaki iş, link'leri güncel tutmak.
Yalnız otomatik "ilgili yazılar"a güvenmek. Otomatik bölüm iyi bir tamamlayıcı, ama yazarın metin içinde verdiği bir link'in bağlamını taşımıyor.
Küçük Bir Deneme
★☆☆ Crawler'a, her sayfanın dışarıya verdiği link sayısını yazdıran bir sütun ekle. Bookstore'da en çok link veren sayfa hangisi ve bunların kaçı sayfa düzeninden (nav ve footer) geliyor?
★★☆ ResolveAsync'i, 404 ve 410 dönen link'leri "broken links" bölümünde raporlayacak şekilde genişlet. Test için sitenin bir yazısına var olmayan bir slug'a giden link ekle.
★★★ Link graph'ını Graphviz'in DOT (graph tanımlama dili) biçiminde dışa aktaran bir seçenek ekle; orphan'lar kırmızı, derinliği 4 ve üzeri olan sayfalar sarı olsun. Çıktıyı dot -Tsvg ile görselleştir ve yukarıdaki figürle karşılaştır.
Link'ler okuru doğru sayfaya getiriyor. Bir sonraki yazıda o sayfanın kendisine bakıyoruz: başlık yapısı, ilk paragrafta net cevap, kod örnekleri, görseller ve iki dilli içerikle okurun sorusuna gerçekten cevap veren bir sayfa yazmak.