

Content Architecture: Topic Cluster, Seri ve Kategori Yapısı ve Keyword Cannibalization
İyi bir içerik mimarisi, her sorgu niyetinin sitede tek bir sahibi olmasını ve hub sayfaların gerçekten bir konuyu anlatmasını sağlar; aynı niyeti hedefleyen iki sayfa ise keyword cannibalization ile birbirini zayıflatır. mertozen.com'un kategori, seri ve yazı yapısını, etiket enflasyonunu, Search Console verisinden .NET 10 ile cannibalization adaylarını çıkarmayı ve birleştir, farklılaştır, canonical seçeneklerini anlatıyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ile derlenip denenmiştir; Google'ın başlangıç rehberinin (SEO Starter Guide), çok dilli site ve canonical dokümanlarının Kasım 2026 hâlini esas alır.
Önce Tahmin Et
Bookstore blog'unda "ef core migration geri alma" sorgusu için iki sayfa görünüyor: genel Entity Framework Core (EF Core) migration rehberi ve geri almaya ayrılmış kısa bir yazı. İkisi de 7–10. sıralar arasında gidip geliyor ve hiçbiri ilk beşe girmiyor. Ekipte üç öneri var: (1) kısa yazıdan rehbere bir canonical koyalım; (2) iki yazıyı birleştirip eski URL'yi 301 ile yönlendirelim; (3) hiçbir şey yapmayalım, iki sayfa iki kat görünürlük demek. Bir de ayrı bir tartışma var: her yazıya 5–7 etiket ekleyip her etiketin kendi sayfası olsun mu? Sence hangi öneri iki sayfayı da güçlendirir, hangisi işi daha kötü yapar?
İçerik Mimarisi Neden Önemli?
İçerik mimarisi, sitedeki sayfaların nasıl gruplandığı ve birbirine nasıl bağlandığı. SEO (arama motorları için yapılan optimizasyon çalışması) açısından iki işi var: Google'ın sayfalar arasındaki ilişkiyi anlamasına yardım etmek ve aynı soruya cevap veren sayfaların birbirinin önünü kesmesini engellemek.
Google'ın SEO Starter Guide'ı bu konuda ölçülü konuşuyor. Mantıklı bir site yapısı, hem kullanıcıların hem arama motorlarının sayfaların birbiriyle ilişkisini anlamasına yardım ediyor; ama rehber aceleyle yeniden yapılanmaya gerek olmadığını, arama motorlarının mevcut yapını da anlayabildiğini ekliyor. Binlerce URL'si olan büyük sitelerde benzer konuları dizinlerde gruplamak, Google'ın her bölümün ne sıklıkla değiştiğini öğrenmesine yardım edebiliyor. Yani mimari bir sıralama hilesi değil; düzenli bir sitenin yan ürünü.
Hub ve Cluster
SEO sektöründe yaygın bir model, topic cluster: bir konunun geniş özetini veren bir hub (pillar) sayfası ve konunun alt sorularına ayrıntılı cevap veren cluster sayfaları. Hub her cluster sayfasına link veriyor, her cluster sayfası hub'a ve gerektiğinde birbirine geri link veriyor. Bu terimler Google'ın dokümanlarında geçmiyor; sektörün pratiği. Arkasındaki fikir ise Google'ın anlattığıyla uyumlu: link'ler hem keşif hem bağlam sağlıyor ve her önemli sayfanın sitedeki başka bir sayfadan link alması gerekiyor (ayrıntısı bir sonraki yazıda).
Teknik bir blog'da bu modelin hazır bir karşılığı var: seri. Seri sayfası hub, serinin yazıları cluster. Seri, okuru belirli bir sırayla bir konunun içinden geçirdiği için cluster yapısını kendiliğinden kuruyor; geriye hub'ın gerçekten bir hub olması kalıyor.
mertozen.com'da Kategori → Seri → Yazı
Bu sitenin yapısı üç katmanlı. En üstte Backend, Frontend, DevOps gibi kategoriler, her kategorinin altında seriler, her serinin altında yazılar. Binden fazla yazı bu ağaçta duruyor.
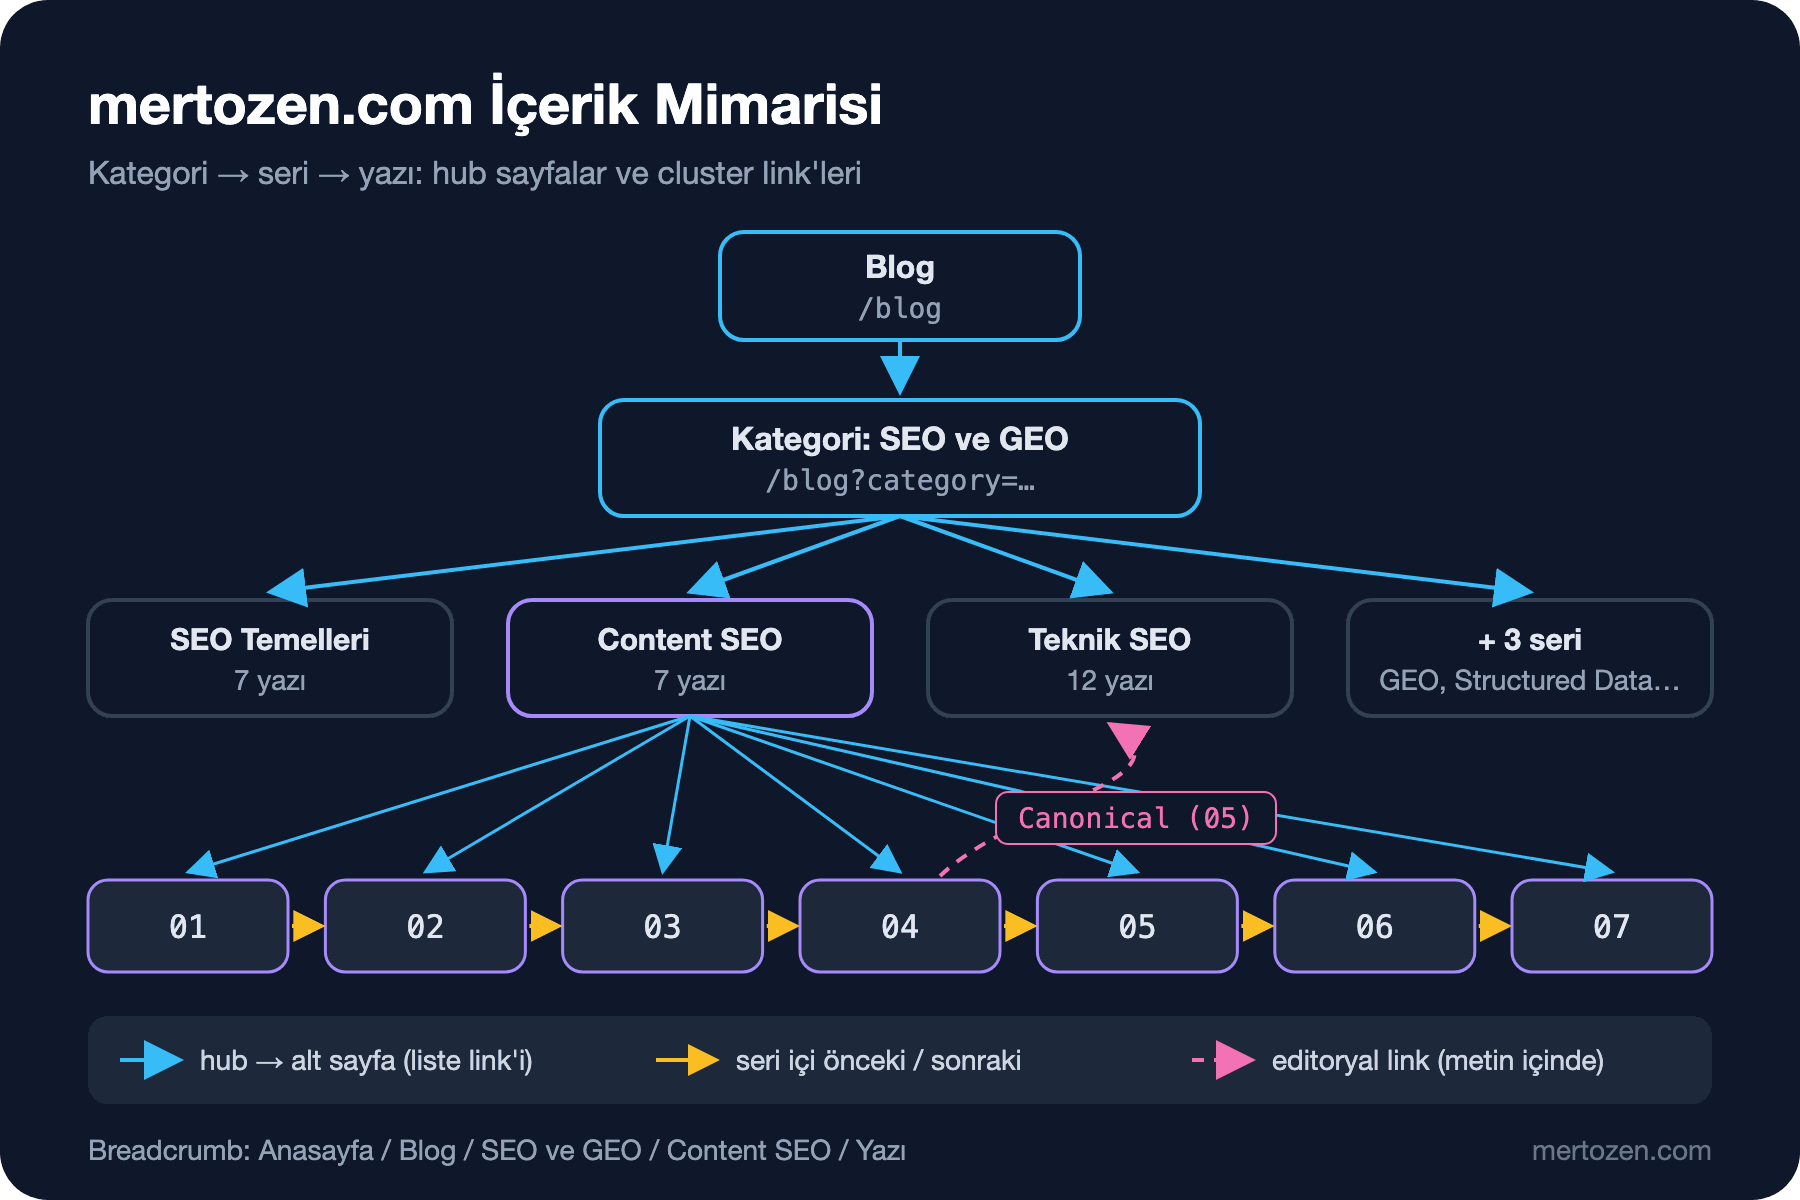
URL'ler bu ağacı şöyle yansıtıyor: yazılar /blog/{slug} adresinde; kategori ve seri sayfaları ise blog listesinin filtrelenmiş görünümleri, /blog?category=seo-ve-geo ve /blog?series=... gibi. EN sürümler aynı yolların /en önekli hâli. Bir yazının breadcrumb'ı Anasayfa / Blog / Kategori / Seri / Yazı zincirini gösteriyor ve sayfadaki BreadcrumbList JSON-LD'si aynı zinciri taşıyor. Yazı sayfasında serinin bütün yazılarını listeleyen bir kenar paneli, önceki ve sonraki yazı kartları ve ilgili yazılar bölümü var. Yani cluster tarafı güçlü: her yazı hub'a ve kardeşlerine bağlı.
Zayıf taraf hub'ın kendisi. Kod tabanına bakınca seri görünümünün her seri için aynı title'ı ("Blog — Mert Özen") ve blog listesinin genel açıklamasını kullandığı görülüyor. CMS'te (içerik yönetim sistemi) her serinin bir açıklama alanı var, ama seri görünümü bunu göstermiyor; okur ve Google bir seri sayfasında yalnız kart listesi görüyor. Bu, "hub sayfasını boş bir link listesi bırakmak" tuzağının ta kendisi. Düzeltmesi küçük: seri görünümünde title'ı ve meta description'ı serinin adı ve açıklamasından üretmek, listenin üstüne serinin neyi öğrettiğini ve hangi sırayla okunacağını anlatan bir giriş paragrafı koymak. Kategori ve seri görünümlerinin path yerine query string kullanmasının artı ve eksilerini Teknik SEO serisinin URL tasarımı yazısında tartıştık.
Taxonomy ve Etiket Enflasyonu
Taxonomy, içeriği sınıflandırdığın sistem: kategoriler, seriler ve etiketler. Kategori ve seri az sayıda ve kontrollü; etiketler ise kolayca çoğalıyor. Bu sitenin yayınlanmış yazılarından 725'inin meta verisini saydığımızda 1.222 farklı etiket çıktı; bunların 819'u yalnız tek bir yazıda kullanılmış. Etiketler yazı sayfasında /blog?tag=... link'leri olarak görünüyor ve bu görünümlerin canonical'ı etiketi koruyor. Sonuç: tek bir yazı kartından oluşan yüzlerce liste sayfası.
Bu sayfalar ne okura ne Google'a bir şey anlatıyor. Seçenekler: etiketleri kontrollü bir listeyle sınırlamak (her etiketin en az birkaç yazıda geçmesini şart koşmak), az yazılı etiket sayfalarına noindex, follow vermek ya da etiketleri link olmaktan çıkarıp yalnız yazı içi bir bilgi olarak göstermek. Hangisini seçersen seç, kural şu: bir taxonomy sayfası ancak okurun gerçekten gezinmek isteyeceği kadar içerik topluyorsa var olmalı.
Keyword Cannibalization
Keyword cannibalization, aynı sitede aynı niyeti hedefleyen iki ya da daha fazla sayfanın aynı sorguda birbirinin yerine geçmesi. Bu da Google'ın dokümanlarında geçen bir terim değil, sektörün adı. Belirtisi tanıdık: bir sorguda bazen bir sayfa, bazen öbürü görünüyor; ikisi de orta sıralarda kalıyor; tıklamalar bölünüyor. Google iki sayfadan hangisinin daha iyi cevap olduğuna karar veremiyor, çünkü sen de karar vermemişsin.
Teşhis Search Console'da başlıyor: Performance raporunda bir sorguyu filtreleyip Pages sekmesine geçtiğinde aynı sorgu için birden fazla URL görüyorsan aday var demektir. Ama bunu yüzlerce sorgu için elle yapamazsın. Serinin ikinci yazısındaki örnek export'u (sorgu ve URL aynı satırda) kullanarak adayları çıkaralım. SearchRow record'u ikinci yazıdakiyle aynı.
using System.Globalization;
using Bookstore.ContentSeo;

CultureInfo.CurrentCulture = CultureInfo.InvariantCulture;
string path = args.Length > 0 ? args[0] : "gsc-url-query.csv";
List<SearchRow> rows = [.. (await File.ReadAllLinesAsync(path)).Skip(1).Select(SearchRow.Parse)];
const double MinShare = 0.15;

static string LangOf(string url) => url.StartsWith("/en/") ? "en" : "tr";

foreach (IGrouping<string, SearchRow> query in rows.GroupBy(r => r.Query).OrderByDescending(g => g.Sum(r => r.Impressions)))
{
    int total = query.Sum(r => r.Impressions);
    // Sorgunun impression'larından anlamlı pay alan sayfalar
    List<SearchRow> pages = [.. query.Where(r => (double)r.Impressions / total >= MinShare)];
    if (pages.Count < 2)
    {
        continue;
    }

    // Aynı dildeki sayfalar birbiriyle yarışır; TR/EN çifti hreflang alternatifidir
    List<IGrouping<string, SearchRow>> sameLanguage = [.. pages.GroupBy(r => LangOf(r.Url)).Where(g => g.Count() > 1)];
    if (sameLanguage.Count == 0)
    {
        Console.WriteLine($"skip  \"{query.Key}\": {string.Join(" + ", pages.Select(p => $"{LangOf(p.Url)} {p.Url}"))} (language alternates)");
        continue;
    }

    Console.WriteLine($"CHECK \"{query.Key}\" ({total} impressions)");
    foreach (SearchRow p in sameLanguage.SelectMany(g => g).OrderByDescending(p => p.Impressions))
    {
        Console.WriteLine($"      {p.Url,-36}{p.Impressions * 100 / total,4}%  clicks {p.Clicks,3}  pos {p.AvgPosition,4:F1}");
    }
}
dotnet run çıktısı:
skip  "dependency injection": tr /blog/dependency-injection-nedir + en /en/blog/what-is-dependency-injection (language alternates)
skip  "ef core migration": tr /blog/ef-core-migration-rehberi + en /en/blog/ef-core-migrations-guide (language alternates)
skip  "cs8618": tr /blog/cs8618-nullable-uyarisi + en /en/blog/cs8618-non-nullable-property-warning (language alternates)
CHECK "ef core migration geri alma" (500 impressions)
      /blog/ef-core-migration-rehberi       52%  clicks   7  pos  9.8
      /blog/ef-core-migration-geri-alma     48%  clicks  12  pos  7.5
CHECK "dependency injection lifetime" (300 impressions)
      /blog/dependency-injection-nedir      53%  clicks   4  pos 10.4
      /blog/aspnet-core-di-lifetime         46%  clicks   5  pos  9.6
skip  "dotnet ef migrations add": en /en/blog/ef-core-migrations-guide + tr /blog/ef-core-migration-rehberi (language alternates)
Program dört sorguyu atladı, çünkü sayfaların biri TR, öbürü EN: bunlar aynı içeriğin iki dil sürümü ve hreflang ile birbirine bağlı. İki sorgu gerçek aday. "ef core migration geri alma" için impression'lar iki TR sayfa arasında neredeyse yarı yarıya bölünmüş ve hiçbiri 7'nin üstüne çıkamıyor. "dependency injection lifetime" için de aynı tablo: tanım sayfası ile lifetime sayfası aynı sorguda yarışıyor.
Bir uyarı: tek bir dönemin toplamı, zaman içindeki "bir o, bir bu" dalgalanmasını göstermiyor. Bulk export'taki günlük veriyle aynı sorguda hangi URL'nin hangi gün göründüğüne bakmak, adayı doğrulamanın en iyi yolu.
Çözüm Seçenekleri
Cannibalization'ın tek bir çözümü yok; seçim, iki sayfanın gerçekten aynı şeyi anlatıp anlatmadığına bağlı.
| Durum | Çözüm | Ne olur |
|---|---|---|
| İki sayfa aynı niyete aynı içerikle cevap veriyor | Birleştir, eski URL'yi 301 ile yönlendir | Tek ve güçlü bir sayfa; eski URL'nin sinyalleri yeni sayfada toplanır |
| İki sayfa farklı niyetlere hizmet ediyor ama sınır bulanık | Farklılaştır: her sayfanın odağını, title'ını ve başlıklarını netleştir, aralarına açıklayıcı link koy | İki sayfa iki farklı sorguda güçlenir |
| İki URL aynı içeriği gösteriyor (parametre, sıralama, yazdırma sürümü) | Canonical | Google'a hangi URL'nin tercih edildiği söylenir |
| Sayfa okur için gerekli ama aramada olmamalı | noindex | Sayfa sitede kalır, index'ten çıkar |
Canonical'ın yerini doğru anlamak önemli. Canonical, aynı ya da neredeyse aynı içeriğin farklı URL'leri için bir sinyal; Google bunu bir ipucu olarak değerlendiriyor ve sayfalar gerçekten farklıysa yok sayabiliyor. İki ayrı yazıdan birini öbürüne canonical'lamak, Bookstore'daki ilk öneri, ya işe yaramaz ya da kısa yazıyı index'ten düşürüp içeriğini kaybettirir. Canonical'ın mekaniğini Teknik SEO serisinin canonical yazısında, 301'i redirect yazısında ayrıntılı anlattık.
Bookstore için karar: "geri alma" ayrı bir niyet, bu yüzden farklılaştırma. Rehberdeki geri alma bölümü iki cümleye iniyor ve "EF Core migration'ı geri almak" anchor text'iyle ayrı sayfaya link veriyor; ayrı sayfanın title'ı ve ilk paragrafı doğrudan geri alma sorusuna cevap veriyor. Dependency injection tarafında da tanım sayfası lifetime konusunu bir paragrafta bırakıyor ve lifetime sayfasına bağlanıyor. Üçüncü öneri, yani hiçbir şey yapmamak, en kötüsüydü: iki orta sıra, bir iyi sıradan değerli değil.
Thin ve Near-Duplicate İçerik
Çok dilli bir sitede ilk akla gelen soru, TR ve EN sayfaların duplicate sayılıp sayılmadığı. Google'ın çok dilli siteler dokümanı bu konuda net: bir sayfanın yerelleştirilmiş sürümleri, ancak ana içerik çevrilmeden bırakıldıysa duplicate sayılıyor. Yani yalnız menüsü çevrilmiş ama gövdesi aynı dilde kalmış bir sayfa sorun; gövdesi gerçekten çevrilmiş TR ve EN sürümler sorun değil. İkisini hreflang ile bağlamak, Google'a hangisinin hangi okura gideceğini söyler; uygulamasını Teknik SEO serisinin hreflang yazısında yaptık.
Asıl sorun aynı dilde neredeyse aynı yazılar. ".NET 8'de Minimal API ile Validation" ve ".NET 9'da Minimal API ile Validation" yazıları birkaç satır dışında aynıysa, iki sayfa aynı niyette yarışır ve ikisi de az şey katar. Thin content da benzer bir sorun: bir paragraflık, tek bir komutu anlatan ve başka bir yazının bölümü olabilecek sayfalar. Bunlar tek tek zararsız görünür, ama site büyüdükçe index'in büyük kısmını oluşturur.
Üretimde Dikkat
Keyword map'i yeni yazı açarken kontrol et. Yeni bir yazı fikri geldiğinde ilk soru, bu niyetin sitede zaten bir sahibi olup olmadığı. Varsa yeni yazı yerine mevcut sayfayı geliştirmek çoğu zaman daha doğru.
Cannibalization raporunu düzenli çalıştır. Yukarıdaki program aylık bir job olarak çalışıp yeni adayları bir issue olarak açabilir. Eşik değerini (%15) kendi verine göre ayarla.
Birleştirmeyi ölçerek yap. Birleştirme ve 301 sonrası trafik genellikle birkaç hafta dalgalanır; Search Console'a bir annotation düş ve önce/sonra karşılaştırmasını aynı süre uzunluğuyla yap. Bunu serinin son yazısında ayrıntılı ele alıyoruz.
Hub sayfasına içerik yaz. Seri ve kategori sayfası; ne öğrettiğini, kime göre olduğunu ve hangi sırayla okunacağını anlatan bir giriş, kendi title'ı ve açıklaması olan bir sayfa olmalı.
Sık Düşülen Tuzaklar
Her küçük konuya ayrı yazı açmak. "EF Core'da migration listesini görmek", "migration'ı SQL script'e çevirmek", "migration'ın adını değiştirmek" tek bir rehberin bölümleri olabilecekken ayrı yazılar olarak açılınca, her biri thin kalıyor ve hepsi aynı sorgu ailesinde yarışıyor.
Hub sayfasını boş bir link listesi bırakmak. Bir kart listesi okura "burada şu yazılar var" der, ama "bu konu neden önemli, nereden başlamalıyım" sorusuna cevap vermez. Google için de sayfanın ne hakkında olduğunu anlatan metin yoktur.
Cannibalization'ı canonical ile çözmeye çalışmak. Canonical duplicate URL'ler içindir; iki farklı yazı için doğru araç birleştirme ya da farklılaştırma.
TR/EN çiftini cannibalization sanmak. Farklı dildeki iki sürüm aynı sorguda görünüyorsa bu, hreflang'ın işini yaptığını ya da sorgunun dilinin belirsiz olduğunu gösterir; bir sayfayı kaldırmak çözüm değil.
Küçük Bir Deneme
★☆☆ Kendi sitende en çok trafik alan beş sorguyu Search Console'da tek tek filtreleyip Pages sekmesine bak. Kaç tanesinde aynı dilde birden fazla URL var?
★★☆ Cannibalization programına, her aday için iki sayfanın title'larını ve ilk paragraflarını HTTP ile çekip yan yana yazdıran bir adım ekle. Hangi adaylar birleştirme, hangileri farklılaştırma istiyor?
★★★ Bulk export'un günlük verisiyle, aynı sorguda gün bazında en çok impression alan URL'nin kaç kez değiştiğini sayan bir sorgu yaz. Değişim sayısı yüksek sorgular, gerçek cannibalization'ın en güçlü işareti.
Mimarinin iskeletini kurduk: kategori, seri, yazı ve aralarındaki ilişkiler. Bu iskeleti ayakta tutan şey link'ler. Bir sonraki yazıda internal linking'e bakıyoruz: anchor text, orphan sayfalar, link derinliği ve C# ile kendi link graph'ını çıkarmak.