

Kod Nasıl Çalışır Hâle Gelir: Compiler, Interpreter, JIT ve AOT'nin Haritası
Derlenen ya da yorumlanan dil diye bir ayrım yok; aynı aşamaların hangisinin build'de, hangisinin çalışma anında yapıldığı implementation'ın seçimi. 1.500 kez çağrılan bir C# method'u JIT tarafından yalnız üç kez derleniyor, TypeScript tipleri build'de kontrol edilip siliniyor, V8 ise kodu önce yorumlayıp sonra Maglev ve TurboFan ile derliyor. Yazı compiler pipeline'ını gerçek çıktılarla gösteriyor ve seri boyunca yazılacak Bookstore filtre dilinin grammar'ını çıkarıyor.
Sürüm notu: Bu yazıdaki kodlar .NET 10 (SDK 10.0.404), TypeScript 7.0.2 ve Node.js 26 (V8 14.6) ile derlenip çalıştırılmıştır; decompiler çıktısı ilspycmd 11.2 ile alınmıştır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) için küçük bir C# programı yazıyoruz: IsCheap adında tek satırlık bir method, fiyatı 300 TL'nin altındaki kitaplar için true dönüyor. Program bu method'u üç kitap üzerinde 1.500 kez çağırıyor. Soru şu: .NET'in JIT (just-in-time; kodu çalışma anında, ihtiyaç duyulduğunda makine koduna çeviren derleme) compiler'ı IsCheap'i kaç kez derler? 1.500 mü, 1 mi, yoksa başka bir sayı mı?
İkinci soru TypeScript'ten. price: number diye tanımlanmış bir alana API'den "349.90" string'i geliyor ve kod bu değere 25 TL kargo ekliyor. TypeScript compiler'ı buna hata verir mi? Vermezse program çalışırken ne yazdırır? İki cevabı da yazının ortasında gerçek çıktılarla göreceğiz; tahminlerini bir kenara not et.
Bir Compiler'ın İçindeki Aşamalar
Bir compiler'ın işi, bir dilde yazılmış metni aynı anlamı taşıyan başka bir biçime çevirmek. Hedef biçim makine kodu olabilir, başka bir dil olabilir (TypeScript'ten JavaScript'e), bir sanal makinenin komutları olabilir: .NET'in IL'i (Intermediate Language; .NET'in işlemciden bağımsız ara kodu) böyle bir biçim. Hangi dil olursa olsun iş aşağı yukarı aynı aşamalardan geçiyor:
- Lexing: karakter dizisini token'lara bölmek.
price<300üç token: bir identifier, bir operatör, bir sayı. - Parsing: token'ları grammar'a göre bir ağaca dizmek. Sonuç AST (abstract syntax tree; kodun anlamlı yapısını gösteren, boşluk ve parantez gibi ayrıntıları atmış ağaç).
- Semantic analysis: isimleri tanımlarına bağlamak, tipleri kontrol etmek.
pricehangi property,<hangi tipler arasında, sonuç ne tip? - IR (intermediate representation; kaynak kod ile makine kodu arasında duran, dilden ve işlemciden bağımsız ara biçim) üretmek.
- Optimization: IR üzerinde gereksiz işi atmak, sabitleri önceden hesaplamak, küçük method'ları çağrıldıkları yere gömmek.
- Code generation: IR'dan hedef koda geçmek.
İlk üç aşamaya front-end, son ikisine back-end denir. Front-end dili bilir ama işlemciyi bilmez; back-end işlemciyi bilir ama kaynak dili bilmez. IR bu ikisinin arasındaki sözleşme. Neden ayrı bir IR'a ihtiyaç var? Beş dil ve dört işlemci mimarisi düşün: her dil için her mimariye ayrı compiler yazarsan yirmi compiler gerekir. Arada ortak bir IR varsa beş front-end ve dört back-end yeterli. LLVM (birçok dilin ortak kullandığı compiler altyapısı) bu fikrin en bilinen örneği; Rust, Swift ve Clang aynı back-end'i paylaşıyor. .NET'te de C#, F# ve Visual Basic aynı IL'e derleniyor ve aynı JIT o IL'i x64 ya da Arm64 koduna çeviriyor.
Bu aşamaların hepsi aynı anda ve aynı yerde çalışmak zorunda değil. Asıl farkı yaratan da bu: hangi aşama build sırasında, hangisi uygulama çalışırken yapılıyor?
Üç Dil, Üç Yol
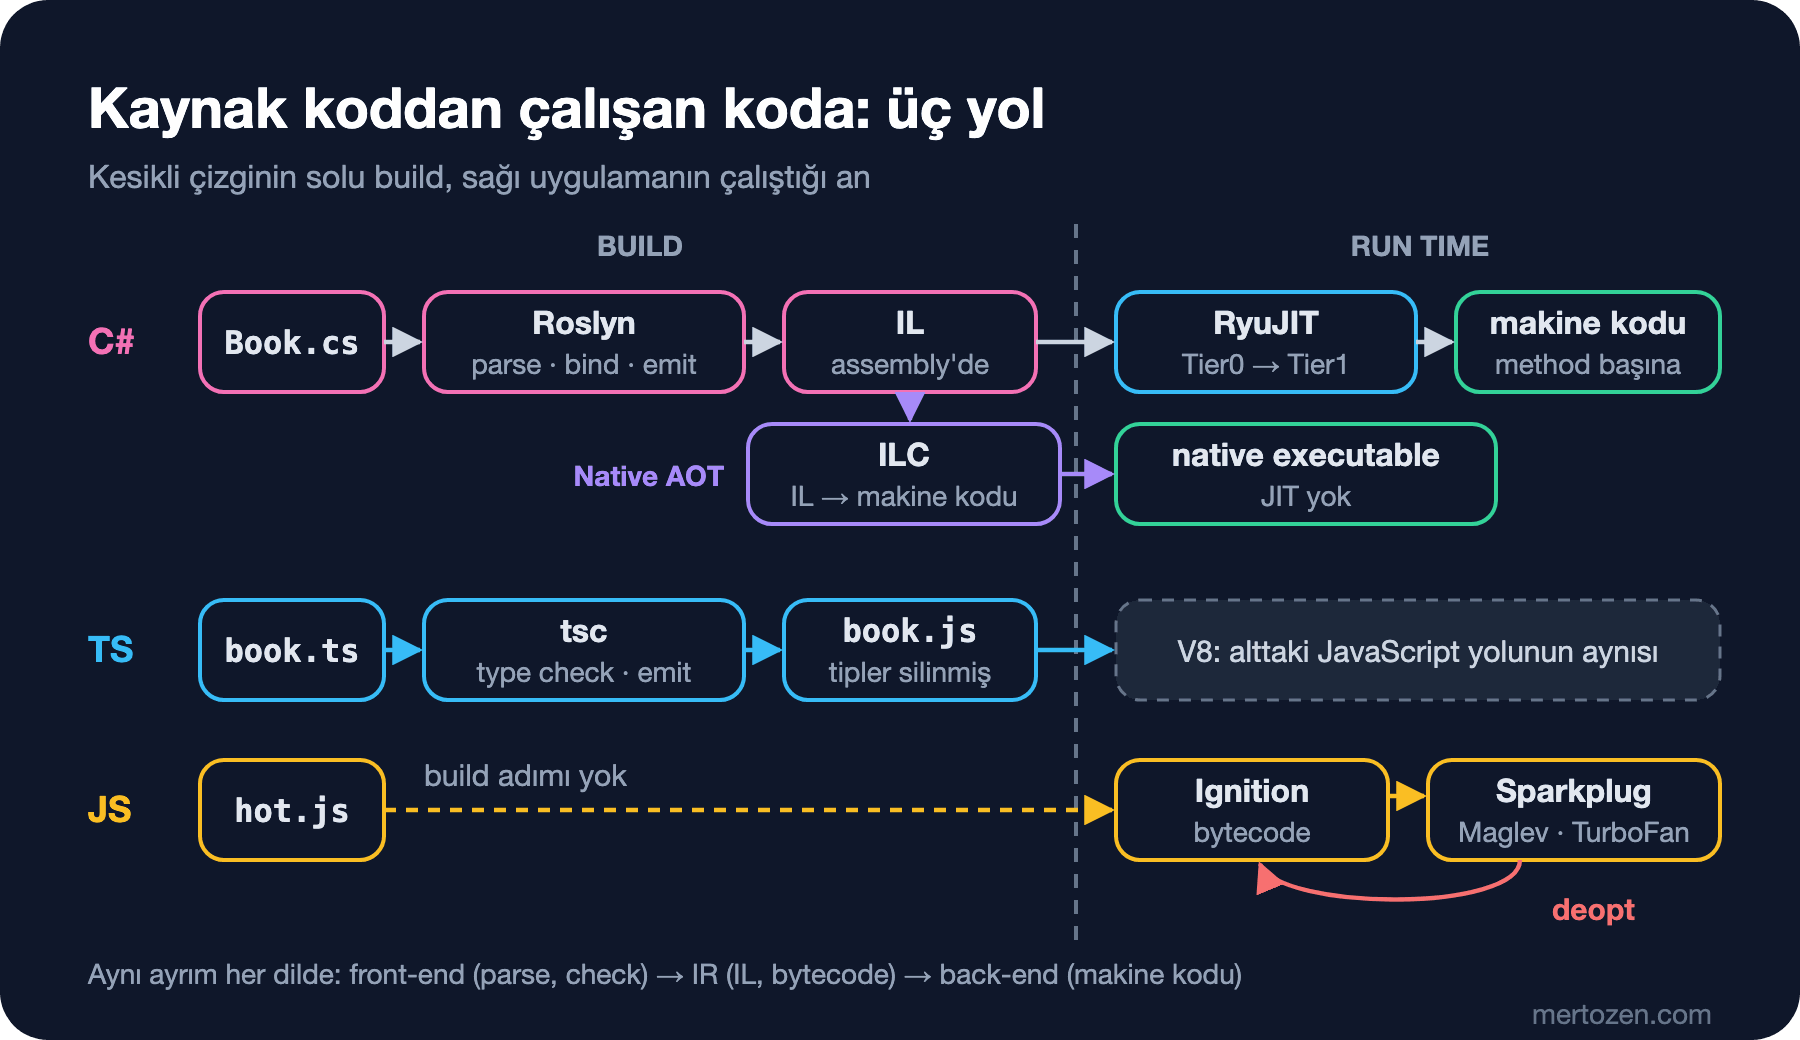
Görseldeki üç satırı sırayla gerçek çıktılarla açalım. Kodların hepsi serinin samples/ klasöründe duruyor.
C#: Roslyn'den IL'e, IL'den Makine Koduna
Book[] books =
[
    new("Dune", 349.90m),
    new("Emma", 199.00m),
    new("The Hobbit", 289.50m),
];

int matches = 0;
for (int round = 1; round <= 5; round++)
{
    for (int i = 0; i < 100; i++)
    {
        foreach (Book book in books)
        {
            if (Filters.IsCheap(book))
                matches++;
        }
    }

    // arka plandaki tiering thread'ine sık çağrılan method'ları yeniden derlemesi için zaman ver
    Thread.Sleep(200);
}

Console.WriteLine($"IsCheap calls: {5 * 100 * books.Length}, matches: {matches}");

public sealed record Book(string Title, decimal Price);

public static class Filters
{
    [MethodImpl(MethodImplOptions.NoInlining)]
    public static bool IsCheap(Book book) => book.Price < 300m;
}
dotnet build çalıştığında C# compiler'ı Roslyn kaynak kodu parse ediyor, isimleri ve tipleri bağlıyor, sonra assembly'ye (.dll) IL yazıyor. Assembly'de makine kodu yok. IsCheap'in IL'ine ilspycmd ile bakalım (dotnet tool install ilspycmd ile kurulan bir decompiler):
$ ilspycmd -il -m "M:Filters.IsCheap(Book)" samples/PipelineTour/bin/Release/net10.0/PipelineTour.dll
// IL code: PipelineTour
.method public hidebysig static
	bool IsCheap (
		class Book book
	) cil managed noinlining
{
	.custom instance void [System.Runtime]System.Runtime.CompilerServices.NullableContextAttribute::.ctor(uint8) = (
		01 00 01 00 00
	)
	// Method begins at RVA 0x233b
	// Header size: 1
	// Code size: 22 (0x16)
	.maxstack 8

	IL_0000: ldarg.0
	IL_0001: callvirt instance valuetype [System.Runtime]System.Decimal Book::get_Price()
	IL_0006: ldc.i4 300
	IL_000b: newobj instance void [System.Runtime]System.Decimal::.ctor(int32)
	IL_0010: call bool [System.Runtime]System.Decimal::op_LessThan(valuetype [System.Runtime]System.Decimal, valuetype [System.Runtime]System.Decimal)
	IL_0015: ret
} // end of method Filters::IsCheap
Altı komut, hepsi bir stack üzerinde çalışıyor: argümanı stack'e koy, Price getter'ını çağır, 300'den bir decimal oluştur, op_LessThan'ı çağır, sonucu dön. Burada iki şey dikkat çekiyor. Birincisi, < operatörü artık bir method çağrısı; Roslyn'in semantic analysis aşaması decimal için hangi operatörün seçileceğine build sırasında karar verdi. İkincisi, 300m literal'i bile IL'de decimal constructor'ına giden bir çağrı. Bu ayrıntılara serinin 05. yazısında, IL ve JIT konusunda döneceğiz.
Peki bu IL ne zaman makine koduna dönüşüyor? Runtime'a her derlediği method'u yazdırmasını söyleyelim. DOTNET_JitDisasmSummary Release runtime'da da çalışan bir tanılama ayarı; DOTNET_JitStdOutFile çıktıyı dosyaya yönlendiriyor (PowerShell'de bunları $env:DOTNET_JitDisasmSummary=1 biçiminde verirsin):
$ dotnet build -c Release samples/PipelineTour
$ DOTNET_JitStdOutFile=jit.txt DOTNET_JitDisasmSummary=1 dotnet samples/PipelineTour/bin/Release/net10.0/PipelineTour.dll
IsCheap calls: 1500, matches: 1000
$ grep -E 'IsCheap|get_Price|Main' jit.txt
   1: JIT compiled Program:<Main>$(System.String[]) [Instrumented Tier0, IL size=234, code size=1156]
   3: JIT compiled Filters:IsCheap(Book) [Tier0, IL size=22, code size=128]
   4: JIT compiled Book:get_Price() [Tier0, IL size=7, code size=40]
   5: JIT compiled Filters:IsCheap(Book) [Instrumented Tier0, IL size=22, code size=128]
   6: JIT compiled Book:get_Price() [Instrumented Tier0, IL size=7, code size=40]
  11: JIT compiled Filters:IsCheap(Book) [Tier1, IL size=22, code size=212]
  12: JIT compiled Book:get_Price() [Tier1, IL size=7, code size=40]
Tahminin cevabı burada: 1.500 çağrıya karşılık IsCheap üç kez derlendi. JIT bir method'u ilk çağrıldığında derliyor ve üretilen makine kodu process kapanana kadar kullanılıyor; sonraki çağrılar doğrudan o koda gidiyor. Üç satırın nedeni tiered compilation. İlk derleme Tier0: hiç optimizasyon yapmadan, hızlıca. Method 30 kez çağrılınca sık kullanılan bir method sayılıyor; Dynamic PGO (profile-guided optimization; çalışma anında toplanan profile göre optimizasyon) için önce sayaçlı bir Tier0 kopyası, yeterli veri toplanınca da optimize edilmiş Tier1 sürümü arka planda derleniyor. code size değerleri işlemci mimarisine göre değişir; sıra ve sayı değişmez.
Main'in ilk satırda doğrudan sayaçlı Tier0 ile derlenmesinin nedeni döngüleri. Bir kez çağrılan ama uzun süre dönen bir method'u Tier1'e taşımak için runtime OSR (on-stack replacement; çalışmakta olan bir döngüyü ortasında optimize edilmiş koda geçirmek) kullanıyor. Tier'lar, OSR ve PGO 05. yazının konusu; buradaki mesaj şu: C#'ta JIT her çağrıda değil, method başına birkaç kez derliyor.
.NET'te ikinci bir yol daha var: Native AOT (ahead-of-time; makine kodunu uygulama çalışmadan önce, publish sırasında üretmek). PublishAot açıkken ILC (Native AOT'nin IL'i makine koduna çeviren compiler'ı) bütün uygulamayı publish sırasında derliyor; ortaya çıkan executable'da JIT yok. Bedeli ve ReadyToRun gibi ara çözümler 06. yazıda.
TypeScript: Type Check Edilir, Sonra Silinir
interface Book {
  title: string;
  price: number;
}

function isCheap(book: Book): boolean {
  return book.price < 300;
}

function withShipping(book: Book): number {
  return book.price + 25;
}

// API price'ı string olarak gönderdi; cast compiler'ı susturuyor
const fromApi = JSON.parse('{"title":"Dune","price":"349.90"}') as Book;

console.log(isCheap(fromApi));
console.log(withShipping(fromApi));
$ npx tsc --version
Version 7.0.2
$ npx tsc
$ cat dist/book.js
function isCheap(book) {
return book.price < 300;
}
function withShipping(book) {
return book.price + 25;
}
// API price'ı string olarak gönderdi; cast compiler'ı susturuyor
const fromApi = JSON.parse('{"title":"Dune","price":"349.90"}');
console.log(isCheap(fromApi));
console.log(withShipping(fromApi));
export {};
$ node dist/book.js
false
349.9025İkinci tahminin cevabı: tsc hiçbir hata vermedi ve program 374.9 yerine 349.9025 yazdırdı. TypeScript compiler'ının iki işi var. Önce type check yapıyor; sonra tip bilgisini tamamen silip JavaScript üretiyor. dist/book.js'te ne interface ne de : number kaldı. Buna type erasure deniyor. Çalışma anında price'ın gerçekten number olup olmadığını kontrol eden hiçbir kod yok. as Book cast'i de bir dönüşüm yapmıyor, yalnızca compiler'a "bana güven" diyor. String ile sayıyı toplayan + operatörü de JavaScript kuralına göre birleştirme yapıyor.
TypeScript 7'nin compiler'ı Go ile yeniden yazıldı. Bu, compiler'ın kendisinin native çalışması demek; ürettiği JavaScript yine aynı. Ayrıntılar TypeScript İleri serisinin "TypeScript 7 ve Sonrası: Go ile Yazılan Derleyici ve Yeni Varsayılanlar" yazısında. Node.js de 22.18 ve 23.6 sürümlerinden beri .ts dosyalarını tipleri silerek doğrudan çalıştırabiliyor: node src/book.ts aynı iki satırı yazdırıyor, yine hiçbir tip kontrolü yapmadan.
JavaScript: V8'in Interpreter'ı ve JIT Katmanları
JavaScript'te build adımı yok (bundler ve minifier'ları saymazsak). Kaynak kod olduğu gibi engine'e gidiyor. Node.js'in ve Chrome'un engine'i V8, kodu önce parse edip bytecode'a çeviriyor ve Ignition adlı interpreter'ında çalıştırıyor:
function isCheap(book) {
  return book.price < 300;
}

const books = [
  { title: "Dune", price: 349.9 },
  { title: "Emma", price: 199 },
  { title: "The Hobbit", price: 289.5 },
];

let matches = 0;
for (let i = 0; i < 200_000; i++) {
  if (isCheap(books[i % books.length])) matches++;
}
console.log(`isCheap calls: 200000, matches: ${matches}`);
$ node --print-bytecode --print-bytecode-filter=isCheap samples/v8-tiers/hot.js
[generated bytecode for function: isCheap (0x2fbef05e8061 <SharedFunctionInfo isCheap>)]
Bytecode length: 14
Parameter count 2
Register count 1
Frame size 8
39 S> 0x3d5a20ef87b0 @ 0 : 33 03 00 00 GetNamedProperty a0, [0:"price"], FBV[0]
0x3d5a20ef87b4 @ 4 : d2 Star0
0x3d5a20ef87b5 @ 5 : 00 0d 2c 01 LdaSmi.Wide [300]
45 E> 0x3d5a20ef87b9 @ 9 : 77 f9 00 00 TestLessThan r0, EmbeddedFeedback[0x0]
51 S> 0x3d5a20ef87bd @ 13 : b7 ReturnBu bytecode, C#'taki IL'in V8'deki karşılığı: kaynak koddan bağımsız, interpreter'ın çalıştırdığı bir ara biçim. Fark, üretildiği yer. IL build sırasında diske yazılıyor; bytecode her çalıştırmada bellekte üretiliyor. FBV ve EmbeddedFeedback girdileri feedback slot'ları: interpreter, price'ın hangi object şekillerinden okunduğunu ve karşılaştırmanın hangi tiplerle yapıldığını buralara not ediyor. Sonraki katmanlar bu notlara bakarak derliyor:
$ node --trace-opt samples/v8-tiers/hot.js 2>&1 | grep -E 'isCheap|calls'
[marking 0x30b452f6f759 <JSFunction isCheap (sfi = 0x299a30568061)> for optimization to MAGLEV, ConcurrencyMode::kConcurrent, reason: hot and stable]
[compiling method 0x30b452f6f759 <JSFunction isCheap (sfi = 0x299a30568061)> (target MAGLEV), mode: ConcurrencyMode::kConcurrent]
[completed compiling 0x299a3056adc9 <JSFunction isCheap (sfi = 0x299a30568061)> (target MAGLEV) - took 0.000, 0.094, 0.004 ms]
[marking 0x299a3056adc9 <JSFunction isCheap (sfi = 0x299a30568061)> for optimization to TURBOFAN_JS, ConcurrencyMode::kConcurrent, reason: hot and stable]
[compiling method 0x299a3056adc9 <JSFunction isCheap (sfi = 0x299a30568061)> (target TURBOFAN_JS), mode: ConcurrencyMode::kConcurrent]
[completed compiling 0x299a3056adc9 <JSFunction isCheap (sfi = 0x299a30568061)> (target TURBOFAN_JS) - took 0.102, 7.268, 0.004 ms]
[completed optimizing 0x299a3056adc9 <JSFunction isCheap (sfi = 0x299a30568061)> (target TURBOFAN_JS)]
isCheap calls: 200000, matches: 133333
V8'in blogundaki güncel tabloya göre katmanlar şöyle: Ignition interpreter'ı, Sparkplug bytecode'u optimizasyon yapmadan çok hızlı makine koduna çeviren baseline compiler, Maglev 2023'te Chrome 117 ile gelen orta katman optimizing compiler, TurboFan en yavaş derleyen ama en hızlı kodu üreten katman. Çıktıda isCheap önce Maglev'e, sonra TurboFan'a çıkıyor. Bu karar zamanlamaya bağlı; aynı komutu birkaç kez çalıştırırsan bazen yalnız Maglev'de kaldığını görürsün.
V8'in .NET'ten en büyük farkı varsayım yapması. TurboFan, feedback'e bakıp "price hep sayıydı" varsayımıyla kod üretiyor. Bir gün string gelirse optimize edilmiş kod bırakılıyor ve fonksiyon bytecode'a geri dönüyor; buna deoptimization deniyor. C#'ta tipler build sırasında bilindiği için JIT bu tür bir varsayım yapmak zorunda değil. Dynamic PGO'nun yaptığı tahminler (örneğin bir interface çağrısının arkasında çoğunlukla hangi class'ın olduğu) ise yanlış çıkarsa geri dönüş için bir kontrol ile korunuyor.
"Derlenen Dil" Diye Bir Şey Yok
"C# derlenen, JavaScript yorumlanan bir dil" cümlesini çok duyarsın. Yukarıdaki çıktılar bu ayrımın dile değil, implementation'a ait olduğunu gösteriyor. JavaScript V8'de hem yorumlanıyor hem üç ayrı compiler'la derleniyor. C# Roslyn ile IL'e derleniyor, IL ise JIT ile ya da Native AOT ile makine koduna çevriliyor.
Aynı C# kodu yorumlandığı bir ortamda da çalışabiliyor. Microsoft Learn'deki Blazor WebAssembly dokümanına göre AOT açılmamış bir Blazor WebAssembly uygulaması, WebAssembly ile yazılmış bir IL interpreter'ında çalışıyor; RunAOTCompilation açılınca .NET kodu doğrudan WebAssembly'ye derleniyor. Python'da da durum aynı: CPython bytecode'u yorumluyor, PyPy aynı kodu JIT ile derliyor. Dil, programın ne anlama geldiğini tanımlar; o anlamın makinede nasıl yürütüleceği implementation'ın seçimidir.
Daha kullanışlı sorular şunlar: Tip hataları ne zaman yakalanıyor, build'de mi çalışma anında mı? Makine kodu ne zaman üretiliyor? Optimizer çalışma anındaki veriyi görebiliyor mu? Bu seride her aşamayı bu sorularla ele alacağız.
Seri Projesi: Bookstore Filtre Dili
Kavramları yalnız okuyarak öğrenmek zor; bu yüzden seri boyunca küçük bir dil yazacağız. Bookstore'un katalog ekranında ve yönetim panelinde kullanıcı, kitapları kısa bir sorguyla filtreleyebilsin:
price < 300 and author = "Jane Austen"
stock = 0 or (year < 1900 and not title contains "The")
Gereksinimleri baştan yazalım, çünkü her biri ileride bir compiler kararına dönüşecek:
- Alanlar:
title,author,isbn,price,year,stock. Bilinmeyen bir alan, hangi satırda ve sütunda olduğu söylenerek reddedilir. - Operatörler:
=,!=,<,<=,>,>=,contains; mantıksaland,or,not; gruplama için parantez. Keyword'lerde büyük/küçük harf fark etmez. - Literal'lar: sayı (ondalık ayırıcı her zaman nokta, makinenin dil ayarından bağımsız), çift tırnaklı string,
true/false. price = "abc"gibi tip hataları, filtre hiçbir kitaba uygulanmadan önce yakalanır.- Aynı filtre iki yerde çalışır: bellekteki bir kitap listesinde ve Entity Framework Core (EF Core; .NET'in veritabanı erişim kütüphanesi) üzerinden SQL Server'da. Kullanıcı girdisi SQL'e hiçbir zaman string olarak eklenmez.
- Kötü niyetli ya da hatalı girdi (çok uzun filtre, binlerce iç içe parantez) process'i çökertmez.
Grammar'ın ilk taslağı EBNF (Extended Backus-Naur Form; bir dilin söz dizimini kurallarla yazmak için kullanılan notasyon) ile şöyle (docs/grammar.ebnf):
filter     = expr , EOF ;
expr       = or_expr ;
or_expr    = and_expr , { "or" , and_expr } ;
and_expr   = not_expr , { "and" , not_expr } ;
not_expr   = "not" , not_expr | comparison ;
comparison = primary , [ comp_op , primary ] ;
primary    = field | literal | "(" , expr , ")" ;
comp_op    = "=" | "!=" | "<" | "<=" | ">" | ">=" | "contains" ;
literal    = number | string | "true" | "false" ;
field      = letter , { letter | digit | "_" } ;
number     = digit , { digit } , [ "." , digit , { digit } ] ;
string     = '"' , { string_char | '\"' | '\\' } , '"' ;
Kurallar yukarıdan aşağı okunduğunda öncelik de ortaya çıkıyor: or en gevşek, sonra and, sonra not, en sıkı bağlanan karşılaştırma. Yani a or b and c, a or (b and c) demek. Son üç kural (alan adı, sayı, string) lexer'ın işi, üsttekiler parser'ın. Yol haritası da buradan çıkıyor: 02. yazıda lexer, 03'te parser, AST ve AST'yi doğrudan çalıştıran bir interpreter, 04'te type checking ve aynı AST'den hem bellek içi delegate hem SQL üreten code generation. 05–07 runtime tarafına geçiyor (JIT, AOT, garbage collection), 08 dillerin nasıl evrildiğine bakıyor.
Üretimde Dikkat
JIT'li bir uygulamanın ilk istekleri sonrakilerden yavaş. Her method ilk çağrıldığında derleniyor ve önce optimize edilmemiş Tier0 koduyla çalışıyor. Deploy sonrası ilk dakikanın gecikme grafiği bu yüzden farklı görünür. Ölçüm yaparken warm-up'ı ayrı değerlendir; startup süresi kritikse ReadyToRun ve Native AOT seçenekleri 06. yazıda.
TypeScript tipleri sistemin sınırında seni korumaz. API'den, queue'dan, localStorage'dan gelen her veri çalışma anında doğrulanmalı. as ile yapılan cast bir doğrulama değil. Sınırda bir şema kütüphanesi ya da elle yazılmış bir kontrol kullan; tipin kendisi bu kontrolden türetilsin.
Tanılama çıktılarını production'da açık bırakma. DOTNET_JitDisasmSummary ve V8'in --trace-opt bayrağı öğrenmek ve bir sorunu incelemek için var; her derlemede çıktı üretiyorlar ve log'u gereksiz satırlarla dolduruyorlar.
Sık Düşülen Tuzaklar
"TypeScript tipleri runtime'da kontrol edilir" sanmak. Tipler build'de kontrol edilip siliniyor; yukarıdaki 349.9025 bunun sonucu. Çalışma anında tip bilgisi yalnız sen bir kontrol yazarsan var.
"C# yorumlanır" ya da tam tersi, "C# doğrudan makine koduna derlenir" demek. Normal bir .NET uygulamasında build IL üretiyor, makine kodu çalışma anında JIT ile geliyor. Native AOT'de ise makine kodu publish sırasında üretiliyor. Hangisinin kullanıldığını proje ayarı belirliyor, dil değil.
"JIT her çağrıda derler" sanmak. Çıktıda gördüğün gibi method başına birkaç derleme var; sonrasında aynı makine kodu kullanılıyor. JIT'in maliyeti ilk çağrılarda ödeniyor.
Debug build'de performans yorumlamak. Debug'da JIT optimizasyonları kapalı ve tiered compilation aynı şekilde çalışmıyor. Her performans ölçümünü Release build'de yap.
Küçük Bir Deneme
★☆☆ PipelineTour'u DOTNET_TieredCompilation=0 ile çalıştırıp jit.txt'ye yeniden bak. IsCheap kaç kez ve hangi etiketle derlendi? Bunun startup süresi için ne anlama geldiğini düşün.
★★☆ book.ts'teki as Book cast'ini kaldırıp fromApi'nin tipini unknown yap. tsc hangi satırlarda hata veriyor? price'ın gerçekten number olduğunu kontrol eden bir type guard yaz ve 349.9025 sorununun ortadan kalktığını göster.
★★★ hot.js'teki döngüde 100.000. çağrıdan sonra price'ı string olan bir kitap gönder. node --trace-opt --trace-deopt çıktısında deoptimization satırını bul ve hangi sebeple yazıldığını oku.
Bir sonraki yazıda pipeline'ın ilk aşamasını yazıyoruz: Bookstore filtre dili için C#'ta, ReadOnlySpan<char> üzerinde tek geçişte çalışan, her token'ın satırını ve sütununu bilen ve hatada "1. satır, 9. sütunda kapanmamış string" diyebilen bir lexer.