

Functional Dependency ve Anomaliler: Düz Tablo Neden Bozulur?
Düz tablo bozulur, çünkü bir satırı birden çok bağımsız olguyu birlikte taşır; insert, update ve delete anomaly'leri bunun üç yüzüdür. Sipariş Excel'ini SQL Server'a yükleyip üç anomaly'yi canlı gösteriyor, functional dependency, determinant, full, partial ve transitive dependency'yi tanımlıyor, closure'ı bir T-SQL procedure'üyle hesaplayıp candidate key'i buluyor ve veriden dependency keşfetmenin neden yanılttığını gösteriyoruz.
Sürüm notu: Bu yazıdaki SQL (Structured Query Language) örnekleri SQL Server 2025 (17.0, Cumulative Update 10) üzerinde çalıştırılmıştır.
Önce Tahmin Et: Ada'nın Telefonu Hangisi?
Serinin ilk yazısında tanıştığımız sipariş Excel'ini SQL Server'a olduğu gibi aldım. Her Excel kolonu bir tablo kolonu, her satır bir sipariş; benzersiz olduğundan emin olduğumuz tek şey sipariş numarası olduğu için primary key o:
CREATE TABLE dbo.order_sheet (
    order_no         INT           NOT NULL PRIMARY KEY,
    order_date       DATE          NOT NULL,
    customer         NVARCHAR(100) NOT NULL,
    email            VARCHAR(254)  NOT NULL,
    phone            VARCHAR(20)   NULL,
    city             NVARCHAR(50)  NULL,
    region           NVARCHAR(50)  NULL,
    shipping_address NVARCHAR(200) NULL,
    isbns            VARCHAR(500)  NOT NULL,
    books            NVARCHAR(1000) NOT NULL,
    authors          NVARCHAR(1000) NULL,
    prices           VARCHAR(200)  NOT NULL,
    quantities       VARCHAR(100)  NOT NULL,
    total            DECIMAL(10,2) NOT NULL
);
SELECT order_no, customer, phone, isbns, books, prices, quantities, total
FROM dbo.order_sheet
ORDER BY order_no;order_no customer phone isbns books prices quantities total
-------- ------------ ---------------- ---------------------------- ------------------------------- -------------- ---------- -------
1001 Ada Lovelace +90 532 000 0001 9798900000268, 9798900000428 Dune, Good Omens 390.50, 340.90 1, 1 731.40
1002 Alan Turing +90 533 000 0002 9798900000572 The Pragmatic Programmer 1150.00 1 1150.00
1003 Ada Lovelace +90 532 000 0001 9798900000305, 9798900000268 The Left Hand of Darkness, Dune 660.00, 351.45 1, 2 1362.90
1004 Grace Hopper +90 535 000 0003 9798900000411 A Wizard of Earthsea 200.50 3 601.50
1005 Alan Turing +90 533 000 0002 9798900000428 Good Omens 340.90 1 340.90
(5 rows affected)Ada müşteri hizmetlerini arıyor ve telefon numarasının değiştiğini söylüyor. Destek ekibindeki arkadaş Ada'nın son siparişini açıyor ve numarayı orada güncelliyor. Ardından biri "müşteri listesi"ni çekiyor:
UPDATE dbo.order_sheet SET phone = '+90 532 000 0099' WHERE order_no = 1003;

SELECT DISTINCT customer, email, phone
FROM dbo.order_sheet
ORDER BY customer, phone;
Tahmin et: Listede kaç müşteri görünür ve Ada'nın telefonu hangisidir?
(1 rows affected)
customer      email              phone
------------  -----------------  ----------------
Ada Lovelace  ada@example.com    +90 532 000 0001
Ada Lovelace  ada@example.com    +90 532 000 0099
Alan Turing   alan@example.com   +90 533 000 0002
Grace Hopper  grace@example.com  +90 535 000 0003

(4 rows affected)
Üç müşteri dört satır olarak çıktı ve Ada'nın iki telefonu var. Hangisinin doğru olduğunu tablo bilemez; bunu ancak sipariş tarihlerine bakıp "sonraki siparişteki numara herhalde günceldir" diye tahmin ederek söyleyebilirsin. Oysa güncelleme hatasız yapıldı, tek bir UPDATE, tek bir satır. Sorun güncellemede değil, tabloda: aynı olgu (Ada'nın telefonu) iki satırda ayrı ayrı yazılı ve tablo bu iki kopyanın aynı kalmasını garanti edecek hiçbir şey bilmiyor.
Bu yazıda düz tabloların neden bozulduğunu sistemli olarak görüyoruz: üç anomaly türü, bunların kaynağı olan functional dependency kavramı ve bir attribute kümesinin key olup olmadığını iş kurallarından hesaplamanın yolu. Normalizasyonun kendisi, yani tabloyu bölme işi, bir sonraki yazıda.
Update Anomaly: Aynı Olgunun Birden Çok Kopyası
Update anomaly, tek bir gerçek dünya olgusunun birden çok satırda tekrarlandığı ve bir güncellemenin bu kopyaların hepsine ulaşmadığı durumdur. Telefon örneği bunun en sade hâli. Excel'de bir tane daha var ve bu kez kimse bir şey güncellememiş bile:
SELECT order_no, books, authors
FROM dbo.order_sheet
WHERE authors LIKE N'%Le Guin%';
order_no books authors
-------- ------------------------------- --------------------------------
1003 The Left Hand of Darkness, Dune Ursula K. Le Guin; Frank Herbert
1004 A Wizard of Earthsea Ursula Le Guin
(2 rows affected)Aynı yazar 1003'te "Ursula K. Le Guin", 1004'te "Ursula Le Guin". İki siparişi farklı kişiler girmiş, biri baş harfi yazmış, diğeri yazmamış. "Le Guin'in kitapları kaç adet sattı?" sorusunun cevabı artık hangi yazımı aradığına bağlı. Update anomaly'nin sinsi tarafı bu: tutarsızlık bir güncelleme hatasıyla değil, aynı bilginin birden çok yere ayrı ayrı yazılmasıyla doğar ve ilk günden itibaren birikir.
Excel'de bir üçüncü kopya türü daha var: total kolonu. Fiyat ve adet kolonlarından hesaplanabilen bu değer de bir kopya; kalem düzeltilip toplam unutulursa iki kolon birbirini yalanlar.
Insert Anomaly: Var Olmayan Bir Şeyi Kaydetmeden Bir Şey Kaydedememek
Kitapçıya Isaac Asimov'un Foundation'ı geldi. Kataloğa eklenmesi, fiyatının girilmesi gerekiyor, ama henüz kimse sipariş etmedi. Bu tabloda bir kitabı kaydetmenin tek yolu bir sipariş satırının içinde olmak:
INSERT INTO dbo.order_sheet (isbns, books, authors, prices, quantities, total)
VALUES ('9798900000282', N'Foundation', N'Isaac Asimov', '660.90', '0', 0);
Msg 515, Level 16, State 2, Server b8be943222fa, Line 1
Cannot insert the value NULL into column 'order_no', table 'dm_05.dbo.order_sheet'; column does not allow nulls. INSERT fails.
The statement has been terminated.Hata mesajı teknik olarak order_no'nun boş geçilemeyeceğini söylüyor, ama asıl söylediği şu: bu tabloda bir kitap, bir siparişin parçası olmadan var olamaz. Önündeki seçenekler kötü: ya sahte bir sipariş numarası uydurursun (raporlarda bir "0 numaralı sipariş" belirir), ya da kitabı sipariş gelene kadar bir kenarda, başka bir Excel'de tutarsın. Aynı durum müşteri için de geçerli: henüz sipariş vermemiş bir müşteriyi kaydedemezsin.
Delete Anomaly: Bir Şeyi Silerken Başka Bir Şeyi Kaybetmek
Grace 1004 numaralı siparişini iptal ediyor ve birisi satırı siliyor:
DELETE FROM dbo.order_sheet WHERE order_no = 1004;

SELECT
    (SELECT COUNT(*) FROM dbo.order_sheet WHERE email = 'grace@example.com') AS grace_rows,
    (SELECT COUNT(*) FROM dbo.order_sheet WHERE isbns LIKE '%9798900000411%') AS earthsea_rows;
(1 rows affected)
grace_rows earthsea_rows
---------- -------------
0 0
(1 rows affected)Bir siparişi sildik, ama bununla birlikte Grace'in e-postası, telefonu ve şehri de gitti; çünkü bu bilgiler yalnızca o satırda yazılıydı. A Wizard of Earthsea da tablodan tamamen silindi: ISBN'i (International Standard Book Number), başlığı, yazarı. Silmek istediğimiz şey tek bir olguydu (bu sipariş), kaybettiğimiz şey üç ayrı olgu (bir sipariş, bir müşteri, bir kitap). İlk yazıdaki requirement listesine göre siparişler silinmiyor, iptal ediliyor; ama burada silme yerine "son siparişi arşive taşımak" ya da "eski siparişleri temizlemek" de aynı sonucu doğurur.
Üç anomaly'nin ortak noktası şu: tablonun bir satırı birden çok bağımsız olguyu birlikte taşıyor. E. F. Codd 1971'deki "Further Normalization of the Data Base Relational Model" çalışmasında 2NF (Second Normal Form) ve 3NF (Third Normal Form) tanımlarını bu tür insert, update ve delete bağımlılıklarından kurtulmak amacıyla ortaya koydu. Bu olguları ayırt etmenin aracı ise functional dependency.
Functional Dependency: X → Y
Bir tabloda X attribute kümesinin her değeri için Y'nin tek bir değeri varsa, Y X'e functional dependency ile bağlıdır denir ve X → Y diye yazılır. X'e determinant denir. "İki satırda X aynıysa Y de aynı olmak zorunda" diye de okuyabilirsin. email → phone şunu söyler: aynı e-postayı taşıyan iki satır farklı telefon taşıyamaz. Yukarıdaki güncellemeden sonra tablo tam olarak bu kuralı ihlal ediyor.
Trivial dependency, Y'nin zaten X'in içinde olduğu durumdur: {order_no, isbn} → isbn her zaman doğrudur ve hiçbir şey söylemez. Normalizasyonda ilgilendiğimiz dependency'ler non-trivial olanlar.
En önemli nokta: dependency'ler veriden değil, iş kuralından gelir. email → phone doğru, çünkü kitapçı her müşteri için tek bir telefon tutmaya karar vermiş. Kitapçı yarın "müşterinin birden çok telefonu olabilir" derse bu dependency ortadan kalkar ve model değişir. Aynı şekilde shipping_address'in neye bağlı olduğu bir iş kararıdır. Adres müşterinin bir özelliği mi (email → shipping_address), yoksa sipariş anında sabitlenen bir bilgi mi (order_no → shipping_address)? Kitapçı, sipariş fiyatında olduğu gibi teslimat adresinin de sipariş anındaki hâliyle saklanmasını istiyor; müşteri taşınsa bile geçmiş siparişin nereye gittiği değişmemeli. Bu yüzden adres siparişe bağlı.
Excel'in hücrelerinde liste olduğu için dependency'leri kalem seviyesinde düşünmemiz gerekiyor: bir satır, bir siparişteki bir kitap. Bir sonraki yazıda 1NF ile bu görünümü fiziksel hâle getireceğiz. Kitapçının kurallarından çıkan dependency'ler şunlar:
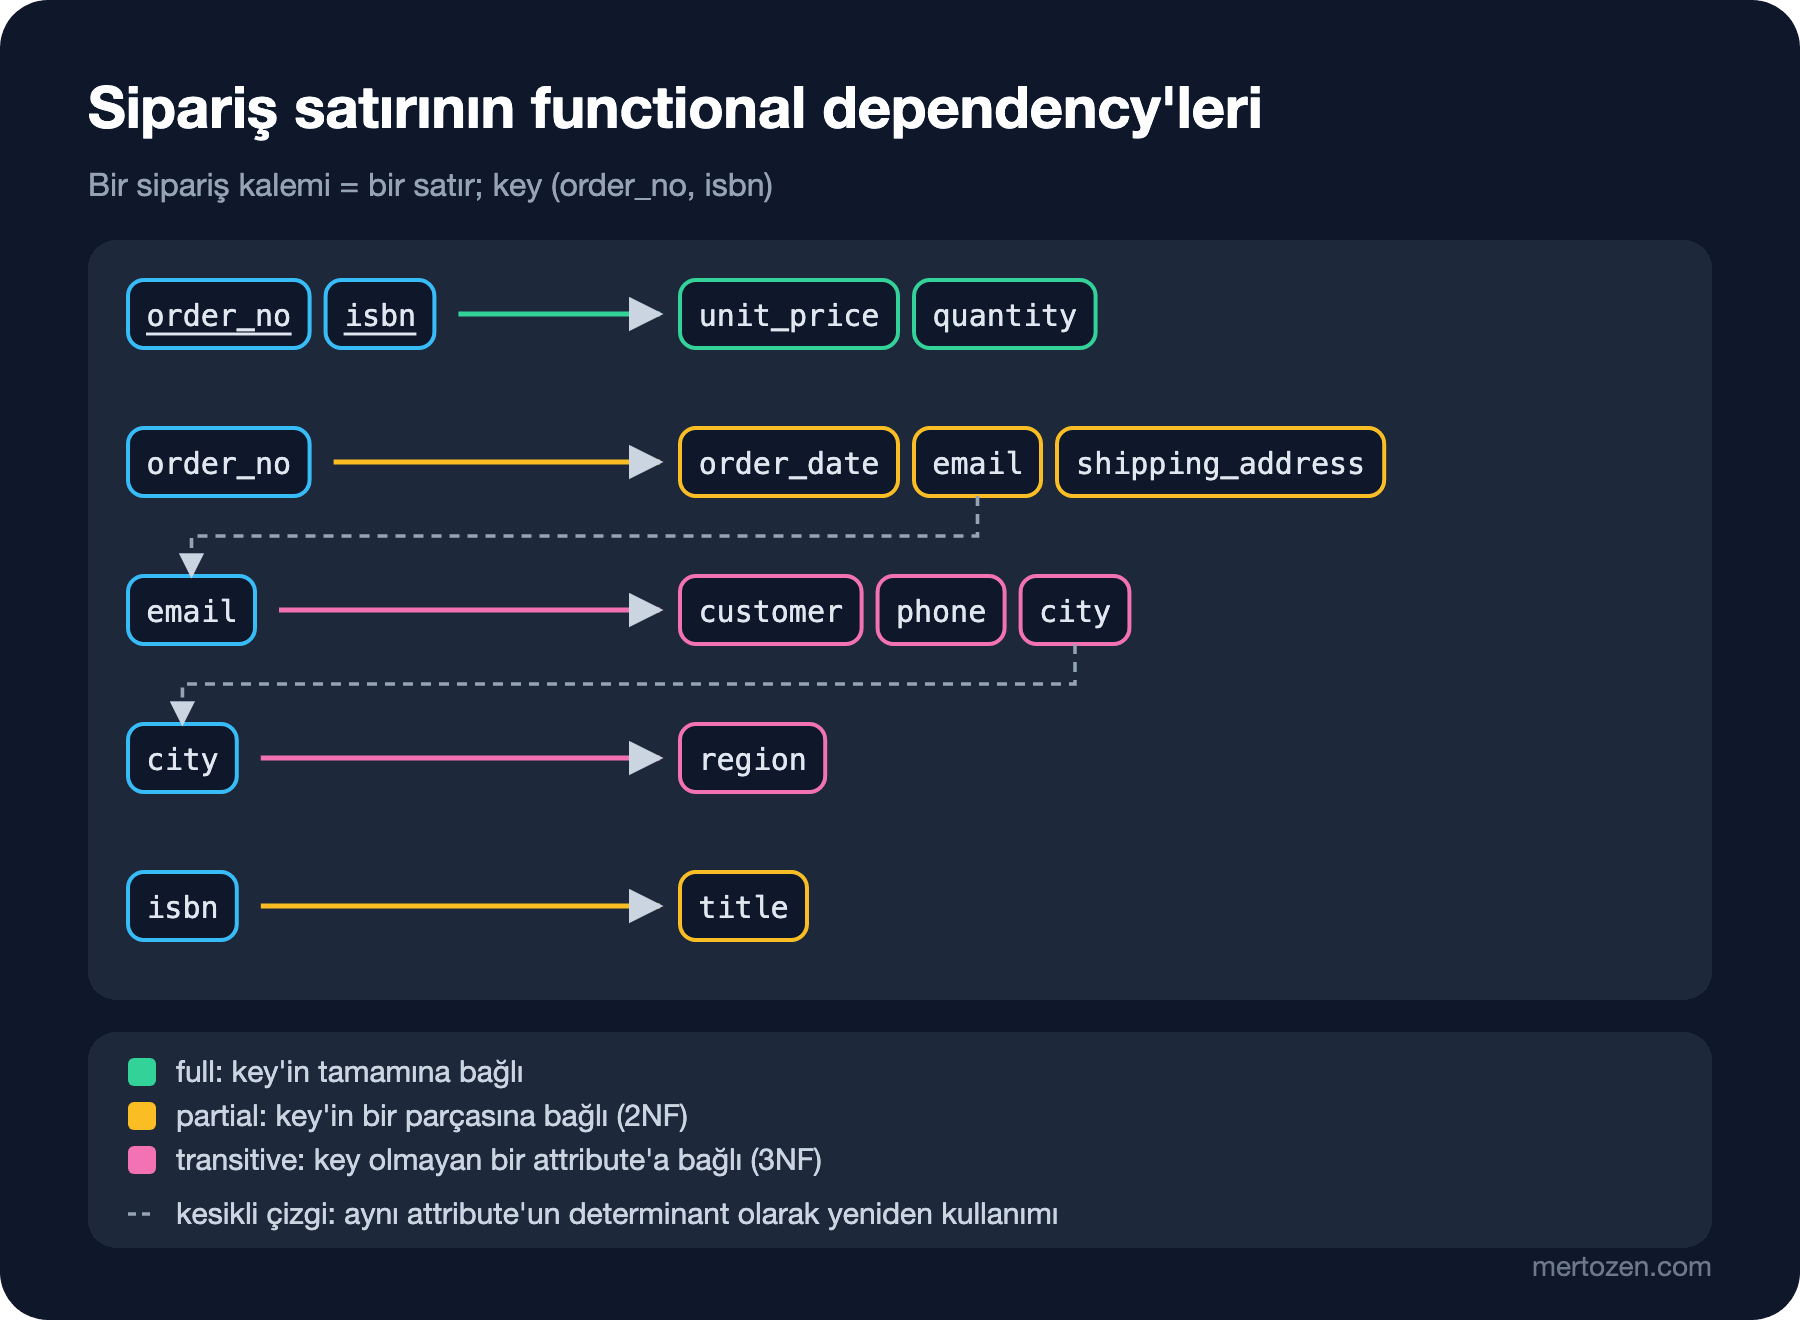
order_no → order_date, email, shipping_address: Sipariş numarası siparişin tarihini, müşterisini ve teslimat adresini belirler. email → customer, phone, city: E-posta müşteriyi ve müşterinin kayıtlı bilgilerini belirler. city → region: Şehir bölgeyi belirler. isbn → title: ISBN kitabın başlığını belirler. {order_no, isbn} → unit_price, quantity: Fiyat ve adet ancak siparişle kitap birlikte bilinince belirlenir. Dune 1001'de 390.50'ye, 1003'te 351.45'e satıldığı için isbn → unit_price bir dependency değil; ilk yazıda gördüğümüz "fiyat kalemin bilgisidir" kuralı burada bir dependency'nin yokluğu olarak karşımıza çıkıyor. Yazarlar ise bir kitap için birden çok değer taşıdığı için isbn → authors bildiğimiz anlamda bir functional dependency değil; bu tür çok değerli bağımlılıkları serinin 7. yazısında 4NF ile konuşacağız.
Full, Partial ve Transitive Dependency
Figürdeki renkler, bir sonraki yazıda yapacağımız bölmenin haritası. Kalem tablosunun key'i {order_no, isbn} ve key olmayan her attribute'un bu key'e nasıl bağlı olduğu üç sınıfa ayrılıyor.
Full dependency, attribute'un key'in tamamına bağlı olmasıdır: unit_price ve quantity için hem sipariş hem kitap gerekiyor. Bunlar kalem tablosunda kalmalı.
Partial dependency, attribute'un composite key'in yalnızca bir parçasına bağlı olmasıdır: order_date yalnızca order_no'ya, title yalnızca isbn'e bağlı. Partial dependency'nin olduğu her yerde tekrar vardır: Dune iki siparişte geçtiği için başlığı iki kez yazılır. 2NF bu dependency'leri ortadan kaldırır.
Transitive dependency, attribute'un key'e başka bir key olmayan attribute üzerinden bağlı olmasıdır: order_no → email → phone ve email → city → region. Ada'nın telefonu siparişin değil, Ada'nın bilgisi; sipariş ona yalnızca e-posta üzerinden ulaşıyor. Telefon anomalisinin kaynağı tam olarak bu. 3NF bu dependency'leri ortadan kaldırır.
William Kent'in 1983 tarihli "A Simple Guide to Five Normal Forms in Relational Database Theory" makalesi, iki kuralı tek bir hatırlatmada birleştirir; kendi kelimelerimizle: key olmayan bir alan, key'in bir parçasına değil tamamına bağlı olmalı ve key'e başka bir alan üzerinden değil doğrudan bağlı olmalı. İlk yarı partial dependency'yi, ikinci yarı transitive dependency'yi dışarıda bırakır.
Closure ile Key Bulmak
Bir attribute kümesinin key olup olmadığını dependency'lerden hesaplayabilirsin. Yöntem, bir kümenin closure'ını bulmaktır: kümeden başla, sol tarafı tamamen kümenin içinde olan her dependency'nin sağ tarafını kümeye ekle, eklenecek bir şey kalmayana kadar tekrarla. Sonuç, başlangıç kümesinin belirlediği tüm attribute'lar. Closure tablonun tüm attribute'larını içeriyorsa başlangıç kümesi bir superkey'dir. Bu çıkarımın kuralları 1974'te William W. Armstrong tarafından formüle edildi ve bugün Armstrong's axioms (reflexivity, augmentation, transitivity) olarak biliniyor; ama hesabı yapmak için kuralları ezberlemen gerekmiyor. Dependency'leri bir tabloya yazıp closure'ı SQL Server'a hesaplatalım:
CREATE TABLE dbo.fds (
    fd_id INT         NOT NULL,
    side  CHAR(3)     NOT NULL CHECK (side IN ('lhs', 'rhs')),
    attr  VARCHAR(30) NOT NULL
);
INSERT INTO dbo.fds (fd_id, side, attr) VALUES
    (1, 'lhs', 'order_no'), (1, 'rhs', 'order_date'), (1, 'rhs', 'email'), (1, 'rhs', 'shipping_address'),
    (2, 'lhs', 'email'),    (2, 'rhs', 'customer'),   (2, 'rhs', 'phone'), (2, 'rhs', 'city'),
    (3, 'lhs', 'city'),     (3, 'rhs', 'region'),
    (4, 'lhs', 'isbn'),     (4, 'rhs', 'title'),
    (5, 'lhs', 'order_no'), (5, 'lhs', 'isbn'),       (5, 'rhs', 'unit_price'), (5, 'rhs', 'quantity');
GO

CREATE OR ALTER PROCEDURE dbo.attribute_closure @attrs VARCHAR(400)
AS
BEGIN
    SET NOCOUNT ON;
    DECLARE @closure TABLE (attr VARCHAR(30) PRIMARY KEY, step INT NOT NULL);
    INSERT INTO @closure (attr, step)
    SELECT TRIM(value), 0 FROM STRING_SPLIT(@attrs, ',');

    DECLARE @step INT = 0, @added INT = 1;
    WHILE @added > 0
    BEGIN
        SET @step += 1;
        INSERT INTO @closure (attr, step)
        SELECT DISTINCT r.attr, @step
        FROM dbo.fds AS r
        WHERE r.side = 'rhs'
          AND r.attr NOT IN (SELECT attr FROM @closure)
          AND NOT EXISTS (SELECT 1 FROM dbo.fds AS l
                          WHERE l.fd_id = r.fd_id AND l.side = 'lhs'
                            AND l.attr NOT IN (SELECT attr FROM @closure));
        SET @added = @@ROWCOUNT;
    END;

    SELECT step, STRING_AGG(attr, ', ') WITHIN GROUP (ORDER BY attr) AS attributes
    FROM @closure
    GROUP BY step
    ORDER BY step;
END;
EXEC dbo.attribute_closure 'order_no';
EXEC dbo.attribute_closure 'order_no, isbn';step attributes
---- -----------------------------------
0 order_no
1 email, order_date, shipping_address
2 city, customer, phone
3 region
step attributes
---- ----------------------------------------------------------------
0 isbn, order_no
1 email, order_date, quantity, shipping_address, title, unit_price
2 city, customer, phone
3 regionorder_no'nun closure'ı sekiz attribute'a ulaşıyor ama isbn, title, unit_price ve quantity dışarıda kalıyor; yani sipariş numarası tek başına bir kalem satırını belirlemiyor. {order_no, isbn}'in closure'ı ise on iki attribute'un hepsine ulaşıyor: superkey. Minimal mi? order_no tek başına yetmedi; isbn'in closure'ı ise yalnızca {isbn, title}. İkisinden biri atılınca key özelliği kayboluyor, demek ki {order_no, isbn} bir candidate key. Bir önceki yazıda "candidate key'i iş kuralına bakarak bulursun" demiştik; closure bu cümlenin hesap hâli.
Adımlar da bilgi taşıyor. 1. adımda gelen attribute'lar key'e doğrudan bağlı; 2. ve 3. adımda gelenler ise ancak araya giren bir attribute üzerinden ulaşılabilir olanlar, yani transitive dependency'ler. Figürdeki pembe kutular tam olarak bu attribute'lar.
Üretimde Dikkat
Dependency listesini modelin parçası olarak yaz. Requirement listesinin yanında "hangi bilgi neyi belirler?" listesi, şema review'ında en çok tartışılan soruların cevabını önceden verir. Yukarıdaki gibi küçük bir tablo bile yeterli.
Anomaly'yi production'da fark etmenin yolu, olması gereken dependency'leri düzenli kontrol etmek. GROUP BY email HAVING COUNT(DISTINCT phone) > 1 gibi bir sorgu, normalize edilmemiş bir raporlama tablosunda ya da bir import staging tablosunda tutarsızlığı erkenden yakalar. Bu sorgu bir kuralın ihlal edildiğini gösterebilir; kuralın doğru olduğunu ise asla gösteremez.
Normalizasyonun okuma tarafında bir maliyeti olduğunu unutma. Kent de aynı makalede normal form kurallarının güncellemeyi korumak için tasarlandığını ve bunun bedelini çoğu zaman okuma tarafının ödediğini vurgular. Tabloyu böldükçe sorgular join'lere dönüşür. Bu bedeli ne zaman kabul etmeyeceğin, yani bilinçli denormalization, serinin 8. yazısının konusu.
Import işlerinde düz tabloyu staging olarak kabul et. Excel ya da CSV (Comma-Separated Values) dosyalarını önce olduğu gibi bir staging tablosuna almak doğru; hata, o staging tablosunun kalıcı modele dönüşmesi. Toplu import akışı Çözüm Desenleri serisinin "Toplu Import ve Validation Raporu" yazısında.
Sık Düşülen Tuzaklar
En yaygın tuzak, örnek veriye bakıp dependency "keşfetmek". Excel'i yeniden yükleyip birkaç aday dependency'yi veriyle test edelim. Sorgu her aday için kuralı ihlal eden grup sayısını sayıyor:
SELECT 'email -> phone' AS candidate,
       (SELECT COUNT(*) FROM (SELECT email FROM dbo.order_sheet
                              GROUP BY email HAVING COUNT(DISTINCT phone) > 1) AS v) AS violations
UNION ALL
SELECT 'city -> email',
       (SELECT COUNT(*) FROM (SELECT city FROM dbo.order_sheet
                              GROUP BY city HAVING COUNT(DISTINCT email) > 1) AS v)
UNION ALL
SELECT 'order_date -> order_no',
       (SELECT COUNT(*) FROM (SELECT order_date FROM dbo.order_sheet
                              GROUP BY order_date HAVING COUNT(DISTINCT order_no) > 1) AS v)
UNION ALL
SELECT 'customer -> total',
       (SELECT COUNT(*) FROM (SELECT customer FROM dbo.order_sheet
                              GROUP BY customer HAVING COUNT(DISTINCT total) > 1) AS v);
candidate violations
---------------------- ----------
email -> phone 0
city -> email 0
order_date -> order_no 0
customer -> total 2
(4 rows affected)Veri, city → email ve order_date → order_no dependency'lerinin "tuttuğunu" söylüyor: her şehirde tek müşteri, her günde tek sipariş var. İkisi de saçma; İstanbul'dan ikinci müşteri ya da aynı gün ikinci sipariş geldiği an bozulacaklar. Beş satırlık bir tabloda tesadüfen tutan ilişki çoktur ve beş bin satırlık bir tabloda da azımsanmayacak kadar vardır. Bu tür bir "keşfi" key'e ya da tablo sınırına çevirirsen, model ilk gerçek veride çöker. customer → total için sonuç farklı: iki ihlal var. Veri bir dependency'yi çürütebilir ama kanıtlayamaz. Hangi dependency'nin gerçek olduğuna yalnızca iş kuralı karar verir.
Snapshot'ı tekrar sanmak. unit_price ile katalog fiyatı aynı değeri taşıyabilir, ama isbn → unit_price bir dependency değil. Bunu "tekrar" diye kitap tablosuna taşımak, geçmiş siparişlerin tutarını değiştirir.
Derived kolonu dependency listesine koymamak. total, kalemlerden hesaplanabildiği için aslında bir dependency'nin sonucu; listede görünmezse normalizasyon sırasında sessizce sipariş tablosunda kalır ve kalemlerle çelişmeye başlar.
Anomaly'yi uygulama koduyla yamamak. "Telefonu güncellerken müşterinin bütün satırlarını güncelleriz" kuralı, ikinci bir ekran ya da bir toplu script aynı kuralı bilmediği gün bozulur. Kopyayı senkron tutmaya çalışmak yerine kopyayı ortadan kaldırmak gerekir.
Küçük Bir Deneme
★☆☆ order_sheet tablosunda email → customer ve isbns → books adaylarını aynı ihlal sorgusuyla test et. İkinci aday neden anlamlı bir sonuç vermiyor? Liste taşıyan bir kolon üzerinde dependency konuşmak mümkün mü?
★★☆ Kitapçı "müşteri her siparişte farklı bir teslimat şehri seçebilir, bölge raporu teslimat şehrine göre yapılsın" diyor. dbo.fds tablosundaki dependency'leri buna göre değiştir ve order_no'nun closure'ını yeniden hesapla. Hangi attribute hangi adımda geliyor?
★★★ dbo.attribute_closure procedure'ünü kullanarak tüm candidate key'leri bulan bir script yaz: attribute'ların bütün alt kümelerini küçükten büyüğe dene, closure'ı tüm attribute'ları içeren ve hiçbir alt kümesi superkey olmayanları listele. On iki attribute için kaç alt küme denemen gerekiyor?
Anomaly'leri gördük ve kaynaklarını dependency olarak adlandırdık. Bir sonraki yazıda bu haritayla tabloyu bölüyoruz: 1NF ile listeleri satırlara açmak, 2NF ile partial, 3NF ile transitive dependency'leri ayırmak ve her adımda bölünen tabloların SQL JOIN ile kayıpsız birleştiğini göstermek.