

OLTP ve OLAP Modeling: Dimensional Model, Star Schema ve Slowly Changing Dimension
Normalize OLTP şeması yazma için, dimensional model okuma için tasarlanır: önce grain ilan edilir, ölçüler fact tablosuna, bağlam denormalize dimension'lara gider. SQL Server'da Bookstore satışlarından star schema kuruyor, aynı raporun OLTP sorgusunda neden satış kaybettiğini, kategori değişince Type 1, 2 ve 3 slowly changing dimension'ın geçmiş raporlara etkisini, grain karışınca çift saymayı ve columnstore'u gösteriyoruz.
Sürüm notu: Bu yazıdaki SQL (Structured Query Language) örnekleri SQL Server 2025 (17.0, Cumulative Update 10) üzerinde çalıştırılmıştır.
Önce Tahmin Et: İki Sorgu Aynı Raporu Verir mi?
Yönetim, 2026'nın ikinci çeyreği için ay ve üst kategori bazında ciro istiyor. Bir geliştirici raporu doğrudan OLTP (Online Transaction Processing) şemasından yazıyor: siparişler, kalemler, kitaplar ve iki kez kategoriler. Bir başkası aynı raporu bu yazıda kuracağımız star schema'dan yazıyor: bir fact tablosu ve iki dimension. İki sorgu da iptal edilen siparişleri dışarıda bırakıyor, ikisi de aynı veriden besleniyor. Tahmin et: iki rapor aynı satırları ve aynı toplamları verir mi?
Vermiyor. OLTP sorgusu 670,50 liralık satışı sessizce kaybediyor ve nedeni bir hata değil, normalize bir şemada rapor yazmanın doğası. Bu yazıda normalize OLTP şemasının raporlamada neden yorulduğuna, OLAP (Online Analytical Processing) tarafının dimensional model'ine, star schema'ya ve geçmiş raporların bugünkü değişikliklerden nasıl korunduğuna, yani slowly changing dimension'lara bakacağız. Örnekler SQL Temelleri serisinin Bookstore şemasının yüklü olduğu dm_10 veritabanında.
Normalize Şema Raporlamada Neden Yorulur?
Serinin ilk yedi yazısında şemayı yazma için optimize ettik: her olgu tek bir yerde, her değişiklik tek bir satırda, anomaly yok. Rapor ise tersini ister: çok sayıda satırı okuyup gruplamak, aynı soruyu her seferinde farklı bir kırılımla sormak. Normalize şemada bu, her raporda aynı join zincirini yeniden kurmak demek. Ciro raporu için kalemden siparişe, siparişten tarihe, kalemden kitaba, kitaptan kategoriye ve kategoriden üst kategoriye gitmek gerekiyor; "iptal edilenleri sayma" kuralı da her sorguda tekrar yazılıyor.
İkinci sorun tarih. OLTP şemasında "çeyrek", "ay adı" ya da "hafta içi mi?" diye bir kolon yok; her rapor bunları DATEPART ile hesaplıyor ve her geliştirici biraz farklı hesaplıyor. Üçüncü sorun geçmiş: OLTP'de bir kitabın kategorisi değişince eski değer yok olur, çünkü normalize şema "şu anki gerçeği" tutar. Geçen yılın raporu bugün çalıştırıldığında farklı sonuç verir. Dördüncü sorun yük: ağır bir rapor sorgusu, siparişleri yazan transaction'larla aynı tablolar ve aynı buffer pool için yarışır.
Dimensional model bu dört sorunu tek bir fikirle ele alır: raporlama için veriyi ayrı bir yapıya, okumaya göre şekillendirerek kopyala. Bu, 8. yazıdaki denormalization'ın en uç ve en sistemli hâli; kopyayı güncel tutan mekanizma da genellikle bir ETL (Extract, Transform, Load) job'ı.
Fact, Dimension ve Önce Grain
Dimensional model'de iki tür tablo var. Fact tablosu ölçülen olayları tutar: satış, ödeme, stok hareketi. Satırları çoktur, kolonları çoğunlukla sayıdır (adet, tutar) ve dimension'lara giden key'lerdir. Dimension tablosu olayın bağlamını tutar: ne zaman, hangi kitap, hangi müşteri. Satırları azdır, kolonları açıklayıcı metinlerdir ve raporun filtre, gruplama ve etiketleri buradan gelir.
Tasarımın ilk kararı ise ne fact ne dimension; grain'dir, yani fact tablosundaki bir satırın neyi temsil ettiği. Kimball Group'un dimensional modeling tekniklerinde grain'i ilan etmek tasarımın en önemli adımı sayılır ve dimension'lar ile ölçüler ancak bu karardan sonra seçilir; mümkün olan en ayrıntılı seviyede (atomic grain) başlamak önerilir, çünkü ayrıntılı veri önceden bilinmeyen soruları da cevaplayabilir. Bookstore satışı için grain şu: "iptal edilmemiş bir siparişteki bir kitap", yani bir sipariş kalemi. Bu karar her şeyi belirliyor: tarih siparişin tarihi, müşteri siparişin müşterisi, ölçüler kalemin adedi ve tutarı. Sipariş numarası ise kendi tablosu olmayan bir dimension olarak fact'te kalıyor; buna degenerate dimension denir.
Bookstore Star Schema'sını Kurmak
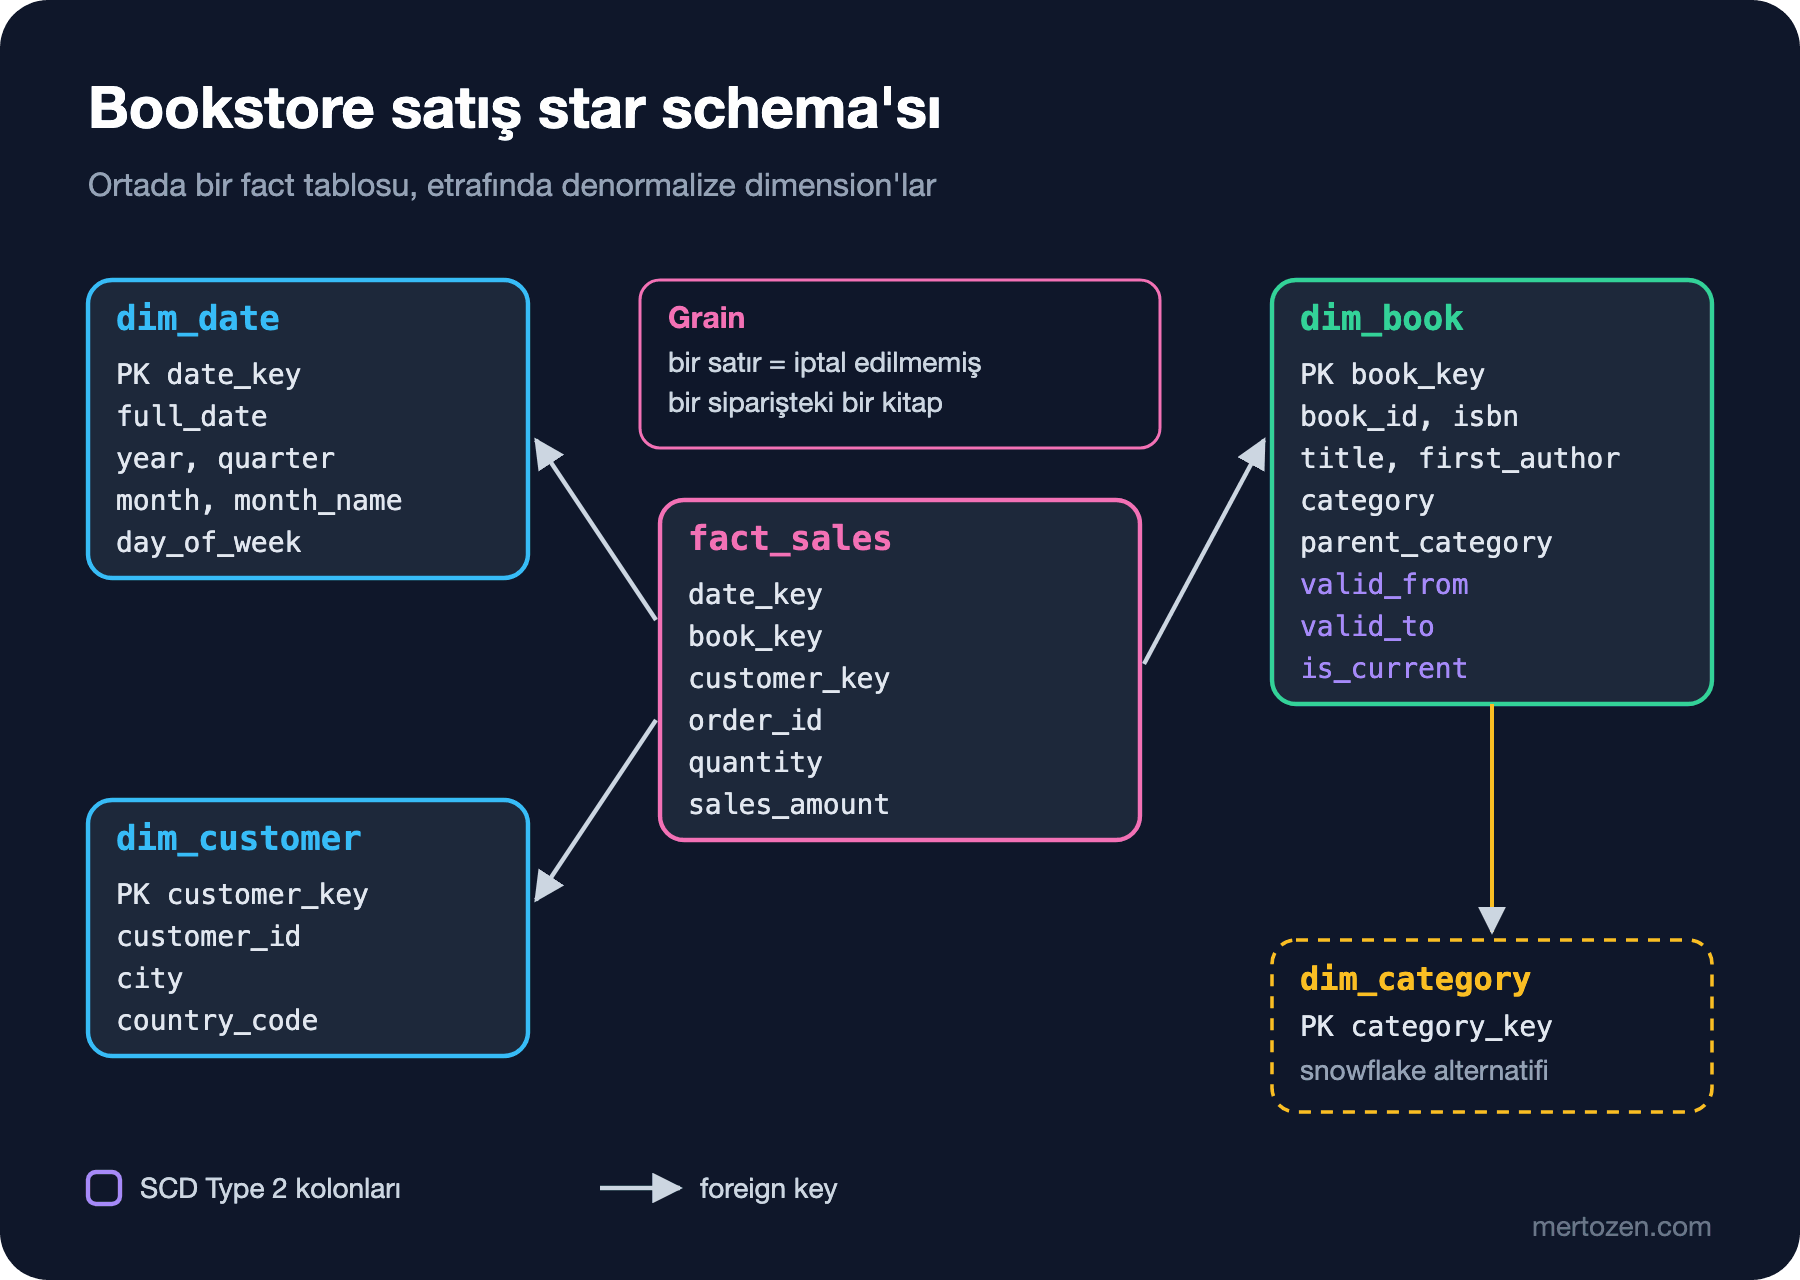
Ortada fact_sales, etrafında üç dimension. Dimension'lar kendi surrogate key'lerine sahip (book_key, customer_key); OLTP'deki book_id ise sıradan bir kolon olarak duruyor. Bunun nedeni birazdan göreceğimiz geçmiş takibi: bir kitap dimension'da birden çok satıra sahip olabilecek.
CREATE TABLE dbo.dim_date (
    date_key     INT         NOT NULL,
    full_date    DATE        NOT NULL,
    year         SMALLINT    NOT NULL,
    quarter      TINYINT     NOT NULL,
    month        TINYINT     NOT NULL,
    month_name   VARCHAR(10) NOT NULL,
    day_of_week  VARCHAR(10) NOT NULL,
    CONSTRAINT PK_dim_date PRIMARY KEY (date_key)
);
CREATE TABLE dbo.dim_book (
    book_key        INT IDENTITY(1,1) NOT NULL,
    book_id         INT               NOT NULL,
    isbn            CHAR(13)          NOT NULL,
    title           NVARCHAR(200)     NOT NULL,
    first_author    NVARCHAR(201)     NULL,
    category        NVARCHAR(100)     NOT NULL,
    parent_category NVARCHAR(100)     NOT NULL,
    valid_from      DATE              NOT NULL,
    valid_to        DATE              NOT NULL,
    is_current      BIT               NOT NULL,
    CONSTRAINT PK_dim_book PRIMARY KEY (book_key)
);
CREATE TABLE dbo.dim_customer (
    customer_key INT IDENTITY(1,1) NOT NULL,
    customer_id  INT               NOT NULL,
    city         NVARCHAR(100)     NOT NULL,
    country_code CHAR(2)           NOT NULL,
    CONSTRAINT PK_dim_customer PRIMARY KEY (customer_key)
);
CREATE TABLE dbo.fact_sales (
    date_key     INT           NOT NULL REFERENCES dbo.dim_date (date_key),
    book_key     INT           NOT NULL REFERENCES dbo.dim_book (book_key),
    customer_key INT           NOT NULL REFERENCES dbo.dim_customer (customer_key),
    order_id     INT           NOT NULL,
    quantity     INT           NOT NULL,
    sales_amount DECIMAL(12,2) NOT NULL
);
dim_book bilinçli olarak denormalize: kategori ve üst kategori adları, ilk yazarın adı aynı satırda. OLTP'de bu üç tablo ve iki join demekti; burada tek bir kolon. Dimension'lar küçük olduğu ve nadiren değiştiği için bu tekrarın anomaly maliyeti düşük, kazancı ise her raporda. Kategoriyi ayrı bir dim_category tablosunda normalize etmek snowflake schema olur. Snowflake depolamadan biraz kazandırır ama her rapora bir join ekler; çoğu durumda star tercih edilir. Yükleme script'i:
INSERT INTO dbo.dim_date (date_key, full_date, year, quarter, month, month_name, day_of_week)
SELECT CONVERT(INT, CONVERT(CHAR(8), d, 112)), d, YEAR(d), DATEPART(QUARTER, d), MONTH(d),
       DATENAME(MONTH, d), DATENAME(WEEKDAY, d)
FROM (SELECT DATEADD(DAY, value, CAST('2025-01-01' AS DATE)) AS d
      FROM GENERATE_SERIES(0, 729)) AS days;

INSERT INTO dbo.dim_book (book_id, isbn, title, first_author, category, parent_category,
                          valid_from, valid_to, is_current)
SELECT b.book_id, b.isbn, b.title, a.first_name + N' ' + a.last_name,
       ISNULL(c.name, N'Uncategorized'), ISNULL(p.name, ISNULL(c.name, N'Uncategorized')),
       '2025-01-01', '9999-12-31', 1
FROM dbo.books AS b
LEFT JOIN dbo.categories AS c ON c.category_id = b.category_id
LEFT JOIN dbo.categories AS p ON p.category_id = c.parent_category_id
LEFT JOIN dbo.book_authors AS ba ON ba.book_id = b.book_id AND ba.author_order = 1
LEFT JOIN dbo.authors AS a ON a.author_id = ba.author_id;

INSERT INTO dbo.dim_customer (customer_id, city, country_code)
SELECT customer_id, ISNULL(city, N'Unknown'), country_code
FROM dbo.customers;

INSERT INTO dbo.fact_sales (date_key, book_key, customer_key, order_id, quantity, sales_amount)
SELECT CONVERT(INT, CONVERT(CHAR(8), o.ordered_at, 112)), db.book_key, dc.customer_key,
       o.order_id, oi.quantity, oi.quantity * oi.unit_price
FROM dbo.orders AS o
JOIN dbo.order_items AS oi ON oi.order_id = o.order_id
JOIN dbo.dim_book AS db ON db.book_id = oi.book_id
     AND CAST(o.ordered_at AS DATE) >= db.valid_from AND CAST(o.ordered_at AS DATE) < db.valid_to
JOIN dbo.dim_customer AS dc ON dc.customer_id = o.customer_id
WHERE o.status <> 'Cancelled';
(730 rows affected)
(77 rows affected)
(40 rows affected)
(641 rows affected)İki ayrıntıya dikkat et. Kategorisi olmayan kitaplar dim_book'a 'Uncategorized' olarak giriyor: dimension'da NULL yerine açıkça adlandırılmış bir "bilinmiyor" değeri tutmak dimensional modeling'in yerleşik bir alışkanlığı. Fact yüklemesi ise kitabı yalnızca book_id ile değil, siparişin tarihini kapsayan geçerlilik aralığıyla eşleştiriyor. Bu satır şimdilik gereksiz görünüyor; geçmiş takibi bölümünde işe yarayacak. 641 satır, 680 kalemden iptal edilen siparişlerin kalemleri çıkınca kalan sayı.
Aynı Rapor İki Modelde
Tahmin sorusundaki iki sorgu. Önce OLTP şemasından:
SELECT YEAR(o.ordered_at) AS year, MONTH(o.ordered_at) AS month,
       COALESCE(p.name, c.name) AS parent_category,
       SUM(oi.quantity * oi.unit_price) AS revenue
FROM dbo.orders AS o
JOIN dbo.order_items AS oi ON oi.order_id = o.order_id
JOIN dbo.books AS b ON b.book_id = oi.book_id
JOIN dbo.categories AS c ON c.category_id = b.category_id
LEFT JOIN dbo.categories AS p ON p.category_id = c.parent_category_id
WHERE o.status <> 'Cancelled'
  AND o.ordered_at >= '2026-04-01' AND o.ordered_at < '2026-07-01'
GROUP BY YEAR(o.ordered_at), MONTH(o.ordered_at), COALESCE(p.name, c.name)
ORDER BY year, month, parent_category;
year month parent_category revenue
---- ----- --------------- --------
2026 4 Children 880.50
2026 4 Computing 3550.00
2026 4 Fiction 11620.00
2026 5 Children 200.00
2026 5 Computing 3250.00
2026 5 Fiction 7528.10
2026 5 Non-Fiction 601.50
2026 6 Children 510.00
2026 6 Computing 1150.00
2026 6 Fiction 10190.70
2026 6 Non-Fiction 401.00
(11 rows affected)Sonra star schema'dan:
SELECT d.year, d.month, b.parent_category, SUM(f.sales_amount) AS revenue
FROM dbo.fact_sales AS f
JOIN dbo.dim_date AS d ON d.date_key = f.date_key
JOIN dbo.dim_book AS b ON b.book_key = f.book_key
WHERE d.year = 2026 AND d.quarter = 2
GROUP BY d.year, d.month, b.parent_category
ORDER BY d.year, d.month, b.parent_category;
year month parent_category revenue
---- ----- --------------- --------
2026 4 Children 880.50
2026 4 Computing 3550.00
2026 4 Fiction 11620.00
2026 5 Children 200.00
2026 5 Computing 3250.00
2026 5 Fiction 7528.10
2026 5 Non-Fiction 601.50
2026 5 Uncategorized 670.50
2026 6 Children 510.00
2026 6 Computing 1150.00
2026 6 Fiction 10190.70
2026 6 Non-Fiction 401.00
(12 rows affected)Star sorgusu bir satır fazla: Mayıs'ta kategorisi olmayan kitaplardan (The Elements of Style ya da Meditations) 670,50 liralık satış. OLTP sorgusundaki JOIN dbo.categories bir inner join olduğu için kategorisi NULL olan kitapların kalemleri rapordan düştü. Bunu düzeltmek kolay (LEFT JOIN ve bir COALESCE), ama mesele düzeltmenin kolaylığı değil: aynı kararın her raporda, her geliştirici tarafından yeniden verilmesi gerekiyor. Star schema'da bu karar bir kez, yükleme sırasında verildi ve bütün raporlar onu miras aldı.
Sorguların yapısındaki fark da öğretici. Star sorgusunda iş kuralı yok: iptal filtresi, tarih hesabı ve kategori hiyerarşisi yüklemede çözüldü. Sorgu yalnızca "fact'i filtrele, dimension'a göre grupla, ölçüyü topla" diyor. Rapor ve dashboard araçlarının beklediği yapı da tam olarak bu.
Slowly Changing Dimension: Type 1, 2 ve 3
Kitapçı 1 Temmuz 2026'da The Time Machine ve The War of the Worlds'ü bilim kurgu rafından klasikler rafına taşımaya karar veriyor. OLTP'de bu tek bir UPDATE; ertesi gün de The Time Machine için yeni bir sipariş geliyor:
UPDATE dbo.books SET category_id = 2 WHERE book_id IN (31, 32);
INSERT INTO dbo.orders (customer_id, ordered_at, status) VALUES (1, '2026-07-02 10:15:00', 'Paid');
INSERT INTO dbo.order_items (order_id, book_id, quantity, unit_price)
SELECT MAX(order_id), 31, 1, 310.00 FROM dbo.orders;
Değişiklikten önce, yılın ilk yarısında iki kategorinin cirosu şöyle:
SELECT b.category, SUM(f.sales_amount) AS revenue_2026_h1
FROM dbo.fact_sales AS f
JOIN dbo.dim_date AS d ON d.date_key = f.date_key
JOIN dbo.dim_book AS b ON b.book_key = f.book_key
WHERE d.year = 2026 AND d.month <= 6
  AND b.category IN (N'Classics', N'Science Fiction')
GROUP BY b.category;
category revenue_2026_h1
--------------- ---------------
Classics 31330.43
Science Fiction 22262.54
(2 rows affected)Dimension tarafında bu değişikliği nasıl yansıtacağın bir iş kararı ve bu kararların adı slowly changing dimension (SCD) tipleri. Type 1 en basiti: eski değerin üzerine yaz. Etkisini görmek için bir transaction içinde deneyip geri alıyorum:
BEGIN TRANSACTION;
    UPDATE dbo.dim_book SET category = N'Classics' WHERE book_id IN (31, 32);

    SELECT b.category, SUM(f.sales_amount) AS revenue_2026_h1
    FROM dbo.fact_sales AS f
    JOIN dbo.dim_date AS d ON d.date_key = f.date_key
    JOIN dbo.dim_book AS b ON b.book_key = f.book_key
    WHERE d.year = 2026 AND d.month <= 6
      AND b.category IN (N'Classics', N'Science Fiction')
    GROUP BY b.category;
ROLLBACK;
(2 rows affected)
category revenue_2026_h1
--------------- ---------------
Classics 33841.85
Science Fiction 19751.12
(2 rows affected)Ocak–Haziran raporu, rapor tarihi değişmediği hâlde değişti: 2.511,42 liralık satış bilim kurgudan klasiklere geçti. Ocak'ta bu kitaplar klasik değildi; Type 1 geçmişi bugünkü sınıflandırmayla yeniden yazar. Yazım hatası düzeltmesi gibi geçmişin de değişmesi gereken durumlar için doğru seçim bu. "Ocak'ta ne sattık?" sorusunun cevabının değişmemesi gerekiyorsa yanlış.
Type 2 geçmişi korur: mevcut satırı kapatır, yeni değerle yeni bir satır ekler. Her satırın geçerlilik aralığı ve bir "güncel mi?" işareti var:
DECLARE @change_date DATE = '2026-07-01';

UPDATE dbo.dim_book
SET valid_to = @change_date, is_current = 0
WHERE book_id IN (31, 32) AND is_current = 1;

INSERT INTO dbo.dim_book (book_id, isbn, title, first_author, category, parent_category,
                          valid_from, valid_to, is_current)
SELECT book_id, isbn, title, first_author, N'Classics', N'Fiction',
       @change_date, '9999-12-31', 1
FROM dbo.dim_book
WHERE book_id IN (31, 32) AND valid_to = @change_date;

SELECT book_key, book_id, title, category, valid_from, valid_to, is_current
FROM dbo.dim_book
WHERE book_id = 31
ORDER BY valid_from;
(2 rows affected)
(2 rows affected)
book_key book_id title category valid_from valid_to is_current
-------- ------- ---------------- --------------- ---------- ---------- ----------
31 31 The Time Machine Science Fiction 2025-01-01 2026-07-01 0
78 31 The Time Machine Classics 2026-07-01 9999-12-31 1
(2 rows affected)The Time Machine artık dimension'da iki satır: 31 numaralı key bilim kurgu dönemini, 78 numaralı key klasik dönemini temsil ediyor. Eski fact satırları 31'i göstermeye devam ediyor; yeni satışlar, yükleme sırasındaki tarih aralığı eşleşmesi sayesinde 78'e bağlanıyor. Temmuz satışını yükleyip iki dönemi birlikte raporlayalım:
INSERT INTO dbo.fact_sales (date_key, book_key, customer_key, order_id, quantity, sales_amount)
SELECT CONVERT(INT, CONVERT(CHAR(8), o.ordered_at, 112)), db.book_key, dc.customer_key,
       o.order_id, oi.quantity, oi.quantity * oi.unit_price
FROM dbo.orders AS o
JOIN dbo.order_items AS oi ON oi.order_id = o.order_id
JOIN dbo.dim_book AS db ON db.book_id = oi.book_id
     AND CAST(o.ordered_at AS DATE) >= db.valid_from AND CAST(o.ordered_at AS DATE) < db.valid_to
JOIN dbo.dim_customer AS dc ON dc.customer_id = o.customer_id
WHERE o.status <> 'Cancelled' AND o.ordered_at >= '2026-07-01';

SELECT IIF(d.month <= 6, 'H1', 'July') AS period, b.category, SUM(f.sales_amount) AS revenue
FROM dbo.fact_sales AS f
JOIN dbo.dim_date AS d ON d.date_key = f.date_key
JOIN dbo.dim_book AS b ON b.book_key = f.book_key
WHERE d.year = 2026 AND d.month <= 7
  AND b.category IN (N'Classics', N'Science Fiction')
GROUP BY IIF(d.month <= 6, 'H1', 'July'), b.category
ORDER BY period, b.category;
(1 rows affected)
period category revenue
------ --------------- --------
H1 Classics 31330.43
H1 Science Fiction 22262.54
July Classics 310.00
(3 rows affected)İlk yarının rakamları değişmedi; Temmuz satışı klasiklere yazıldı. Type 2'nin bir artısı daha var: istersen geçmişi bugünkü sınıflandırmayla da görebilirsin. Fact'in bağlandığı tarihsel satırdan aynı kitabın güncel satırına geçmek yeterli:
SELECT cur.category AS current_category, SUM(f.sales_amount) AS revenue_2026_h1
FROM dbo.fact_sales AS f
JOIN dbo.dim_date AS d ON d.date_key = f.date_key
JOIN dbo.dim_book AS hist ON hist.book_key = f.book_key
JOIN dbo.dim_book AS cur ON cur.book_id = hist.book_id AND cur.is_current = 1
WHERE d.year = 2026 AND d.month <= 6
  AND cur.category IN (N'Classics', N'Science Fiction')
GROUP BY cur.category;
current_category revenue_2026_h1
---------------- ---------------
Classics 33841.85
Science Fiction 19751.12
(2 rows affected)Bu, Type 1'in verdiği sonucun aynısı, ama geçmişi silmeden. Type 3 ise arada bir yol: önceki değeri ayrı bir kolonda tutar. Yalnızca bir önceki değeri hatırlar ve genellikle "yeniden yapılanmadan önceki ve sonraki hâliyle karşılaştır" gibi geçiş dönemi raporları için kullanılır:
ALTER TABLE dbo.dim_book ADD previous_category NVARCHAR(100) NULL;
GO
UPDATE dbo.dim_book
SET previous_category = N'Science Fiction'
WHERE book_id IN (31, 32) AND is_current = 1;

SELECT book_key, title, category, previous_category
FROM dbo.dim_book
WHERE book_id IN (31, 32) AND is_current = 1;
(2 rows affected)
book_key title category previous_category
-------- --------------------- -------- -----------------
78 The Time Machine Classics Science Fiction
79 The War of the Worlds Classics Science Fiction
(2 rows affected)Kimball Group'un tekniklerinde bunların ötesinde tipler de var: değişmeyen attribute (Type 0), sık değişen attribute'lar için mini-dimension (Type 4) ve bunların bileşimleri (Type 5, 6, 7). Pratikte çoğu dimension'da attribute bazında karar verilir: kitabın başlığındaki yazım hatası Type 1, kategorisi Type 2. Bu, serinin 7. yazısında gördüğümüz 6NF'in temporal veriye bakışıyla aynı soruyu soruyor: hangi attribute'un geçmişi önemli? OLTP tarafında geçerlilik tarihli kayıtların pratik tasarımı Çözüm Desenleri serisinin "Temporal Data" yazısında.
Columnstore'a Kısa Bir İşaret
Fact tabloları milyonlarca satıra büyür ve rapor sorguları satırların çoğunu ama kolonların azını okur. SQL Server'ın columnstore index'i bu erişim şekli için tasarlandı: veriyi satır satır değil, kolon kolon ve sıkıştırılmış row group'lar hâlinde tutar; sorgu yalnızca ihtiyaç duyduğu kolonları okur. Fact tablosu için tipik seçim clustered columnstore index:
CREATE CLUSTERED COLUMNSTORE INDEX CCI_fact_sales ON dbo.fact_sales;641 satırlık bir tabloda bunun etkisini ölçmek anlamsız; columnstore'un faydası milyonlarca satırda ve batch mode execution ile ortaya çıkar. Ayrıntısı için Microsoft Learn'deki columnstore index rehberi iyi bir başlangıç noktası. Bu yazı açısından önemli olan, dimensional model ile columnstore'un birbirini tamamlaması: geniş ve dar bir fact tablosu, az sayıda kolonu okuyan gruplama sorguları için idealdir.
Üretimde Dikkat
Ağır raporu OLTP veritabanına doğrudan yükleme. Ay sonu raporu, siparişleri yazan transaction'larla aynı tablolarda lock ve buffer pool için yarışır. En azından raporları bir read replica'ya yönlendir; düzenli raporlama ihtiyacı varsa ayrı bir dimensional model kur. Replica'nın ve ölçeklemenin altyapı tarafı System Design serisinin "Veri Katmanını Ölçeklemek: Replication, Sharding ve SQL mi NoSQL mi?" yazısında.
Yüklemeyi artımlı ve tekrar çalıştırılabilir yap. Fact yüklemesi bir tarih penceresiyle çalışmalı ve aynı pencere iki kez yüklenirse çift satır oluşmamalı; pencereyi silip yeniden yüklemek ya da kaynak key'e (order_id, book_id) göre eşleştirmek iki yaygın yol. Geç gelen değişiklikler (iade, iptal) için pencere son birkaç günü kapsamalı.
Bilinmeyen dimension üyesini planla. Fact satırı, dimension'da henüz olmayan bir kitaba ya da müşteriye işaret edebilir. Satırı atmak yerine bir "Unknown" dimension satırına bağlamak ve sonra düzeltmek, toplamların kaynakla tutarlı kalmasını sağlar.
Dimension'ları süreçler arasında paylaş. Satış ve stok hareketi fact'leri aynı dim_book'u ve aynı dim_date'i kullanırsa, iki süreç aynı raporda yan yana konabilir. Kimball terminolojisinde bunlara conformed dimension denir; her fact için ayrı bir kitap dimension'ı kurmak bu imkânı kaybettirir.
Sık Düşülen Tuzaklar
Grain'i karıştırıp çift saymak. Ödemeler sipariş seviyesinde, kalemler kalem seviyesinde. 1 numaralı siparişin iki kalemi ve iki ödemesi var; ikisini aynı sorguda birleştirmek ödemeleri kalem sayısı kadar çoğaltıyor:
SELECT 'items'               AS source, SUM(oi.quantity * oi.unit_price) AS amount
FROM dbo.order_items AS oi WHERE oi.order_id = 1
UNION ALL
SELECT 'payments', SUM(p.amount)
FROM dbo.payments AS p WHERE p.order_id = 1
UNION ALL
SELECT 'items x payments', SUM(p.amount)
FROM dbo.order_items AS oi
JOIN dbo.payments AS p ON p.order_id = oi.order_id
WHERE oi.order_id = 1;
source amount
---------------- -------
items 1042.70
payments 1042.70
items x payments 2085.40
(3 rows affected)Toplam ödeme iki katına çıktı. Farklı grain'deki olaylar ayrı fact tablolarında durmalı (fact_sales ve bir fact_payments) ve birlikte raporlanacaklarsa önce her biri kendi grain'inde ortak dimension'a göre toplanıp sonra birleştirilmeli.
Grain'i ilan etmeden kolon eklemek. "Fact'e kargo ücretini de koyalım" önerisi masum görünür; ama kargo ücreti siparişe aittir, kaleme değil. Kalem grain'indeki bir fact'e eklenirse her kalem satırında tekrar eder ve toplam şişer.
Her dimension'ı Type 2 yapmak. Geçmiş takibi bedava değil: dimension büyür, sorgular "hangi satır?" sorusunu cevaplamak zorunda kalır. Geçmişi kimse sormuyorsa Type 1 yeterli.
Dimension'ı OLTP tablosunun kopyası sanmak. dim_book, books'un aynısı değil; raporun dilinde, düzleştirilmiş, "bilinmiyor" değerleri adlandırılmış ve geçmişi taşıyan bir tablo. Onu birebir kopyalamak, OLTP'nin raporlama sorunlarını yeni bir veritabanına taşımaktır.
Küçük Bir Deneme
★☆☆ dim_date'e bir is_weekend kolonu ekle ve 2026'nın ilk yarısında hafta sonu ile hafta içi cirosunu karşılaştıran sorguyu yaz. Aynı sorguyu OLTP şemasında yazmak ne kadar farklı?
★★☆ Ödemeler için fact_payments tablosu tasarla: grain nedir, hangi dimension'lar gerekir, payments.method nereye gider? Ardından aylık "satış ve tahsilat" raporunu iki fact'i çift saymadan yaz.
★★★ Müşterinin şehri değiştiğinde dim_customer için hangi SCD tipini seçerdin? Type 2'yi uygula, bir müşterinin şehrini değiştir ve "şehir bazında ciro" raporunu hem satış anındaki hem güncel şehre göre çalıştır.
Aynı veriyi yazma için normalize, okuma için dimensional olarak iki farklı şekilde modelledik. Bir sonraki yazıda bir başka şekle bakıyoruz: aynı Bookstore requirement'larını document modelde düşünmek, sipariş ve kalemlerini tek bir document'te tutmak, ilişkisel veritabanında JSON (JavaScript Object Notation) kolonunun doğru yeri ve ilişkisel mi document mı kararını hangi sorularla vereceğin.