

1NF, 2NF ve 3NF: Sipariş Tablosunu Adım Adım Normalize Etmek
Normalizasyon tabloyu dependency'lere göre böler: 1NF listeleri satırlara açar, 2NF partial, 3NF transitive dependency'leri ayırır ve determinant yeni tablonun key'i olduğu için birleştirme kayıpsız olur. Sipariş Excel'ini SQL Server'da STRING_SPLIT ile 1NF'e, ardından 2NF ve 3NF'e taşıyor, her adımda EXCEPT ile kayıp ve sahte satır olmadığını kanıtlıyor, JSON kolonunun 1NF ile ilişkisini ve sonucu Bookstore şemasına eşlemeyi gösteriyoruz.
Sürüm notu: Bu yazıdaki SQL (Structured Query Language) örnekleri SQL Server 2025 (17.0, Cumulative Update 10) üzerinde çalıştırılmıştır.
Önce Tahmin Et: Bölünen Tablolar Aynı Veriyi Geri Verir mi?
Bir önceki yazıda sipariş Excel'inin dependency haritasını çıkardık. Bu yazıda tabloyu o haritaya göre adım adım böleceğiz ve sonunda beş satırlık düz tablo altı tabloya dönüşecek: customers, cities, orders, order_items, books ve book_authors. Serinin 3. yazısında bir ternary ilişkiyi iki tabloya bölüp geri birleştirdiğimizde sahte satırlar çıkmıştı. Tahmin et: Bu tabloları JOIN ile geri birleştirdiğimizde başlangıçtaki satırların aynısını mı, fazlasını mı, eksiğini mi alırız?
Cevap: aynısını. Her adımın sonunda bunu EXCEPT ile iki yönlü kontrol edeceğiz ve hem "kaybolan" hem "sahte" satır sayısı sıfır çıkacak. Bu bir şans değil; bölmeyi rastgele değil, dependency'lere göre yaptığımız için böyle. Yazının sonunda bunun nedenini tek bir kurala bağlayacağız.
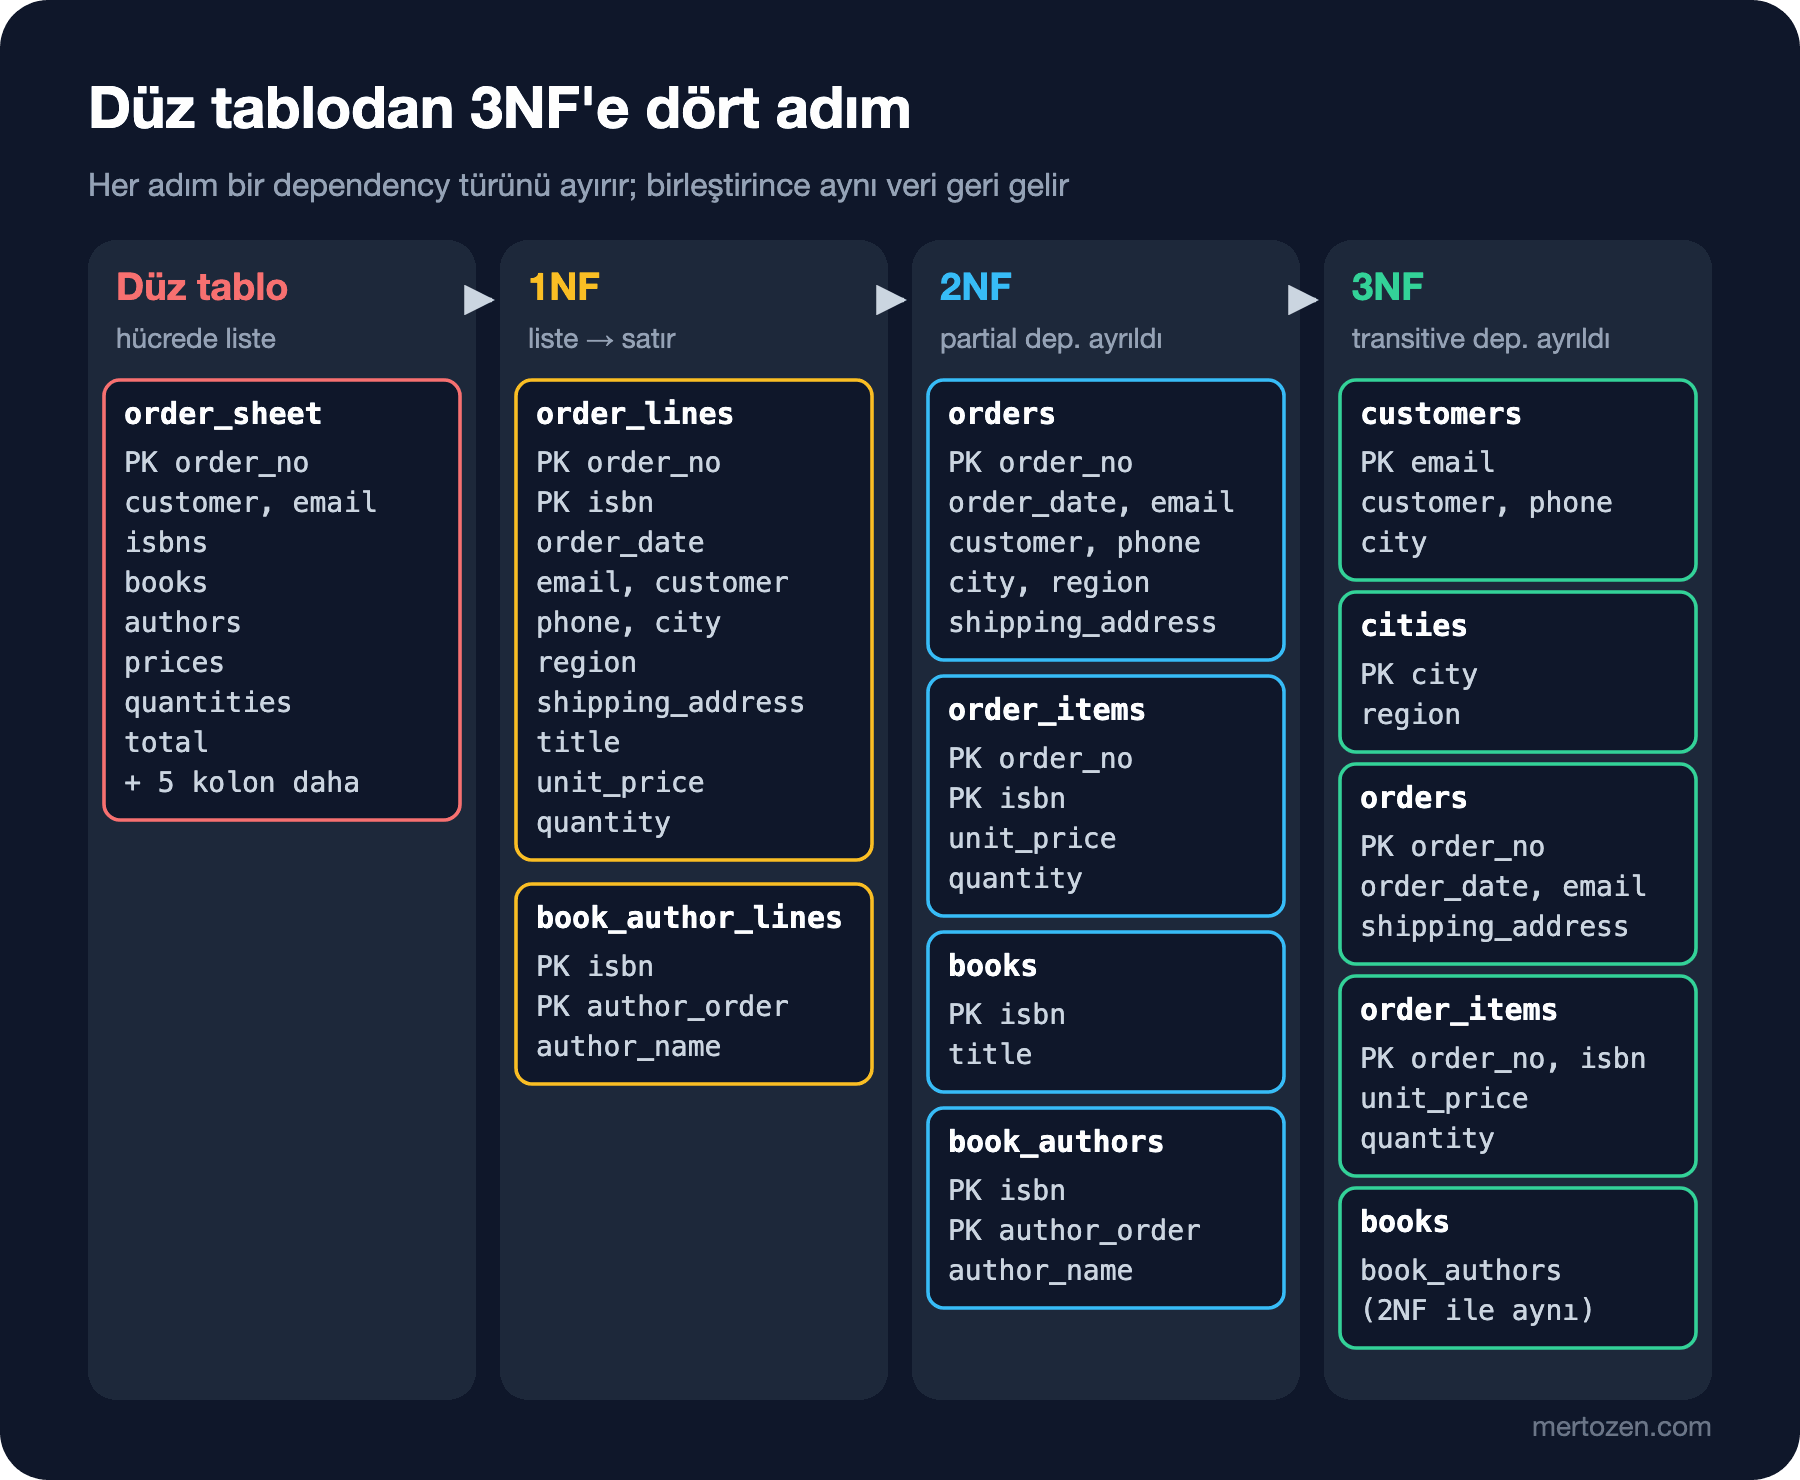
SQL denemelerinde her adımın tablosunu adımın sonekiyle adlandırdım (order_lines_1nf, orders_2nf, customers_3nf), böylece aynı veritabanında yan yana durabiliyorlar. Başlangıç noktası, bir önceki yazıdaki dbo.order_sheet tablosunun yeniden yüklenmiş, temiz hâli.
1NF: Atomik Değer ve Tekrarlayan Grup
1NF'in (First Normal Form) özü şu: bir satırın her kolonu tek bir değer taşır ve bir satır aynı türden değerleri tekrarlayan bir grup içermez. Excel'in isbns, books, prices ve quantities hücreleri tam olarak tekrarlayan grup: bir siparişteki her kitap için dört bilginin listesi, dört ayrı hücreye pozisyonla dağıtılmış. 1NF'e geçmek, her kitabı kendi satırına açmak demek. SQL Server 2022'den beri STRING_SPLIT üçüncü parametreyle her parçanın sırasını da döndürüyor; dört listeyi bu sırayla hizalayabiliriz:
SELECT s.order_no, s.order_date, s.customer, s.email, s.phone, s.city, s.region, s.shipping_address,
       i.ordinal                          AS line_no,
       TRIM(i.value)                      AS isbn,
       TRIM(b.value)                      AS title,
       CAST(TRIM(p.value) AS DECIMAL(10,2)) AS unit_price,
       CAST(TRIM(q.value) AS INT)           AS quantity
INTO dbo.order_lines_1nf
FROM dbo.order_sheet AS s
CROSS APPLY STRING_SPLIT(s.isbns, ',', 1) AS i
CROSS APPLY STRING_SPLIT(s.books, ',', 1) AS b
CROSS APPLY STRING_SPLIT(s.prices, ',', 1) AS p
CROSS APPLY STRING_SPLIT(s.quantities, ',', 1) AS q
WHERE b.ordinal = i.ordinal AND p.ordinal = i.ordinal AND q.ordinal = i.ordinal;

ALTER TABLE dbo.order_lines_1nf ALTER COLUMN isbn CHAR(13) NOT NULL;
ALTER TABLE dbo.order_lines_1nf
    ADD CONSTRAINT PK_order_lines_1nf PRIMARY KEY (order_no, isbn);

SELECT order_no, line_no, isbn, title, unit_price, quantity, customer
FROM dbo.order_lines_1nf
ORDER BY order_no, line_no;
(7 rows affected)
order_no line_no isbn title unit_price quantity customer
-------- ------- ------------- ------------------------- ---------- -------- ------------
1001 1 9798900000268 Dune 390.50 1 Ada Lovelace
1001 2 9798900000428 Good Omens 340.90 1 Ada Lovelace
1002 1 9798900000572 The Pragmatic Programmer 1150.00 1 Alan Turing
1003 1 9798900000305 The Left Hand of Darkness 660.00 1 Ada Lovelace
1003 2 9798900000268 Dune 351.45 2 Ada Lovelace
1004 1 9798900000411 A Wizard of Earthsea 200.50 3 Grace Hopper
1005 1 9798900000428 Good Omens 340.90 1 Alan Turing
(7 rows affected)Beş satır yedi satıra açıldı ve artık her satır "bir siparişteki bir kitap". Key (order_no, isbn), bir önceki yazıda closure ile bulduğumuz candidate key. Ama sorgunun ne kadar kırılgan olduğuna dikkat et: dört ayrı listenin aynı sırada yazıldığına güveniyor. Başlığında virgül olan bir kitap (Tinker, Tailor, Soldier, Spy gibi) books listesini bir eleman uzatır ve o siparişin bütün hizalaması kayar: fiyatlar yanlış kitaplara, adetler yanlış satırlara gider. Hücreye liste koymanın asıl maliyeti budur; veriyi okuyabilmek için verinin içinde olmayan bir kurala (sıraya ve ayırıcıya) güvenmek zorunda kalırsın.
Yazarlar iki seviyeli bir liste: kitaplar noktalı virgülle, aynı kitabın yazarları virgülle ayrılmış. Onları ayrı bir tabloya açıyoruz, çünkü yazar sipariş kalemiyle değil kitapla ilgili bir tekrarlayan grup:
SELECT DISTINCT
       TRIM(i.value)  AS isbn,
       TRIM(a.value)  AS author_name,
       a.ordinal      AS author_order
INTO dbo.book_author_lines_1nf
FROM dbo.order_sheet AS s
CROSS APPLY STRING_SPLIT(s.isbns, ',', 1) AS i
CROSS APPLY STRING_SPLIT(s.authors, ';', 1) AS g
CROSS APPLY STRING_SPLIT(g.value, ',', 1) AS a
WHERE g.ordinal = i.ordinal;

SELECT isbn, author_order, author_name
FROM dbo.book_author_lines_1nf
ORDER BY isbn, author_order;
(7 rows affected)
isbn author_order author_name
------------- ------------ -----------------
9798900000268 1 Frank Herbert
9798900000305 1 Ursula K. Le Guin
9798900000411 1 Ursula Le Guin
9798900000428 1 Terry Pratchett
9798900000428 2 Neil Gaiman
9798900000572 1 Andrew Hunt
9798900000572 2 David Thomas
(7 rows affected)DISTINCT, Dune ve Good Omens'ın iki farklı siparişte geçmesinden doğan tekrarları attı. Ama çıktıda bir şey daha var: "Ursula K. Le Guin" ve "Ursula Le Guin" iki ayrı yazar olarak duruyor. Normalizasyon aynı değerin kopyalarını birleştirir, aynı kişinin farklı yazımlarını birleştiremez. Bu bir veri kalitesi işi; yazarı kendi kimliğiyle (author_id) bir authors tablosuna taşıdığında ve import sırasında eşleştirme yaptığında çözülür. Normalize edilmiş model bu hatanın tekrar oluşmasını engeller; zaten oluşmuş olanı ise senin bulman gerekir.
1NF'in Modern Hâli: JSON ve ARRAY Kolonları
"Atomik değer" tanımı ilk bakışta net görünür ama sınırı tartışmalıdır. Bir tarih atomik mi, yoksa gün, ay ve yıldan oluşan bir yapı mı? Bir adres? Modern veritabanlarında bir kolon JSON (JavaScript Object Notation) document'i ya da PostgreSQL'de bir array (text[] gibi) tutabiliyor ve SQL Server 2025 native json tipini getirdi (SQL Temelleri serisinin "SQL Server 2025 ile T-SQL'e Gelenler" yazısı). Bu kolonlar 1NF'i bozar mı? Pratik cevap şu: bir değer, veritabanının içine bakması gereken bir sorgunun konusu olduğu anda o değer senin için atomik değildir. Sipariş kalemlerini JSON kolonunda tutan bir tablo deneyelim:
CREATE TABLE dbo.orders_json (
    order_no INT  NOT NULL PRIMARY KEY,
    items    JSON NOT NULL
);
INSERT INTO dbo.orders_json (order_no, items) VALUES
    (1001, '[{"isbn":"9798900000268","qty":1,"price":390.50},{"isbn":"9798900000428","qty":1,"price":340.90}]'),
    (1003, '[{"isbn":"9798900000305","qty":1,"price":660.00},{"isbn":"9798900000268","qty":2,"price":351.45}]'),
    (1006, '[{"isbn":"9790000000000","qty":1,"price":10.00}]');

SELECT o.order_no, i.qty, i.price
FROM dbo.orders_json AS o
CROSS APPLY OPENJSON(o.items)
     WITH (isbn CHAR(13) '$.isbn', qty INT '$.qty', price DECIMAL(10,2) '$.price') AS i
WHERE i.isbn = '9798900000268';
(3 rows affected)
order_no qty price
-------- --- ------
1001 1 390.50
1003 2 351.45
(2 rows affected)Sorgu çalışıyor; "Dune'u kim aldı?" sorusunun cevabı doğru. Ama her sorgu her siparişin JSON'unu açmak zorunda ve daha önemlisi, 1006 numaralı sipariş var olmayan bir ISBN'le (International Standard Book Number) sorunsuzca kaydedildi. JSON'un içindeki bir değere foreign key tanımlayamazsın, UNIQUE koyamazsın, CHECK ile adedin pozitif olduğunu garanti etmek de ayrı bir iş. Kalemler sorgulanan, kısıtlanan ve başka tablolara bağlanan bir şeyse ayrı bir tablodur.
Tersine, kitabın formatına özgü ve kimsenin üzerinde join ya da filtre yapmadığı bir metadata (e-kitabın dosya boyutu, sesli kitabın anlatıcı notları) bir JSON kolonunda gayet iyi durur; çünkü veritabanı o değeri bir bütün olarak saklıyor ve uygulamaya bir bütün olarak veriyor. Aynı veri bir gün rapor sorgusunun WHERE koşuluna girerse, o gün kolonun yerini yeniden düşünürsün. JSON kolonunun doğru yeri serinin 11. yazısında ayrıntısıyla ele alınacak.
2NF: Partial Dependency'yi Ayırmak
2NF (Second Normal Form), 1NF'te olan bir tabloda key olmayan hiçbir attribute'un composite key'in yalnızca bir parçasına bağlı olmamasını ister. order_lines_1nf'in key'i (order_no, isbn); ama sipariş tarihi, müşteri ve adres yalnızca order_no'ya, başlık yalnızca isbn'e bağlı. Her partial dependency kendi determinant'ıyla birlikte ayrı bir tabloya çıkıyor, tam key'e bağlı olanlar kalem tablosunda kalıyor:
SELECT DISTINCT order_no, order_date, email, customer, phone, city, region, shipping_address
INTO dbo.orders_2nf
FROM dbo.order_lines_1nf;

SELECT DISTINCT isbn, title
INTO dbo.books_2nf
FROM dbo.order_lines_1nf;

SELECT order_no, isbn, line_no, unit_price, quantity
INTO dbo.order_items_2nf
FROM dbo.order_lines_1nf;
(5 rows affected)
(5 rows affected)
(7 rows affected)Yedi kalem satırındaki sipariş bilgisi beş sipariş satırına, kitap bilgisi beş kitap satırına indi. Şimdi üç tabloyu birleştirip başlangıçtaki 1NF tablosuyla iki yönlü karşılaştıralım. missing 1NF'te olup birleştirmede olmayan, spurious birleştirmede olup 1NF'te olmayan satırları sayıyor:
WITH rejoined AS (
    SELECT o.order_no, o.order_date, o.customer, o.email, o.phone, o.city, o.region, o.shipping_address,
           oi.line_no, oi.isbn, b.title, oi.unit_price, oi.quantity
    FROM dbo.order_items_2nf AS oi
    JOIN dbo.orders_2nf AS o ON o.order_no = oi.order_no
    JOIN dbo.books_2nf AS b ON b.isbn = oi.isbn
)
SELECT 'missing' AS direction, COUNT(*) AS row_count
FROM (SELECT * FROM dbo.order_lines_1nf EXCEPT SELECT * FROM rejoined) AS m
UNION ALL
SELECT 'spurious', COUNT(*)
FROM (SELECT * FROM rejoined EXCEPT SELECT * FROM dbo.order_lines_1nf) AS s;
direction row_count
--------- ---------
missing 0
spurious 0
(2 rows affected)Kayıp yok, sahte satır yok. book_author_lines_1nf ise bu adımda değişmedi: key'i (isbn, author_order) ve tek key olmayan attribute'u olan author_name key'in tamamına bağlı, yani tablo zaten 2NF'te. Bir de şuna bakalım: orders_2nf artık tekrar içermiyor mu?
SELECT order_no, email, customer, phone, city, region
FROM dbo.orders_2nf
ORDER BY order_no;
order_no email customer phone city region
-------- ----------------- ------------ ---------------- -------- ----------------
1001 ada@example.com Ada Lovelace +90 532 000 0001 Istanbul Marmara
1002 alan@example.com Alan Turing +90 533 000 0002 Ankara Central Anatolia
1003 ada@example.com Ada Lovelace +90 532 000 0001 Istanbul Marmara
1004 grace@example.com Grace Hopper +90 535 000 0003 Izmir Aegean
1005 alan@example.com Alan Turing +90 533 000 0002 Ankara Central Anatolia
(5 rows affected)İçeriyor. Ada'nın telefonu, şehri ve bölgesi hâlâ iki satırda, Alan'ınki de. Bir önceki yazının başındaki telefon anomalisi 2NF'te de aynen yaşanabilir, çünkü kaynağı partial değil transitive dependency. Bütün candidate key'leri tek kolondan oluşan bir tablo partial dependency içeremez, çünkü bölünecek bir "parça" yok; dolayısıyla böyle bir tablo 1NF'teyse otomatik olarak 2NF'tedir. Ama bu, tekrar içermediği anlamına gelmez.
3NF: Transitive Dependency'yi Ayırmak
3NF (Third Normal Form), 2NF'te olan bir tabloda key olmayan hiçbir attribute'un key'e başka bir key olmayan attribute üzerinden bağlı olmamasını ister. orders_2nf'te iki zincir var: order_no → email → customer, phone, city ve email → city → region. Her zincirin ortasındaki determinant kendi tablosunun key'i oluyor:
SELECT DISTINCT email, customer, phone, city
INTO dbo.customers_3nf
FROM dbo.orders_2nf;

SELECT DISTINCT city, region
INTO dbo.cities_3nf
FROM dbo.orders_2nf;

SELECT order_no, order_date, email, shipping_address
INTO dbo.orders_3nf
FROM dbo.orders_2nf;
(3 rows affected)
(3 rows affected)
(5 rows affected)Şimdi beş tabloyu birden birleştirip yine 1NF tablosuyla karşılaştıralım. Aynı script, Excel'deki total kolonunu kalemlerden yeniden hesaplayıp karşılaştırıyor:
WITH rejoined AS (
    SELECT o.order_no, o.order_date, c.customer, c.email, c.phone, c.city, ci.region, o.shipping_address,
           oi.line_no, oi.isbn, b.title, oi.unit_price, oi.quantity
    FROM dbo.order_items_2nf AS oi
    JOIN dbo.orders_3nf AS o ON o.order_no = oi.order_no
    JOIN dbo.customers_3nf AS c ON c.email = o.email
    JOIN dbo.cities_3nf AS ci ON ci.city = c.city
    JOIN dbo.books_2nf AS b ON b.isbn = oi.isbn
)
SELECT 'missing' AS direction, COUNT(*) AS row_count
FROM (SELECT * FROM dbo.order_lines_1nf EXCEPT SELECT * FROM rejoined) AS m
UNION ALL
SELECT 'spurious', COUNT(*)
FROM (SELECT * FROM rejoined EXCEPT SELECT * FROM dbo.order_lines_1nf) AS s;

SELECT o.order_no, SUM(oi.quantity * oi.unit_price) AS computed_total, s.total AS sheet_total
FROM dbo.orders_3nf AS o
JOIN dbo.order_items_2nf AS oi ON oi.order_no = o.order_no
JOIN dbo.order_sheet AS s ON s.order_no = o.order_no
GROUP BY o.order_no, s.total
ORDER BY o.order_no;
direction row_count
--------- ---------
missing 0
spurious 0
(2 rows affected)
order_no computed_total sheet_total
-------- -------------- -----------
1001 731.40 731.40
1002 1150.00 1150.00
1003 1362.90 1362.90
1004 601.50 601.50
1005 340.90 340.90
(5 rows affected)Beş tablo, yedi satırı eksiksiz ve fazlasız geri verdi. Toplamlar da kalemlerden birebir hesaplanabiliyor; bu yüzden total hiçbir 3NF tablosuna taşınmadı. Saklanması gerekiyorsa bu bir denormalization kararıdır ve serinin 8. yazısının konusu. Artık Ada'nın telefonu tek bir satırda duruyor; bir önceki yazıdaki UPDATE yalnızca o satırı değiştirebilir ve iki farklı telefon oluşamaz. Grace'in siparişini silmek Grace'i silmez, çünkü Grace customers_3nf'te. Foundation, hiç sipariş edilmeden books_2nf'e eklenebilir. Üç anomaly'nin üçü de ortadan kalktı.
Bölme Neden Kayıpsız Oldu?
Her adımda bir tabloyu ikiye ayırdık ve iki parçanın ortak kolonu, parçalardan birinin key'iydi: orders_2nf ile order_items_2nf'in ortak kolonu order_no, orders_2nf'in key'i; customers_3nf ile orders_3nf'in ortak kolonu email, customers_3nf'in key'i. Bu koşul sağlandığında, bir satır birleştirmede karşısında en fazla bir eşleşme bulabilir; sahte satır üretecek çoklu eşleşme oluşamaz. 3. yazıdaki yayın hakkı örneğinde ise ortak kolon book_id'ydi ve iki parçanın hiçbirinde key değildi: Dune iki yayınevine ve iki ülkeye bağlıydı, birleştirme her yayınevini her ülkeyle eşleştirdi. Dependency'lere göre bölmenin pratik güvencesi bu: determinant'ı yeni tablonun key'i yaptığında birleştirme kayıpsız olur.
Sonuç Şema: Bookstore'a Eşleme
3NF tabloları, SQL Temelleri serisindeki Bookstore şemasının iskeletiyle örtüşüyor. Farklar, serinin önceki yazılarında verdiğimiz kararlardan geliyor:
| 3NF tablosu | Bookstore karşılığı | Fark ve nedeni |
|---|---|---|
customers_3nf | customers | Key email yerine surrogate customer_id, e-posta UNIQUE (4. yazı); ad first_name ve last_name olarak bölünmüş |
cities_3nf | yok | Bookstore bölge raporu istemediği için region tutulmuyor; şehir müşteride metin |
orders_3nf | orders | Surrogate order_id, müşteri customer_id ile; status eklendi (silme yerine iptal) |
order_items_2nf | order_items | book_id ile kitaba bağlı; UNIQUE (order_id, book_id) eski key'i koruyor |
books_2nf | books | Surrogate book_id, ISBN UNIQUE; list_price eklendi |
book_author_lines_1nf | authors ve book_authors | Yazar kendi kimliğiyle ayrı tabloda; ilişki (book_id, author_id) ve author_order |
cities satırı küçük ama öğretici bir karar. 3NF, city → region dependency'si varsa bölgenin ayrı bir tabloda durmasını söyler. Ama dependency'nin var olup olmadığına iş kuralı karar verir: kitapçı bölge raporu istemiyorsa region kolonuna da, cities tablosuna da gerek yok. Normalizasyon "bu veriyi tutuyorsan nerede tutmalısın?" sorusunu cevaplar; "bu veriyi tutmalı mısın?" sorusunu değil.
order_items.unit_price ile books.list_price'ın yan yana durması bir tekrar değil. İlk yazıdaki requirement'a göre sipariş anındaki fiyat değişmez; bu yüzden fiyat {order_no, isbn}'e bağlı ayrı bir olgu, katalog fiyatı ise yalnızca kitaba bağlı başka bir olgu. Normalizasyon ikisini de doğru yere koydu: biri kalem tablosunda, diğeri kitap tablosunda.
Üretimde Dikkat
Normalizasyonu bir kez yapılan bir dönüşüm olarak değil, bir doğrulama aracı olarak kullan. Yeni bir kolon eklerken "bu kolon neye bağlı?" sorusunu sormak, kolonu doğru tabloya koymanın en kısa yolu. Cevap tablonun key'i değilse, kolon yanlış yerde.
Gerçek bir taşıma işinde yukarıdaki EXCEPT kontrolünü script'in parçası yap. Eski düz tablodan yeni şemaya veri taşırken "kayıp ve sahte satır sıfır" kontrolü, migration'ın en ucuz testidir. Toplam ve sayım karşılaştırmaları da (sipariş başına toplam, müşteri başına sipariş sayısı) aynı script'e girer.
Join sayısının arttığını kabul et ama erken optimize etme. 3NF'teki bir sipariş detayı beş tabloyu birleştirmek demek; doğru index'lerle bu, OLTP (Online Transaction Processing) yükünde genellikle sorun değildir. Ölçmeden denormalize etmek, bu yazıda ortadan kaldırdığımız anomaly'leri geri çağırmaktır. Ne zaman ölçüp ne zaman denormalize edeceğin serinin 8. yazısında.
Veri temizliğini normalizasyondan ayrı planla. "Ursula Le Guin" örneğindeki gibi yazım farkları, tekrar eden müşteriler, farklı formattaki telefonlar şemaya taşınmadan önce eşleştirilmeli. Bu iş için staging tablosu, eşleştirme kuralları ve satır bazlı hata raporu Çözüm Desenleri serisinin "Toplu Import ve Validation Raporu" yazısında.
Sık Düşülen Tuzaklar
3NF'i "her şeyi ayrı tabloya böl" diye anlamak. 3NF yalnızca dependency'lere göre böler: determinant'ı key olmayan bir dependency varsa ayırır, yoksa ayırmaz. Müşterinin adını, soyadını ve e-postasını üç ayrı tabloya koymak normalizasyon değil, gereksiz join'dir; hepsi aynı key'e doğrudan bağlı.
Lookup tablosu çılgınlığı. Her metin kolonu için bir lookup tablosu açmak (her şehir, her renk, her durum için ayrı tablo) 3NF'in gerektirdiği bir şey değil. Bir lookup tablosu ancak değerin kendine ait attribute'ları varsa (şehrin bölgesi gibi) ya da değer kümesini veritabanında kısıtlamak istiyorsan anlamlıdır. Enum mu lookup tablosu mu kararı Çözüm Desenleri serisinin "Enum mı Lookup Tablosu mu?" yazısında.
Snapshot'ı tekrar sanıp ayırmak. unit_price'ı "kitabın fiyatı zaten books'ta var" diye kalem tablosundan silmek, geçmiş siparişlerin tutarını bugünkü katalog fiyatına bağlar. Aynı tuzak teslimat adresi için de geçerli.
Derived kolonu taşımak. total'ı orders tablosuna "nasılsa siparişin bilgisi" diye koymak, kalemlerle çelişebilecek bir kopya yaratır. Ya hiç saklama ya da bilinçli olarak sakla ve senkronizasyonunu tasarla.
Listeleri parse ederek normalize etmeye güvenmek. STRING_SPLIT bir kerelik dönüşüm için iyi bir araç; ama ayırıcıyı içeren tek bir değer bütün hizalamayı bozar. Dönüşümden sonra satır sayılarını ve toplamları mutlaka karşılaştır.
Küçük Bir Deneme
★☆☆ order_sheet'e başlığı virgül içeren bir kitapla yeni bir sipariş ekle (N'Tinker, Tailor, Soldier, Spy' gibi) ve 1NF sorgusunu yeniden çalıştır. Hangi satırlar yanlış çıkıyor? Sorgu bunu fark edebilir mi?
★★☆ book_author_lines_1nf'ten bir authors tablosu (author_id, full_name) ve bir book_authors tablosu (isbn, author_id, author_order) türet. Le Guin'in iki yazımını tek bir author_id'ye nasıl eşlersin? Eşledikten sonra kayıpsız birleştirme kontrolünü tekrarla.
★★★ Kitapçı "teslimat adresi siparişe değil müşteriye aittir, müşteri taşınınca eski siparişler de yeni adresi göstersin" diyor. Dependency'leri değiştir, 2NF ve 3NF adımlarını yeniden yap. Hangi tablo değişti? Bu kural bir muhasebe ya da kargo senaryosunda neden tehlikeli?
Bookstore'un iskeleti 3NF'te. Bir sonraki yazıda 3NF'in yetmediği durumlara bakıyoruz: her determinant'ın candidate key olmasını isteyen BCNF (Boyce-Codd Normal Form), bağımsız çok değerli olguları ayıran 4NF, join dependency ile 5NF ve bunların pratikte ne zaman gerçekten gerektiği.