

Window Function'lar 1: OVER, PARTITION BY, ROW_NUMBER, RANK ve Grup Başına Top-N

Window function, GROUP BY gibi hesap yapar ama row'ları çökertmez; sonucu her row'un yanına yazar. OVER ve PARTITION BY'ı, ROW_NUMBER, RANK, DENSE_RANK ve NTILE'ın eşitliklerdeki farkını, WHERE'de neden kullanılamadığını, CTE ile grup başına top-N'i, eşitlik kararını ve ROW_NUMBER ile güvenli duplicate silmeyi Bookstore verisinde gerçek çıktıyla gösteriyoruz.
Sürüm notu: Bu yazıdaki SQL (Structured Query Language) örnekleri SQL Server 2025 (17.0, CU10 (Cumulative Update 10)) üzerinde serinin Bookstore veritabanıyla çalıştırılmıştır.
Önce Tahmin Et
Programming kategorisindeki dokuz kitabı fiyata göre sıralayıp üç farklı function ile numaralandırıyoruz. Üç kitap 1150,00, iki kitap 950,00, iki kitap da 890,00 TL'ye (Türk lirası) satılıyor. Clean Code hangi numaraları alır?
SELECT title, list_price,
       ROW_NUMBER() OVER (ORDER BY list_price DESC) AS row_num,
       RANK()       OVER (ORDER BY list_price DESC) AS rnk,
       DENSE_RANK() OVER (ORDER BY list_price DESC) AS dense_rnk
FROM dbo.books
WHERE category_id = 11
ORDER BY list_price DESC, row_num;
Cevap:
title                                             list_price row_num rnk dense_rnk
------------------------------------------------- ---------- ------- --- ---------
Design Patterns                                      1450.00       1   1         1
Structure and Interpretation of Computer Programs    1250.00       2   2         2
Code Complete                                        1150.00       3   3         3
The Pragmatic Programmer                             1150.00       4   3         3
Refactoring                                          1150.00       5   3         3
The C Programming Language                            950.00       6   6         4
Domain-Driven Design                                  950.00       7   6         4
The Mythical Man-Month                                890.00       8   8         5
Clean Code                                            890.00       9   8         5
Aynı sıralama, üç farklı numara: ROW_NUMBER 9, RANK 8, DENSE_RANK 5. Üç function da aynı soruyu, "bu row sıralamada kaçıncı?" sorusunu cevaplıyor ama eşitliklere farklı davranıyor. Bir de dikkat et: aynı fiyatlı kitapların ROW_NUMBER değerleri arasındaki sıra (Code Complete 3, The Pragmatic Programmer 4) hiçbir şeye dayanmıyor; bir sonraki çalıştırmada yer değiştirebilirler. Bu yazı window function'ların ilk yarısı: OVER, PARTITION BY, sıralama function'ları ve en sık kullanım alanı olan grup başına top-N.
GROUP BY'dan Farkı: Row'lar Kaybolmaz
Serinin 10. yazısında GROUP BY'ın row'ları gruplara çökerttiğini gördük: dört Dystopian kitabı tek bir row olur ve kitapların adlarını kaybedersin. Window function ise aynı hesabı yapar ama sonucu her row'un yanına yazar. OVER clause'u, function'ın hangi row kümesine (window) bakacağını söyler:
SELECT b.category_id, b.title, b.list_price,
       COUNT(*)          OVER (PARTITION BY b.category_id) AS books_in_category,
       AVG(b.list_price) OVER (PARTITION BY b.category_id) AS category_avg
FROM dbo.books AS b
WHERE b.category_id IN (4, 12)
ORDER BY b.category_id, b.list_price DESC;
category_id title list_price books_in_category category_avg
----------- ------------------------------- ---------- ----------------- ------------
4 The Handmaid's Tale 580.50 4 490.800000
4 Nineteen Eighty-Four 530.90 4 490.800000
4 Fahrenheit 451 530.90 4 490.800000
4 Brave New World 320.90 4 490.800000
12 The Art of Computer Programming 1450.00 2 1300.000000
12 The Algorithm Design Manual 1150.00 2 1300.000000Her kitap row'unda hem kendi fiyatı hem kategorinin kitap sayısı hem de ortalaması var. PARTITION BY category_id, window'u kategoriye göre böler; COUNT ve AVG her row için yalnız kendi kategorisinin row'larına bakar. GROUP BY ile bunu yapmak için aggregate'i ayrı hesaplayıp geri join etmen gerekirdi.
En sık kullanım, bir row'un toplam içindeki payı. Science Fiction kitaplarının, kategorinin cirosu içindeki yüzdesi:
WITH book_revenue AS (
    SELECT b.category_id, b.title, SUM(oi.quantity * oi.unit_price) AS revenue
    FROM dbo.books AS b
    JOIN dbo.order_items AS oi ON oi.book_id = b.book_id
    JOIN dbo.orders AS o       ON o.order_id = oi.order_id
    WHERE o.status <> 'Cancelled' AND b.category_id = 3
    GROUP BY b.category_id, b.title
)
SELECT title, revenue,
       SUM(revenue) OVER ()                                                     AS category_total,
       CAST(100.0 * revenue / SUM(revenue) OVER () AS DECIMAL(5,2))             AS pct_of_category
FROM book_revenue
ORDER BY revenue DESC;
title revenue category_total pct_of_category
------------------------- -------- -------------- ---------------
Dune Messiah 12413.70 64066.20 19.38
Dune 12222.65 64066.20 19.08
Foundation 10243.95 64066.20 15.99
I, Robot 6903.00 64066.20 10.77
The Left Hand of Darkness 5874.00 64066.20 9.17
Neuromancer 5621.85 64066.20 8.78
The Time Machine 5617.65 64066.20 8.77
The War of the Worlds 3063.40 64066.20 4.78
Hyperion 2106.00 64066.20 3.29SUM(revenue) OVER () boş bir OVER ile bütün sonucu tek window sayar, yani her row'a genel toplamı yazar. Payı hesaplamak için ayrı bir sorguya ya da subquery'ye gerek kalmadı. Window function'lar standarda SQL:2003 ile girdi; SQL Server sıralama function'larını 2005'te, aggregate'lerde ORDER BY ve frame desteğini 2012'de getirdi, MySQL 8.0 ve SQLite 3.25 ile de destek geldi.
PARTITION BY ve ORDER BY
OVER içindeki iki parça farklı işler yapar. PARTITION BY row'ları bağımsız gruplara böler; window function her partition'da baştan başlar. ORDER BY ise partition içindeki sırayı belirler ve sıralama function'ları için zorunludur. İki kategoriyi aynı sorguda numaralandıralım:
SELECT category_id, title, list_price,
       ROW_NUMBER() OVER (PARTITION BY category_id ORDER BY list_price DESC, book_id) AS row_num,
       RANK()       OVER (PARTITION BY category_id ORDER BY list_price DESC)          AS rnk,
       DENSE_RANK() OVER (PARTITION BY category_id ORDER BY list_price DESC)          AS dense_rnk
FROM dbo.books
WHERE category_id IN (4, 12)
ORDER BY category_id, row_num;
category_id title list_price row_num rnk dense_rnk
----------- ------------------------------- ---------- ------- --- ---------
4 The Handmaid's Tale 580.50 1 1 1
4 Nineteen Eighty-Four 530.90 2 2 2
4 Fahrenheit 451 530.90 3 2 2
4 Brave New World 320.90 4 4 3
12 The Art of Computer Programming 1450.00 1 1 1
12 The Algorithm Design Manual 1150.00 2 2 2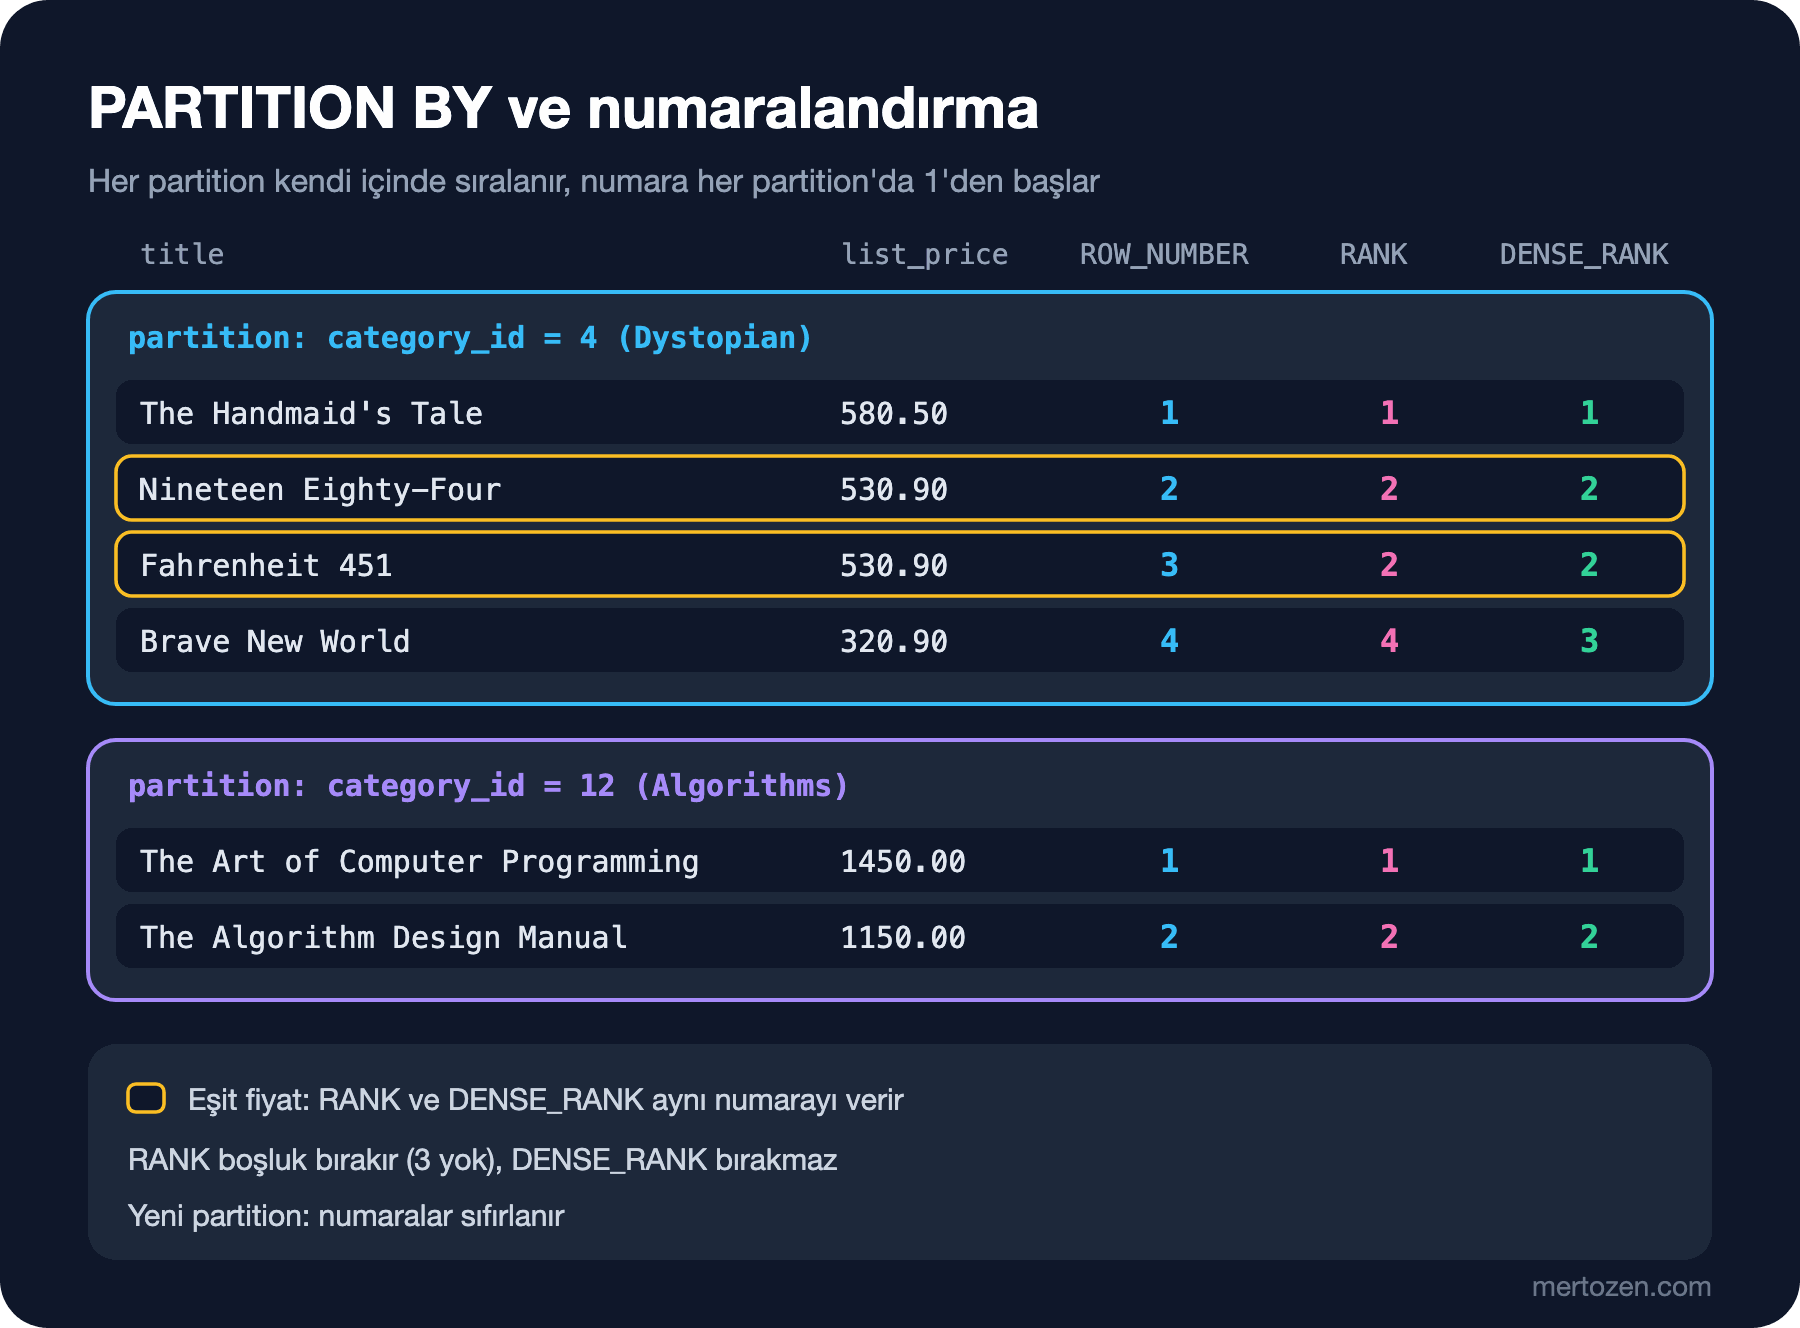
Dystopian'da numaralar 1'den 4'e gidiyor, Algorithms'e geçince yeniden 1'den başlıyor. ROW_NUMBER'ın ORDER BY'ına book_id'yi ikinci anahtar olarak ekledim; böylece aynı fiyatlı Nineteen Eighty-Four ile Fahrenheit 451 her çalıştırmada aynı numarayı alıyor. RANK ve DENSE_RANK için buna gerek yok, çünkü eşitlere zaten aynı numarayı veriyorlar.
OVER içindeki ORDER BY, sorgunun sonundaki ORDER BY'dan bağımsızdır. Birincisi window function'ın hesabı için sıradır; ikincisi sonucun sana hangi sırayla geleceği. Window'a göre sıralanmış bir sonuç istiyorsan dış ORDER BY'ı da yazmalısın.
ROW_NUMBER, RANK, DENSE_RANK ve NTILE
Açılıştaki sonucun kuralları şöyle:
| Function | Eşitlikte | Sonraki numara | Clean Code |
|---|---|---|---|
ROW_NUMBER | Her row'a farklı numara, eşitler arasındaki sıra belirsiz | Bir sonraki tam sayı | 9 |
RANK | Eşitlere aynı numara | Eşit sayısı kadar atlar (1, 2, 3, 3, 3, 6) | 8 |
DENSE_RANK | Eşitlere aynı numara | Atlamaz (1, 2, 3, 3, 3, 4) | 5 |
NTILE(n) | Eşitlere farklı kova düşebilir | Row'ları n kovaya olabildiğince eşit böler | - |
Hangisini seçeceğin iş kuralına bağlı. "Sayfalama için her row'a tek numara" ROW_NUMBER'dır. "Yarışmada ikinciler berabere kaldıysa sonraki üçüncü değil dördüncüdür" RANK'tir. "En pahalı üç fiyat seviyesindeki bütün kitaplar" DENSE_RANK'tir.
NTILE row'ları sıraya göre eşit büyüklükte kovalara dağıtır. Müşterileri harcamalarına göre dört çeyreğe bölmek, segmentasyon raporlarının klasik ilk adımı:
WITH spend AS (
    SELECT o.customer_id, SUM(oi.quantity * oi.unit_price) AS total
    FROM dbo.orders AS o
    JOIN dbo.order_items AS oi ON oi.order_id = o.order_id
    WHERE o.status <> 'Cancelled'
    GROUP BY o.customer_id
)
SELECT quartile, COUNT(*) AS customers, MIN(total) AS min_spend, MAX(total) AS max_spend
FROM (SELECT customer_id, total, NTILE(4) OVER (ORDER BY total DESC) AS quartile FROM spend) AS q
GROUP BY quartile
ORDER BY quartile;
quartile customers min_spend max_spend
-------- --------- --------- ---------
1 9 11769.61 38259.40
2 9 6319.11 10595.13
3 9 4494.40 6306.61
4 9 1179.00 4084.4036 müşteri dört kovaya 9'ar dağıldı. Row sayısı kova sayısına tam bölünmeseydi ilk kovalar birer fazla row alırdı. NTILE'ın değerlere değil row sayısına baktığını unutma: sınırdaki iki müşterinin harcaması eşit olsa bile farklı kovalara düşebilirler.
Window Function'ı WHERE'de Kullanamazsın
Her kategorinin en pahalı üç kitabını istiyorsun ve aklına ilk gelen şu:
SELECT title, list_price,
       ROW_NUMBER() OVER (PARTITION BY category_id ORDER BY list_price DESC) AS rn
FROM dbo.books
WHERE ROW_NUMBER() OVER (PARTITION BY category_id ORDER BY list_price DESC) <= 3;
Msg 4108, Level 15, State 1, Server b8be943222fa, Line 4
Windowed functions can only appear in the SELECT or ORDER BY clauses.Sebebi yine mantıksal sorgu işleme sırası. Window function'lar SELECT aşamasında, yani WHERE, GROUP BY ve HAVING bittikten sonra hesaplanır. WHERE çalışırken numaralar henüz yoktur. Aynı sebeple window function'ları bir aggregate'in sonucu üzerinde çalıştırabilirsin, çünkü gruplar SELECT'ten önce oluşmuştur:
SELECT b.category_id,
       SUM(oi.quantity) AS copies,
       RANK() OVER (ORDER BY SUM(oi.quantity) DESC) AS sales_rank
FROM dbo.books AS b
JOIN dbo.order_items AS oi ON oi.book_id = b.book_id
JOIN dbo.orders AS o       ON o.order_id = oi.order_id
WHERE o.status <> 'Cancelled' AND b.category_id IS NOT NULL
GROUP BY b.category_id
ORDER BY sales_rank;
category_id copies sales_rank
----------- ------ ----------
2 283 1
3 125 2
5 112 3
6 68 4
4 65 5
11 64 6
9 37 7
13 13 8
12 7 9RANK() OVER (ORDER BY SUM(oi.quantity) DESC) önce gruplamanın, sonra numaralandırmanın yapıldığını gösteriyor. Window function'ın sonucunu filtrelemenin yolu, onu bir CTE (Common Table Expression) ya da derived table içinde hesaplayıp dış sorguda filtrelemek; bir sonraki bölümde bunu yapacağız.
Bazı veritabanları (Snowflake, BigQuery, DuckDB gibi) bu iş için standart dışı bir QUALIFY clause'u sunar. SQL Server 2025'te yok:
SELECT title, list_price
FROM dbo.books
QUALIFY ROW_NUMBER() OVER (PARTITION BY category_id ORDER BY list_price DESC) = 1;
Msg 102, Level 15, State 1, Server b8be943222fa, Line 3
Incorrect syntax near 'ROW_NUMBER'.Grup Başına Top-N
"Her kategoride en çok satan üç kitap" window function'ların en çok yazılan sorgusu. Pattern her zaman aynı: önce satışları hesapla, sonra partition içinde numaralandır, sonra numaraya göre filtrele:
WITH sales AS (
    SELECT b.category_id, b.book_id, b.title, SUM(oi.quantity) AS copies
    FROM dbo.books AS b
    JOIN dbo.order_items AS oi ON oi.book_id = b.book_id
    JOIN dbo.orders AS o       ON o.order_id = oi.order_id
    WHERE o.status <> 'Cancelled'
    GROUP BY b.category_id, b.book_id, b.title
),
ranked AS (
    SELECT category_id, title, copies,
           ROW_NUMBER() OVER (PARTITION BY category_id ORDER BY copies DESC, book_id) AS rn
    FROM sales
)
SELECT category_id, rn, title, copies
FROM ranked
WHERE rn <= 3 AND category_id IN (2, 3, 11)
ORDER BY category_id, rn;
category_id rn title copies
----------- -- -------------------------- ------
2 1 Animal Farm 28
2 2 Pride and Prejudice 26
2 3 The Picture of Dorian Gray 22
3 1 Dune 32
3 2 Dune Messiah 24
3 3 Foundation 16
11 1 The Pragmatic Programmer 16
11 2 Clean Code 15
11 3 Design Patterns 12İki CTE ile adımları ayırdım: sales kitap başına satılan adedi hesaplıyor, ranked her kategoride numaralandırıyor, son SELECT ilk üçü alıyor. Raporu kısa tutmak için üç kategoriyle sınırladım.
Şimdi eşitlik sorusu. Fantasy kategorisinde iki kitap 20'şer adetle üçüncülüğü paylaşıyor:
WITH sales AS (
    SELECT b.category_id, b.book_id, b.title, SUM(oi.quantity) AS copies
    FROM dbo.books AS b
    JOIN dbo.order_items AS oi ON oi.book_id = b.book_id
    JOIN dbo.orders AS o       ON o.order_id = oi.order_id
    WHERE o.status <> 'Cancelled'
    GROUP BY b.category_id, b.book_id, b.title
),
ranked AS (
    SELECT category_id, title, copies,
           ROW_NUMBER() OVER (PARTITION BY category_id ORDER BY copies DESC, book_id) AS rn,
           RANK()       OVER (PARTITION BY category_id ORDER BY copies DESC)          AS rnk,
           DENSE_RANK() OVER (PARTITION BY category_id ORDER BY copies DESC)          AS drnk
    FROM sales
)
SELECT category_id, title, copies, rn, rnk, drnk
FROM ranked
WHERE category_id = 5
ORDER BY rn;
category_id title copies rn rnk drnk
----------- -------------------------- ------ -- --- ----
5 The Hobbit 28 1 1 1
5 The Fellowship of the Ring 23 2 2 2
5 Good Omens 20 3 3 3
5 American Gods 20 4 3 3
5 A Wizard of Earthsea 16 5 5 4
5 The Colour of Magic 5 6 6 5rn <= 3 filtresi American Gods'ı dışarıda bırakır, ve hangisinin dışarıda kalacağını ORDER BY'daki ikinci anahtar (book_id) belirler. rnk <= 3 ikisini de alır ve dört row döndürür. drnk <= 3 de ikisini alır; ama eşitlik daha üstte olsaydı DENSE_RANK "ilk üç satış seviyesi" diyerek dörtten fazla row döndürebilirdi. Ürün ekibine "ilk üç" derken hangisini kastettiğini sor; çoğu zaman cevap RANK olur ve bunu kimse önceden düşünmemiştir.
Aynı kalıbın en sık görülen özel hâli "grup başına son kayıt": her müşterinin son siparişi.
WITH numbered AS (
    SELECT o.customer_id, o.order_id, o.ordered_at, o.status,
           ROW_NUMBER() OVER (PARTITION BY o.customer_id ORDER BY o.ordered_at DESC, o.order_id DESC) AS rn
    FROM dbo.orders AS o
)
SELECT customer_id, order_id, ordered_at, status
FROM numbered
WHERE rn = 1 AND customer_id <= 5
ORDER BY customer_id;
customer_id order_id ordered_at status
----------- -------- ------------------- ---------
1 369 2026-06-10 21:27:57 Shipped
2 366 2026-06-06 09:39:30 Delivered
3 377 2026-06-20 16:58:05 Shipped
4 326 2026-03-16 10:31:45 Delivered
5 359 2026-05-15 12:00:31 DeliveredORDER BY o.ordered_at DESC, o.order_id DESC ile aynı saniyede verilmiş iki sipariş olsa bile sonuç belirli. Bunu serinin 11. yazısındaki correlated subquery ile (WHERE ordered_at = (SELECT MAX(...))) de yazabilirdin; ama o yöntem aynı zaman damgasına sahip iki siparişte iki row döndürür, ROW_NUMBER ise her zaman bir.
ROW_NUMBER ile Duplicate Silmek
Bir CSV (Comma-Separated Values) import'u sonrası customer_import tablosunda aynı e-postanın birden çok kaydı var. Biri büyük harfle yazılmış, ikisi birebir aynı. Her e-posta için en yeni kaydı tutup gerisini silmek istiyoruz. Önce kendi veritabanımda tabloyu hazırlıyorum:
DROP TABLE IF EXISTS dbo.customer_import;
CREATE TABLE dbo.customer_import (
    import_id   INT IDENTITY(1,1) PRIMARY KEY,
    email       VARCHAR(254) NOT NULL,
    first_name  NVARCHAR(100) NOT NULL,
    imported_at DATETIME2(0) NOT NULL
);
INSERT INTO dbo.customer_import (email, first_name, imported_at) VALUES
    ('ada.lovelace@example.com', N'Ada',   '2026-06-01 09:00'),
    ('Ada.Lovelace@example.com', N'Ada',   '2026-06-03 10:30'),
    ('grace.hopper@example.com', N'Grace', '2026-06-02 08:15'),
    ('linus@example.com',        N'Linus', '2026-06-01 12:00'),
    ('linus@example.com',        N'Linus', '2026-06-01 12:00'),
    ('linus@example.com',        N'Linus', '2026-06-05 18:45');
Silmeden önce, her zaman, neyin silineceğine bak:
SELECT import_id, email, imported_at,
       ROW_NUMBER() OVER (PARTITION BY LOWER(email) ORDER BY imported_at DESC, import_id DESC) AS rn
FROM dbo.customer_import
ORDER BY LOWER(email), rn;
import_id email imported_at rn
--------- ------------------------ ------------------- --
2 Ada.Lovelace@example.com 2026-06-03 10:30:00 1
1 ada.lovelace@example.com 2026-06-01 09:00:00 2
3 grace.hopper@example.com 2026-06-02 08:15:00 1
6 linus@example.com 2026-06-05 18:45:00 1
5 linus@example.com 2026-06-01 12:00:00 2
4 linus@example.com 2026-06-01 12:00:00 3PARTITION BY LOWER(email) büyük-küçük harf farkını yok sayarak grupluyor; rn = 1 her grubun en yeni kaydı. Önizleme doğru görünüyorsa aynı CTE üzerinden silebilirsin:
WITH numbered AS (
    SELECT import_id,
           ROW_NUMBER() OVER (PARTITION BY LOWER(email) ORDER BY imported_at DESC, import_id DESC) AS rn
    FROM dbo.customer_import
)
DELETE FROM numbered
WHERE rn > 1;
SELECT @@ROWCOUNT AS deleted;
SELECT import_id, email, imported_at FROM dbo.customer_import ORDER BY import_id;
deleted
-------
3
import_id email imported_at
--------- ------------------------ -------------------
2 Ada.Lovelace@example.com 2026-06-03 10:30:00
3 grace.hopper@example.com 2026-06-02 08:15:00
6 linus@example.com 2026-06-05 18:45:00SQL Server, tek bir tabloya dayanan CTE üzerinden DELETE yapmana izin verir ve silme alttaki tabloya uygulanır. ORDER BY'daki import_id DESC, birebir aynı iki Linus kaydı arasından hangisinin kalacağını belirliyor; onu yazmasaydın kalan row çalıştırmadan çalıştırmaya değişebilirdi. Production'da bu işlemi bir transaction içinde, önce SELECT ile sayıyı doğrulayarak yap; bunu 15. yazıda ayrıntılı göreceğiz.
Üretimde Dikkat
Sıralama function'larının bedeli çoğunlukla bir sort'tur. SET SHOWPLAN_TEXT ON ile basit bir ROW_NUMBER sorgusunun planı:
SET SHOWPLAN_TEXT ON;
GO
SELECT title, ROW_NUMBER() OVER (PARTITION BY category_id ORDER BY list_price DESC) AS rn
FROM dbo.books;
GO
SET SHOWPLAN_TEXT OFF;
|--Sequence Project(DEFINE:([Expr1002]=row_number))
|--Segment
|--Sort(ORDER BY:([sqlt_13].[dbo].[books].[category_id] ASC, [sqlt_13].[dbo].[books].[list_price] DESC))
|--Clustered Index Scan(OBJECT:([sqlt_13].[dbo].[books].[PK_books]))Okuması aşağıdan yukarı: tablo taranıyor, category_id ve list_price'a göre sıralanıyor, Segment operator'ü partition sınırlarını işaretliyor, Sequence Project da numaraları üretiyor. 77 row için sort önemsiz; milyonlarca row'da ise sort hem CPU (Central Processing Unit) hem bellek ister ve bellek yetmezse tempdb'ye taşar. Partition ve sıralama column'larıyla başlayan, seçilen column'ları da kapsayan bir index ((category_id, list_price DESC) INCLUDE (title)) sort'u ortadan kaldırabilir. Index tasarımı ve planın ayrıntıları SQL Server Derinlemesine serisinin konusu.
Sıralama function'larında ORDER BY zorunlu. Unutursan:
SELECT title, ROW_NUMBER() OVER (PARTITION BY category_id) AS rn
FROM dbo.books;
Msg 4112, Level 15, State 1, Server b8be943222fa, Line 1
The function 'ROW_NUMBER' must have an OVER clause with ORDER BY.Bu hatayı susturmak için internette ORDER BY (SELECT NULL) önerisini görürsün. Bu, "sıra umurumda değil" demektir; elde ettiğin numaralar fiziksel okuma sırasına bağlıdır ve sayfalama ya da duplicate silme gibi işlerde felakete yol açar. Gerçekten sıra umurunda değilse bile en azından primary key'i yaz.
Deterministik olmayan numaralandırma, testte görünmeyen bir hatadır. Küçük veride plan seri çalışır ve eşitler hep aynı sırada gelir; veri büyüyüp plan paralelleştiğinde sıra değişir. Kural: ROW_NUMBER'ın ORDER BY'ı her zaman benzersiz bir anahtarla bitmeli.
Sık Düşülen Tuzaklar
Window function'ı WHERE ya da HAVING'de kullanmaya çalışmak. Önce CTE ya da derived table içinde hesapla, dışarıda filtrele.
ROW_NUMBER'ın ORDER BY'ını benzersiz bir anahtarla bitirmemek. Eşitlerde numaralar çalıştırmadan çalıştırmaya değişir.
"İlk üç" isteğinde ROW_NUMBER, RANK ve DENSE_RANK farkını iş birimiyle konuşmamak.
OVER (ORDER BY ...)'ın sonucu sıralayacağını sanmak. Sonucun sırası için dış ORDER BY gerekir.
Duplicate silmeden önce önizleme yapmamak. Aynı CTE'yi önce SELECT ile çalıştır, sayıyı kontrol et, sonra DELETE'e çevir.
NTILE'ı değer aralığına göre bölme sanmak. Row sayısına göre böler; eşit değerler farklı kovalara düşebilir.
Küçük Bir Deneme
★☆☆ Her müşterinin siparişlerini tarihe göre numaralandır ve her müşterinin ilk siparişini (rn = 1) döndür. Sonra aynı sorguyu her müşterinin ikinci siparişini dönecek şekilde değiştir.
★★☆ Her ülkede toplam harcamaya göre ilk iki müşteriyi bul. Eşitlik varsa ikisini de göstermek için hangi function'ı kullandın? Her müşterinin ülke cirosu içindeki yüzdesini de ekle.
★★★ reviews tablosunda her kitap için en yüksek puanlı yorumu bul; aynı puanlı birden çok yorum varsa en yenisini seç. Sonra her kategoride "en çok yorum alan kitap" ile "en yüksek ortalama puanlı kitap" aynı mı, tek sorguda karşılaştır (ortalama için 10. yazıdaki tam sayı bölmesi tuzağına dikkat).
Bu yazıda window'u partition'a böldük ve partition içinde numara verdik. Bir sonraki yazıda window'u row row hareket ettiriyoruz: SUM() OVER (ORDER BY ...) ile kümülatif toplam, ROWS ile RANGE frame'leri arasındaki sinsi fark, LAG/LEAD ile önceki row'a bakmak ve gaps and islands problemi.