

SQL Nedir? İlişkisel Model, ANSI/ISO SQL Standardı ve T-SQL Lehçesi

SQL bir ürün değil, Codd'un ilişkisel modeline dayanan ve ISO/IEC 9075 ile tanımlanan declarative bir dil; SQL Server onun T-SQL lehçesini konuşur. Table, row, column ve key kavramlarını, döngü yerine set-based düşünmeyi logical read sayılarıyla, DDL/DML/DCL/TCL ailelerini ve FETCH FIRST'ün SQL Server, PostgreSQL ve MySQL'deki farklı davranışını gerçek çıktılarla gösteriyoruz.
Sürüm notu: Bu yazıdaki SQL (Structured Query Language) sorguları SQL Server 2025 (17.0, Cumulative Update 10) üzerinde, lehçe karşılaştırmaları PostgreSQL 18.6 ve MySQL 8.4 üzerinde çalıştırılmıştır.
Önce Tahmin Et: 77 Kitabın Kaçı Bu Alt Başlığa Sahip Değil?
Bookstore'un kataloğunda 77 kitap var. Bunlardan yalnız biri, Design Patterns, "Elements of Reusable Object-Oriented Software" alt başlığını taşıyor. Şimdi şu sorguyu çalıştırmadan önce bir sayı söyle: alt başlığı bu olmayan kaç kitap var?
SELECT COUNT(*) AS total_books,
       (SELECT COUNT(*) FROM dbo.books WHERE subtitle <> N'Elements of Reusable Object-Oriented Software') AS not_that_subtitle
FROM dbo.books;
C# ile düşünen biri hemen 76 der: 77 kitaptan biri eşit, kalan 76'sı eşit değil. Gerçek çıktı:
total_books  not_that_subtitle
-----------  -----------------
77           5

(1 rows affected)
Beş. Kitapların 71'inin alt başlığı yok; o column'da NULL duruyor ve NULL <> 'x' karşılaştırması ne doğru ne yanlış, "bilinmiyor" sonucunu veriyor. WHERE yalnız doğru olan row'ları geçirdiği için bu 71 kitap sessizce elendi. Üç değerli mantığı serinin 6. yazısında baştan sona açacağız. Bu yazının konusu daha temel bir şey: SQL'in seni C#'tan farklı düşünmeye zorladığı yerler, bu farkın arkasındaki ilişkisel model ve "SQL" dediğimiz dilin kimin elinde, hangi standartla ve hangi lehçelerle yaşadığı.
İlişkisel Model: Table, Row, Column ve Key
SQL bir veritabanı ürünü değil, bir dil. Arkasındaki fikir Edgar F. Codd'un IBM'de (International Business Machines) çalışırken 1970'te Communications of the ACM (Association for Computing Machinery) dergisinde yayımladığı "A Relational Model of Data for Large Shared Data Banks" makalesinden geliyor. Codd'un önerisi şuydu: veriyi pointer'larla birbirine bağlanmış kayıtlar olarak değil, matematikteki relation'lar, yani tuple kümeleri olarak modelle; sorgulamayı da bu kümeler üzerinde tanımlanmış işlemlerle yap. SQL'de relation'a table, tuple'a row, attribute'a column diyoruz.
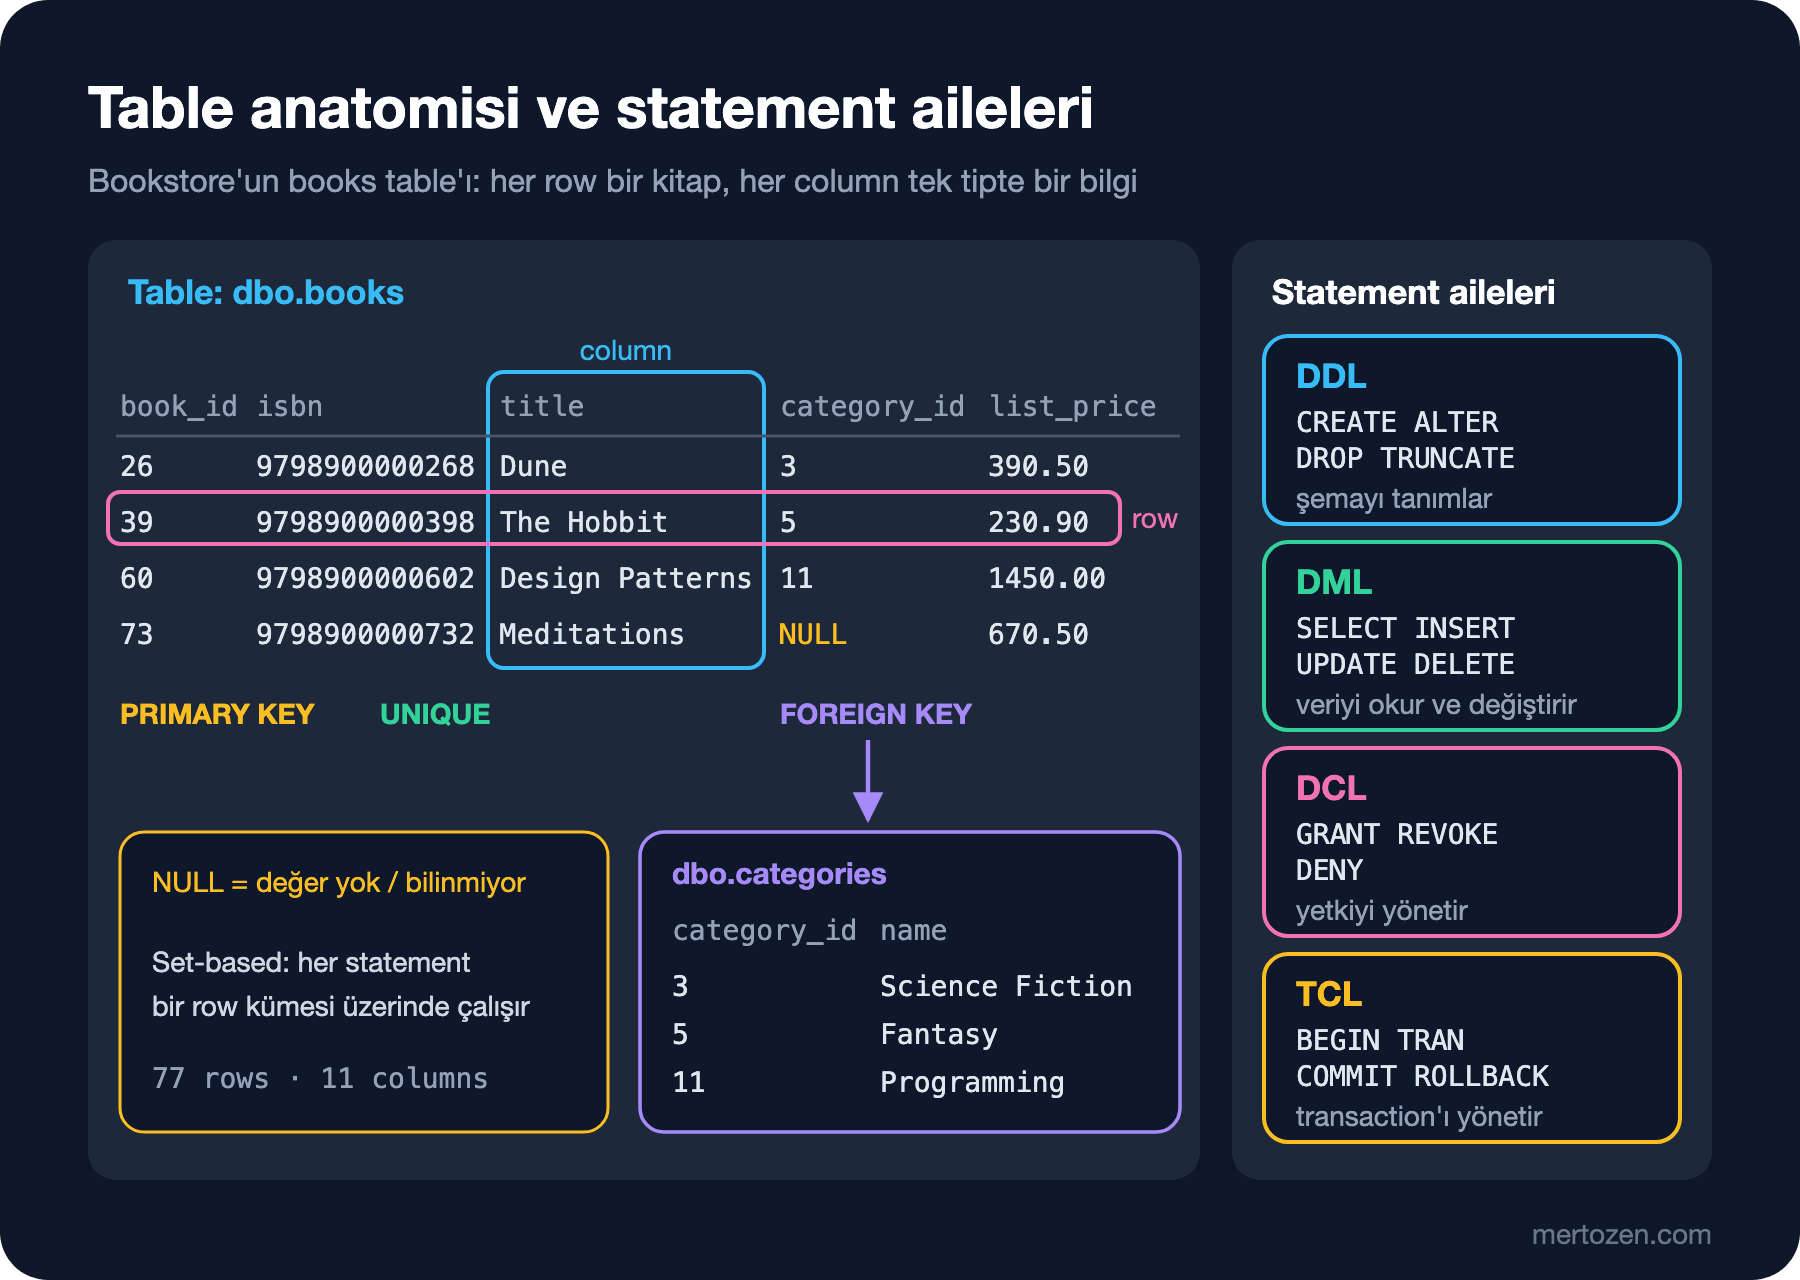
Bir table'ın yapısını görmenin en taşınabilir yolu, standardın tanımladığı INFORMATION_SCHEMA view'larıdır. Aynı sorgu SQL Server'da, PostgreSQL'de ve MySQL'de çalışır:
SELECT COLUMN_NAME, DATA_TYPE, CHARACTER_MAXIMUM_LENGTH, IS_NULLABLE
FROM INFORMATION_SCHEMA.COLUMNS
WHERE TABLE_SCHEMA = 'dbo' AND TABLE_NAME = 'books'
ORDER BY ORDINAL_POSITION;
COLUMN_NAME DATA_TYPE CHARACTER_MAXIMUM_LENGTH IS_NULLABLE
-------------- --------- ------------------------ -----------
book_id int NULL NO
isbn char 13 NO
title nvarchar 200 NO
subtitle nvarchar 200 YES
category_id int NULL YES
language_code char 2 NO
published_year smallint NULL YES
page_count smallint NULL YES
list_price decimal NULL NO
listed_on date NULL NO
is_active bit NULL NO
(11 rows affected)Buradan modelin üç kuralı okunuyor. Her column'un tek bir tipi var: list_price her row'da decimal, bir row'da metin, diğerinde sayı olamaz. Her column ya zorunlu (NOT NULL) ya da değersiz kalabilir. Ve her row'un kimliği bir key ile belirlenir:
SELECT tc.CONSTRAINT_NAME, tc.CONSTRAINT_TYPE, kcu.COLUMN_NAME
FROM INFORMATION_SCHEMA.TABLE_CONSTRAINTS AS tc
JOIN INFORMATION_SCHEMA.KEY_COLUMN_USAGE AS kcu
    ON kcu.CONSTRAINT_NAME = tc.CONSTRAINT_NAME
WHERE tc.TABLE_NAME = 'books'
ORDER BY tc.CONSTRAINT_TYPE, tc.CONSTRAINT_NAME;
CONSTRAINT_NAME CONSTRAINT_TYPE COLUMN_NAME
------------------- --------------- -----------
FK_books_categories FOREIGN KEY category_id
PK_books PRIMARY KEY book_id
UQ_books_isbn UNIQUE isbn
(3 rows affected)book_id primary key: her kitabı tek başına tanımlar. isbn de benzersiz; ilişkisel teoride buna candidate key denir, yani primary key olmaya aday ama seçilmemiş bir key. category_id ise foreign key: değeri categories table'ında var olan bir category_id olmak zorunda. Table'lar arasındaki ilişki pointer'la değil, değerle kurulur. Bu yüzden iki table'ı birleştirmek için navigation property'ye değil, join koşuluna ihtiyacın var; join'leri 8. ve 9. yazılarda işleyeceğiz.
Bir nüans: Codd'un relation'ı matematiksel bir küme olduğu için ne sırası ne de tekrar eden elemanı vardır. SQL bu konuda teoriden ayrılır. Key tanımlamadığın bir table'a aynı row'u iki kez ekleyebilirsin ve SQL table'ı aslında bir bag (tekrara izin veren çoklu küme) gibi davranır. Sıra konusunda ise SQL teoriye sadıktır: table'ın bir sırası yoktur. ORDER BY yazmadığın sürece sonucun hangi sırayla geleceği garanti değildir. Küçük bir table'da hep aynı sırayı görmen, o sıranın bir sözleşme olduğu anlamına gelmez; 5. yazıda bunun sayfalamayı nasıl bozduğunu göreceğiz.
Set-Based Düşünmek: Döngü Yerine Küme
C# geliştiricisinin refleksi döngüdür: her kategori için kitapları bul, say, ortalamayı hesapla, bir listeye ekle. SQL'de bunu da yazabilirsin. T-SQL (Transact-SQL) değişken, WHILE ve table variable sunuyor:
SET NOCOUNT ON;
DECLARE @result TABLE (category_id INT, book_count INT, avg_price DECIMAL(10,2));
DECLARE @id INT = (SELECT MIN(category_id) FROM dbo.categories);
SET STATISTICS IO ON;
WHILE @id IS NOT NULL
BEGIN
    /* her kategori için ayrı bir sorgu */
    INSERT INTO @result (category_id, book_count, avg_price)
    SELECT @id, COUNT(*), AVG(list_price)
    FROM dbo.books
    WHERE category_id = @id;

    SET @id = (SELECT MIN(category_id) FROM dbo.categories WHERE category_id > @id);
END;
SET STATISTICS IO OFF;
SELECT category_id, book_count, avg_price FROM @result WHERE book_count > 0 ORDER BY category_id;
Aynı soruyu küme olarak sormak tek bir statement:
SET STATISTICS IO ON;
SELECT category_id, COUNT(*) AS book_count, AVG(list_price) AS avg_price
FROM dbo.books
WHERE category_id IS NOT NULL
GROUP BY category_id
ORDER BY category_id;
SET STATISTICS IO OFF;
category_id book_count avg_price
----------- ---------- -----------
2 29 412.489655
3 9 551.533333
4 4 490.800000
5 6 350.466666
6 6 532.133333
9 5 432.380000
11 9 1092.222222
12 2 1300.000000
13 5 408.460000
(9 rows affected)
Table 'Worktable'. Scan count 0, logical reads 0, physical reads 0, ...
Table 'books'. Scan count 1, logical reads 3, physical reads 0, ...Sonuç aynı (döngü versiyonu ortalamayı DECIMAL(10,2)'ye yuvarladığı için yalnız ondalık hane sayısı farklı). Asıl fark SET STATISTICS IO çıktısında. Burada süre değil logical read sayısına bakıyoruz: sunucunun bellekten okuduğu 8 KB'lık sayfa sayısı, makineden makineye değişmeyen bir ölçü. Set-based sorgu books table'ını bir kez tarıyor ve 3 sayfa okuyor. Döngü ise 13 kategorinin her biri için şu üç satırı tekrar üretiyor (satırları kısalttım):
Table '#BF9633CF'. Scan count 0, logical reads 1, ...
Table 'books'. Scan count 1, logical reads 3, ...
Table 'categories'. Scan count 1, logical reads 2, ...
13 iterasyon × (3 + 2 + 1) = 78 logical read, set-based sorgu ise 3. Bookstore'un 77 kitabında bu fark mikrosaniye, ama oran sabit kalmıyor: kategori sayısı büyüdükçe döngü her seferinde table'ı yeniden tarıyor. Daha önemlisi, döngü "nasıl" yapılacağını sen dikte ettiğin için optimizer'ın elini bağlıyor. Set-based düşünmek, "her row için ne yapayım" yerine "hangi row kümesini istiyorum ve ona hangi işlemi uygulayayım" diye sormaktır. Bu serinin her yazısı bu refleksi kazandırmak için var.
Declarative Dil: "Ne"yi Yazarsın, "Nasıl"ı Optimizer Seçer
SQL declarative bir dildir. Yukarıdaki GROUP BY sorgusunda hangi index'in kullanılacağını, row'ların hash ile mi yoksa sıralayarak mı gruplanacağını, hangi table'ın önce okunacağını söylemedin. Yalnız sonucun ne olması gerektiğini tarif ettin. Bu kararları SQL Server'ın query optimizer'ı verir: istatistiklere bakar, birkaç alternatif plan değerlendirir ve en ucuz tahmin ettiğini seçer.
Bunun iki pratik sonucu var. Birincisi, aynı sonucu veren farklı yazımlar çoğu zaman aynı plana iner; IN ile subquery mi, join mi diye tartışırken önce plana bakmak gerekir. İkincisi, yazdığın sıra çalışma sırası değildir. SELECT cümlenin başında durur ama mantıksal olarak FROM ve WHERE'den sonra değerlendirilir. Mantıksal sorgu işleme sırasını 5. yazıda, execution plan okumayı ise ilerideki "SQL Server Derinlemesine" serisinde ayrıntılı göreceğiz.
Statement Aileleri: DDL, DML, DCL ve TCL
SQL statement'ları geleneksel olarak dört aileye ayrılır: DDL (Data Definition Language) şemayı tanımlar, DML (Data Manipulation Language) veriyi okur ve değiştirir, DCL (Data Control Language) yetkileri yönetir, TCL (Transaction Control Language) transaction sınırlarını çizer. Bazı kaynaklar SELECT'i ayrı bir aile olarak DQL (Data Query Language) diye anar. Standart bu etiketleri kullanmaz, kendi sınıflandırması daha ayrıntılıdır. Ama günlük dilde bu dört kelimeyi sürekli duyacaksın. Dördü bir arada:
SET NOCOUNT ON;
/* DDL: yeni bir table */
CREATE TABLE dbo.wishlist_items (
    customer_id INT NOT NULL REFERENCES dbo.customers (customer_id),
    book_id     INT NOT NULL REFERENCES dbo.books (book_id),
    added_at    DATETIME2(0) NOT NULL DEFAULT SYSUTCDATETIME(),
    PRIMARY KEY (customer_id, book_id)
);
/* DML: veri ekle ve oku */
INSERT INTO dbo.wishlist_items (customer_id, book_id) VALUES (1, 26), (1, 39);
SELECT customer_id, book_id FROM dbo.wishlist_items;
/* DCL: yalnız okuma yetkisi */
CREATE USER sqlt_report_reader WITHOUT LOGIN;
GRANT SELECT ON dbo.wishlist_items TO sqlt_report_reader;
/* TCL: sil, gör, geri al */
BEGIN TRANSACTION;
    DELETE FROM dbo.wishlist_items WHERE customer_id = 1;
    SELECT COUNT(*) AS rows_inside_tran FROM dbo.wishlist_items;
ROLLBACK TRANSACTION;
SELECT COUNT(*) AS rows_after_rollback FROM dbo.wishlist_items;
customer_id book_id
----------- -------
1 26
1 39
rows_inside_tran
-------------------
0
rows_after_rollback
-------------------
2Ada'nın istek listesine Dune ile The Hobbit'i ekledik, transaction içinde sildik ve ROLLBACK ile geri aldık. Transaction içindeki SELECT sıfır row gördü; ROLLBACK'ten sonra iki row geri geldi. Bu dört aile serinin iskeleti: DDL 3. ve 4. yazılarda, DML'in okuma tarafı 5. yazıdan itibaren, yazma tarafı 15. yazıda. DCL ve transaction'ların derin tarafı (isolation, lock) "SQL Server Derinlemesine" serisine ait.
Standardın Kısa Tarihi: SQL-86'dan SQL:2023'e
Codd'un makalesinden sonra IBM'de Donald D. Chamberlin ve Raymond F. Boyce, System R prototipi için SEQUEL (Structured English Query Language) adlı dili geliştirdi; isim bir ticari marka çakışması yüzünden SQL'e kısaldı. Dil yaygınlaşınca ANSI (American National Standards Institute) 1986'da, ISO (International Organization for Standardization) 1987'de standart olarak kabul etti. Bugün standardın adı ISO/IEC 9075; IEC (International Electrotechnical Commission) ISO ile ortak komiteyi temsil ediyor. Standart tek bir doküman değil, parçalardan oluşuyor: dilin çekirdeği Part 2 Foundation, metadata view'ları Part 11 Schemata, en yenisi de property graph sorguları için Part 16 PGQ (Property Graph Queries).
| Sürüm | Öne çıkan ekler |
|---|---|
| SQL-86 / SQL-89 | İlk standart; 89'da integrity constraint'ler |
| SQL-92 | Büyük revizyon; JOIN syntax'ı, CASE, Entry/Intermediate/Full seviyeleri |
| SQL:1999 | Recursive sorgular, trigger, boolean tipi |
| SQL:2003 | Window function'lar, MERGE, sequence ve identity column |
| SQL:2008 | FETCH FIRST, TRUNCATE, INSTEAD OF trigger |
| SQL:2011 | Temporal veri, window function geliştirmeleri |
| SQL:2016 | String içinde saklanan JSON (JavaScript Object Notation) üzerinde işlemler, row pattern recognition |
| SQL:2023 | Native JSON tipi, GREATEST/LEAST, UNIQUE NULLS [NOT] DISTINCT, Part 16 PGQ |
JSON satırlarında gördüğün gibi standart, ürünlerin zaten yaptığı şeyleri sonradan resmîleştirmeye de hizmet ediyor. SQL:2023'ün Foundation parçası Haziran 2023'te yayımlandı ve tek başına 1.715 sayfa. PostgreSQL geliştiricisi ve SQL standardı çalışmalarına katılan Peter Eisentraut'un yazısı yenilikleri feature kodlarıyla listeliyor: GREATEST/LEAST T054, UNIQUE NULLS DISTINCT F292 gibi.
Bu kodlar önemli, çünkü standardın en az bilinen gerçeği şu: özelliklerin büyük kısmı isteğe bağlı. Standart küçük bir zorunlu çekirdek (Core SQL) ve yüzlerce opsiyonel feature tanımlar. Bir ürün "SQL standardını destekliyorum" dediğinde, aslında "çekirdeğin büyük kısmını ve şu opsiyonel feature'ları" demek istiyor. Hatta bazı davranışları standart bilerek ürüne bırakır; örneğin SQL:2023'e kadar bir UNIQUE column'da birden fazla NULL olup olamayacağı implementation-defined idi ve SQL Server ile PostgreSQL bu konuda farklı davranır (4. yazı). Markus Winand'ın Modern SQL sitesi hangi feature'ın hangi üründe hangi sürümden beri çalıştığını izlemek için iyi bir kaynak.
Lehçeler: T-SQL, PostgreSQL ve MySQL
Her ürün standardın bir alt kümesini, kendi eklentileriyle birlikte uygular. Ortaya çıkan dile lehçe (dialect) diyoruz. SQL Server'ın lehçesi T-SQL'dir; Sybase ile ortak kökten gelir ve değişkenleri, IF/WHILE gibi kontrol akışını, TOP gibi kısayolları aynı dilin içinde sunar. PostgreSQL'de ise sorgu dili ile prosedürel dil ayrıdır: düz SQL'in yanında function ve procedure yazmak için PL/pgSQL (Procedural Language/PostgreSQL) kullanırsın. MySQL'in de kendi eklentileri var.
Farkı somut görmek için "en pahalı üç kitap" sorgusunu üç üründe çalıştıralım. Standart yazım SQL:2008'den beri FETCH FIRST:
SELECT title, list_price
FROM books
ORDER BY list_price DESC, book_id
FETCH FIRST 3 ROWS ONLY;
PostgreSQL 18.6 bunu olduğu gibi kabul ediyor:
                       title                       | list_price
---------------------------------------------------+------------
 Design Patterns                                   |    1450.00
 The Art of Computer Programming                   |    1450.00
 Structure and Interpretation of Computer Programs |    1250.00
(3 rows)
SQL Server 2025 aynı cümleyi reddediyor:
Msg 153, Level 15, State 2, Server b8be943222fa, Line 4
Invalid usage of the option FIRST in the FETCH statement.
T-SQL FETCH'i yalnız OFFSET ile birlikte kabul ediyor. Çalışan iki T-SQL yazımı:
/* standarda yakın: OFFSET zorunlu */
SELECT title, list_price
FROM dbo.books
ORDER BY list_price DESC, book_id
OFFSET 0 ROWS FETCH FIRST 3 ROWS ONLY;

/* T-SQL'e özgü kısayol */
SELECT TOP (3) title, list_price
FROM dbo.books
ORDER BY list_price DESC, book_id;
İkisi de aynı üç row'u döndürüyor. MySQL 8.4 ise FETCH FIRST'i hiç tanımıyor (ERROR 1064 (42000), syntax hatası) ve LIMIT 3 istiyor; PostgreSQL de LIMIT'i destekliyor, ama TOP'u bir function çağrısı sanıp function top(integer) does not exist hatası veriyor. Tek bir "ilk üç row" ihtiyacı için üç ürün, üç farklı davranış. Bu serinin kuralı bu yüzden şu: her konuda önce standardın ne dediğini, sonra T-SQL karşılığını, gerektiğinde de PostgreSQL ve MySQL farkını göstereceğiz. Lehçeleri yan yana koyduğumuz ayrı bir yazı (16. yazı) da var.
Üretimde Dikkat
Lehçenin yanında bir de sürüm boyutu var. SQL Server'da bir veritabanının davranışını sunucu sürümü kadar compatibility level da belirler:
SELECT name, compatibility_level, collation_name
FROM sys.databases
WHERE name = DB_NAME();
name compatibility_level collation_name
------- ------------------- ----------------------------
sqlt_01 170 SQL_Latin1_General_CP1_CI_AS
(1 rows affected)170, SQL Server 2025'in seviyesi. Eski bir sürümden restore edilmiş bir veritabanı yeni sunucuda eski seviyede kalabilir ve bazı yeni function'lar o seviyede çalışmaz. "Bende çalışıyor" ile "production'da çalışıyor" arasındaki farkın bir kısmı buradan gelir. Collation da aynı satırda duruyor; Türkçe "i" harfiyle başımıza açtığı işleri 3. yazıda göreceğiz.
İkinci nokta: ORM (Object-Relational Mapping) kullansan bile veritabanına giden şey SQL'dir. LINQ (Language Integrated Query) sorgularının nasıl SQL'e çevrildiğini Entity Framework Core (EF Core) serisinin "EF Core ile LINQ Sorguları: SQL Çevirisi, Client Evaluation ve IQueryable Tuzağı" yazısında gördük; o çeviriyi okuyup "bu sorgu neden 40.000 row çekiyor" diyebilmek SQL bilgisi ister. Dapper serisinde ise SQL'i zaten elle yazıyorsun. Üçüncü nokta, uygulamadan SQL gönderirken değerleri asla string birleştirerek koymamak; bu konu OWASP (Open Worldwide Application Security Project) serisinin "OWASP A05: Injection (1) — SQL Injection ve Command Injection" yazısında ve Dapper serisinin "Dapper ile Parameter'lar ve SQL Injection: Güvenli Sorgunun Kuralları" yazısında işlendi.
Sık Düşülen Tuzaklar
- "SQL" ile "SQL Server"ı aynı şey sanmak. SQL bir dil ve ISO standardı; SQL Server, PostgreSQL, MySQL, SQLite bu dili konuşan ürünler. "SQL biliyorum" demek, T-SQL'e özgü
TOP'un PostgreSQL'de çalışacağı anlamına gelmez. - ORM'in SQL bilgisini gereksiz kıldığını düşünmek. ORM, SQL yazmayı otomatikleştirir; ürettiği SQL'i değerlendirme sorumluluğunu senden almaz.
ORDER BYolmadan bir sıra beklemek. Table'ın sırası yoktur; bugün primary key sırasıyla gelen sonuç, yarın bir index eklendiğinde ya da plan değiştiğinde başka sırada gelebilir.NULL'ı bir değer sanmak. Açılıştaki sorgu 76 yerine 5 döndürdü;NULLile yapılan her karşılaştırma "bilinmiyor" sonucunu verir.- "Standart" etiketini taşınabilirlik garantisi sanmak. Standart feature'ların çoğu opsiyonel ve bazı davranışlar bilerek ürüne bırakılmış; taşımadan önce hedef üründe dene.
Küçük Bir Deneme
★☆☆ INFORMATION_SCHEMA.COLUMNS sorgusunu orders table'ı için çalıştır. Hangi column'lar NULL alabiliyor? shipped_at'in neden nullable olduğunu iş kuralı olarak bir cümleyle açıkla.
★★☆ Açılıştaki sorguyu, alt başlığı olmayan kitapları da "bu alt başlığa sahip değil" sayacak şekilde değiştir; 76 sonucunu al. İpucu: IS NULL ile OR.
★★★ Döngü örneğini kategori yerine yıl bazında yeniden yaz (published_year) ve SET STATISTICS IO ile toplam logical read sayısını set-based GROUP BY versiyonuyla karşılaştır. Kaç ayrı yıl var ve fark neden kategori örneğinden daha büyük?
Bu yazıdaki her sorguyu kendi makinende çalıştırmak için bir laboratuvara ihtiyacın var. Bir sonraki yazıda SQL Server 2025'i Docker'da ayağa kaldırıp Visual Studio Code'un mssql eklentisiyle bağlanacak ve seri boyunca kullanacağımız Bookstore veritabanını yükleyeceğiz.