

CTE, View ve Recursive Sorgular: WITH ile Okunabilir SQL ve Hiyerarşik Veri

CTE sorguyu isimli adımlarla yukarıdan aşağıya yazdırır ama SQL Server'da materialize edilmez; her referans yeniden çalışır. CTE zincirlerini, view'ı, SELECT * tuzağını, SCHEMABINDING ve WITH CHECK OPTION'ı, kategori ağacını gezen recursive CTE'yi, döngü korumasını ve MAXRECURSION'ı Bookstore verisinde gerçek çıktı ve logical read'lerle gösteriyoruz.
Sürüm notu: Bu yazıdaki SQL (Structured Query Language) örnekleri SQL Server 2025 (17.0, CU10 (Cumulative Update 10)) üzerinde serinin Bookstore veritabanıyla çalıştırılmıştır; PostgreSQL karşılaştırmaları PostgreSQL 18.6 ile denenmiştir.
Önce Tahmin Et
Aşağıdaki sorgu rastgele bir kitap seçen bir CTE (Common Table Expression) tanımlıyor ve sonra o CTE'yi kendisiyle CROSS JOIN ediyor. CTE tek bir row döndürüyor; iki referans da aynı "tablo"ya bakıyor. Sonuçtaki iki column aynı kitabı mı gösterir?
WITH pick AS (
    SELECT TOP (1) book_id, title
    FROM dbo.books
    ORDER BY NEWID()
)
SELECT a.title AS first_read, b.title AS second_read
FROM pick AS a
CROSS JOIN pick AS b;
Çoğu insan "evet" der: CTE bir kez hesaplanır, sonra iki kez okunur. Benim çalıştırmamda çıktı şuydu:
first_read         second_read
------------------ ------------------------
Great Expectations The Pragmatic Programmer
İki farklı kitap. Sorguyu tekrar çalıştırırsan büyük ihtimalle yine iki farklı kitap görürsün. Çünkü SQL Server'da CTE bir ara tablo değil, sorgunun içine yapıştırılan bir isimli ifade; her referans ayrı ayrı değerlendirilir ve NEWID() her seferinde başka bir kitap seçer. Bu yazı, CTE'nin ne olduğunu ve ne olmadığını, aynı fikrin kalıcı hâli olan view'ları ve CTE'nin asıl süper gücü olan recursive sorguları ele alıyor.
WITH ile Sorguyu Yukarıdan Aşağıya Yazmak
Bir önceki yazıda derived table'ları gördük. İşe yararlar ama iç içe geçtikçe sorgu içten dışa okunur. CTE aynı mantığı isim vererek, yukarıdan aşağıya yazmanı sağlar ve standarda SQL:1999 ile girdi. Teslim edilen siparişlerden, kendi ülkesinin ortalamasının iki katından fazla harcayan müşteriler:
WITH customer_spend AS (
    SELECT o.customer_id, SUM(oi.quantity * oi.unit_price) AS spend
    FROM dbo.orders AS o
    JOIN dbo.order_items AS oi ON oi.order_id = o.order_id
    WHERE o.status = 'Delivered'
    GROUP BY o.customer_id
),
country_avg AS (
    SELECT c.country_code, AVG(cs.spend) AS avg_spend
    FROM customer_spend AS cs
    JOIN dbo.customers AS c ON c.customer_id = cs.customer_id
    GROUP BY c.country_code
)
SELECT c.customer_id, c.first_name, c.last_name, c.country_code, cs.spend, ca.avg_spend
FROM customer_spend AS cs
JOIN dbo.customers AS c   ON c.customer_id = cs.customer_id
JOIN country_avg AS ca    ON ca.country_code = c.country_code
WHERE cs.spend > ca.avg_spend * 2
ORDER BY cs.spend DESC;
customer_id first_name last_name country_code spend avg_spend
----------- ---------- ---------- ------------ -------- ------------
3 Grace Hopper TR 36417.00 8537.969615
32 Ivan Sutherland TR 27110.19 8537.969615
30 Jean Bartik TR 26879.12 8537.969615
2 Alan Turing DE 25281.68 12558.385714
22 Joan Clarke TR 17150.36 8537.969615İlk CTE müşteri başına harcamayı hesaplıyor, ikincisi birinciyi kullanarak ülke ortalamasını, son SELECT de ikisini birleştiriyor. Her adımın bir adı var ve her adım ayrı ayrı test edilebilir: ortadaki CTE'nin sonucunu görmek için son SELECT'i SELECT * FROM country_avg yapman yeter. Birden çok CTE virgülle ayrılır, WITH yalnız bir kez yazılır ve sonraki CTE öncekilere referans verebilir, tersi olmaz.
T-SQL'de (Transact-SQL) bir syntax detayı var: WITH kelimesi başka anlamlarda da kullanıldığı için önceki statement noktalı virgülle bitmemişse hata alırsın. Bu yüzden bazı kod tabanlarında ;WITH görürsün; doğrusu her statement'ı noktalı virgülle bitirmek.
CTE Materialize Edilmez
Açılıştaki sürprizin sebebi şu: SQL Server CTE'yi optimizasyondan önce sorgunun içine açar, view gibi. CTE'ye iki kez referans verirsen, onu üreten sorgu iki kez çalışır. Bunu SET STATISTICS IO ON ile ölçebiliriz. Genel ortalamanın üzerinde harcayan müşteri sayısı, CTE'ye iki referansla:
SET STATISTICS IO ON;
WITH customer_spend AS (
    SELECT o.customer_id, SUM(oi.quantity * oi.unit_price) AS spend
    FROM dbo.orders AS o
    JOIN dbo.order_items AS oi ON oi.order_id = o.order_id
    WHERE o.status = 'Delivered'
    GROUP BY o.customer_id
)
SELECT COUNT(*) AS above_overall_avg
FROM customer_spend
WHERE spend > (SELECT AVG(spend) FROM customer_spend);
SET STATISTICS IO OFF;
above_overall_avg
-----------------
11
Table 'Worktable'. Scan count 0, logical reads 0, physical reads 0, page server reads 0, read-ahead reads 0, page server read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob page server reads 0, lob read-ahead reads 0, lob page server read-ahead reads 0.
Table 'Workfile'. Scan count 0, logical reads 0, physical reads 0, page server reads 0, read-ahead reads 0, page server read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob page server reads 0, lob read-ahead reads 0, lob page server read-ahead reads 0.
Table 'order_items'. Scan count 2, logical reads 10, physical reads 0, page server reads 0, read-ahead reads 0, page server read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob page server reads 0, lob read-ahead reads 0, lob page server read-ahead reads 0.
Table 'orders'. Scan count 2, logical reads 8, physical reads 0, page server reads 0, read-ahead reads 0, page server read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob page server reads 0, lob read-ahead reads 0, lob page server read-ahead reads 0.orders ve order_items ikişer kez tarandı (Scan count 2). Aynı ara sonucu bir temporary table'a bir kez yazıp iki kez okursak:
SET STATISTICS IO ON;
SELECT o.customer_id, SUM(oi.quantity * oi.unit_price) AS spend
INTO #customer_spend
FROM dbo.orders AS o
JOIN dbo.order_items AS oi ON oi.order_id = o.order_id
WHERE o.status = 'Delivered'
GROUP BY o.customer_id;
SELECT COUNT(*) AS above_overall_avg
FROM #customer_spend
WHERE spend > (SELECT AVG(spend) FROM #customer_spend);
SET STATISTICS IO OFF;
DROP TABLE #customer_spend;
Table 'Worktable'. Scan count 0, logical reads 0, physical reads 0, page server reads 0, read-ahead reads 0, page server read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob page server reads 0, lob read-ahead reads 0, lob page server read-ahead reads 0.
Table 'Workfile'. Scan count 0, logical reads 0, physical reads 0, page server reads 0, read-ahead reads 0, page server read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob page server reads 0, lob read-ahead reads 0, lob page server read-ahead reads 0.
Table 'order_items'. Scan count 1, logical reads 5, physical reads 0, page server reads 0, read-ahead reads 0, page server read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob page server reads 0, lob read-ahead reads 0, lob page server read-ahead reads 0.
Table 'orders'. Scan count 1, logical reads 4, physical reads 0, page server reads 0, read-ahead reads 0, page server read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob page server reads 0, lob read-ahead reads 0, lob page server read-ahead reads 0.
above_overall_avg
-----------------
11
Table '#customer_spend_____________________________________________________________________________________________________00000000000B'. Scan count 2, logical reads 2, physical reads 0, page server reads 0, read-ahead reads 0, page server read-ahead reads 0, lob logical reads 0, lob physical reads 0, lob page server reads 0, lob read-ahead reads 0, lob page server read-ahead reads 0.Bu kez kaynak tablolar birer kez tarandı; ara sonucu iki kez okumak ise geçici tabloda toplam 2 logical read tuttu. Bookstore'un boyutunda fark önemsiz; ama CTE'nin içinde milyonlarca row'u gezen bir aggregate varsa ve sonucu üç yerde kullanıyorsan, bedeli üç kez ödersin. Kural: CTE okunabilirlik aracıdır, cache değil. Ara sonucu gerçekten bir kez hesaplamak istiyorsan temporary table kullan.
PostgreSQL burada farklı davranır. PostgreSQL 12'den önce her CTE materialize edilirdi; 12'den beri yan etkisiz ve tek kez referans verilen CTE'ler sorguya açılıyor, birden çok referans verilenler materialize ediliyor. Ayrıca WITH x AS MATERIALIZED (...) ve NOT MATERIALIZED ile kararı sen verebiliyorsun. SQL Server'da böyle bir ipucu yok.
View: Kalıcı Bir Sorgu
CTE tek bir statement için yaşar. Aynı sorguyu birçok yerde kullanacaksan view olarak saklarsın. View, veritabanında adıyla duran bir SELECT'tir; veri tutmaz, her kullanıldığında açılıp sorguya katılır:
CREATE OR ALTER VIEW dbo.v_book_sales
AS
SELECT b.book_id,
       b.title,
       COUNT(DISTINCT oi.order_id)       AS orders,
       SUM(oi.quantity)                  AS copies,
       SUM(oi.quantity * oi.unit_price)  AS revenue
FROM dbo.books AS b
JOIN dbo.order_items AS oi ON oi.book_id = b.book_id
JOIN dbo.orders AS o       ON o.order_id = oi.order_id
WHERE o.status <> 'Cancelled'
GROUP BY b.book_id, b.title;
SELECT TOP (5) title, orders, copies, revenue
FROM dbo.v_book_sales
ORDER BY revenue DESC, book_id;title orders copies revenue
-------------------------- ------ ------ --------
The Pragmatic Programmer 13 16 17365.00
Design Patterns 9 12 16530.00
Nineteen Eighty-Four 26 30 15449.19
The Fellowship of the Ring 17 23 13680.00
Clean Code 13 15 12460.00View'ın iki faydası var. Birincisi soyutlama: "iptal edilmeyen siparişlerden kitap başına satış" tanımı tek yerde durur; kural değişirse (diyelim ki iade edilenler de çıkarılacak) tek yeri değiştirirsin. İkincisi yetki sınırı: bir raporlama kullanıcısına GRANT SELECT ON dbo.v_book_sales verip orders tablosuna hiç yetki vermeyebilirsin. View ile tablolar aynı owner'a aitse SQL Server ownership chaining sayesinde alttaki tablolar için ayrıca yetki kontrolü yapmaz.
View'ın içine ORDER BY yazamazsın (yalnız TOP ile birlikte izin verilir ve o durumda da dış sorgunun sırasını garanti etmez). Sıra, view'ı kullanan sorgunun işidir.
View'da SELECT * Tuzağı ve SCHEMABINDING
View oluşturulduğunda column listesi metadata'ya yazılır. SELECT * ile tanımlanan bir view, tablo değiştiğinde kendini güncellemez. Bunu kendi veritabanımda küçük bir promotions tablosuyla gösteriyorum:
DROP VIEW IF EXISTS dbo.v_promotions;
DROP TABLE IF EXISTS dbo.promotions;
CREATE TABLE dbo.promotions (
    promotion_id INT          NOT NULL PRIMARY KEY,
    code         VARCHAR(20)  NOT NULL,
    discount_pct DECIMAL(4,1) NOT NULL,
    ends_on      DATE         NOT NULL
);
INSERT INTO dbo.promotions VALUES (1, 'BACK2SCHOOL', 10.0, '2025-09-30'), (2, 'NEWYEAR', 15.0, '2026-01-31');
GO
CREATE VIEW dbo.v_promotions AS SELECT * FROM dbo.promotions;
GO
SELECT * FROM dbo.v_promotions;
promotion_id code discount_pct ends_on
------------ ----------- ------------ ----------
1 BACK2SCHOOL 10.0 2025-09-30
2 NEWYEAR 15.0 2026-01-31Şimdi tablodan ortadaki discount_pct column'unu silip sona yeni bir channel column'u ekliyorum ve view'a aynı sorguyu gönderiyorum:
ALTER TABLE dbo.promotions DROP COLUMN discount_pct;
ALTER TABLE dbo.promotions ADD channel VARCHAR(10) NOT NULL CONSTRAINT DF_promotions_channel DEFAULT ('web');
SELECT * FROM dbo.v_promotions;
promotion_id code discount_pct ends_on
------------ ----------- ------------ -------
1 BACK2SCHOOL 2025-09-30 web
2 NEWYEAR 2026-01-31 webHata yok. Ama discount_pct başlığının altında bitiş tarihleri, ends_on başlığının altında da kanal adları var. View eski column adlarını koruyor ve tablonun yeni column'larını sırayla bunlara diziyor. Bu sonucu okuyan bir uygulama, discount_pct'yi decimal olarak okumaya çalışırken patlar; daha kötüsü, tipler uyumluysa yanlış veriyi sessizce kullanır. sp_refreshview metadata'yı yeniler:
EXEC sp_refreshview 'dbo.v_promotions';
SELECT * FROM dbo.v_promotions;
promotion_id code ends_on channel
------------ ----------- ---------- -------
1 BACK2SCHOOL 2025-09-30 web
2 NEWYEAR 2026-01-31 webKalıcı çözüm, view'da column'ları açıkça yazmak ve gerektiğinde WITH SCHEMABINDING kullanmak. Schema-bound bir view, bağlı olduğu column'ların değiştirilmesini engeller:
DROP VIEW dbo.v_promotions;
GO
CREATE VIEW dbo.v_promotions
WITH SCHEMABINDING
AS
SELECT promotion_id, code, ends_on
FROM dbo.promotions;
GO
ALTER TABLE dbo.promotions DROP COLUMN ends_on;
Msg 5074, Level 16, State 1, Server b8be943222fa, Line 1
The object 'v_promotions' is dependent on column 'ends_on'.
Msg 4922, Level 16, State 9, Server b8be943222fa, Line 1
ALTER TABLE DROP COLUMN ends_on failed because one or more objects access this column.SCHEMABINDING için iki kural var: object'ler iki parçalı adla (dbo.promotions) yazılır ve SELECT * kullanılamaz. Karşılığında tablo değişikliği, view'ı bozacaksa daha deploy sırasında hata verir. Indexed view gibi ileri özellikler de schema-bound view ister; onlar SQL Server Derinlemesine serisinin konusu.
Updatable View ve WITH CHECK OPTION
Tek bir tabloya dayanan, aggregate ya da DISTINCT içermeyen bir view üzerinden INSERT, UPDATE ve DELETE yapılabilir; değişiklik alttaki tabloya gider. Türkiye'deki müşterileri gösteren bir view:
CREATE OR ALTER VIEW dbo.v_tr_customers
AS
SELECT customer_id, first_name, last_name, city, country_code
FROM dbo.customers
WHERE country_code = 'TR'
WITH CHECK OPTION;
GO
UPDATE dbo.v_tr_customers SET city = N'Konya' WHERE customer_id = 37;
SELECT @@ROWCOUNT AS updated;
updated
-------
1Bu view üzerinden bir müşterinin ülkesini değiştirirsem row view'ın dışına çıkar: güncelleme yapılır ama sonra o row'u view'da göremem. WITH CHECK OPTION bunu engeller; view'ın WHERE koşulunu bozan her değişiklik reddedilir:
UPDATE dbo.v_tr_customers SET country_code = 'DE' WHERE customer_id = 37;Msg 550, Level 16, State 1, Server b8be943222fa, Line 1
The attempted insert or update failed because the target view either specifies WITH CHECK OPTION or spans a view that specifies WITH CHECK OPTION and one or more rows resulting from the operation did not qualify under the CHECK OPTION constraint.
The statement has been terminated.Aggregate içeren bir view ise güncellenemez, çünkü revenue gibi bir column'un hangi row'a yazılacağı belli değildir:
UPDATE dbo.v_book_sales SET revenue = 0 WHERE book_id = 1;Msg 4406, Level 16, State 1, Server b8be943222fa, Line 1
Update or insert of view or function 'dbo.v_book_sales' failed because it contains a derived or constant field.Standart, hangi view'ların güncellenebilir olduğunu ayrıntılı kurallarla tanımlar ve lehçeler bu kuralların farklı alt kümelerini uygular. Pratikte ben updatable view'ları nadiren kullanıyorum; yazma işi tablo üzerinden, view'lar okuma ve yetki için.
Recursive CTE: Kategori Ağacı
CTE'nin derived table'ın yapamadığı bir işi var: kendine referans verebilir. Bookstore'daki categories tablosu kendi kendine bağlanan bir ağaç: her kategorinin parent_category_id'si bir başka kategoriyi gösteriyor. Ağacın derinliğini bilmeden bütün yolları (breadcrumb) üretmek için:
WITH category_tree AS (
    SELECT category_id, name, parent_category_id,
           0 AS depth,
           CAST(name AS NVARCHAR(400)) AS path
    FROM dbo.categories
    WHERE parent_category_id IS NULL
    UNION ALL
    SELECT c.category_id, c.name, c.parent_category_id,
           t.depth + 1,
           CAST(t.path + N' > ' + c.name AS NVARCHAR(400))
    FROM dbo.categories AS c
    JOIN category_tree AS t ON c.parent_category_id = t.category_id
)
SELECT category_id, depth, path
FROM category_tree
ORDER BY path;
category_id depth path
----------- ----- -------------------------------------
13 0 Children
1 0 Fiction
2 1 Fiction > Classics
5 1 Fiction > Fantasy
6 1 Fiction > Mystery
7 1 Fiction > Poetry
3 1 Fiction > Science Fiction
4 2 Fiction > Science Fiction > Dystopian
8 0 Non-Fiction
10 1 Non-Fiction > Computing
12 2 Non-Fiction > Computing > Algorithms
11 2 Non-Fiction > Computing > Programming
9 1 Non-Fiction > ScienceRecursive CTE iki parçadan oluşur ve UNION ALL ile bağlanır. Anchor member başlangıç row'larını üretir: kök kategoriler. Recursive member CTE'nin kendisine join yapar ve bir önceki adımda üretilen row'ların çocuklarını bulur. SQL Server bunu iterasyonla çalıştırır: her iterasyonda recursive member yalnız bir önceki iterasyonun row'larını görür, yeni row üretmediği anda durur.
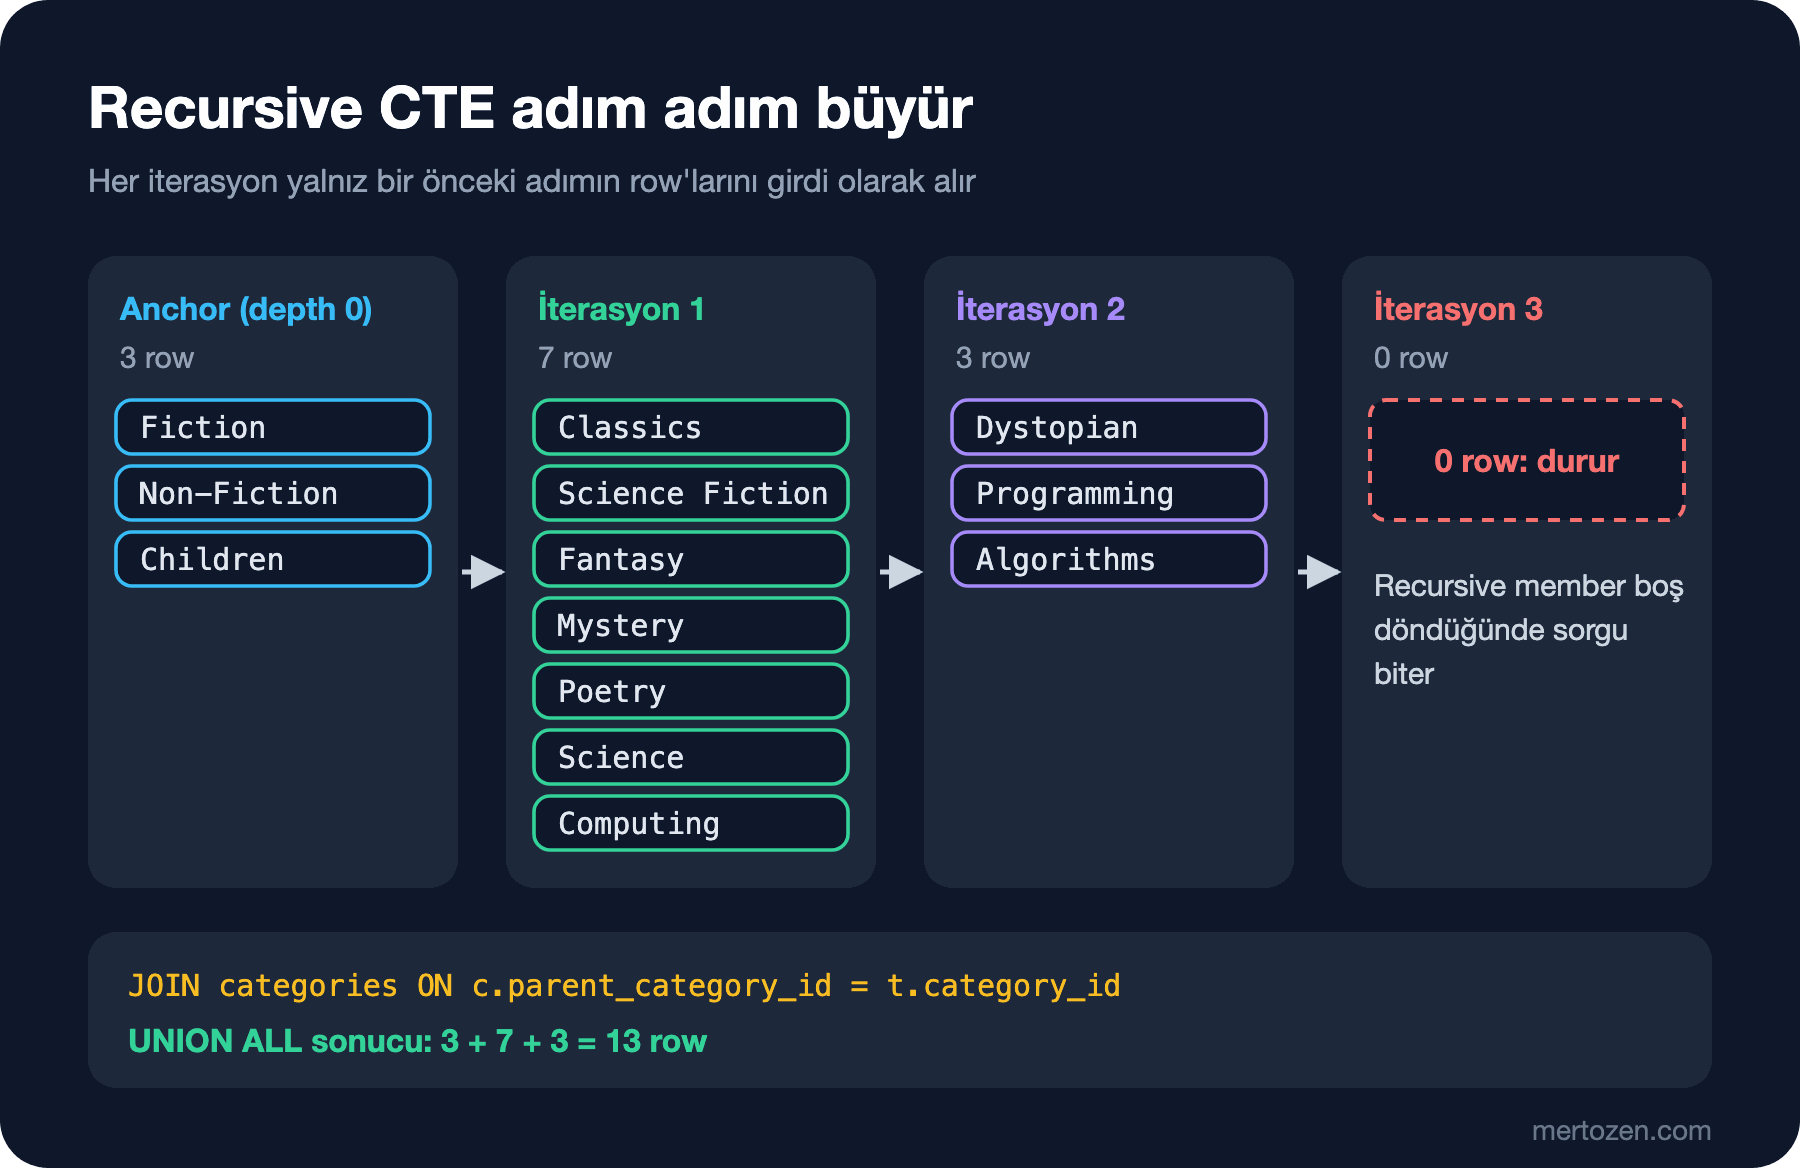
Bizim ağaçta anchor 3, ilk iterasyon 7, ikinci iterasyon 3 row üretti, üçüncü iterasyon boş döndü ve sorgu bitti: toplam 13 row. Standart bu sorgular için WITH RECURSIVE yazılmasını ister; PostgreSQL ve MySQL bu anahtar kelimeyi zorunlu tutar (PostgreSQL 18'de RECURSIVE olmadan "There is a WITH item named "n", but it cannot be referenced from this part of the query" hatası aldım). SQL Server ise tersine RECURSIVE kelimesini tanımaz:
WITH RECURSIVE n AS (
    SELECT 1 AS i
    UNION ALL
    SELECT i + 1 FROM n WHERE i < 3
)
SELECT i FROM n;
Msg 102, Level 15, State 1, Server b8be943222fa, Line 1
Incorrect syntax near 'n'.İki ince nokta daha var. Anchor ile recursive member'ın column tipleri birebir aynı olmalı. path'i CAST etmeden yazarsan:
WITH category_tree AS (
    SELECT category_id, name AS path
    FROM dbo.categories
    WHERE parent_category_id IS NULL
    UNION ALL
    SELECT c.category_id, t.path + N' > ' + c.name
    FROM dbo.categories AS c
    JOIN category_tree AS t ON c.parent_category_id = t.category_id
)
SELECT * FROM category_tree;
Msg 240, Level 16, State 1, Server b8be943222fa, Line 1
Types don't match between the anchor and the recursive part in column "path" of recursive query "category_tree".Anchor'daki name NVARCHAR(100), recursive member'daki birleştirme ise daha uzun bir NVARCHAR; SQL Server bunu kabul etmez. İkinci nokta, recursive member'ın kısıtları: SQL Server'da recursive member içinde GROUP BY, aggregate, TOP, DISTINCT ve outer join kullanılamaz. Aggregate'i recursive CTE'nin dışında, sonucun üzerinde yaparsın. Non-Fiction altındaki bütün kategorilerdeki kitap sayısı:
WITH subtree AS (
    SELECT category_id FROM dbo.categories WHERE category_id = 8
    UNION ALL
    SELECT c.category_id
    FROM dbo.categories AS c
    JOIN subtree AS s ON c.parent_category_id = s.category_id
)
SELECT COUNT(*) AS books_under_non_fiction
FROM dbo.books
WHERE category_id IN (SELECT category_id FROM subtree);
books_under_non_fiction
-----------------------
16Döngüler ve MAXRECURSION
Gerçek veride ağaç her zaman ağaç kalmaz. Yanlış bir güncelleme Fiction'ın parent'ını Dystopian yapsa (Dystopian zaten Fiction'ın torunu) bir döngü oluşur. Bunu categories'in kendi veritabanımdaki bir kopyasında deniyorum:
DROP TABLE IF EXISTS dbo.category_copy;
SELECT category_id, name, parent_category_id INTO dbo.category_copy FROM dbo.categories;
UPDATE dbo.category_copy SET parent_category_id = 4 WHERE category_id = 1;
WITH tree AS (
SELECT category_id, name, 0 AS depth
FROM dbo.category_copy
WHERE category_id = 1
UNION ALL
SELECT c.category_id, c.name, t.depth + 1
FROM dbo.category_copy AS c
JOIN tree AS t ON c.parent_category_id = t.category_id
)
SELECT COUNT(*) AS rows_produced FROM tree;Msg 530, Level 16, State 1, Server b8be943222fa, Line 1
The statement terminated. The maximum recursion 100 has been exhausted before statement completion.SQL Server'ın varsayılan recursion sınırı 100 iterasyon. Bu sınır olmasaydı sorgu sonsuza kadar dönerdi; sınır sayesinde hata alıp duruyor. Ama hata, "veride döngü var" demiyor, yalnız sınıra çarptığını söylüyor. Döngüyü tespit edip zarifçe durmak için ziyaret edilen düğümleri bir path'te taşıyorum:
WITH tree AS (
    SELECT category_id, name, 0 AS depth,
           CAST(CONCAT('/', category_id, '/') AS VARCHAR(400)) AS visited,
           0 AS is_cycle
    FROM dbo.category_copy
    WHERE category_id = 1
    UNION ALL
    SELECT c.category_id, c.name, t.depth + 1,
           CAST(CONCAT(t.visited, c.category_id, '/') AS VARCHAR(400)),
           CASE WHEN t.visited LIKE CONCAT('%/', c.category_id, '/%') THEN 1 ELSE 0 END
    FROM dbo.category_copy AS c
    JOIN tree AS t ON c.parent_category_id = t.category_id
    WHERE t.is_cycle = 0
)
SELECT category_id, name, depth, visited, is_cycle
FROM tree
ORDER BY depth, category_id;
category_id name depth visited is_cycle
----------- --------------- ----- --------- --------
1 Fiction 0 /1/ 0
2 Classics 1 /1/2/ 0
3 Science Fiction 1 /1/3/ 0
5 Fantasy 1 /1/5/ 0
6 Mystery 1 /1/6/ 0
7 Poetry 1 /1/7/ 0
4 Dystopian 2 /1/3/4/ 0
1 Fiction 3 /1/3/4/1/ 1Fiction ikinci kez görüldüğünde is_cycle 1 oluyor ve recursive member o row'dan devam etmiyor. Standart bunu CYCLE clause'u ile tek satırda yapar (sıralama için de SEARCH DEPTH FIRST / BREADTH FIRST vardır); SQL:2023 bu clause'un işaret değerlerini boolean'a sadeleştirdi. PostgreSQL 14'ten beri ikisini de destekliyor; aynı döngülü kopyada CYCLE category_id SET is_cycle USING visited yazdığımda PostgreSQL 18 aynı sekiz row'u döndürdü ve yalnız ikinci Fiction row'unu is_cycle true olarak işaretledi. SQL Server'da bu clause yok, path ile elle kontrol tek yol.
Recursive CTE'nin bir başka yaygın kullanımı sayı ya da tarih serisi üretmek. Aralık 2025'in günlerini üretip siparişi olmayan günleri de 0 ile görmek:
WITH days AS (
    SELECT CAST('2025-12-01' AS date) AS d
    UNION ALL
    SELECT DATEADD(day, 1, d) FROM days WHERE d < '2025-12-31'
)
SELECT d, COUNT(o.order_id) AS orders
FROM days
LEFT JOIN dbo.orders AS o
       ON o.ordered_at >= d AND o.ordered_at < DATEADD(day, 1, d)
WHERE d BETWEEN '2025-12-20' AND '2025-12-26'
GROUP BY d
ORDER BY d;
d orders
---------- ------
2025-12-20 0
2025-12-21 2
2025-12-22 4
2025-12-23 1
2025-12-24 2
2025-12-25 1
2025-12-26 1Anchor 1 Aralık'ı üretiyor, 30 iterasyon da kalan günleri. Bir yılın günlerini üretmeye kalkarsan sınıra takılırsın:
WITH n AS (
    SELECT 1 AS i
    UNION ALL
    SELECT i + 1 FROM n WHERE i < 365
)
SELECT COUNT(*) AS days_in_year FROM n;
Msg 530, Level 16, State 1, Server b8be943222fa, Line 1
The statement terminated. The maximum recursion 100 has been exhausted before statement completion.OPTION (MAXRECURSION n) sınırı değiştirir; en fazla 32767 olabilir, 0 ise sınırı tamamen kaldırır:
WITH n AS (
    SELECT 1 AS i
    UNION ALL
    SELECT i + 1 FROM n WHERE i < 365
)
SELECT COUNT(*) AS days_in_year FROM n
OPTION (MAXRECURSION 400);
days_in_year
------------
365MAXRECURSION 0'ı döngü kontrolün yoksa asla yazma. Seri üretmek için SQL Server 2022'den beri GENERATE_SERIES var ve daha hızlı; onu 17. yazıda göreceğiz.
Üretimde Dikkat
CTE'yi performans aracı sanma. Okunabilirliği artırır, ama SQL Server'da optimizer açısından bir derived table'dan farkı yoktur. Bir CTE'ye iki kez referans veriyorsan logical read'lere bak; tekrar eden pahalı bir hesap varsa temporary table'a al.
View'ları iç içe kurmak cazip gelir: v_book_sales'i kullanan bir v_category_sales, onu kullanan bir v_dashboard. Her katman tek başına mantıklıdır, ama optimizer sonunda hepsini tek bir dev sorguya açar ve kullanmadığın join'ler bile planda kalabilir. Üç katmandan derin view zincirleri production'da en sık gördüğüm "bu sorgu neden yavaş" sebeplerinden biri.
Recursive CTE ağacın derinliği kadar iterasyon yapar ve her iterasyonda bir join çalıştırır. parent_category_id üzerinde index yoksa her iterasyon tabloyu baştan tarar. Kategori ağacı gibi küçük ve sığ yapılarda sorun değil; organizasyon şemaları ya da yorum zincirleri gibi büyük hiyerarşilerde parent_id column'unu index'le ve derinliği sınırla.
Recursive CTE ile döngü korumasını üretimde her zaman yaz. Veri bugün ağaç olsa bile bir gün yanlış bir UPDATE onu grafa çevirir ve o gün hata mesajı "maximum recursion 100 has been exhausted" olur; kimse bunu "veride döngü var" diye okumaz.
Sık Düşülen Tuzaklar
CTE'nin bir kez hesaplanıp saklandığını sanmak. SQL Server'da her referans yeniden değerlendirilir; nondeterministic function'lar (NEWID(), SYSDATETIME()) her referansta farklı sonuç verebilir.
View'ı SELECT * ile tanımlamak. Tablo değişince view eski column adlarıyla yeni veriyi döndürür; column'ları açıkça yaz, gerekirse SCHEMABINDING ekle.
View'ın içine ORDER BY koyup sıranın korunacağını sanmak.
Recursive CTE'de anchor ile recursive member'ın tiplerini eşitlememek. CAST ile iki tarafı aynı tipe getir.
MAXRECURSION 0 ile hatayı susturmak. Döngü varsa sorgu bitmez; önce döngü kontrolü ekle.
WITH'ten önceki statement'ı noktalı virgülsüz bırakmak.
Küçük Bir Deneme
★☆☆ Bir önceki yazıdaki "2026'da sipariş vermemiş müşteriler" derived table sorgusunu CTE olarak yeniden yaz ve son SELECT'e müşterinin adını ekle.
★★☆ dbo.v_category_sales adında, her kategori için kitap sayısını ve iptal edilmemiş siparişlerden ciroyu döndüren bir view yaz. Column'ları açıkça listele ve WITH SCHEMABINDING ekle. Sonra books tablosundan view'ın kullandığı bir column'u silmeyi dene ve hatayı oku.
★★★ Recursive CTE ile her kategorinin kendisi ve bütün alt kategorilerindeki toplam kitap sayısını hesapla (Fiction için Classics, Science Fiction, Dystopian, Fantasy, Mystery ve Poetry'deki kitapların toplamı). İpucu: her kategoriden başlayıp aşağı inen bir CTE, (root_id, category_id) çiftleri üretsin; aggregate'i CTE'nin dışında yap.
Recursive CTE ve conditional aggregation ile birçok raporu yazabiliyoruz, ama "her kategoride en çok satan üç kitap" ya da "kümülatif toplam" gibi sorular hâlâ zor. Bir sonraki yazıda bu soruların doğal cevabı olan window function'lara başlıyoruz: OVER, PARTITION BY, ROW_NUMBER ve RANK.