

Scheduling: OS Hangi Thread'i Ne Zaman Çalıştırır? Context Switch, Priority ve Linux EEVDF
Scheduler, core'lardan fazla olan thread'leri kısa dilimlerle çalıştırır ve her geçişte bir context switch yapar; Linux bunu 6.6'dan beri EEVDF ile, nice ağırlıklarına göre adil paylaştırarak yapar. Context switch'leri /proc ile sayıyor, maliyetini ölçüyor, nice 10'un CPU'nun onda birini aldığını, Linux'ta Process.PriorityClass'ın yalnız ana thread'i etkilediğini ve --cpus=0.5 container'ında 31 periyodun 30'unda throttling olduğunu gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ile derlenip denenmiştir; testler xUnit v3 4.0.3 ile yazıldı. Ölçümler mcr.microsoft.com/dotnet/sdk:10.0 container'larında (Ubuntu 24.04, Linux 6.x kernel, cgroup v2), Docker'ın --cpuset-cpus ve --cpus limitleriyle alındı. Windows scheduling bilgileri Microsoft Learn dokümanlarına, Linux tarafı kernel dokümanlarına ve kaynak koduna dayanır.
Önce Tahmin Et
Sitedeki serilerin ortak örnek uygulaması Bookstore (bir online kitapçı) gece raporlarını API ile aynı makinede üretiyor. Ekip, raporun API'yi yavaşlatmaması için rapor process'ini nice -n 10 ile başlatıyor. İki process de CPU'yu sonuna kadar kullanıyor ve tek bir core'u paylaşıyor. Rapor CPU'nun yüzde kaçını alır: yarısını mı, üçte birini mi, onda birini mi? Peki aynı şeyi kodun içinden Process.PriorityClass = ProcessPriorityClass.BelowNormal ile yapsaydın, Linux'ta process'in bütün thread'leri yavaşlar mıydı?
Üçüncü soru: Bookstore'u --cpus=0.5 limitli bir container'da çalıştırıyorsun. Environment.ProcessorCount kaç döner ve iki thread'le 3 saniye boyunca CPU'yu kullanan bir iş, 3 saniyede kaç kez durdurulur? Hepsini bu yazıda ölçüyoruz.
Preemptive Scheduling, Time Slice ve Context Switch
Bir core aynı anda tek bir thread çalıştırır. Process'ler ve thread'ler core'lardan çok olduğunda hangisinin ne zaman çalışacağına scheduler karar verir. Eski sistemlerin bir kısmı cooperative'di: bir program CPU'yu ancak kendisi bıraktığında başkasına sıra geliyordu ve sonsuz döngüye giren bir program bütün makineyi kilitliyordu. Linux, Windows ve macOS preemptive'dir: kernel bir timer interrupt'ıyla kontrolü belirli aralıklarla geri alır ve gerekirse çalışan thread'i durdurup başkasını koyar. Bir thread'e bir seferde verilen süreye time slice (Windows dokümanında quantum) denir.
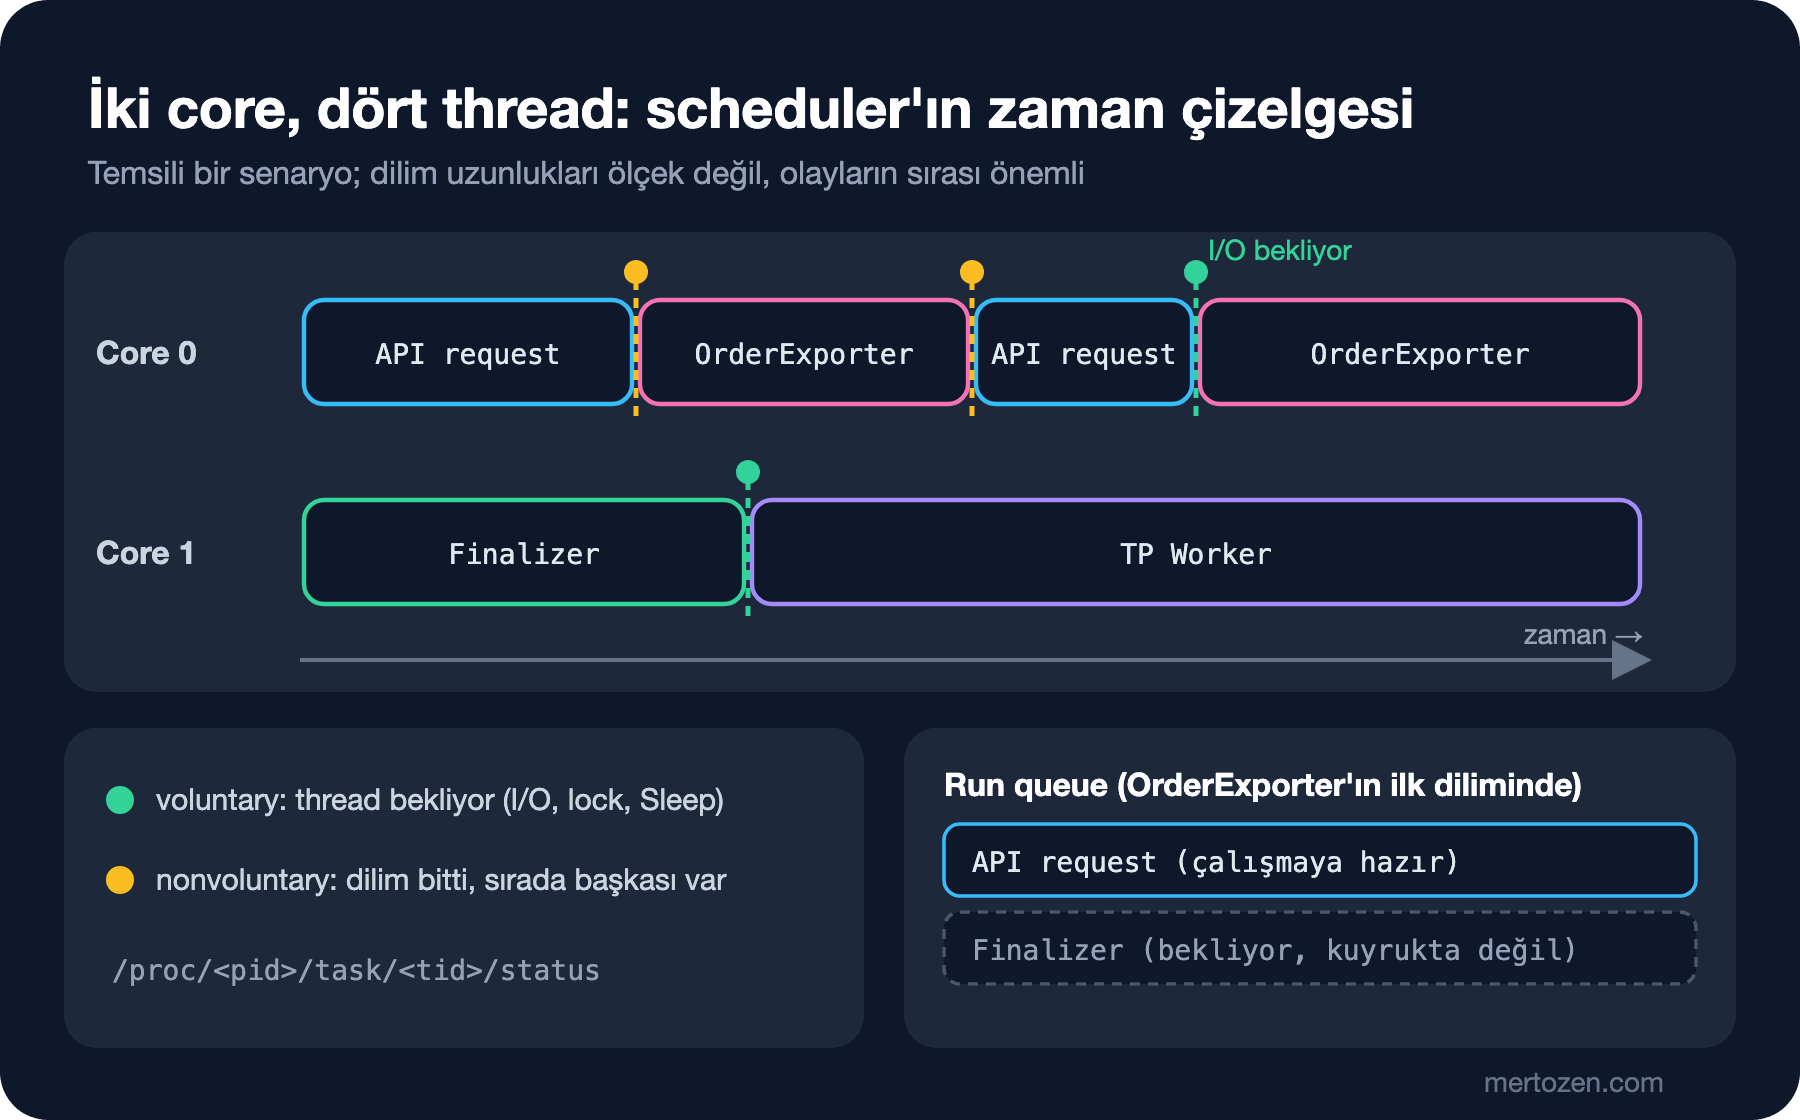
Bir thread'den diğerine geçişe context switch denir. Microsoft'un dokümanı adımları açıkça sayıyor: durdurulan ya da kendi isteğiyle bırakan thread'in context'i (register'ları) saklanır, hâlâ çalışmaya hazırsa kendi önceliğinin kuyruğunun sonuna konur, en yüksek öncelikli dolu kuyruk bulunur ve oradaki ilk thread'in context'i yüklenip çalıştırılır. Geçişin üç yaygın sebebi var: dilim bitti ve aynı önceliğe sahip başka bir thread hazır; daha yüksek öncelikli bir thread hazır hâle geldi; ya da çalışan thread beklemek zorunda kaldı. Linux bu ayrımı iki sayaçla tutar: thread beklemeye geçtiği için olan geçişler voluntary, scheduler'ın thread'i elinden alıp başkasına verdiği geçişler nonvoluntary.
Context Switch'i Görmek ve Ölçmek
Bu sayaçlar her thread için /proc/thread-self/status dosyasında. Deney uygulamasına CPU'yu hiç bırakmayan işçiler ekledim; her işçi bitince kendi sayaçlarını okuyor:
// CPU'yu hiç bırakmayan, yalnız sayaç artıran bir iş
public static long Spin(TimeSpan duration)
{
    long iterations = 0;
    Stopwatch sw = Stopwatch.StartNew();
    while (sw.Elapsed < duration)
    {
        for (int i = 0; i < 10_000; i++)
        {
            iterations++;
        }
    }
    return iterations;
}

// /proc/thread-self/status: bu thread'in voluntary ve nonvoluntary context switch sayaçları
public static (long Voluntary, long Involuntary) ContextSwitches()
{
    if (!OperatingSystem.IsLinux())
    {
        return (-1, -1);
    }
    long voluntary = 0, involuntary = 0;
    foreach (string line in File.ReadLines("/proc/thread-self/status"))
    {
        if (line.StartsWith("voluntary_ctxt_switches:"))
            voluntary = long.Parse(line.Split(':')[1]);
        else if (line.StartsWith("nonvoluntary_ctxt_switches:"))
            involuntary = long.Parse(line.Split(':')[1]);
    }
    return (voluntary, involuntary);
}
Dört işçiyi tek bir core'a sıkıştırmak için container'ı --cpuset-cpus=0 ile başlattım:
dotnet publish src/Bookstore.OsLab -c Release -o out
docker run --rm -it --cpuset-cpus=0 -v ${PWD}/out:/app -w /app mcr.microsoft.com/dotnet/sdk:10.0 bash
dotnet Bookstore.OsLab.dll cpu-info
dotnet Bookstore.OsLab.dll workers 4 3
ProcessorCount=1
cpu.max=max 100000
worker-0: 2,897 M iterations, voluntary=0, nonvoluntary=268
worker-1: 2,902 M iterations, voluntary=0, nonvoluntary=258
worker-2: 2,904 M iterations, voluntary=0, nonvoluntary=267
worker-3: 2,920 M iterations, voluntary=0, nonvoluntary=254Dört işçi 3 saniye boyunca tek core'u paylaştı ve neredeyse eşit iş yaptı. Hiçbiri kendi isteğiyle CPU'yu bırakmadı (voluntary 0); her biri yaklaşık 260 kez scheduler tarafından durduruldu. Toplam bin civarı geçiş 3 saniyeye bölününce dilimlerin birkaç milisaniye mertebesinde olduğu görülüyor.
Bir geçişin ne kadar sürdüğünü görmek için iki thread'in birbirini sırayla uyandırdığı bir ping-pong yeterli. AutoResetEvent beklerken spin yapmaz, doğrudan kernel'de bloklanır; böylece her tur gerçek iki geçiş olur:
// İki thread sırayla birbirini uyandırır; AutoResetEvent spin yapmadan bloklar
public static (TimeSpan Elapsed, long Voluntary) PingPong(int rounds)
{
    using AutoResetEvent ping = new(false), pong = new(false);
    long ponger = 0;
    Thread other = new(() =>
    {
        for (int i = 0; i < rounds; i++)
        {
            ping.WaitOne();
            pong.Set();
        }
        ponger = ContextSwitches().Voluntary;
    });
    other.Start();

    long before = ContextSwitches().Voluntary;
    Stopwatch sw = Stopwatch.StartNew();
    for (int i = 0; i < rounds; i++)
    {
        ping.Set();
        pong.WaitOne();
    }
    sw.Stop();
    other.Join();
    return (sw.Elapsed, ContextSwitches().Voluntary - before + ponger);
}
# --cpuset-cpus=0 (tek core)
100,000 round trips in 239 ms (2.39 us each), voluntary switches=217,161
# --cpuset-cpus=0,1 (iki core)
100,000 round trips in 1967 ms (19.67 us each), voluntary switches=200,779Tek core'da bir tur 2,4 mikrosaniye ve iki voluntary switch içeriyor; yani bir uyandırma ve geçiş, kernel'deki bekleme mekanizması dahil, bir mikrosaniyenin biraz üstünde. İki core'da aynı iş sekiz kat yavaş. Başlıca sebep, uyanacak thread'in başka bir core'da beklemesi: o core'un boşta beklediği durumdan çıkarılması ve sinyalin core'lar arasında taşınması gerekiyor. Bu sayılar Docker'ın kullandığı Linux VM'inde ölçüldü; çıplak donanımda daha küçük olur ama oran fikri değişmez. Bir context switch'in asıl maliyeti de yalnız bu süre değil: yeni thread'in verisi CPU cache'lerinde olmadığı için ilk mikrosaniyeler yavaş geçer. Cache tarafı ilerideki Bilgisayar Nasıl Çalışır serisinin konusu.
Klasik Politikalar: Interactive İş ile Batch İş Arasında
Scheduler'ın çözdüğü problem aslında bir ikilem. Bookstore API'deki bir istek kısa sürer ama hemen cevap bekler; gece raporu uzun sürer ama birkaç saniye geç başlaması kimseyi üzmez. İlk akla gelen FIFO (first in, first out; gelen sırayla çalıştırma): uzun bir rapor işi önde başladığında arkasındaki kısa istekler onu beklemek zorunda kalır. Round Robin her işe sırayla küçük bir dilim verir ve kısa işlerin beklemesini azaltır; ama dilim çok küçükse zamanın büyük kısmı context switch'e gider, çok büyükse sistem tepkisizleşir. MLFQ (multi-level feedback queue; işlerin davranışına göre kuyruk değiştirdiği çok seviyeli kuyruk) bu ikisini birleştirmeye çalışır: CPU'yu sık bırakan işi interactive sayıp yüksek öncelikte tutar, dilimini sonuna kadar kullanan işi batch sayıp aşağı indirir. Gerçek scheduler'ların hepsi bu ikilemin bir cevabı.
Linux: CFS'ten EEVDF'e ve nice
Linux 2.6.23'ten 6.6'ya kadar CFS (Completely Fair Scheduler; her thread'e ağırlığına göre adil CPU payı vermeye çalışan scheduler) kullandı. Fikir basit: her thread'in ağırlıklı bir virtual runtime'ı tutulur ve en az çalışmış olan çalıştırılır. Linux 6.6 ile geçiş başlayan EEVDF (Earliest Eligible Virtual Deadline First; çalışmaya hak kazanmış thread'ler arasından virtual deadline'ı en erken olanı seçen algoritma) aynı adalet hedefini korur ama seçimi farklı yapar. Kernel dokümanına göre her thread'in bir lag'i vardır: hak ettiği pay ile aldığı pay arasındaki fark. Lag'i sıfır ya da pozitif olan thread'ler eligible sayılır, aralarından virtual deadline'ı en erken olan çalışır. Daha kısa dilim isteyen bir thread daha erken bir deadline alır; uygulamalar bunu sched_setattr() ile isteyebilir. Böylece latency'ye duyarlı işler, adaleti bozmadan daha sık CPU'ya çıkabilir. Doküman, uyuyan thread'lerin lag'inin nasıl ele alınacağının hâlâ tartışıldığını da not ediyor.
Ağırlığı belirleyen nice değeridir: -20 ile 19 arasında, büyük değer daha az pay demek. Kernel kaynağındaki tablo nice 0 için 1024, nice 10 için 110 ağırlık veriyor ve yanındaki yoruma göre her nice seviyesi CPU payını yaklaşık yüzde 10 değiştiriyor. Giriş sorusunu tek core'da ölçtüm:
nice -n 10 dotnet Bookstore.OsLab.dll spin 5 & dotnet Bookstore.OsLab.dll spin 5; waitpid=37 Normal 15,761 M iterations
pid=36 Normal 1,991 M iterations36 numaralı process nice -n 10 ile başladı ve yaptığı iş toplamın yüzde 11'i; ağırlıklardan beklenen 110 / 1134, yani yüzde 9,7. Fark, iki process'in açılışlarının aynı ana denk gelmemesinden. Raporun payı yarı ya da üçte bir değil, onda bir civarı.
Windows Öncelikleri ve .NET'te PriorityClass
Windows'ta her thread'in 0 ile 31 arasında bir önceliği vardır. Microsoft'un dokümanına göre bu değer process'in priority class'ı (Idle, BelowNormal, Normal, AboveNormal, High, RealTime) ile thread'in o sınıf içindeki seviyesinin birleşmesinden çıkar; Normal sınıftaki normal bir thread'in temel önceliği 8'dir. Scheduler en yüksek öncelikli hazır thread'lere dilimleri sırayla dağıtır, daha yüksek öncelikli bir thread hazır olunca daha düşük olanı dilimini bitirmesini beklemeden durdurur. Linux'un ağırlıklı adaletinden farklı olarak bu katı bir önceliktir; doküman High sınıfını dikkatli kullanmayı, RealTime'ı ise neredeyse hiç kullanmamayı söylüyor, çünkü klavye, fare ve disk flush işlerini yapan sistem thread'lerinin önüne geçer.
.NET'te Process.PriorityClass Windows'ta doğrudan bu sınıfı değiştirir. Linux'ta ise dotnet/runtime kaynağına göre bir nice değerine çevrilir: BelowNormal 10, Idle 19, AboveNormal -6, High -11, RealTime -19. Negatif değerler root yetkisi ister. Burada bir tuzak var. Önce aynı ölçümü kodun içinden yaptım; spin komutu ikinci argümanı Process.PriorityClass'a yazıyor:
dotnet Bookstore.OsLab.dll spin 5 BelowNormal & dotnet Bookstore.OsLab.dll spin 5; waitpid=53 Normal 16,087 M iterations
pid=52 BelowNormal 1,752 M iterationsBeklendiği gibi. Ama bu ölçümde iş ana thread'de çalışıyordu. Bir de process'in bütün thread'lerinin nice değerine bakalım:
case "nice":
{
    await Task.Run(() => { }); // thread pool thread'leri oluşsun
    using (Process self = Process.GetCurrentProcess())
    {
        self.PriorityClass = ProcessPriorityClass.BelowNormal;
    }
    Thread late = new(() => Thread.Sleep(500)) { Name = "created-after" };
    late.Start();
    foreach ((string tid, string name, int nice) in SchedLab.ThreadNiceValues())
    {
        Console.WriteLine($"{tid,6} {name,-16} nice={nice}");
    }
    late.Join();
    break;
}
15024 dotnet nice=10
15105 .NET SynchManag nice=0
15106 .NET EventPipe nice=0
15107 .NET DebugPipe nice=0
15108 .NET Debugger nice=0
15109 .NET Finalizer nice=0
15110 .NET Tiered Com nice=0
15111 .NET TP Worker nice=0
15112 .NET TP Gate nice=0
15113 .NET TP Worker nice=0
15114 created-after nice=0Yalnız ana thread nice 10 oldu. Thread pool işçileri nice 0'da kaldı; ayarı yaptıktan sonra açtığımız created-after thread'i de bu ölçümde 0 ile başladı. Sebep Linux'un kendisi: setpriority(2) man sayfası, POSIX'e (Unix benzeri sistemlerin ortak API standardı) göre process'e ait olması gereken nice değerinin Linux'ta thread başına bir özellik olduğunu yazıyor. .NET'in kullandığı setpriority(PRIO_PROCESS, pid) çağrısı bu yüzden yalnız TID'i (thread'in kernel'deki numarası) PID'e (process'in numarası) eşit olan thread'i, yani ana thread'i etkiliyor. İşi thread pool'da yapan bir ASP.NET Core uygulamasında PriorityClass'ı değiştirmek Linux'ta pratikte hiçbir şey yapmaz. Process'i dışarıdan nice -n 10 ile başlatmak ise doğru çalışıyor: aynı container'da threads komutunu böyle başlattığımda on iki thread'in hepsi nice 10'du.
Container'da CPU: cpuset, Quota ve Throttling
Container'a CPU sınırı koymanın iki yolu var. --cpuset-cpus process'i belirli core'lara bağlar; yukarıdaki ölçümler bununla yapıldı ve Environment.ProcessorCount 1 döndü. --cpus ise core sayısını değil, zamanı sınırlar: cgroup v2'deki cpu.max dosyasına "her periyotta en fazla şu kadar mikrosaniye" yazar. Kernel dokümanına göre bir grup periyot içindeki kotasını bitirdiğinde thread'leri bir sonraki periyoda kadar throttle edilir, yani çalışmaya hazır olsalar bile bekletilir:
docker run --rm -it --cpus=0.5 -v ${PWD}/out:/app -w /app mcr.microsoft.com/dotnet/sdk:10.0 bash
dotnet Bookstore.OsLab.dll cpu-info
time dotnet Bookstore.OsLab.dll workers 2 3
cat /sys/fs/cgroup/cpu.stat
ProcessorCount=1
cpu.max=50000 100000
worker-0: 2,570 M iterations, voluntary=8, nonvoluntary=35
worker-1: 2,480 M iterations, voluntary=58, nonvoluntary=33
real 0m3.023s
user 0m1.515s
sys 0m0.005s
usage_usec 1544766
user_usec 1534876
system_usec 9889
nice_usec 0
nr_periods 31
nr_throttled 30
throttled_usec 4505300
nr_bursts 0
burst_usec 050000 100000: her 100 ms'lik periyotta 50 ms CPU. İki thread 3 saniye çalışmak istedi ama toplam yalnız 1,5 saniye CPU alabildi; 31 periyodun 30'unda grup throttle edildi. Bu container içindeki bir API için şu demek: her 100 ms'nin ilk yarısında istekler işlenir, ikinci yarısında hepsi bekleyebilir ve p99 latency'ye (isteklerin yüzde 99'unun altında kaldığı süre) onlarca milisaniye eklenebilir. ProcessorCount 0,5 limitte 1 döndü; Microsoft'un dokümanına göre değer, makinedeki core sayısı, affinity ve yukarı yuvarlanmış CPU limiti arasındaki en küçük sayıdır ve process açılırken sabitlenir. --cpus=2 ile 2 döndü, DOTNET_PROCESSOR_COUNT=4 ile bu değeri elle 4'e çekebildim. GC'nin (garbage collector; kullanılmayan belleği toplayan bileşen) heap sayısı ve thread pool'un başlangıç boyutu bu değere bakar; Kubernetes'te request ve limit'in bunlarla ilişkisini yayınlanmış Kubernetes serisinin resource request ve limit yazısında anlatmıştık.
Üretimde Dikkat
Container'da CPU limiti koyduysan cpu.stat'taki nr_throttled ve throttled_usec'i izle; CPU kullanım grafiği yüzde 50'de düz görünürken latency'nin neden dalgalandığını bu sayılar açıklar. Kısa süreli yüksek CPU isteyen API'ler için düşük bir limit, ortalama kullanım düşük olsa bile throttling demektir.
Context switch sayısını izlemek de işe yarar. /proc/<pid>/status içindeki iki sayaç process'in toplamını verir; nonvoluntary sayısı hızla artıyorsa CPU'dan fazla iş var demektir, voluntary sayısı çok yüksekse thread'ler sürekli bir lock'u ya da birbirini bekliyor olabilir. Thread pool'a bloklayan iş vermek ikisini birden artırır.
Sık Düşülen Tuzaklar
Priority'yi performans ayarı sanmak. Bir işin önceliğini yükseltmek toplam işi hızlandırmaz, yalnız sırayı değiştirir. Windows'un katı öncelik modelinde yüksek öncelikli, CPU'yu bırakmayan bir thread düşük öncelikli olanları hiç çalıştırmayabilir (starvation). Düşük öncelikli bir thread'in tuttuğu lock'u yüksek öncelikli bir thread beklediğinde ise priority inversion ortaya çıkar. Bu iki problemin teorisi ilerideki Concurrency Teorisi serisinin konusu.
Thread.Sleep(0) ya da Thread.Yield() ile "düzeltme". .NET dokümanına göre Thread.Yield, çalışmaya hazır başka bir thread'e yalnız aynı core üzerinde sıra verir; sırada kimse yoksa hiçbir şey olmaz. Bir döngüye Yield eklemek bir yarış koşulunu çözmez, yalnız zamanlamasını değiştirip daha nadir görünür hâle getirir. Bekleme gerekiyorsa gerçek bir senkronizasyon aracı kullan.
Linux'ta Process.PriorityClass'a güvenmek. Yukarıda gördüğümüz gibi yalnız ana thread'i etkiler. Arka plan işini yavaşlatmak istiyorsan onu ayrı bir process olarak nice ile başlat ya da container'da ayrı bir CPU limiti ver.
Container'daki ProcessorCount'u makinenin core sayısı sanmak. Paralellik derecesini, kanal ya da worker sayısını hesaplarken Environment.ProcessorCount kullan, kendi tahminini değil; limit değiştiğinde değer de değişir.
Küçük Bir Deneme
★☆☆ Tek core'lu container'da workers 2 3, workers 4 3 ve workers 8 3 çalıştır. Toplam iterasyon sayısının ve thread başına nonvoluntary switch sayısının nasıl değiştiğini tabloya dök.
★★☆ nice -n 5 ve nice -n 15 ile iki spin process'ini aynı core'da yarıştır. Sonucu kernel'deki ağırlık tablosundan (nice 5 için 335, nice 15 için 36) hesapladığın oranla karşılaştır.
★★★ --cpus=0.5 container'ında bir ASP.NET Core Minimal API çalıştır ve her istekte 30 ms CPU harcayan bir endpoint yaz. Saniyede 10 istekle yük verip p99 latency'yi ve nr_throttled'ı ölç, sonra aynı deneyi --cpus=1 ile tekrarla.
Bu yazıda thread'lerin CPU'yu nasıl paylaştığını gördük. Paylaşılan ikinci büyük kaynak bellek. Bir sonraki yazıda virtual memory'ye bakıyoruz: ikinci yazıdaki 17 GB'lık VmSize ile 27 MB'lık VmRSS nasıl aynı process'e ait olabiliyor, page table ve TLB (translation lookaside buffer; adres çevirilerini tutan CPU cache'i) ne iş yapar ve bir page fault'un minor ya da major olması neyi değiştirir?