

"Sayfam Neden Index'lenmedi?" Indexing Sorunlarını Adım Adım Teşhis Etmek
Index'lenmeyen bir sayfa için sırayla sor: Google URL'yi biliyor mu, robots.txt izin veriyor mu, 200 dönüyor mu, noindex var mı, canonical kendini mi gösteriyor, içerik gerçek mi; ilk hayır cevabı sorunun yeridir. Teşhis ağacını, yerelde çalışan bir .NET 10 kontrol aracını, robots.txt ile noindex çelişkisini ve Crawled/Discovered – currently not indexed durumlarını anlatıyoruz.
Sürüm notu: Bu yazı Google Search Console'un Page indexing ve URL (Uniform Resource Locator) Inspection yardım sayfalarının Kasım 2026 hâlini esas alır; kod örnekleri .NET 10 ile derlenip denenmiştir.
Önce Tahmin Et
Bookstore'da altı URL var ve hiçbiri Google'da görünmüyor: bir kitap sayfası, bir arama sonuç sayfası, paylaşılan bir okuma listesi, silinmiş bir kitap, UTM (Urchin Tracking Module) parametreli bir kampanya linki ve bulunamayan bir yazar sayfası. Hepsinin nedeni farklı. Bunlardan hangisi gerçekten bir sorun, hangisi tam olması gerektiği gibi davranıyor? Bir de şunu düşün: arama sonuç sayfası hem robots.txt ile engellenmiş hem de içinde noindex var. Bu ikisi birlikte "çifte güvenlik" mi, yoksa birbirini mi bozuyor?
Önce Doğru Soruyu Sor: Hangi Aşamada Takıldı?
Serinin ilk yazısındaki boru hattını hatırla: keşif, crawl, render, index, serving. "Index'lenmedi" şikâyetinin yarısı aslında "index'lendi ama görünmüyor" durumudur; ikisi tamamen farklı teşhis gerektirir. Bu yüzden ilk adım her zaman Search Console'daki URL Inspection: URL'yi yapıştır ve "URL is on Google" mı, "URL is not on Google" mı, ona bak. Sayfa index'teyse sorun serving tarafında, yani sorgu, alaka ve kalite; ranking'i serinin üçüncü yazısında konuşmuştuk. Index'te değilse aşağıdaki ağaç devreye giriyor.
Bir uyarı: site: operatörü teşhis aracı değil. site:bookstore.example/books/ araması sana bir fikir verir, ama Google bu operatörün index'teki bütün URL'leri döndürmeyebileceğini açıkça söylüyor ve sonuç sayısı bir tahmin. Bir URL'nin index'te olup olmadığının güvenilir cevabı URL Inspection.
Teşhis Ağacı
Aşağıdaki ağaç sorulara yukarıdan aşağı cevap vermeni ve ilk "hayır"da durmanı istiyor. Her dalın çözüm detayı Teknik SEO (Search Engine Optimization) serisinde; bu yazı teşhis merkezi.
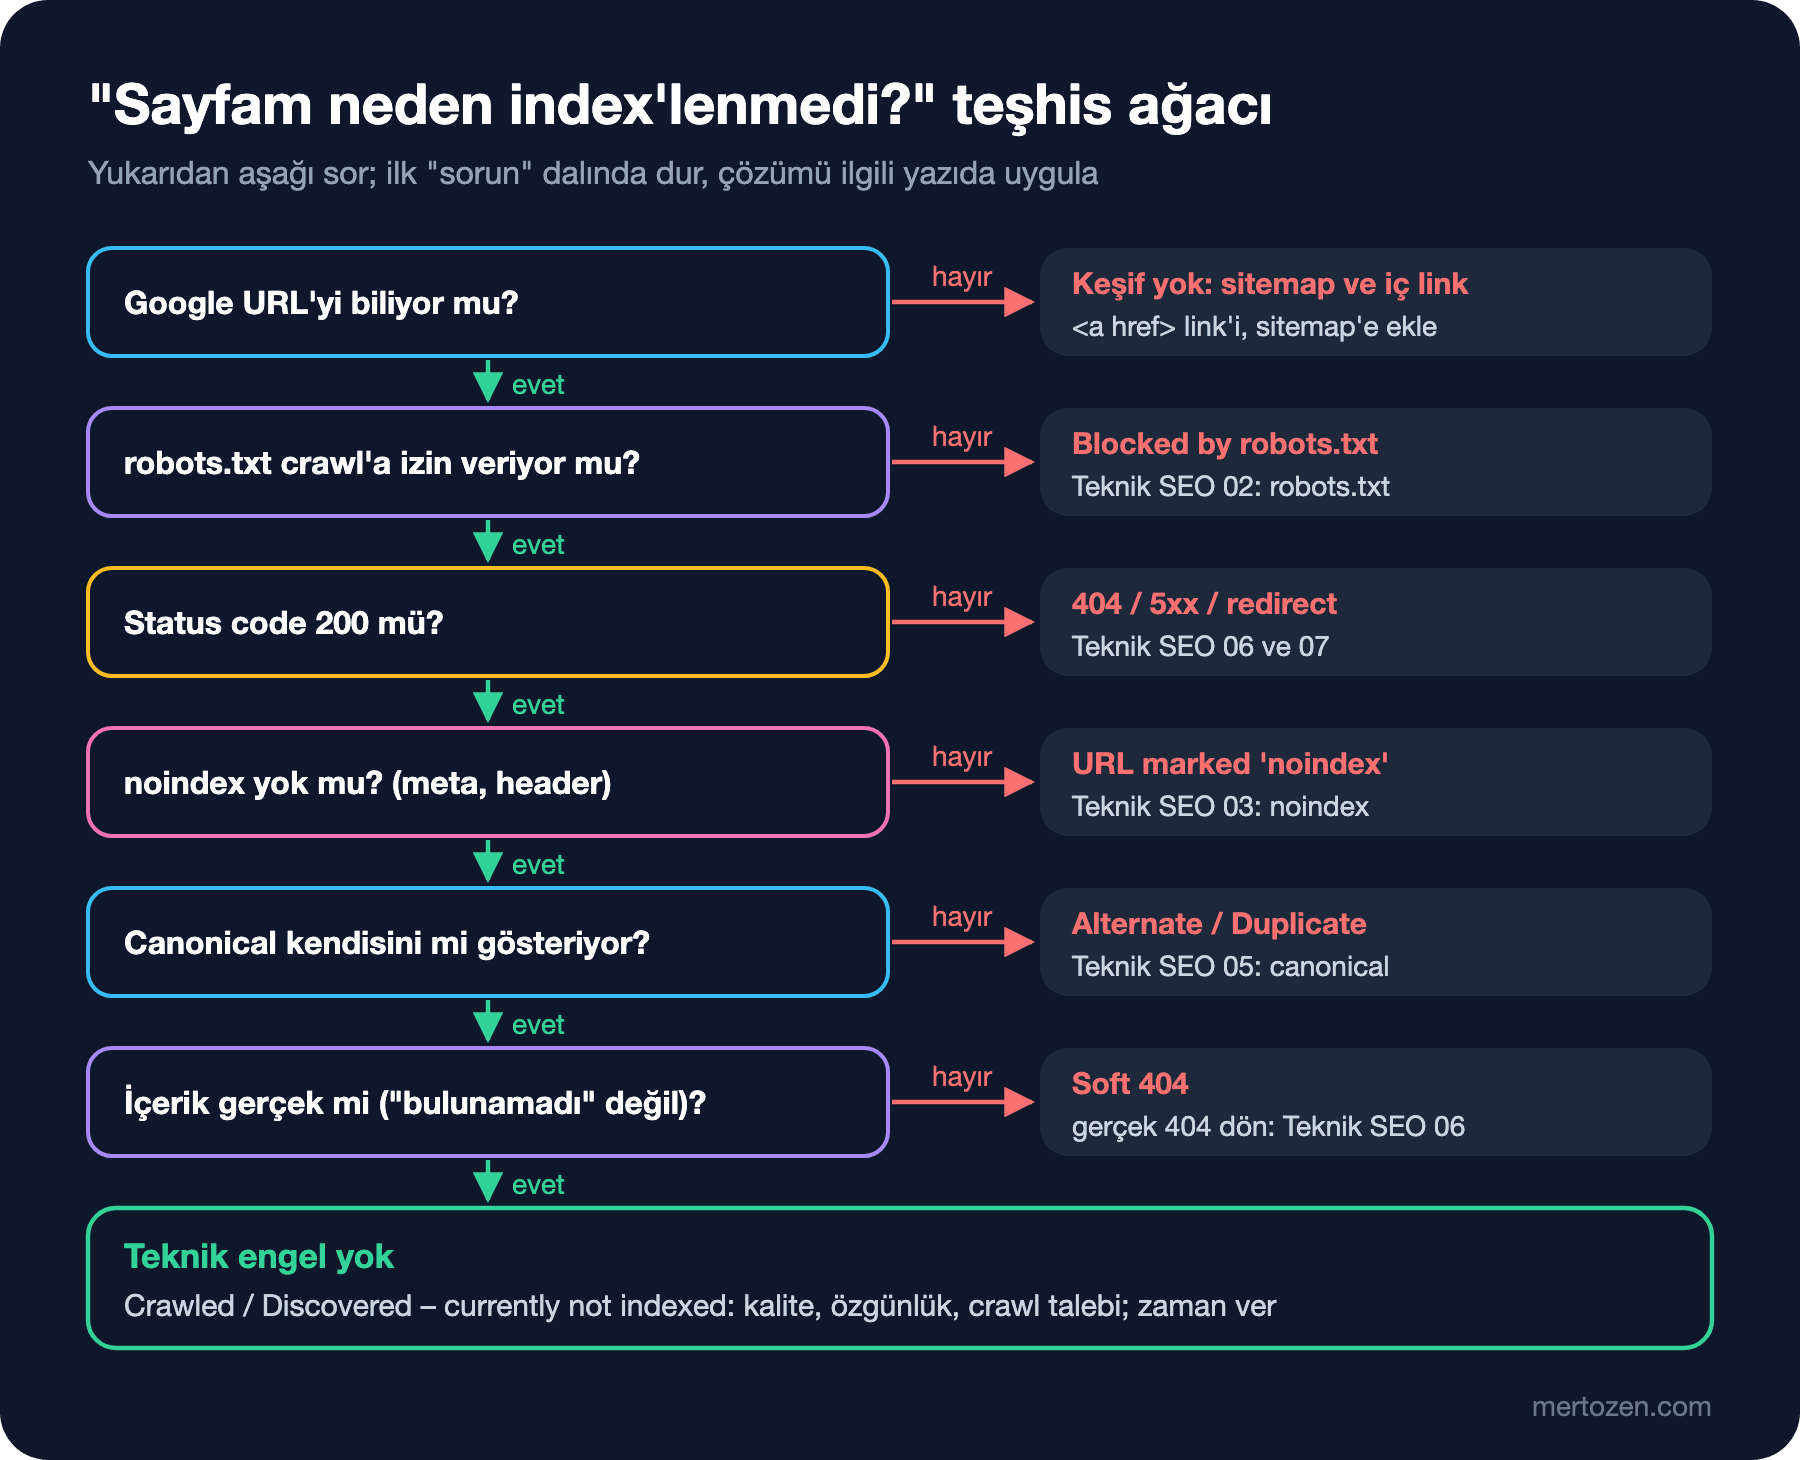
Sıralamanın bir mantığı var: her soru bir sonrakinin ön koşulu. robots.txt crawl'ı engelliyorsa Google sayfayı hiç indirmez; status code'u da, noindex'i de, canonical'ı da göremez. Bu yüzden canonical'ı incelemeden önce robots.txt'e bakmak zorundasın.
Ağacı Yerelde Çalıştırmak
Ağacın teknik dallarını, yani robots.txt, status code, noindex, canonical ve soft 404 dallarını, kendi sunucuna karşı kontrol eden küçük bir .NET 10 file-based app yazmak mümkün. Search Console'un yerini tutmaz; Google'ın kararını değil, senin sitenin gönderdiği sinyalleri gösterir. Ama yayından önce, staging'de ya da CI (Continuous Integration) içinde koşabilir.
using System.Text.RegularExpressions;

Uri url = new(args[0]);
using HttpClient http = new(new HttpClientHandler { AllowAutoRedirect = false });

// 1. robots.txt: yalnızca "*" group'u, en uzun eşleşen önek kazanır (wildcard yok)
string robots = await http.GetStringAsync(new Uri(url, "/robots.txt"));
string? rule = MatchRobots(robots, url.PathAndQuery);
if (rule is not null && rule.StartsWith("Disallow"))
{
    Verdict("Blocked by robots.txt", $"{rule}; a noindex on this page can never be seen");
    return;
}

// 2. status code
using HttpResponseMessage response = await http.GetAsync(url);
int status = (int)response.StatusCode;
if (status is >= 300 and < 400)
{
    Verdict("Page with redirect", $"{status} -> {response.Headers.Location}");
    return;
}
if (status >= 400)
{
    Verdict(status >= 500 ? "Server error (5xx)" : $"Not found or blocked ({status})", "only 200 pages can be indexed");
    return;
}

// 3. header'da veya HTML'de noindex
string html = await response.Content.ReadAsStringAsync();
if (response.Headers.TryGetValues("X-Robots-Tag", out IEnumerable<string>? tags) && tags.Any(t => t.Contains("noindex")))
{
    Verdict("URL marked 'noindex'", "X-Robots-Tag header");
    return;
}
if (Regex.IsMatch(html, """<meta[^>]+name="robots"[^>]+noindex""", RegexOptions.IgnoreCase))
{
    Verdict("URL marked 'noindex'", "robots meta tag");
    return;
}

// 4. başka URL'yi gösteren canonical
Match canonical = Regex.Match(html, """<link[^>]+rel="canonical"[^>]+href="([^"]+)""");
if (canonical.Success && new Uri(canonical.Groups[1].Value).PathAndQuery != url.PathAndQuery)
{
    Verdict("Alternate page / duplicate", $"canonical points to {canonical.Groups[1].Value}");
    return;
}

// 5. soft 404 sezgisi
if (html.Contains("not found", StringComparison.OrdinalIgnoreCase))
{
    Verdict("Possible soft 404", "200 response whose content says 'not found'");
    return;
}

Verdict("No technical blocker", "if it is still not indexed, look at quality and duplicates");

void Verdict(string title, string detail) => Console.WriteLine($"{url.PathAndQuery,-44} {title}: {detail}");

static string? MatchRobots(string robots, string path)
{
    bool inStarGroup = false;
    string? best = null;
    foreach (string raw in robots.Split('\n'))
    {
        string line = raw.Trim();
        if (line.StartsWith("User-agent:", StringComparison.OrdinalIgnoreCase))
        {
            inStarGroup = line[11..].Trim() == "*";
            continue;
        }
        string[] parts = line.Split(':', 2);
        if (!inStarGroup || parts.Length != 2 || parts[1].Trim().Length == 0)
        {
            continue;
        }
        string prefix = parts[1].Trim();
        bool isRule = parts[0] is "Allow" or "Disallow";
        if (isRule && path.StartsWith(prefix) && (best is null || prefix.Length > best.Split(':', 2)[1].Trim().Length))
        {
            best = $"{parts[0]}: {prefix}";
        }
    }
    return best;
}
robots.txt eşleştirmesi bilerek basit: yalnızca * group'u ve önek eşleşmesi. Wildcard'lar, $ ve group birleştirme kuralları RFC (Request for Comments) 9309'da tanımlı; ayrıntısı Teknik SEO serisinin "robots.txt Rehberi" yazısında. Bookstore'un robots.txt'i /search ve /account/'u engelliyor. Baştaki altı URL için gerçek çıktı:
/books/async-in-practice                     No technical blocker: if it is still not indexed, look at quality and duplicates
/search?q=async                              Blocked by robots.txt: Disallow: /search; a noindex on this page can never be seen
/lists/q7Hk2                                 URL marked 'noindex': X-Robots-Tag header
/books/no-such-book                          Not found or blocked (404): only 200 pages can be indexed
/books/async-in-practice?utm_source=newsletter Alternate page / duplicate: canonical points to https://bookstore.example/books/async-in-practice
/authors/nobody                              Possible soft 404: 200 response whose content says 'not found'
Şimdi baştaki soruyu cevaplayabiliriz. Okuma listesi, silinmiş kitap ve UTM'li link sorun değil; bilinçli kararlar. Kitap sayfasında teknik engel yok; index'lenmemişse sorun başka yerde. Yazar sayfası gerçek bir hata: bulunamayan içerik için 200 dönüyor. Arama sayfası ise ikinci sorunun cevabı.
robots.txt ve noindex Birlikte: Çifte Güvenlik Değil
Arama sayfasında hem Disallow: /search hem de <meta name="robots" content="noindex"> var. Sezgi "iki kat güvenli" diyor, gerçek tersi. Google robots.txt yüzünden sayfayı indirmediği için meta tag'i hiç görmez. URL Inspection'da "Indexing allowed?" alanı bu durumda her zaman "Yes" gösterir. Dışarıdan link alan bir arama URL'si bu yüzden içeriği okunmadan sonuçlarda görünebilir; Page indexing raporunda bunun adı "Indexed, though blocked by robots.txt".
Amacın arama sayfalarını index dışında tutmaksa doğru sıra: önce crawl'a izin ver ve noindex'i Google'a göster, sayfalar index'ten düştükten sonra, crawl yükünü azaltmak istiyorsan, robots.txt kuralını ekle. Amacın yalnızca crawl yükünü azaltmaksa robots.txt yeterli, ama o zaman index'te görünme ihtimalini kabul ediyorsun. Teknik SEO serisinin "noindex ve X-Robots-Tag" yazısı bu çelişkiyi ayrıntılı ele alıyor.
Status Code Dalı: 404, 410, 5xx, 401/403 ve Redirect
HTTP (Hypertext Transfer Protocol) status code dalı tek bir soruya benziyor ama raporda birçok satıra ayrılıyor. Not found (404) bilinçli olarak sildiğin sayfalar için doğru cevap; kalıcı olarak kaldırdığın içerik için 410 da kullanabilirsin. Bu satırlar ancak hâlâ trafik alan veya iç link'lerin gösterdiği bir URL'yi kapsıyorsa sorun. Server error (5xx) ise her zaman incelenmeli: Google yalnızca index'leyemediği için değil, crawl hızını düşürdüğü için de bu hatalar zarar veriyor. Blocked due to unauthorized request (401) ve Blocked due to access forbidden (403), Googlebot'un kimlik bilgisi göndermediğini hatırlatıyor; giriş arkasındaki bir sayfa zaten index'lenmez, ama herkese açık olması gereken bir sayfa 403 dönüyorsa bir WAF (Web Application Firewall) veya bot koruma kuralı Googlebot'u yanlışlıkla engelliyor olabilir.
Page with redirect ise çoğu zaman sağlıklı bir durum: URL başka bir adrese yönleniyor ve index'e hedef girer. mertozen.com Kasım 2026'da İngilizce sayfaları ?lang=en parametresinden /en/ alt klasörüne taşıdı ve eski adresleri 301 ile yeni adreslere yönlendiriyor; önümüzdeki haftalarda raporda bu eski adreslerin "Page with redirect" satırına dolması beklenen sonuç. Redirect error ise farklı: zincir çok uzun, döngüye giriyor, aşırı uzun bir URL üretiyor ya da boş bir hedefe gidiyor. Redirect türleri ve zincirler Teknik SEO serisinin "Redirect'ler" yazısında, status code'ların ayrıntısı "HTTP Status Code'ları ve Soft 404" yazısında.
Canonical Dalı: User-declared ve Google-selected
URL Inspection iki canonical gösteriyor. User-declared canonical, senin link tag'i, HTTP header'ı, sitemap veya başka bir yöntemle bildirdiğin URL. Google-selected canonical ise Google'ın benzer sayfalar arasından seçtiği URL. İkisi aynıysa her şey yolunda. Page indexing raporunda üç farklı durum görürsün:
- Alternate page with proper canonical tag: sayfa başka bir sayfanın alternatifi ve o sayfa index'te. UTM'li kampanya linki için beklenen durum; düzeltilecek bir şey yok.
- Duplicate without user-selected canonical: sen canonical bildirmemişsin, Google başka bir sayfayı seçmiş. Kendi seçimini
rel="canonical"ile bildir. - Duplicate, Google chose different canonical than user: sen bir canonical bildirmişsin, Google başka birini seçmiş. Sinyallerin çelişiyor olabilir: iç link'ler başka URL'yi gösteriyor, sitemap başka URL'yi listeliyor veya iki sayfa gerçekten aynı.
Son durum en çok vakit alanı. Google'ın canonical sorun giderme rehberi Temmuz 2026'da yeniden değerlendirmenin zamanlamasını netleştirdi; değişiklikten sonra yeni kararın görünmesi zaman alıyor. Canonical sinyallerinin tamamı ve tutarlı hâle getirilmesi Teknik SEO serisinin "Canonical URL" yazısında.
Teknik Engel Yoksa: Crawled ve Discovered – Currently Not Indexed
Ağacın en altına indiysen iki durumdan birindesin. Discovered – currently not indexed: Google URL'yi buldu ama henüz crawl etmedi; siteyi aşırı yüklememek için crawl'ı yeniden planladı. Bu genellikle yeni veya çok sayıda yeni URL'si olan sitelerde, ya da sunucunun yavaş yanıt verdiği dönemlerde görülür. Crawled – currently not indexed: Google sayfayı indirdi ama index'lemedi. Google'ın notu açık: web'deki bütün sayfaları index'lemiyor, bu durum yaygın ve her zaman müdahale gerektirmiyor.
Önemli bir sayfa bu durumdaysa teknik teşhisi bitirdikten sonra soruyu değiştir: bu sayfa neden index'e girmeyi hak ediyor? Aynı içeriğin daha iyi bir hâli sitede veya web'de var mı, sayfa ince mi, gerçekten özgün bir şey söylüyor mu? Google'ın helpful content soruları burada da geçerli. Sayfayı güçlendirdikten sonra iç link'lerle desteklemek ve sitemap'teki lastmod'u dürüstçe güncellemek, Google'a yeniden bakması için en temiz sinyal. Büyük sitelerde crawl kapasitesi ve crawl talebi konusu Teknik SEO serisinin "Crawl Budget, Log Analizi ve Googlebot'u Doğrulamak" yazısında.
Üretimde Dikkat
Teşhisi kanıtla bitir. Bir dalda düzeltme yaptıysan URL Inspection'da live test ile sinyalin artık doğru gittiğini göster, sonra Page indexing raporunda "Validate fix" başlat. Doğrulama tipik olarak iki haftaya kadar sürüyor; bekle, tekrar basma.
Sayfa tiplerini grupla. Tek tek URL'lerle uğraşmak yerine raporu sayfa şablonuna göre oku: bütün /authors/ sayfaları soft 404 ise sorun tek bir controller'da.
Yukarıdaki aracı yalnızca kendi sunucuna karşı çalıştır ve deploy sonrası birkaç kritik URL için CI'da koş. robots.txt'e yanlışlıkla eklenen bir Disallow, yayına girmeden yakalanır.
Sık Düşülen Tuzaklar
Her "not indexed" satırını bir hata sanmak. Alternate page, redirect ve bilinçli noindex satırları raporda durur ve durması gerekir.
Request indexing'e yüklenmek. Kota var ve istek index'lemeyi garanti etmez; teknik engel varsa istek de işe yaramaz.
Soft 404'ü görmezden gelmek. "Bulunamadı" yazan bir sayfanın 200 dönmesi, hem Google'ın crawl'ını boşa harcar hem de gerçek sayfalarla aynı muameleyi bekler. Gerçek 404 veya 410 dön.
Live test'in sonucunu index'teki sürüm sanmak. Live test anlık bir fotoğraf; index'teki veri son crawl'dan.
Küçük Bir Deneme
★☆☆ IndexCheck.cs'i kendi projenin beş farklı sayfa şablonuna karşı çalıştır ve her biri için ağaçta hangi dalda durduğunu yaz.
★★☆ Aracın soft 404 sezgisini geliştir: "not found" metnine ek olarak, gövdesi 512 byte'tan kısa ve <h1> içermeyen 200 yanıtları da işaretle. Bookstore'da yanlış pozitif çıkıyor mu?
★★★ robots.txt eşleştirmesine * wildcard'ını ve satır sonu için $'ı ekle; RFC 9309'daki örneklerle birim testleri yaz ve Allow ile Disallow aynı uzunlukta olduğunda hangisinin kazandığını testle göster.
Teşhis ağacıyla teknik sorunları ayırmayı öğrendik. Serinin son yazısında teknik olmayan ama en çok zaman kaybettiren konuya geçiyoruz: meta keywords'ten "garantili sıralama" vaatlerine kadar SEO mitleri ve Google'ın bunlar hakkında gerçekte ne dediği.