

Arama Motoru Nasıl Çalışır? Crawling, Rendering, Indexing ve Serving
Google bir sayfayı dört adımda işler: URL'yi keşfeder ve crawl eder, JavaScript'i render eder, içeriği duplicate cluster'lar ve canonical seçimiyle index'ler, sorgu geldiğinde alaka ve kaliteye göre sunar. Googlebot'un 2 MB sınırını gerçek bir ölçümle gösteriyor, mertozen.com'daki bir yazının yolculuğunu adım adım izliyoruz.
Sürüm notu: Bu yazı Google Search Central dokümanlarının Kasım 2026 hâlini esas alır; kod örnekleri .NET 10 ile derlenip denenmiştir.
Önce Tahmin Et
Bookstore ekibi yeni kitap sayfasını yayınladı: /books/modeling-bounded-contexts. Sayfa sitemap'te var, tarayıcıda kusursuz açılıyor, gzip ile sıkıştırılmış hâli 84 KB. Ama sayfanın <head> kısmına, bütün okur yorumlarını taşıyan büyük bir JSON (JavaScript Object Notation) bloğu gömülmüş ve sıkıştırılmamış HTML (HyperText Markup Language) 2 MB'ı biraz geçiyor. Soru şu: Google bu sayfanın <title>'ını görür mü? Peki kitabın adının yazdığı <h1>'i? Bir de şunu düşün: sayfa sitemap'te olduğu için Google'ın onu index'lemesi garanti mi?
Cevapları yazının ortasında gerçek bir ölçümle vereceğiz. Önce bir arama motorunun bir URL'yi (Uniform Resource Locator) sonuç sayfasına kadar nasıl taşıdığını adım adım kuralım; SEO (Search Engine Optimization) dediğimiz işin tamamı bu boru hattının bir yerinde takılan sayfayı bulmaktan ibaret.
Dört Aşama: Crawling, Rendering, Indexing ve Serving
Google kendi dokümanında süreci üç aşama olarak anlatır: crawling, indexing ve serving. Rendering ayrı bir başlık değildir ama JavaScript kullanan her site için ayrı düşünmek gerekir, çünkü sayfanın HTML'i ile Google'ın gördüğü içerik arasındaki fark tam orada doğar. Aşağıdaki şema her aşamayı ve o aşamada sayfanın neden elenebileceğini gösteriyor.
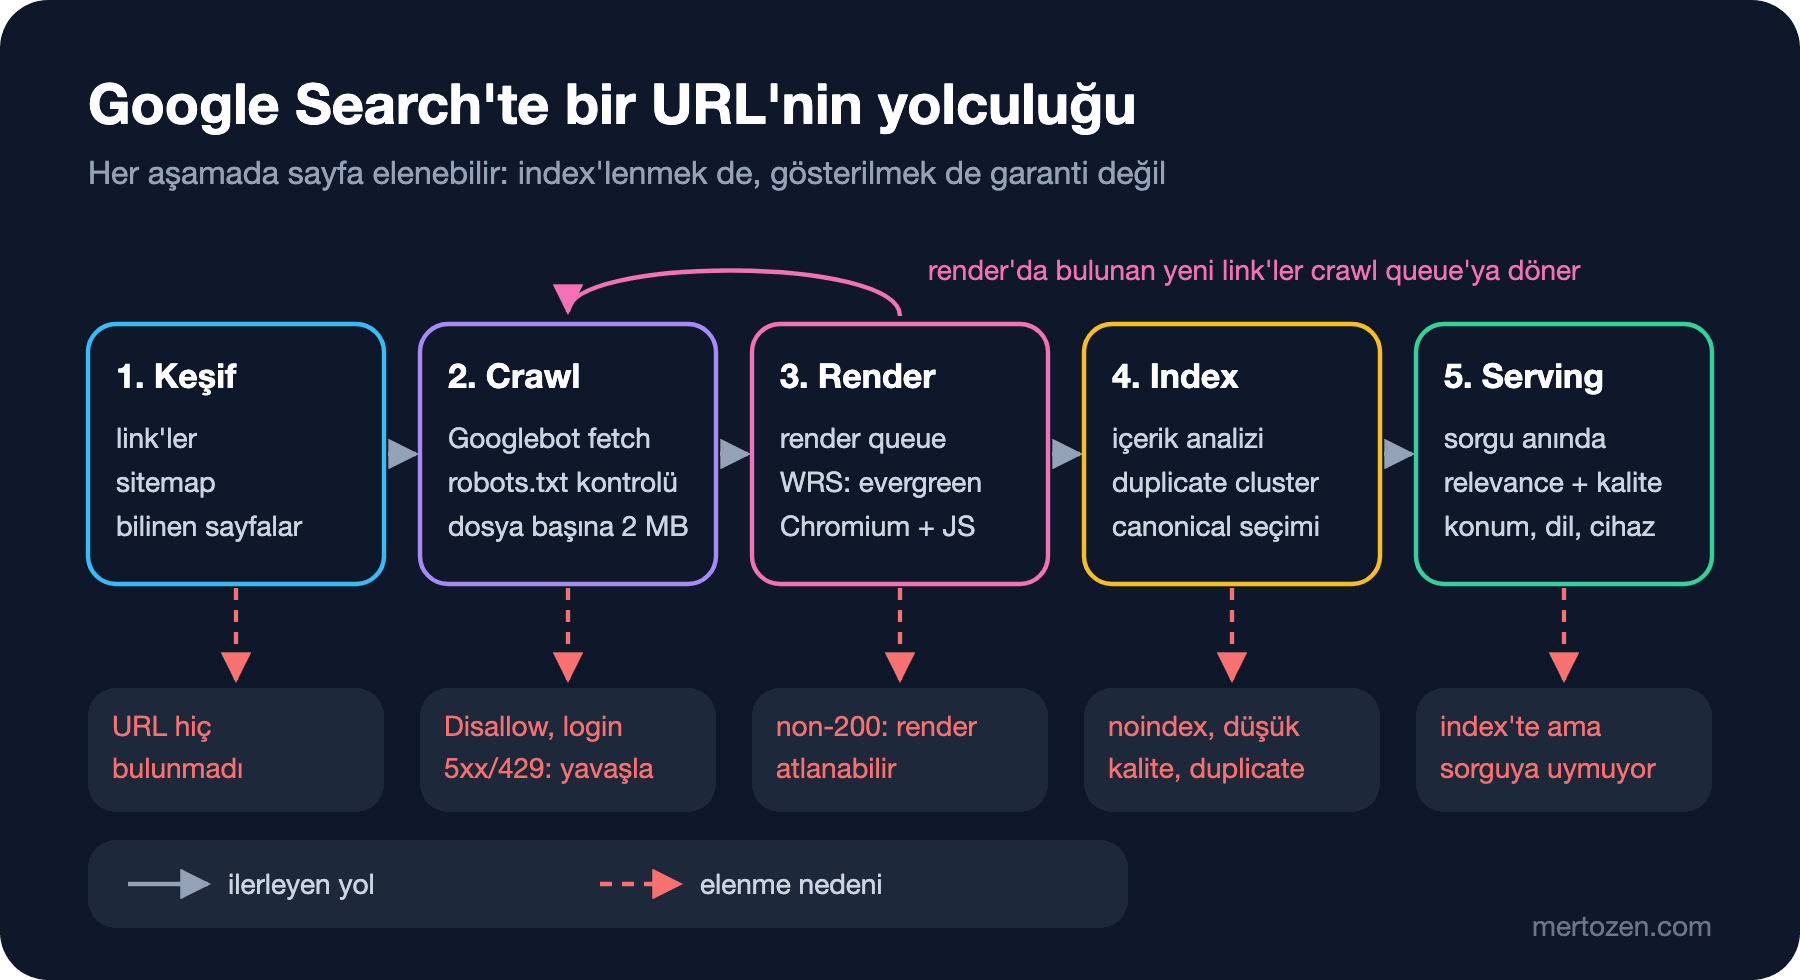
Şemadaki kırmızı kutular önemli: Google'ın kendi cümlesiyle, Search Essentials'a uyan bir sayfa için bile Google sayfayı crawl edeceğini, index'leyeceğini ya da göstereceğini garanti etmez. Bu, serinin geri kalanının da ana fikri. "Neden çıkmıyorum?" sorusunun cevabı her zaman bu beş kutudan birindedir.
Crawling: URL'ler Nasıl Keşfedilir ve İndirilir?
Web'in merkezi bir kayıt defteri yok. Google yeni URL'leri üç yerden öğrenir: daha önce ziyaret ettiği sayfalardaki link'lerden, site sahibinin gönderdiği sitemap'lerden ve zaten bildiği sayfalardan. Bookstore'un yeni kitap sayfası için en hızlı yol ana sayfadaki gerçek bir <a href> link'i ve sitemap kaydıdır. Google, link'leri yalnızca href attribute'u olan <a> element'lerinden keşfedebildiğini açıkça yazıyor; onclick ile yönlenen bir div keşif için link değildir.
Keşfedilen URL bir crawl queue'ya girer. Hangi sitenin ne sıklıkla ve kaç sayfasının indirileceğine Googlebot'un algoritmaları karar verir. Burada iki şey seni doğrudan ilgilendirir:
- Googlebot URL'yi istemeden önce robots.txt'e bakar. Disallow edilmiş bir URL indirilmez; giriş (login) gerektiren sayfalar da crawl edilmez.
- Googlebot sunucunun cevaplarına göre hızını ayarlar. Google'ın örneği net: HTTP (Hypertext Transfer Protocol) 500 hataları "yavaşla" demektir. Sürekli 5xx veya 429 dönen bir sunucu, crawl edilen sayfa sayısını kendi eliyle düşürür.
Googlebot'un iki türü var: Googlebot Smartphone ve Googlebot Desktop. Google çoğu sitede mobil sürümü index'lediği için isteklerin çoğu mobil crawler'dan gelir. İkisi aynı robots.txt token'ına uyduğu için robots.txt ile yalnızca birini hedefleyemezsin. robots.txt'in kurallarını ve hangi durumda engellenmiş bir URL'nin yine de sonuçlarda görünebildiğini Teknik SEO serisinin "robots.txt Rehberi" yazısı ayrıntılı anlatıyor.
Rendering: Googlebot JavaScript'i Ne Zaman Çalıştırır?
İndirilen HTML, link'leri ve içeriği için ayrıştırılır. JavaScript ile içerik üreten sayfalar için bir adım daha var: 200 dönen sayfalar render queue'ya alınır ve kaynak müsait olduğunda Google'ın WRS'i (Web Rendering Service) sayfayı evergreen, yani sürekli güncel tutulan bir Chromium ile render eder. Google, sayfanın bu queue'da "birkaç saniye" kalabileceğini ama daha uzun da sürebileceğini söylüyor.
Bu adımın üç pratik sonucu var. Birincisi, status code 200 değilse rendering atlanabilir; 404 sayfanın içinde JavaScript ile ne gösterdiğin önemsizleşir. İkincisi, ilk HTML'de noindex varsa Google rendering'i ve JavaScript çalıştırmayı atlayabilir; JavaScript ile sonradan kaldırılan bir noindex'e güvenme. Üçüncüsü, WRS stateless çalışır: istekler arasında local storage ve session verisini temizler, görsel ve video istemez, yalnızca crawler'ın gerçekten indirdiği JavaScript'i çalıştırabilir. CSR (Client-Side Rendering), SSR (Server-Side Rendering) ve Angular SSR tarafını Teknik SEO serisinin "JavaScript SEO" ve "Angular SSR ile SEO" yazılarına bırakıyorum; burada aklında kalması gereken şu: kritik içerik ilk HTML'de olursa bu adımın riski küçülür.
2 MB Sınırı: Googlebot Bir Dosyanın Ne Kadarını Okur?
Google, crawler dokümantasyonundaki sınırları Şubat 2026'da netleştirdi, 31 Mart 2026'daki "Inside Googlebot" yazısıyla da ayrıntılandırdı. Google Search için Googlebot desteklenen bir dosya tipinin ilk 2 MB'ını, PDF'in ilk 64 MB'ını indirir. Sınır sıkıştırılmamış veriye uygulanır ve response header'larını da kapsar. Sınırı geçen sayfa reddedilmez; indirme kesilir ve ilk 2 MB tam dosyaymış gibi indexing'e ve WRS'e gönderilir. Kesimden sonraki byte'lar ne indirilir, ne render edilir, ne index'lenir. Sayfanın referans verdiği CSS (Cascading Style Sheets) ve JavaScript dosyaları ayrı ayrı indirilir ve her birinin kendi sayacı vardır. Limit belirtmeyen diğer Google crawler'ları için varsayılan 15 MB.
Baştaki soruyu ölçelim. Bookstore'un kitap sayfası bütün yorumları <head>'e gömüyordu:
// bütün yorumlar sayfaya gömülüyor, bazı SSR uygulamalarının state'i gibi
var reviews = Enumerable.Range(1, 9_000)
    .Select(i => new { id = i, rating = i % 5 + 1, text = $"Review {i}: " + new string('x', 180) });
InlineReviewState = JsonSerializer.Serialize(reviews);
Sayfayı Googlebot gibi gzip isteyerek indiren, sonra açıp kritik işaretlerin kaçıncı byte'ta olduğunu bulan küçük bir .NET 10 file-based app yazdım:
using System.Globalization;
using System.IO.Compression;
using System.Net;
using System.Text;

CultureInfo.CurrentCulture = CultureInfo.InvariantCulture;

// Google "2MB" diyor ve response header'larını da sayıyor; bu yüzden payı bırakıyoruz.
const int CrawlLimit = 2_000_000;
string url = args[0];
string[] markers = ["<title>", "rel=\"canonical\"", "<h1>", "id=\"reviews\""];

using HttpClient http = new(new HttpClientHandler { AutomaticDecompression = DecompressionMethods.None });
http.DefaultRequestHeaders.AcceptEncoding.ParseAdd("gzip");

using HttpResponseMessage response = await http.GetAsync(url);
byte[] transferred = await response.Content.ReadAsByteArrayAsync();
byte[] body = response.Content.Headers.ContentEncoding.Contains("gzip")
    ? await GunzipAsync(transferred)
    : transferred;

Console.WriteLine($"Status:        {(int)response.StatusCode}");
Console.WriteLine($"Transferred:   {transferred.Length,12:N0} bytes (gzip)");
Console.WriteLine($"Uncompressed:  {body.Length,12:N0} bytes");

foreach (string marker in markers)
{
    int offset = body.AsSpan().IndexOf(Encoding.UTF8.GetBytes(marker));
    string verdict = offset < 0 ? "missing" : offset < CrawlLimit ? "inside limit" : "PAST LIMIT";
    Console.WriteLine($"{marker,-20} at {offset,12:N0}  {verdict}");
}

static async Task<byte[]> GunzipAsync(byte[] data)
{
    using GZipStream gzip = new(new MemoryStream(data), CompressionMode.Decompress);
    using MemoryStream output = new();
    await gzip.CopyToAsync(output);
    return output.ToArray();
}
dotnet run HtmlSizeCheck.cs -- http://localhost:5481/books/modeling-bounded-contexts ile çalıştırınca gerçek çıktı:
Status:        200
Transferred:         83,836 bytes (gzip)
Uncompressed:     2,032,603 bytes
<title>              at          150  inside limit
rel="canonical"      at          331  inside limit
<h1>                 at    2,032,320  PAST LIMIT
id="reviews"         at    2,032,474  PAST LIMIT
Cevap: title ve canonical sınırın içinde, ama kitabın adı ve açıklaması 2 MB'ın ötesinde. Ağdan geçen 84 KB seni yanıltıyor; Google sıkıştırılmamış boyuta bakıyor. Düzeltme, yorumların yalnızca ilk sayfasını HTML'e koyup gerisini sayfalamak:
// HTML'e yalnızca yorumların ilk sayfası giriyor, gerisi sayfalanıyor
var reviews = Enumerable.Range(1, 20)
Status: 200
Transferred: 750 bytes (gzip)
Uncompressed: 5,239 bytes
<title> at 150 inside limit
rel="canonical" at 331 inside limit
<h1> at 4,956 inside limit
id="reviews" at 5,110 inside limitAbartma da: Google, web'in büyük çoğunluğu için 2 MB'lık bir HTML'in bu sınıra hiç yaklaşmayacağı kadar büyük olduğunu söylüyor. Riskli olanlar inline base64 görseller, sayfaya gömülü dev state JSON'ları ve devasa inline CSS/JavaScript. Google'ın tavsiyesi de buna göre: ağır CSS ve JavaScript'i harici dosyalara taşı, title, meta tag'ler, canonical ve structured data gibi kritik element'leri HTML'in üst kısmında tut. Sınırın zamanla değişebileceğini de ayrıca not ediyor.
Indexing: Duplicate Cluster ve Canonical Seçimi
Render edilen sayfa analiz edilir: metin, <title>, alt attribute'ları, görseller, videolar. Sonra kritik bir adım gelir: Google benzer içerikli sayfaları bir cluster'da toplar ve içlerinden en temsil edici olanı canonical seçer. Sonuçlarda görünebilecek olan canonical sayfadır; diğerleri alternatif sürümlerdir ve başka bağlamlarda, örneğin mobil cihazda, sunulabilir. Google canonical sayfa hakkında dil, hedeflenen ülke ve sayfanın kullanılabilirliği gibi sinyalleri de toplayıp index'e yazar.
Bookstore için bunun anlamı şu: /books/modeling-bounded-contexts, /books/modeling-bounded-contexts?utm_source=newsletter ve /Books/Modeling-Bounded-Contexts Google için üç ayrı URL ama büyük ihtimalle tek cluster. Hangisinin canonical olacağına sen rel="canonical", redirect'ler, sitemap ve iç link'lerle oy verirsin; son kararı Google verir. Bu oy verme mekaniği Teknik SEO serisinin "Canonical URL" yazısının konusu.
Google'ın kendi sözleriyle: index'lenmek garanti değildir; Google'ın işlediği her sayfa index'lenmez. En sık nedenler düşük kaliteli içerik, index'lemeyi engelleyen robots meta kuralları ve index'lemeyi zorlaştıran site tasarımı.
Serving: Sorgu Geldiğinde Ne Olur?
Kullanıcı arama yaptığında Google index'te eşleşen sayfaları arar ve en alakalı, en kaliteli bulduklarını döner. Alaka yüzlerce faktöre bağlıdır; Google bunlardan kullanıcının konumunu, dilini ve cihazını açıkça sayıyor. Aynı sorgu İstanbul'da ve Berlin'de farklı sonuç verebilir. Sorguya göre sonuç sayfasındaki özellikler de değişir: bir sorguda yerel sonuçlar, başka birinde görsel sonuçlar çıkar. Google sıralamayı yükseltmek için ödeme kabul etmediğini de aynı sayfada yazar.
Index'lenmiş bir sayfa yine de hiç görünmeyebilir. Google'ın saydığı nedenler: içerik sorguyla alakasız, kalite düşük veya robots meta kuralları gösterimi engelliyor. Ranking system'lerin ne yaptığını serinin üçüncü yazısında, sonuç sayfasındaki görünümü (title link, snippet) dördüncü yazısında açacağız.
mertozen.com'daki Bir Yazının Yolculuğu
Teoriyi bu sitenin kendi kaynak koduyla bağlayalım. mertozen.com bir ASP.NET Core uygulaması ve yazılar Razor ile sunucuda render ediliyor. Bir yazı yayınlandığında süreç şöyle işliyor:
Keşif: SeoController'daki /sitemap.xml endpoint'i her yazı için iki <url> kaydı üretiyor, biri TR, biri /en/ altındaki EN adresi için; ikisi de hreflang="tr", hreflang="en" ve x-default alternate'lerini taşıyor. lastmod, yazının yayın veya düzenlenme tarihinden hangisi yeniyse o. robots.txt'in son satırı da sitemap'i gösteriyor. Ayrıca yazı, ana sayfadaki ve blog listesindeki gerçek <a href> link'lerinden de keşfedilebiliyor.
Crawl ve render: robots.txt herkese Allow: / diyor. İçerik Razor ile sunucuda üretildiği için yazının metni ilk HTML'de; WRS'in JavaScript çalıştırmasına bağlı değil. Bu, rendering aşamasının riskini neredeyse sıfırlıyor.
Index: her sayfa kendi canonical'ını <link rel="canonical"> ile veriyor; TR yazının canonical'ı kendi adresi, EN yazınınki /en/blog/... adresi. Google bu oyu dikkate alır ama son seçimi kendisi yapar; seçtiği canonical'ı Search Console'daki URL Inspection aracında "Google-selected canonical" olarak görürsün.
Serving: yazı index'e girdikten sonra hangi sorguda, hangi sırada çıkacağı artık içeriğin kendisine ve sorguya bağlı. Sitenin elindeki tek dürüst ölçüm Search Console'un Performance raporu; ona serinin beşinci yazısında bakacağız.
Üretimde Dikkat
Sayfa boyutunu sıkıştırılmamış hâliyle izle. Yukarıdaki araç CI'da (Continuous Integration) en önemli birkaç sayfa şablonuna karşı çalışabilir; bir şablon 1 MB'ı geçtiğinde uyarı vermek, 2 MB'a dayanmadan haber almanın en ucuz yolu.
5xx ve 429 oranını izle. Crawl hızını belirleyen sinyallerden biri senin sunucunun sağlığı. Deploy sırasında birkaç dakika 503 dönmek felaket değil, ama günlerce süren yüksek hata oranı Googlebot'u yavaşlatır.
Kritik içeriği ilk HTML'de tut. Render queue gecikmesi, stateless WRS ve 2 MB sınırı aynı sonuca çıkıyor: ana içerik, title, canonical ve link'ler sunucudan gelen HTML'de, mümkün olduğunca üstte olmalı.
Sık Düşülen Tuzaklar
"Sitemap'e koydum, index'lenir" sanmak. Sitemap keşif içindir; index'lemeyi garanti etmez. Google'ın ifadesi açık: uygun olmak garanti değildir.
Gzip'li boyuta bakmak. DevTools'un Network sekmesindeki transfer boyutu sıkıştırılmış hâldir. Googlebot'un sınırı açılmış veriye uygulanır; ölçümümüzde 84 KB'lık transfer 2 MB'lık bir HTML'di.
robots.txt ile index'ten çıkarmaya çalışmak. robots.txt crawl'ı engeller, index'lemeyi değil. Engellenen bir URL'nin içeriği okunamadığı için oradaki noindex de görülmez. Doğru araç noindex ve crawl'a izin vermek.
JavaScript'te link üretmek. <a href> olmayan navigasyon, crawler'ın keşif yolunu kapatır.
Küçük Bir Deneme
★☆☆ Kendi projendeki en ağır sayfa şablonunu HtmlSizeCheck.cs ile ölç. Transfer ve sıkıştırılmamış boyut arasındaki oran kaç?
★★☆ Aracı genişlet: <head> içindeki inline <script> ve <style> bloklarının toplam byte'ını ayrıca raporlasın. Sayfanın ne kadarının içerik, ne kadarının gömülü kod olduğunu gör.
★★★ Sitemap'teki bütün URL'leri sırayla okuyup her biri için status code'u ve sıkıştırılmamış boyutu raporlayan bir sürüm yaz; 1 MB'ı geçen ve 200 dönmeyen URL'leri ayrı listele. Yalnızca kendi yerel ortamına karşı çalıştır.
Artık bir sayfanın hangi aşamada takılabileceğini biliyoruz. Bir sonraki yazıda Google'ın bu sürecin kurallarını yazdığı belgeye, Search Essentials'a bakacağız: technical requirement'lar, spam policy'leri ve 2026'da eklenen back button hijacking gibi yeni kurallar.