

Release Planning: Aralıklı Velocity, Burn-up, Sabit Tarih mi Sabit Kapsam mı?
Release tarihi tek bir velocity ortalamasından değil, geçmiş sprint'lerden çıkan bir aralıktan verilir; tarih sabitse kapsam MoSCoW katmanlarıyla esnetilir. Bookstore'un 130 point'lik Kurumsal Sipariş planı 12 Şubat ile 12 Mart arasına düşüyor; 1 Mart'ta Must kapsamı kötü senaryoda bile sığıyor. Aynı soruyu Monte Carlo ile de cevaplayıp iki yöntemin neden farklı sonuç verdiğini görüyoruz.
Sürüm notu: Bu yazıdaki release planı ve Monte Carlo kodu .NET 10 ile derlenip çalıştırılmıştır; velocity'nin Scrum içindeki anlamı için Scrum Guide 2020 esas alınmıştır.
Önce Tahmin Et
20 Kasım cuma. Kurumsal Sipariş'in Release 1 backlog'u boyutlandırıldı: 30 story, 130 point. Sitedeki serilerin ortak örnek uygulaması Bookstore'un (bir online kitapçı) ekibi pazartesi Sprint 24'e başlıyor ve sprint'ler iki hafta. Son 10 sprint'in velocity'leri şöyle: 21, 17, 24, 19, 14, 22, 20, 23, 18, 22. Ortalama tam 20.
Hesap kolay görünüyor: 130 / 20 = 6,5, yukarı yuvarlayınca 7 sprint. Yedinci sprint 26 Şubat cuma günü bitiyor; Hakan'ın 1 Mart hedefine üç gün kala. Selin bu tarihi Hakan'a söylemeli mi? Söylerse, sence tutma olasılığı ne: %50 mi, %70 mi, %90 mı? Ve 1 Mart pazarlık konusu değilse, yani okulun siparişi o gün başlayacaksa, ekip neyi değiştirebilir?
Velocity Tek Sayı Değil
Velocity, ekibin bir sprint'te Done'a getirdiği işin point toplamı. Scrum Guide velocity'den söz etmez; Sprint Planning için yalnızca Developers'ın geçmiş performansını bilmesinin forecast'e güveni artırdığını söyler. Velocity'nin bir sprint içinde neyi gösterip neyi göstermediği Scrum serisinin "Scrum'da Metrikler: Velocity, Burndown ve Sprint Goal Başarısı Neyi Gösterir, Neyi Göstermez?" yazısında. Bu yazıda velocity'yi tek bir amaçla kullanıyoruz: birkaç sprint sonrasını kabaca öngörmek.
Bookstore'un velocity'si 14 ile 24 arasında oynuyor. Ortalamayı kullanmak, bütün sprint'lerin ortalama gideceğini varsaymak demek; ilk yazıda gördüğümüz tek sayı sorununun aynısı. Mike Cohn, Agile Estimating and Planning kitabında ve sunumlarında velocity'yi belirsizliğe uygun bir aralık olarak ifade etmeyi önerir: backlog toplamını yüksek velocity'ye bölünce en kısa, düşük velocity'ye bölünce en uzun süre çıkar.
Aralığın uçlarını seçmenin birçok yolu var. En düşük ve en yüksek tek sprint'i almak aralığı tek bir sıra dışı sprint'e bağlar; Sprint 18'deki 14, büyük bir story'nin sprint sonuna yetişmemesinden geliyordu. Biz en kötü üç sprint'in ortalamasını, genel ortalamayı ve en iyi üç sprint'in ortalamasını kullanıyoruz. Bu bir istatistik formülü değil, bilinçli bir seçim: kötü bir dönemin nasıl göründüğünü tek bir sprint'e değil, üç sprint'e bakarak söylüyor.
Kod: Aralıklı Release Planı
İkinci yazıda yazdığımız SprintHistory sınıfını aynen kullanıyoruz. Yeni sınıf üç soruya cevap veriyor: kapsam sabitse hangi tarih aralığı, tarih sabitse hangi kapsam, ve aynı soruya akış bakışıyla, yani Monte Carlo ile ne cevap çıkıyor?
namespace Bookstore.Planning;

public static class ReleasePlan
{
    public static readonly DateOnly FirstSprintStart = new(2026, 11, 23); // Sprint 24, pazartesi
    public static readonly DateOnly Target = new(2027, 3, 1);

    // n. sprint'in son iş günü (2 haftalık sprint, cuma biter)
    public static DateOnly SprintEnd(int n) => FirstSprintStart.AddDays(14 * (n - 1) + 11);

    public static (double Low, double Mean, double High) VelocityRange(Sprint[] history)
    {
        List<int> v = [.. history.Select(s => s.Velocity).Order()];
        return (v.Take(3).Average(), v.Average(), v.TakeLast(3).Average());
    }

    public static void Run()
    {
        Sprint[] history = SprintHistory.Last10;
        int scope = SprintHistory.Release1.Sum();
        (double low, double mean, double high) = VelocityRange(history);

        Console.WriteLine($"Scope: {scope} points. Velocity range (last {history.Length} sprints): worst-3 {low:F1}, mean {mean:F1}, best-3 {high:F1}");
        foreach ((string name, double v) in new[] { ("worst-3", low), ("mean", mean), ("best-3", high) })
        {
            int sprints = (int)Math.Ceiling(scope / v);
            Console.WriteLine($"  {name,-8} {sprints} sprints -> done by {SprintEnd(sprints):yyyy-MM-dd}");
        }

        // Sabit tarih: 1 Mart'tan önce biten sprint sayısı ve sığan kapsam
        int fixedSprints = Enumerable.Range(1, 20).Last(n => SprintEnd(n) < Target);
        (string Name, int Points)[] moscow = [("Must", 96), ("Should", 22), ("Could", 12)];
        Console.WriteLine();
        Console.WriteLine($"Fixed date {Target:yyyy-MM-dd}: {fixedSprints} sprints (last ends {SprintEnd(fixedSprints):yyyy-MM-dd})");
        foreach ((string name, double v) in new[] { ("worst-3", low), ("mean", mean), ("best-3", high) })
        {
            double capacity = fixedSprints * v;
            int cumulative = 0;
            string fits = string.Join(", ", moscow.TakeWhile(m => (cumulative += m.Points) <= capacity).Select(m => m.Name));
            Console.WriteLine($"  {name,-8} ~{capacity:F0} points -> {fits}");
        }

        // Akış bakışı: geçmiş sprint'lerden örneklem alan Monte Carlo (seed sabit)
        const int Runs = 10_000;
        Random rng = new(2026);
        int stories = SprintHistory.Release1.Length;
        List<int> byPoints = [.. Enumerable.Range(0, Runs).Select(_ => SprintsUntil(scope, () => history[rng.Next(history.Length)].Velocity)).Order()];
        List<int> byCount = [.. Enumerable.Range(0, Runs).Select(_ => SprintsUntil(stories, () => history[rng.Next(history.Length)].Throughput)).Order()];

        Console.WriteLine();
        Console.WriteLine($"Monte Carlo, {Runs:N0} runs: sprints needed (finish date)");
        Console.WriteLine($"  {"",4} {"by points (130)",-24} {"by count (30 stories)",-24}");
        foreach (int p in new[] { 50, 85, 95 })
        {
            int a = Stats.Percentile(byPoints, p), b = Stats.Percentile(byCount, p);
            Console.WriteLine($"  p{p}  {a} ({SprintEnd(a):yyyy-MM-dd}){"",8} {b} ({SprintEnd(b):yyyy-MM-dd})");
        }
        Console.WriteLine($"  P(done before {Target:yyyy-MM-dd}): by points {byPoints.Count(s => s <= fixedSprints) * 100.0 / Runs:F0}%, by count {byCount.Count(s => s <= fixedSprints) * 100.0 / Runs:F0}%");
    }

    static int SprintsUntil(int remaining, Func<int> nextSprint)
    {
        int sprints = 0;
        while (remaining > 0)
        {
            remaining -= nextSprint();
            sprints++;
        }
        return sprints;
    }
}
VelocityRange ve SprintEnd public, çünkü altıncı yazıda planı güncellerken onları yeniden kullanacağız. Program.cs'e case "release": ReleasePlan.Run(); break; satırını ekleyip çalıştırıyoruz:
dotnet run --project src/Bookstore.Planning -- releaseScope: 130 points. Velocity range (last 10 sprints): worst-3 16.3, mean 20.0, best-3 23.0
worst-3 8 sprints -> done by 2027-03-12
mean 7 sprints -> done by 2027-02-26
best-3 6 sprints -> done by 2027-02-12
Fixed date 2027-03-01: 7 sprints (last ends 2027-02-26)
worst-3 ~114 points -> Must
mean ~140 points -> Must, Should, Could
best-3 ~161 points -> Must, Should, Could
Monte Carlo, 10,000 runs: sprints needed (finish date)
by points (130) by count (30 stories)
p50 7 (2027-02-26) 6 (2027-02-12)
p85 7 (2027-02-26) 7 (2027-02-26)
p95 8 (2027-03-12) 7 (2027-02-26)
P(done before 2027-03-01): by points 91%, by count 99%Çıktıyı Okumak
Velocity aralığı 16,3, 20,0 ve 23,0. Kapsam sabitse Release 1 en iyi senaryoda 6 sprint sürüp 12 Şubat'ta, ortalama senaryoda 7 sprint sürüp 26 Şubat'ta, kötü senaryoda 8 sprint sürüp 12 Mart'ta bitiyor. Hakan'a söylenecek cümle "26 Şubat" değil, "12 Şubat ile 12 Mart arası" olmalı. 1 Mart bu aralığın içinde, ama ortalama senaryonun yalnızca üç gün ötesinde.
Bu hesaba iki şey girmiyor. İlki takvim: Sprint 26, 21 Aralık ile 1 Ocak arasında ve yılbaşına denk geliyor; izinler o sprint'in kapasitesini düşürecek. Kapasite hesabı Scrum serisinin "Sprint ve Sprint Planning: Why, What, How ve Sprint Goal" yazısında; burada bunu beşinci yazıdaki risk listesine bir kalem olarak yazacağız. İkincisi kapsam değişimi: 130 point bugünkü bilgimiz, ve ilk yazıdaki koniye göre requirement'lar henüz tamamlanmadı. Kapsamın büyümesi neredeyse kesin.
Burn-up: Kapsam Çizgisi Ayrı Dursun
Release planını göstermenin en iyi yolu bir burn-up grafiği. Burndown kalan işi gösterir; kapsam büyüdüğünde çizgi yukarı sıçrar ya da hiç inmiyormuş gibi görünür ve izleyen kişi ekibin mi yavaşladığını, kapsamın mı büyüdüğünü ayırt edemez. Burn-up'ta ise iki ayrı çizgi var: biten iş ve toplam kapsam. Ekip yavaşlarsa birinci çizginin eğimi azalır; kapsam büyürse ikinci çizgi yükselir. İkisini ayrı görmek, altıncı yazıda konuşacağımız "plan neden kaydı?" sorusunun cevabını grafiğin kendisine koyar.
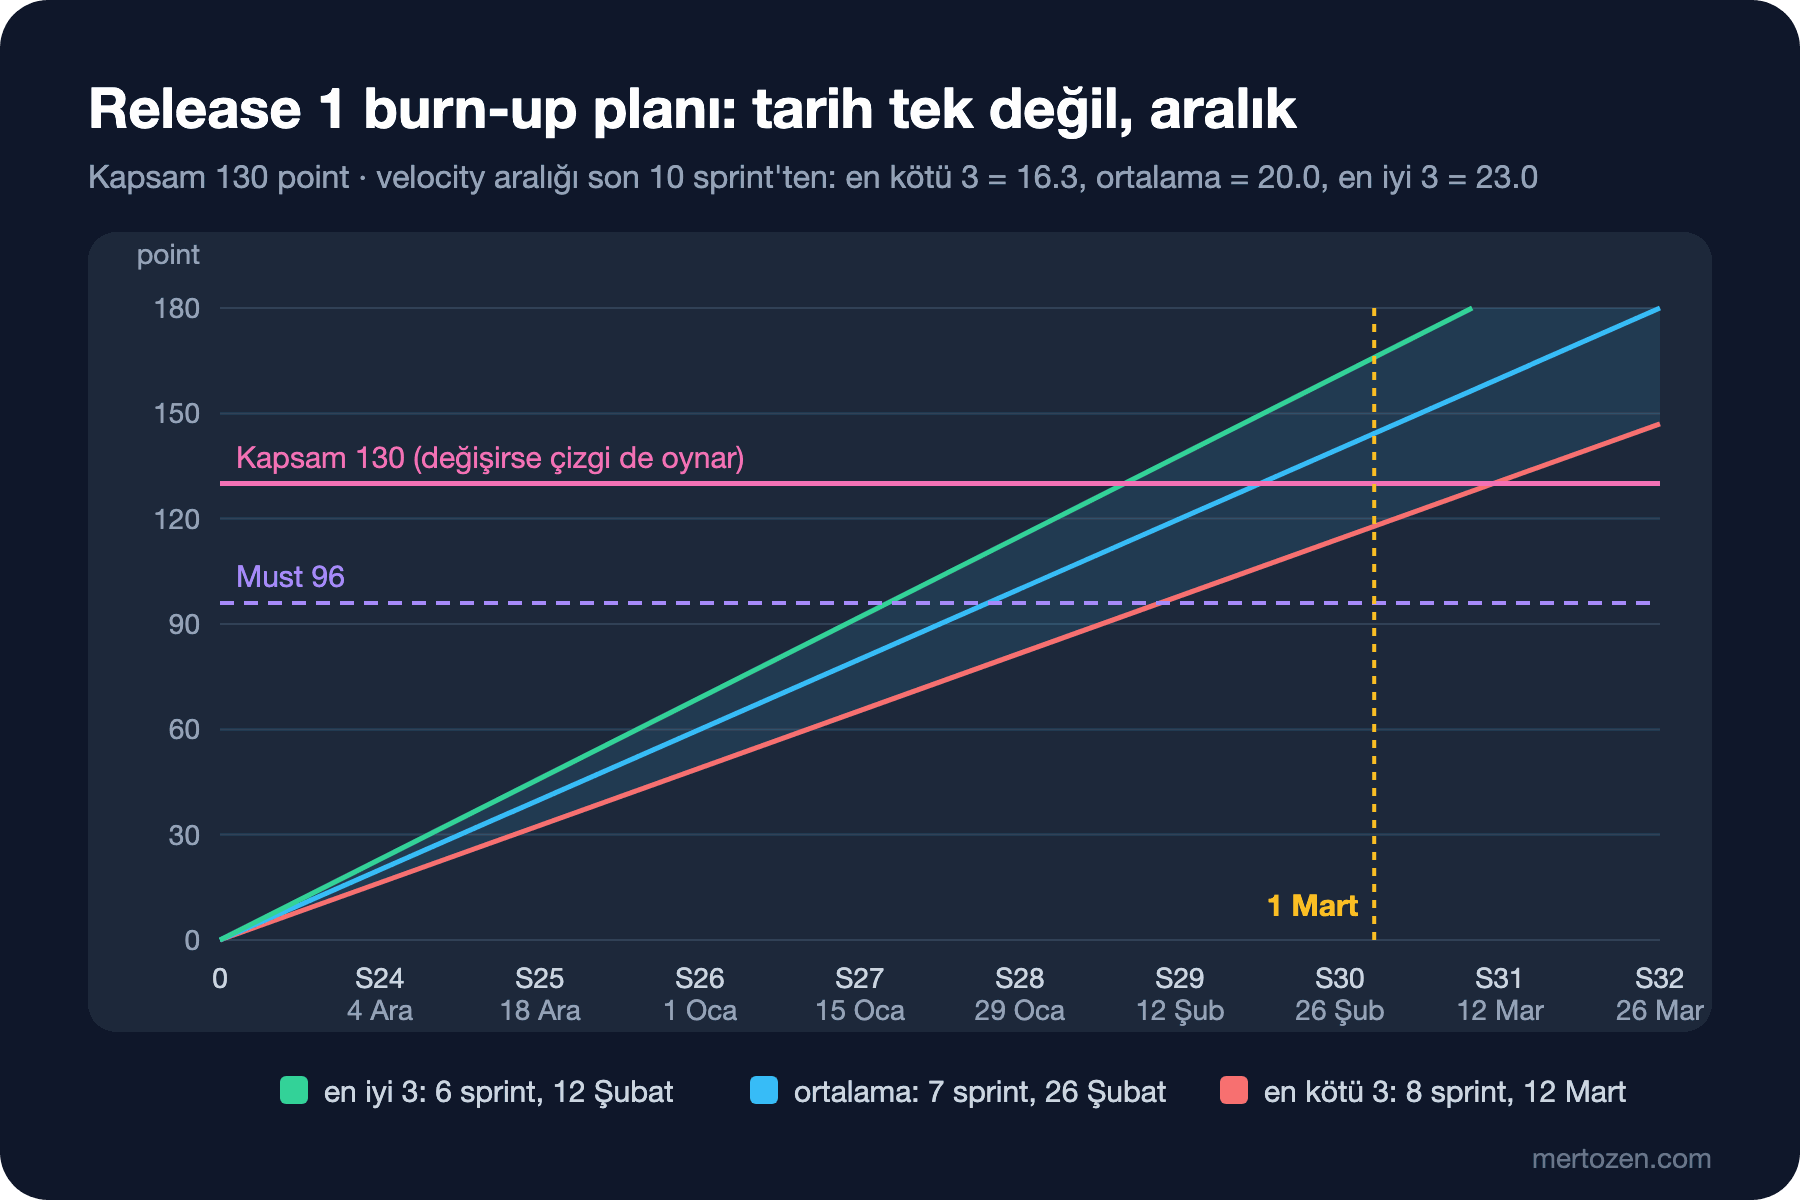
Grafikte tek bir tahmin çizgisi yok; en kötü üç, ortalama ve en iyi üç sprint'in velocity'siyle çizilmiş üç çizgi ve aralarında bir yelpaze var. Pembe kapsam çizgisinin yelpazeyi kestiği bölge tarih aralığı. Mor kesikli çizgi Must kalemlerinin toplamı; bir sonraki bölümün konusu. Her sprint sonunda gerçek biten iş grafiğe bir nokta olarak eklenir ve noktaların yelpazenin hangi kenarına yakın durduğu, tarih hakkında herhangi bir toplantıdan daha çok şey söyler.
Sabit Tarih mi, Sabit Kapsam mı?
Proje üçgeninin köşeleri kapsam, tarih ve kaynaktır; kaliteyi de dördüncü bir köşe olarak sayanlar var. Pratikte bir release planında aynı anda en fazla birini sabitleyebilirsin. Agile ekipler genellikle kaynağı (ekibi) ve tarihi sabit tutup kapsamı esnetir; bu tartışmanın sözleşme tarafı Agile Mindset serisinin "Agile ve Gerçek Dünya: Sabit Fiyatlı Sözleşme, Deadline ve Mimari Kararlar" yazısında.
Bookstore'da 1 Mart okulun takviminden geliyor ve değişmiyor. Bu durumda soru "ne zaman biter?" değil, "1 Mart'a kadar ne biter?" olur. Kodun ikinci bloğu bunu cevaplıyor: 1 Mart'tan önce 7 sprint bitiyor. Kötü senaryoda bu 7 sprint'e yaklaşık 114 point, ortalamada 140, iyi senaryoda 161 point sığıyor.
Selin bunun için backlog'u MoSCoW (Must have, Should have, Could have, Won't have; olmazsa olmaz, olmalı, olabilir, bu sefer olmayacak) ile sınıflandırdı. Must kalemleri 96 point: kurum hesabı, liste yapıştırma ve doğrulama, kitap adıyla eşleştirme, kurumsal indirim, teslimat noktaları, satın alma emri numarasıyla sipariş ve muhasebeye giden günlük fatura raporu. Should 22 point: taslak kaydetme, Excel dosyasından yükleme ve sipariş onay e-postası. Could 12 point: geçmiş siparişi tekrar verme ve sipariş listesini dışa aktarma. Önceliklendirme yöntemlerinin kendisi, RICE (erişim, etki, güven ve efora dayalı bir puanlama) ve Cost of Delay dahil, Product Management'a Giriş serisinin "Prioritization Framework'leri: RICE, MoSCoW, Kano ve Cost of Delay" yazısında.
Çıktıya göre Must kalemleri kötü senaryoda bile sığıyor; Should ve Could ise ortalama ve iyi senaryoda sığıyor. Ekibin Hakan'a verebileceği taahhüt artık bir tarih değil, kapsamın katmanlarıdır: "1 Mart'ta Must kapsamı kesin. Should kalemleri büyük ihtimalle yetişir; yetişmezse mart ortasında gelir. Could kalemleri için söz vermiyoruz." Bu cümlede gizli bir ped yok: Should ve Could kalemleri, işler kötü giderse ilk düşecek kalemler olarak herkesin gözü önünde duruyor. Görünür buffer budur.
MoSCoW'un işe yaraması için Must listesinin gerçekten küçük tutulması gerekiyor. MoSCoW'u yaygınlaştıran DSDM (Dynamic Systems Development Method; 1990'larda ortaya çıkan bir agile proje yönetimi çerçevesi) bugün Agile Business Consortium tarafından sürdürülüyor ve Must kalemlerinin toplam eforun genellikle %60'ını geçmemesini öneriyor; daha yüksek bir oran ancak tahminler çok güvenilirse makul. Bookstore'da Must 130 point'in %74'ü ve kötü senaryodaki 114 point'lik kapasitenin %84'ü. Bu oranla ekip aslında sabit kapsamlı bir taahhüde yaklaşıyor ve esneklik azalıyor. Selin'in bir-iki Must kalemini daha Should'a indirip indiremeyeceğini sorması yerinde olur.
Kapsam sabit olsaydı, yani okul tam kapsam olmadan portala geçmeyecek olsaydı, cevap tarih aralığı olurdu: "12 Şubat ile 12 Mart arası, en olası 26 Şubat." Bu durumda 1 Mart'ı tutturmanın yolu kapsamdan değil, riskten geçer: belirsiz işleri öne çekip aralığı erken daraltmak. Bunu beşinci yazıda konuşacağız.
Akış Bakışı: Monte Carlo ile Aynı Soru
Kodun son bloğu aynı soruyu Kanban serisinin "Service Level Expectation ve Monte Carlo" yazısındaki yöntemle cevaplıyor: geçmişteki bir sprint'i rastgele seçip onun velocity'sini ya da bitirdiği story sayısını kullanmak, kapsam bitene kadar devam etmek ve bunu 10.000 kez tekrarlamak. Point'e göre %85 olasılıkla 7 sprint, %95 olasılıkla 8 sprint; 1 Mart'tan önce bitme olasılığı %91. Story sayısına göre bu olasılık %99.
Monte Carlo, en kötü üç sprint'in ortalamasına göre çok daha iyimser. Nedeni şu: simülasyon her sprint'i bağımsız çekiyor ve 7–8 sprint boyunca kötü ve iyi sprint'ler birbirini dengeliyor. En kötü üç sprint'in ortalamasıyla hesap yapmak ise yedi sprint'in hepsinin kötü gideceğini varsayıyor; bağımsız sprint'lerde bu çok düşük bir olasılık. Hangisi gerçeğe daha yakın? Sprint'ler gerçekten birbirinden bağımsızsa Monte Carlo. Ama yılbaşı haftası, bir kişinin uzun izni ya da büyüyen kapsam gibi nedenler birkaç sprint'i birlikte etkiler. Monte Carlo'nun %91'i, kapsamın 130'da kaldığını ve önümüzdeki sprint'lerin geçmiş on sprint'e benzeyeceğini varsayıyor. İkisi de bu planda tartışmalı.
Story sayısına dayalı simülasyonun daha da iyimser olması ikinci yazıdaki bulgunun devamı: Release 1'in story'leri ekibin geçmiş ortalamasından büyük. Sayma yöntemi bu farkı görmüyor.
İki yöntemi birlikte kullanmak en dürüst yol. Monte Carlo, kapsam ve ekip koşulları geçmişe benzerse olasılığın ne olduğunu söylüyor; velocity aralığı ise koşullar kötüleşirse tarihin nereye gidebileceğini gösteriyor. Hakan'a giden notta ikisi birlikte duruyor: "Kapsam değişmezse 1 Mart'a yetişme olasılığımız %90 civarında; ama kapsam büyürse ya da birkaç sprint üst üste kötü giderse 12 Mart'a kayabilir. Must kapsamı her iki durumda da 1 Mart'ta hazır."
Tarihli Plan ile Outcome Roadmap'in Buluşması
Product Management'a Giriş serisinin "Roadmap Hazırlamak: Feature Takvimi Yerine Now-Next-Later ve Outcome Roadmap'leri" yazısında tarihli feature roadmap'lerinin sorunlarını konuştuk. Release planı bununla çelişmiyor. Now-Next-Later roadmap'inde Kurumsal Sipariş "Now" sütununda; burada bir tarih aralığı ve kapsam katmanları var, çünkü dışarıdan gelen gerçek bir tarih var ve kararlar ona bağlı. "Next" ve "Later" sütunlarındaki işler için ise tarih vermiyoruz: onlar ilk yazıdaki koninin en geniş yerinde.
Release 1'in amacı da roadmap'teki outcome'a bağlı: okulların e-postayla gönderdiği listeleri müşteri hizmetlerinden Gül'ün elle girmesine gerek kalmaması. Kapsam katmanlarını konuşurken bu cümle bir filtre işlevi görüyor. Must listesindeki her kalem için "bu olmadan Gül yine elle giriş yapar mı?" sorusu soruluyor; cevap hayırsa kalem Should'a iniyor.
Üretimde Dikkat
Burn-up'ı her sprint sonunda güncelle ve aynı grafiği herkese göster. Grafiği yalnızca kötü haber olduğunda açan bir ekip, grafiği bir alarm aracına çevirir. Her Sprint Review'da yelpazeyi, gerçek noktaları ve kapsam çizgisini birlikte göstermek, altıncı yazıda konuşacağımız sürpriz olmayan güncellemenin temeli.
Velocity aralığını kayan bir pencereyle hesapla. Son 10 sprint, ekip ya da iş türü değiştiğinde eski bilgiyi taşır. Ekibe yeni biri katıldıysa ya da teknoloji değiştiyse, değişiklikten sonraki sprint'leri ayrı değerlendir. Yeni bir ekibin hiç geçmişi yoksa birkaç sprint gözlem yapmadan release tarihi çıkarma; geçici olarak geniş bir aralık ver ve her sprint'te daralt.
Point'ler tutarlı değilse velocity aralığı da anlamsızdır. İkinci yazıdaki referans set ve bug kuralı burada karşılığını buluyor: 130 point'in, son 10 sprint'teki point'lerle aynı ölçekte verilmiş olması gerekiyor. Jira gibi bir araçta bu raporların nasıl alındığı Jira ve Proje Araçları serisinin konusu.
Sık Düşülen Tuzaklar
- Velocity'yi sabit sayı gibi kullanmak: "ortalama 20, demek ki 26 Şubat" cümlesi, iki release'ten birinde tutmayacak bir sözdür.
- Yeni ekibin ilk sprint'inden release tarihi çıkarmak: tek bir sprint'in velocity'si ekip hakkında neredeyse hiçbir şey söylemez.
- Burndown ile kapsam değişimini gizlemek: kapsam büyüdüğünde ekip yavaşlamış gibi görünür.
- Must listesini şişirmek: her şey Must olunca sabit tarihli plan sessizce sabit kapsamlı plana dönüşür.
- Monte Carlo'nun olasılığını koşulsuz sunmak: simülasyon, kapsamın ve ekip koşullarının sabit kaldığını varsayar.
- Buffer'ı gizli tutmak: görünür olmayan pay kimse tarafından yönetilemez ve sıkışınca ilk o kaybolur.
Küçük Bir Deneme
★☆☆ VelocityRange'i en kötü ve en iyi üç sprint yerine en kötü ve en iyi iki sprint'le hesapla. Tarih aralığı nasıl değişti?
★★☆ Monte Carlo'ya kapsam büyümesini ekle: her simüle edilen sprint'te kapsama 0 ile 6 arasında rastgele point ekleyen bir satır yaz. 1 Mart'tan önce bitme olasılığı %91'den kaça düştü?
★★★ Sprint 26 için yılbaşı izinlerini modelle: o sprint'te çekilen velocity'yi 0,6 ile çarp. Ardından, sprint'leri bağımsız çekmek yerine art arda gelen üç sprint'i birlikte çeken (geçmişten rastgele bir başlangıç noktası seçip sırayla ilerleyen) bir varyant yaz. İki değişiklik %91'i nasıl etkiledi?
Release planı bir tarih aralığı ve kapsam katmanları verdi, ama aralığın kötü ucunu belirleyen şeyler henüz bir isim almadı: muhasebe entegrasyonu, depo ekibine bağımlılık, yılbaşı izinleri. Bir sonraki yazıda bunları pre-mortem ile ortaya çıkarıp bir risk register'a yazıyoruz ve riski erken azaltmanın plana nasıl girdiğini görüyoruz.