

Load Balancing: L4 ve L7, Algoritmalar, Health Check ve Sticky Session

Load balancer'ın algoritması, bir instance yavaşladığında kullanıcının gördüğü latency'yi belirler: YARP ile yapılan gerçek denemede round robin'de p99 4,6 saniyeye çıkarken LeastRequests ve power of two choices yavaş instance'a trafiği kendiliğinden azaltıp p99'u 300 ms'de tutuyor. Çöken instance'ı ise ancak health check çıkarır (133 hatadan 35'e); L4/L7 farkı, sticky session'ın bedeli, connection draining ve GeoDNS/anycast ile global load balancing de yazıda.
Sürüm notu: Bu yazıdaki kodlar C# 14 ve .NET 10 ile derlenip denenmiştir; load balancer örneği YARP (Yet Another Reverse Proxy) 2.3.0 ile koşturuldu.
Önce Tahmin Et
Bookstore'un katalog API'si (Application Programming Interface) artık üç instance'ta çalışıyor ve önlerinde istekleri sırayla dağıtan bir load balancer var. Her instance bir aramayı 20 ms'de bitiriyor ve aynı anda en fazla 8 isteği işleyebiliyor. Bir gün instance'lardan biri, üzerinde çalıştığı makinedeki başka bir iş yüzünden yavaşlıyor: aynı arama artık 300 ms sürüyor. Diğer ikisi gayet sağlıklı. Load balancer'a saniyede 200 istek geliyor.
Kullanıcıların gördüğü p99 latency kabaca ne olur: 20 ms mi, 300 ms mi, yoksa çok daha kötü bir şey mi? Ve load balancer'ın algoritmasını değiştirmek bunu düzeltir mi?
Load Balancer Ne İş Yapar?
Load balancer (LB), gelen istekleri ya da bağlantıları bir grup sunucuya dağıtan component. Bir önceki yazıda, "Tek Sunucudan Milyonlarca Kullanıcıya: Vertical ve Horizontal Scaling, Stateless Tier"de, uygulama tier'ını stateless yapmıştık; load balancer bu stateless instance'ları dışarıya tek bir adres olarak sunan parça. Üç işi var: yükü dağıtmak, sağlıksız instance'ı trafikten çıkarmak ve instance'ların eklenip çıkarılmasını client'tan gizlemek.
Load balancer'ın kendisi de bir hata noktası. Bu yüzden genelde çift çalışır (active-passive ya da active-active) ya da bulut sağlayıcısının yönetilen bir servisi olarak gelir ve onun availability'si sağlayıcının sorumluluğundadır. Kendi kurduğun tek bir Nginx, arkasındaki üç instance'ın availability kazancını sıfırlar.
L4 ve L7 Load Balancer
Load balancer'lar, OSI (Open Systems Interconnection) modelinin hangi katmanında karar verdiklerine göre ikiye ayrılır:
L4 (Layer 4) load balancer TCP (Transmission Control Protocol) ya da UDP (User Datagram Protocol) seviyesinde çalışır: IP (Internet Protocol) adresine ve port'a bakar, paketin içine bakmaz ve bir bağlantının bütün paketlerini aynı sunucuya gönderir. L7 (Layer 7) load balancer ise HTTP (Hypertext Transfer Protocol) isteğini okur; /api/ ile başlayan istekleri API instance'larına, /images/ ile başlayanları başka bir gruba gönderebilir. Bunun için TLS (Transport Layer Security) bağlantısını sonlandırması gerekir.
| Kriter | L4 (transport katmanı) | L7 (application katmanı) |
|---|---|---|
| Neye bakar | IP adresi ve port, TCP/UDP bağlantısı | HTTP isteği: path, host, header, cookie |
| Neyi dağıtır | Bağlantıları | İstekleri |
| TLS | Genelde dokunmaz, şifreli trafiği iletir | Sonlandırır (TLS termination), içeriği okur |
| Yapabildikleri | Çok hızlı, protokolden bağımsız | Path bazlı routing, retry, header ekleme, sticky cookie |
| Örnekler | Azure Load Balancer, AWS (Amazon Web Services) Network Load Balancer | Azure Application Gateway, AWS Application Load Balancer, Nginx, YARP |
Pratikte en önemli fark şu: L4 bağlantıları dağıtır, istekleri değil. HTTP/2 ya da gRPC gibi uzun ömürlü ve çok istek taşıyan bağlantılarda bir client'ın bütün istekleri tek bir instance'a gider; yeni eklenen instance'lar, mevcut bağlantılar kapanana kadar hiç yük almaz. İstek bazında dengeleme istiyorsan L7 gerekir.
Algoritmalar
Round robin, sırayla bir sonraki instance'ı seçer. Basit ve adil, ama bütün instance'ların ve bütün isteklerin eşit olduğunu varsayar. Weighted round robin, instance'lara ağırlık vererek güçlü makineye daha çok istek gönderir. Least connections (YARP'ta LeastRequests), o an en az aktif isteği olan instance'ı seçer; yavaşlayan bir instance'ta istekler biriktiği için ona kendiliğinden daha az iş gider. Least response time, aktif istek sayısını ölçülen yanıt süresiyle birleştirir.
Power of two choices, rastgele iki instance seçip bunlardan daha az meşgul olana gönderir. Michael Mitzenmacher'ın çalışmasıyla bilinen sonuç şu: tamamen rastgele seçime göre en yoğun sunucudaki yük dramatik biçimde azalıyor, ama bütün instance'ları taramak gerekmiyor. YARP'ın dokümantasyonu bunu varsayılan policy olarak seçmesini aynı gerekçeyle açıklıyor: LeastRequests'in bütün destination'ları inceleme maliyetinden ve Random'ın meşgul bir destination'ı seçme riskinden kaçınmak.
Hash-based algoritmalar ise isteğin bir özelliğinden (client IP'si, kullanıcı id'si, URL (Uniform Resource Locator)) hash alıp hep aynı instance'a gönderir. Amaç yük dengesi değil yakınlık: aynı kullanıcının verisi o instance'ın cache'inde sıcak kalsın. Basit hash % N instance sayısı değişince neredeyse bütün eşleşmeleri bozar; çözümü serinin "Consistent Hashing: Hash Ring, Virtual Node'lar ve C# ile Implementasyon" yazısında.
Google'ın SRE (Site Reliability Engineering) kitabının "Load Balancing in the Datacenter" bölümü iki ayrıntıyı daha hatırlatıyor. Birincisi subsetting: binlerce client'ın binlerce backend'e bağlantı açması bellek ve health check maliyeti yarattığı için her client yalnız bir alt kümeye (genelde 20–100 backend) bağlanıyor ve bu alt kümenin deterministik seçilmesi yükü dengeli tutuyor. İkincisi, "en az aktif istek" sinyalinin tuzağı: hatalı bir backend istekleri çok hızlı reddederse aktif isteği hep az görünür ve trafiği bir kara delik gibi çeker. Kitap bunu sinkholing olarak anlatıyor ve çözüm olarak son hataların da aktif istek gibi sayılmasını öneriyor.
Deneme: Yavaşlayan Bir Instance
Açılıştaki senaryoyu YARP ile kuralım. YARP, Microsoft'un ASP.NET Core üzerine kurulu, açık kaynak reverse proxy library'si; load balancing policy'lerini ve health check'leri konfigürasyonla değiştirebiliyoruz. Önce üç backend instance'ı. Her biri aynı anda en fazla 8 isteği işliyor, fazlası sırada bekliyor:
sealed class BackendInstance(string name, int port, TimeSpan serviceTime)
{
    private readonly SemaphoreSlim _workers = new(8);
    private WebApplication? _app;

    public async Task StartAsync()
    {
        WebApplicationBuilder builder = WebApplication.CreateBuilder();
        builder.WebHost.UseUrls($"http://localhost:{port}");
        builder.Logging.ClearProviders();
        _app = builder.Build();
        _app.MapGet("/health", () => "ok");
        _app.MapGet("/api/books/search", async () =>
        {
            await _workers.WaitAsync();   // kapasite doluysa istek sırada bekler
            try { await Task.Delay(serviceTime); }
            finally { _workers.Release(); }
            return name;
        });
        await _app.StartAsync();
    }

    public Task StopAsync() => _app!.StopAsync();
}
Proxy tarafında cluster'ın policy'si komut satırından geliyor:
ClusterConfig[] clusters =
[
    new()
    {
        ClusterId = "bookstore-api",
        LoadBalancingPolicy = policy,
        Destinations = new Dictionary<string, DestinationConfig>
        {
            ["api-1"] = new() { Address = "http://localhost:5201" },
            ["api-2"] = new() { Address = "http://localhost:5202" },
            ["api-3"] = new() { Address = "http://localhost:5203" },
        },
    },
];
builder.Services.AddReverseProxy().LoadFromMemory(routes, clusters);
Yük üreticisi açık döngü çalışıyor: önceki isteğin bitmesini beklemeden her 5 ms'de bir yeni istek, yani saniyede 200 istek, 3 saniye boyunca 600 istek. Gerçek trafik de böyle gelir; kullanıcılar sistemin yavaşladığını bilip beklemez.
// açık döngü yük: her 5 ms'de bir istek (saniyede ~200), 3 saniye boyunca
for (int i = 0; i < 600; i++)
{
    if (scenario == "crash" && i == 200) _ = backends[2].StopAsync();   // 1. saniyede api-3 çöküyor
    inFlight.Add(SendAsync());
    TimeSpan next = TimeSpan.FromMilliseconds(5 * (i + 1));
    if (next > clock.Elapsed) await Task.Delay(next - clock.Elapsed);
}
await Task.WhenAll(inFlight);
api-3 300 ms'ye yavaşlamışken üç policy'nin gerçek çıktısı:
== slow, RoundRobin
api-1: 200 requests
api-2: 200 requests
api-3: 200 requests
errors: 0, p50 21 ms, p99 4,652 ms
== slow, LeastRequests
api-1: 249 requests
api-2: 319 requests
api-3:  32 requests
errors: 0, p50 21 ms, p99 303 ms
== slow, PowerOfTwoChoices
api-1: 282 requests
api-2: 283 requests
api-3:  35 requests
errors: 0, p50 21 ms, p99 301 ms
Açılıştaki tahminin cevabı ilk blokta: round robin'de p99 4,6 saniye. Hesabı kâğıt üstünde de yapabiliriz. Round robin api-3'e saniyede ~67 istek gönderiyor; api-3'ün kapasitesi 8 ÷ 0,3 s ≈ 27 istek/saniye. Gelen, işlenebilenden fazla olduğu için sıra her saniye ~40 istek büyüyor ve testin sonunda sıradaki bir istek saniyelerce bekliyor. Instance'ların üçte biri sağlıklı değil ama isteklerin üçte biri cezalandırılıyor; p50'nin 21 ms'de kalması da bu yüzden yanıltıcı.
LeastRequests ve PowerOfTwoChoices aynı yavaş instance'a yalnız 32 ve 35 istek gönderdi. api-3'te istekler biriktikçe aktif istek sayısı yükseldi ve algoritma trafiği kendiliğinden diğer ikisine kaydırdı; p99, yavaş instance'ın kendi servis süresine (300 ms) indi. Power of two choices bunu her istekte yalnız iki instance'a bakarak başardı. Load balancer'ın yavaşlığı fark etmesi için bir health check'e ya da konfigürasyon değişikliğine gerek kalmadı; algoritmanın kendisi geri besleme döngüsü.
Health Check: Active ve Passive
Yavaş instance'ı algoritma idare etti; ölü instance'ı etmez. Health check'in iki biçimi var. Active health check'te load balancer belirli aralıklarla her instance'ın bir endpoint'ine (/health) istek atar ve art arda başarısız olanı listeden çıkarır. Passive health check'te gerçek trafiği izler: bağlantı hatası ya da 5xx oranı bir eşiği geçen instance'ı bir süreliğine dışarıda bırakır. YARP ikisini de destekliyor:
HealthCheck = new HealthCheckConfig
{
    Active = new ActiveHealthCheckConfig
    {
        Enabled = true,
        Interval = TimeSpan.FromMilliseconds(500),
        Timeout = TimeSpan.FromMilliseconds(300),
        Policy = HealthCheckConstants.ActivePolicy.ConsecutiveFailures,
        Path = "/health",
    },
},
Senaryoyu değiştirelim: bu kez üç instance da hızlı, ama 200. istekte (yaklaşık 1. saniyede) api-3 tamamen kapanıyor. Round robin, health check'li ve health check'siz:
== crash, RoundRobin
api-1: 200 requests
api-2: 200 requests
api-3:  67 requests
errors: 133, p50 21 ms, p99 43 ms
== crash, RoundRobin + active health check
api-1: 249 requests
api-2: 249 requests
api-3:  67 requests
errors: 35, p50 21 ms, p99 24 ms
Health check olmadan api-3 çöktükten sonraki her üç istekten biri hata aldı: 400 isteğin üçte biri, 133 hata. YARP bağlantı kuramadığı destination için client'a 502 döndü. Active health check'le hata sayısı 35'e indi: 500 ms'lik aralıkla iki ardışık başarısız kontrol, yani yaklaşık bir saniye içinde api-3 listeden çıktı ve kalan istekler api-1 ile api-2'ye gitti. Sıfıra inmedi, çünkü active health check doğası gereği gecikmeli; aralığı kısaltmak sıfıra yaklaştırır ama sağlıklı instance'lara da daha çok kontrol isteği demek. Pratikte ikisi birlikte kullanılır: passive check gerçek trafikteki hatayı hemen görür, active check instance'ın geri dönüp dönmediğini anlar.
Health endpoint'inin neyi kontrol ettiği de bir tasarım kararı. Veritabanına bağlanamayan instance'ı listeden çıkarmak mantıklı görünür, ama veritabanı herkes için düştüyse bütün instance'lar aynı anda listeden çıkar ve load balancer'ın gönderebileceği kimse kalmaz. Liveness ve readiness ayrımı ASP.NET Core Web API serisinin "ASP.NET Core Web API'de Health Check: Liveness, Readiness ve Veritabanı Kontrolü" yazısında; load balancer'a genelde readiness bakar.
Sticky Session'ın Maliyeti
Sticky session (session affinity), load balancer'ın aynı client'ı hep aynı instance'a göndermesi: L7'de bir cookie ile, L4'te client IP'sinin hash'iyle. Bir önceki yazıda stateless tier'ın onu gereksiz kıldığını görmüştük; bu yazının deneyi de bedelini gösteriyor. Affinity açıkken load balancer, kullanıcı api-3'e bağlıysa onu yavaş instance'tan kaçıramaz: LeastRequests'in bütün kazancı, sticky kullanıcılar için yok. Yük de dengesiz dağılır, çünkü kullanıcılar eşit değil; ağır bir kurumsal müşteri tek bir instance'a yapışır. Ve instance çöktüğünde ya da deploy için kapandığında o kullanıcıların bellekteki state'i gider.
Affinity'nin meşru kullanımı var: instance'ın belleğindeki sıcak bir cache'ten yararlanmak ya da WebSocket gibi doğası gereği bağlantıya bağlı trafik. Bu durumda bile affinity bir optimizasyon olmalı, doğruluğun şartı değil: kullanıcı başka instance'a düştüğünde sistem yavaşlamalı, bozulmamalı.
Connection Draining ve Deployment
Bir instance'ı deploy için kapatırken, üzerindeki istekleri yarıda kesmek istemezsin. Connection draining, instance'ı yeni istek almayacak şekilde işaretleyip mevcut isteklerin bitmesini beklemek demek. AWS'in target group'larında bunun adı deregistration delay ve varsayılanı 300 saniye; Google'ın SRE kitabı da benzer durumu "lame duck" olarak anlatıyor: görev hâlâ istek işliyor ama client'lara artık yeni istek göndermemelerini söylüyor.
ASP.NET Core tarafında karşılığı graceful shutdown: host, SIGTERM aldığında yeni bağlantı kabul etmeyi bırakır ve HostOptions.ShutdownTimeout (varsayılan 30 saniye) kadar mevcut isteklerin bitmesini bekler. İki sürenin uyumlu olması gerekiyor: load balancer'ın draining süresi kısaysa ya da instance load balancer listeden çıkarmadan kapanırsa, rolling deployment her seferinde birkaç yüz isteği 502 ile düşürür.
Global Load Balancing: GeoDNS, Anycast ve DNS TTL
Birden fazla bölge olduğunda iki seviyede karar verilir: önce hangi bölge, sonra o bölgede hangi instance.
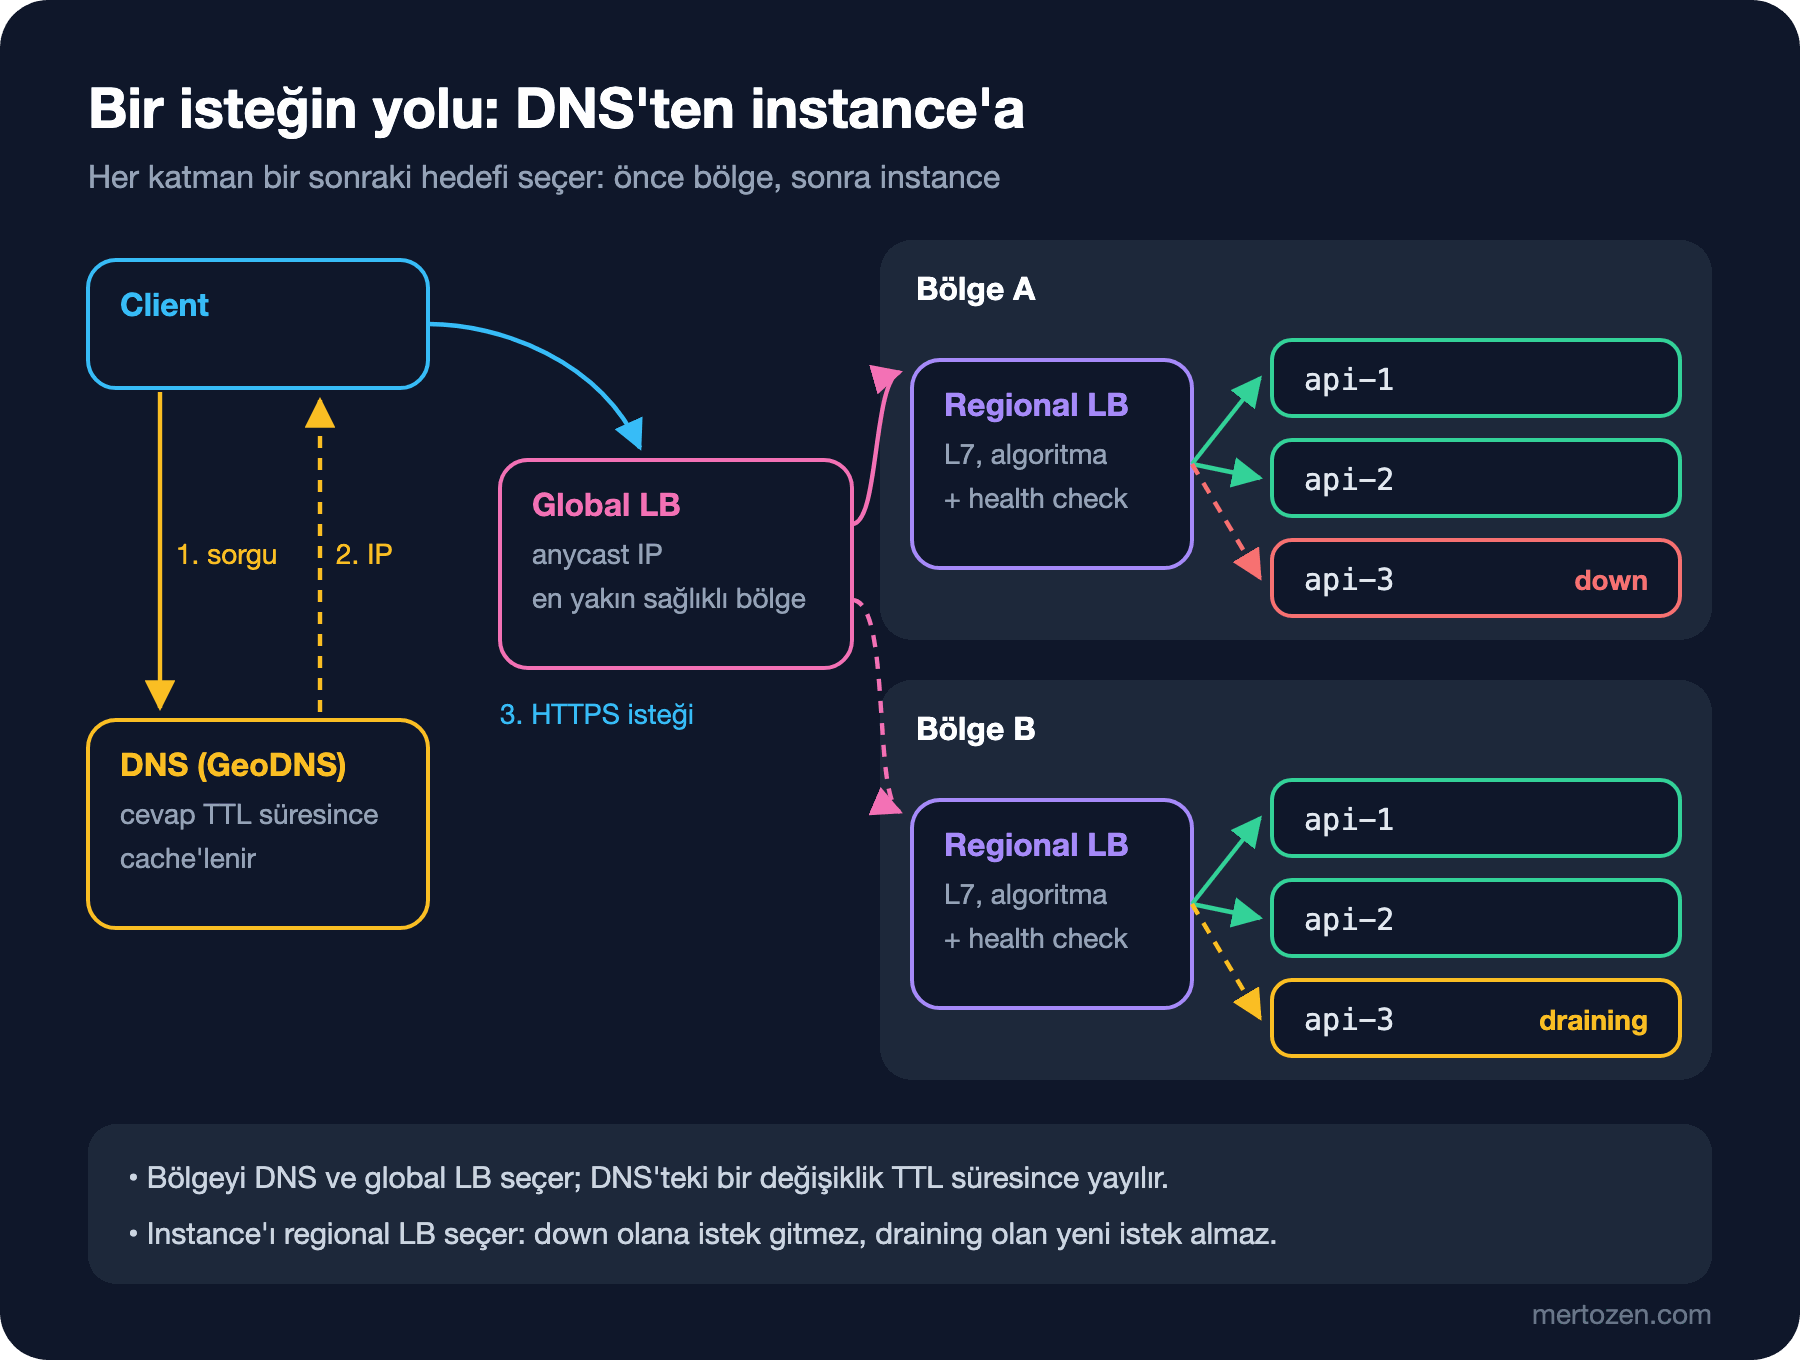
Bölge seçiminin en yaygın yolu DNS (Domain Name System). GeoDNS, aynı ad için sorgunun geldiği konuma göre farklı IP adresi döner: Avrupa'daki kullanıcı Frankfurt'u, Türkiye'deki kullanıcı en yakın bölgeyi alır. Sorunu TTL (time to live): DNS cevabı resolver'larda ve client'larda TTL süresince cache'lenir, bazıları bu süreye uymaz bile. Bir bölge çöktüğünde DNS'i değiştirsen bile kullanıcıların bir kısmı TTL dolana kadar ölü bölgeye gitmeye devam eder. TTL'i kısaltmak (60 saniye gibi) yayılmayı hızlandırır, ama DNS sorgu sayısını ve çözümleme gecikmesini artırır.
Anycast bu gecikmeyi atlar: aynı IP adresi birçok lokasyondan BGP (Border Gateway Protocol) ile duyurulur ve internet yönlendirmesi paketi en yakın lokasyona götürür. Bir lokasyon düştüğünde duyuru geri çekilir ve trafik saniyeler içinde bir sonrakine akar; client'ın DNS cache'i hiç değişmez. Büyük bulut sağlayıcılarının global load balancer'ları ve CDN'ler (Content Delivery Network) bu yöntemle çalışır. Kendi başına kurması zor olduğu için genelde yönetilen bir servis olarak kullanılır.
Bookstore için bu katman bugün gereksiz; tek bölge yeterli. Ama DNS TTL'ini bilmek tek bölgede bile işe yarar: load balancer'ın IP'si değişen bir taşımada eski kayıt TTL süresince yaşamaya devam eder. DNS ve CDN kurulumu ilerideki DevOps kategorisindeki Domain, DNS ve CDN serisinin, Nginx konfigürasyonu da Web Server'lar ve Hosting serisinin konusu.
Sık Düşülen Tuzaklar
Bütün instance'ları ve istekleri eşit saymak. Round robin, bir instance yavaşladığında isteklerin üçte birini cezalandırır; yukarıdaki p99 4,6 saniye bunun ölçüsü.
Health check'i veritabanına bağlamak. Paylaşılan bir bağımlılık düştüğünde bütün instance'lar aynı anda listeden çıkar; load balancer sağlıklı ama işe yaramaz bir sistemi tamamen kapatır.
Hızlı hata veren instance'ı sağlıklı sanmak. "En az aktif istek" mantığı, istekleri anında reddeden bir instance'a trafiği yığar; passive health check'te hata oranını hesaba kat.
HTTP/2 ve gRPC'yi L4 ile dengelemek. Uzun ömürlü bağlantılar yüzünden yük bağlantı açıldığı andaki dağılımda kalır.
Draining olmadan deploy etmek. Instance load balancer'dan çıkmadan kapanırsa her deploy kullanıcıya birkaç saniyelik 502 olarak yansır.
Load balancer'ın kendisini tek bırakmak. Üç instance'ın önündeki tek bir proxy, sistemi yine tek hata noktasına bağlar.
Küçük Bir Deneme
★☆☆ slow senaryosunu Random policy'siyle çalıştır. api-3'e kaç istek gitti, p99 ne oldu? Sonucu round robin ve power of two choices ile karşılaştır.
★★☆ Active health check'in Interval değerini 500 ms'den 2 saniyeye çıkar ve crash senaryosundaki hata sayısını tahmin et, sonra ölç. Sonra YARP'ın passive health check'ini (Passive = new PassiveHealthCheckConfig { Enabled = true }) aç ve ikisinin birlikte davranışına bak.
★★★ api-3'ü yavaş değil, her isteği anında 500 ile reddeden bir instance'a çevir ve LeastRequests ile çalıştır. Google SRE kitabının anlattığı sinkholing'i görebiliyor musun? Bunu passive health check ya da kendi ILoadBalancingPolicy implementasyonunla nasıl önlersin?
Load balancer yükü dağıttı, ama her instance hâlâ aynı veritabanına aynı sorguları gönderiyor. Bir sonraki yazıda bu tekrarı kesen katmana bakıyoruz: caching stratejileri, cache-aside'dan write-behind'a ve kampanya gününde cache'in kendisinin bir yük kaynağına dönüştüğü cache stampede'e kadar.