

System Design Case Study: News Feed ve Timeline

News feed'de varsayılan fan-out on write'tır, ama takipçi dağılımı power-law olduğu için tek bir ünlü paylaşımı milyon yazmaya dönüşür; çözüm, yüksek bir eşiğin üstündeki hesapları okuma anında birleştiren hibrit model, yalnız post ID tutan bir feed cache ve cursor pagination. Hesaplanmış capacity tablosu, push, pull ve hibrit simülasyonu, Redis sorted set'te offset ile cursor'ın gerçek çıktıları.
Sürüm notu: Bu yazıdaki kodlar C# 14 ve .NET 10 ile derlenip denenmiştir; feed cache örneği Redis 7.4 ve StackExchange.Redis 3.4 ile, fan-out simülasyonu sabit seed ile koşturuldu.
Önce Tahmin Et
Bookstore'a bir "Okur Topluluğu" ekleniyor: okurlar yazarları ve birbirlerini takip ediyor, kısa yorumlar ve kitaptan alıntılar paylaşıyor; ana sayfada takip ettiklerinin paylaşımlarından oluşan bir akış (feed) var. Ekip en hızlı okumayı vermek için her paylaşımı, yazıldığı anda bütün takipçilerin hazır akışına eklemeye karar veriyor. İlk ay her şey yolunda. Sonra bir milyon takipçili ünlü bir yazar platforma katılıyor ve yeni kitabını duyuruyor.
İki soru. O tek duyuru, sisteme kaç yazma işi çıkarır ve son takipçi duyuruyu ne zaman görür? Ve okur akışını kaydırırken (?page=2) araya yeni paylaşımlar girerse, ikinci sayfada ne görür?
Requirement'lar ve Capacity Estimation
Functional requirement'lar: kullanıcı metin ve isteğe bağlı görsel içeren bir paylaşım yapabilir; takip ettiği hesapların paylaşımlarını yeniden eskiye bir akışta görür; akış sayfa sayfa (sonsuz kaydırma) yüklenir. Kapsam dışı: beğeni ve yorum sayaçları, bildirimler, arama. Non-functional requirement'lar: akış hızlı açılmalı (p99, yani isteklerin %99'unun altında kaldığı süre, 200 ms'nin altında); yeni bir paylaşımın takipçilerin akışına birkaç saniye içinde düşmesi yeterli, anında olması gerekmiyor; sistem ünlü hesapların varlığında da ayakta kalmalı. Bu son cümle, consistency yerine availability ve latency'yi seçtiğimizi söylüyor: akış eventual consistency ile yaşayabilir.
Varsayımlar: 10 milyon DAU (Daily Active Users, günlük aktif kullanıcı), kişi başı günde 2 paylaşım ve 10 akış okuması, ortalama 125 takipçi, peak ortalamanın 3 katı, paylaşımların %10'unda 500 KB'lık bir görsel.
const double dau = 10_000_000, postsPerUser = 2, readsPerUser = 10, avgFollowers = 125, peak = 3;
const double postBytes = 1_000, mediaShare = 0.10, mediaBytes = 500_000, feedEntries = 800, entryBytes = 16;
double postsPerSec = dau * postsPerUser / 86_400, readsPerSec = dau * readsPerUser / 86_400;
posts/s 231 (peak 694), feed reads/s 1,157 (peak 3,472)
fan-out inserts/s if every post is pushed: 28,935
post text/day 20 GB, media/day 1.0 TB
feed cache: 800 ids x 16 B x 10 M users = 128 GB before Redis overheadTablonun en önemli satırı ikincisi: saniyede 231 paylaşım, her biri yazıldığı anda takipçilere dağıtılırsa saniyede 29 bin akış yazmasına dönüşüyor. Okuma tarafı (saniyede 1.157, peak'te 3.500) tek başına zor değil; zor olan, okumayı ucuzlatmak için yazmayı ne kadar pahalılaştıracağımız. Görseller günde 1 TB ile metnin 50 katı; onların yeri veritabanı değil. Akış cache'i, kullanıcı başına yalnız 800 post ID'si tutarsak ham hâliyle 128 GB; Redis'in veri yapısı overhead'iyle birkaç katı, yani birkaç node'luk bir cluster.
API ve Veri Modeli
API (Application Programming Interface) iki endpoint'ten oluşuyor: POST /api/posts (metin ve, yüklendiyse, görselin object storage'daki anahtarı) ve GET /api/feed?cursor=...&limit=20. Akış cevabı paylaşımları ve bir sonraki sayfa için opak bir nextCursor döner; sayfa numarası yok, sebebini aşağıda göreceğiz.
Kalıcı veri üç parça. Posts tablosu paylaşımın kendisini tutar ve post ID'si zaman sıralıdır (serinin "Unique ID Üretimi: Auto-Increment, UUIDv4, UUIDv7 ve Snowflake" yazısındaki Snowflake gibi), böylece ID'ye göre sıralamak zamana göre sıralamak olur. Follows tablosu takip ilişkisidir; iki yönde de sorgulanır ("Grace'i kimler takip ediyor?" fan-out için, "Ada kimleri takip ediyor?" okuma için), bu yüzden iki index ya da iki ayrı tablo gerekir. Akış cache'i ise kalıcı değildir: kullanıcı başına bir Redis sorted set, feed:{user}, içinde yalnız post ID'leri. Paylaşımın metni akışlara kopyalanmaz; akış bir ID listesi, paylaşım bir kez saklanır. Bu ayrım, düzenlenen ya da silinen bir paylaşımın bütün akışlarda tek yerden değişmesini sağlar.
High-Level Design
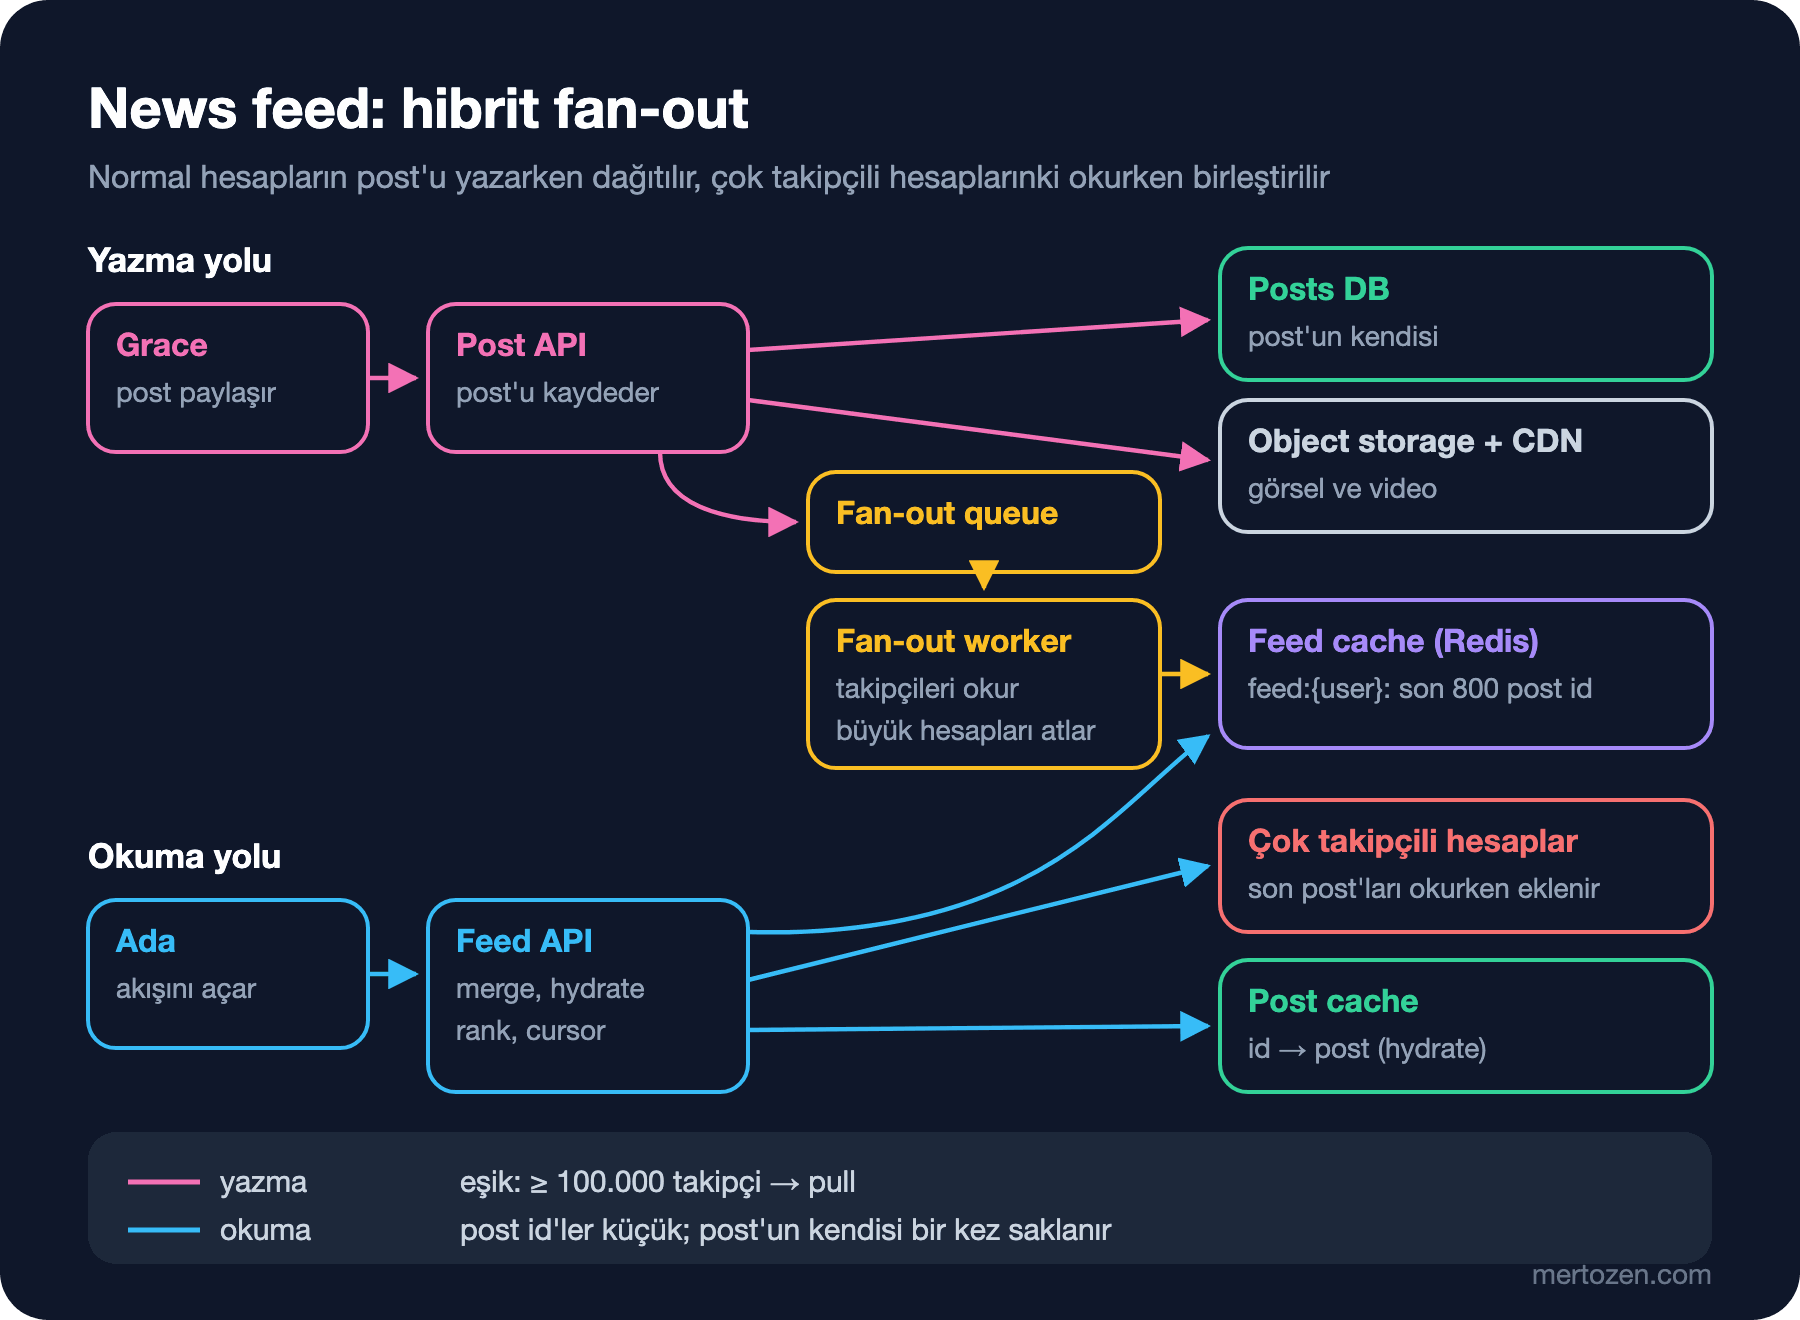
Yazma yolunda Post API paylaşımı veritabanına yazar, görseli object storage'a bırakır ve bir fan-out işini queue'ya koyar; kullanıcı bu noktada cevabını almıştır. Fan-out worker'ları yazarın takipçilerini okur ve post ID'sini her takipçinin akış cache'ine ekler. Okuma yolunda Feed API kullanıcının akış cache'inden ID'leri alır, takip ettiği çok takipçili hesapların son paylaşımlarını bunlara ekler (merge), ID'leri post cache'ten gerçek paylaşımlara çevirir (hydrate), sıralar ve bir cursor ile döner. Bu ikili yapının neden gerektiği deep dive'ların konusu.
Deep Dive: Fan-Out on Write mı, on Read mi?
İki uç model var. Fan-out on write (push): paylaşım yazıldığı anda bütün takipçilerin akışına eklenir; okuma tek bir cache okuması kadar ucuzdur, yazma takipçi sayısı kadar pahalıdır. Fan-out on read (pull): paylaşım yalnız yazarın listesine yazılır; okuyan, takip ettiği herkesin son paylaşımlarını toplayıp birleştirir. Yazma ucuz, okuma takip edilen hesap sayısı kadar pahalı.
Hangisinin ne kadar pahalı olduğunu ortalamalar söylemez, çünkü takipçi dağılımı eşit değil: çoğu hesabın birkaç düzine takipçisi varken bir avuç hesabın milyonları var. Bir milyon kullanıcılık bir modeli power-law (Pareto) dağılımıyla kurdum ve günde 2 paylaşım, 10 okuma ile iki modeli karşılaştırdım:
// Takipçi sayıları power-law dağılımında: çoğu kullanıcının birkaç düzine, bir avuç hesabın milyonlarca takipçisi var
public static FanOutReport Run(int users, double postsPerUserPerDay, double readsPerUserPerDay, long celebrityThreshold)
{
    Random random = new(7);
    long[] followers = new long[users];
    for (int i = 0; i < users; i++)
        followers[i] = Math.Min(users - 1, (long)(20 * Math.Pow(1 - random.NextDouble(), -1 / 1.15)));

    double totalEdges = followers.Sum(f => (double)f);
    double celebrityEdges = followers.Where(f => f >= celebrityThreshold).Sum(f => (double)f);
    double avgFollowing = totalEdges / users;                 // her edge bir takipçi ve bir takip demek
    double avgCelebritiesFollowed = celebrityEdges / users;

    double posts = users * postsPerUserPerDay, reads = users * readsPerUserPerDay;
    return new FanOutReport(
        AvgFollowers: avgFollowing,
        MaxFollowers: followers.Max(),
        Celebrities: followers.Count(f => f >= celebrityThreshold),
        WritesPerDay: postsPerUserPerDay * totalEdges,                         // push: takipçi başına bir akış yazması
        BiggestFanOut: followers.Max(),
        PullReadCostPerDay: reads * avgFollowing,                             // pull: her okuma takip edilen herkesi tarar
        HybridWritesPerDay: postsPerUserPerDay * (totalEdges - celebrityEdges),
        HybridReadCostPerDay: reads * (1 + avgCelebritiesFollowed));          // hazır akış + ünlülerin birleştirilmesi
}
avg followers 125, max 999,999
push : 250 M feed inserts/day, one post can fan out to 999,999
pull : 1,249 M followee lookups/day for 10 M feed readsPush, günde 250 milyon akış yazması üretiyor ama okuma başına tek bir cache okuması yeterli. Pull ise yazmayı sıfırlıyor, bedelini okumaya yüklüyor: 10 milyon okuma için 1,25 milyar "takip edilen hesabın son paylaşımları" sorgusu, okuma başına ortalama 125. Okuma yazmadan sık olduğu ve kullanıcının beklediği taraf okuma olduğu için çoğu sistem varsayılan olarak push'u seçer. Ama tablonun ikinci satırındaki sayı, push'un neden tek başına yetmediğini gösteriyor: tek bir paylaşım bir milyona yakın yazmaya dönüşebiliyor.
Deep Dive: Celebrity Problemi ve Hibrit Model
Önce Tahmin Et'teki ilk sorunun cevabı burada. Bir milyon takipçili yazarın duyurusu bir milyon akış yazması demek; worker'lar bunu saniyede birkaç bin ile işliyorsa son takipçi duyuruyu dakikalar sonra görür ve o sırada queue'nun arkasında bekleyen sıradan kullanıcıların paylaşımları da gecikir. Twitter'ın bu sorunla tanışması iyi belgelenmiş: Raffi Krikorian'ın 2012'deki "Timelines at Scale" konuşmasının High Scalability'deki özetine göre ana sayfa timeline'ları Redis'te kullanıcı başına en fazla 800 kayıtla tutuluyor, fan-out hedefi 5 saniyenin altıydı, ama 31 milyon takipçili bir hesabın tweet'inin herkese ulaşması 5 dakikayı bulabiliyordu. Çözüm olarak çok takipçili hesapların tweet'lerini fan-out etmeyip okuma anında timeline'a birleştirmeye geçtiklerini anlatıyor.
Bu hibrit model: normal hesaplar push, eşiği aşan hesaplar pull. Eşik bir ayar düğmesi; nereye koyduğunu simülasyon gösteriyor:
hybrid >=  10,000: 795 pull accounts, 184 M inserts/day + 337 M lookups/day
hybrid >= 100,000:  54 pull accounts, 220 M inserts/day + 158 M lookups/day
Eşik 10 bin takipçideyken 795 hesap pull'a geçiyor, yazmalar 250 milyondan 184 milyona iniyor, ama ortalama kullanıcı yaklaşık 33 "ünlü" takip ettiği için her okuma yaklaşık 34 parçanın birleştirilmesi oluyor. Eşik 100 bine çıkınca yalnız 54 hesap kalıyor ve okuma maliyeti yarıya iniyor; yazmalar ise 220 milyona çıkıyor. En pahalı fan-out'ları (milyon takipçili hesaplar) kesmek için yüksek bir eşik yeterli; eşiği düşürmek yazmayı az azaltıp okumayı çok pahalılaştırıyor. Pull tarafındaki birleştirmenin ucuz olması da bir tasarım işi: her ünlü hesabın son paylaşımları kendi küçük cache listesinde durur ve Feed API onları tek bir toplu (multi-get) çağrıyla alır.
İki ayrıntı daha. Uzun süredir giriş yapmamış kullanıcılar için akışı her paylaşımda güncellemek boşa iş; fan-out yalnız aktif kullanıcılara yapılabilir, uzun süre sonra dönen kullanıcının akışı ilk girişte pull ile yeniden kurulur. Ve fan-out at-least-once çalışır: serinin "Asenkron İşleme: Queue, Worker, Fan-Out ve Backpressure" yazısında konuştuğumuz gibi, aynı iş iki kez işlenebilir. Sorted set'e aynı post ID'sini iki kez eklemek tek bir kayıt bıraktığı için bu işlem doğal olarak idempotent.
Deep Dive: Feed Cache ve Cursor Pagination
Akış cache'i için Redis sorted set iyi bir uyum: üye post ID'si, score da yine post ID'si (zaman sıralı olduğu için). Ekleme ZADD, en yeni 800'ü tutmak ZREMRANGEBYRANK, sayfa okumak bir range sorgusu. Önce Tahmin Et'teki ikinci soruyu bu yapı üzerinde denedim: Ada ilk sayfayı alıyor, araya iki yeni paylaşım giriyor, sonra ikinci sayfayı istiyor. Bir kez offset ile, bir kez cursor ile:
long[] page1 = await PageByOffset(db, feed, offset: 0, size: 10);
await db.SortedSetAddAsync(feed, 1031, 1031);                      // Ada kaydırırken yeni bir paylaşım geliyor
await db.SortedSetAddAsync(feed, 1032, 1032);
long[] page2Offset = await PageByOffset(db, feed, offset: 10, size: 10);
long[] page2Cursor = await PageByCursor(db, feed, before: page1[^1], size: 10);

static async Task<long[]> PageByOffset(IDatabase db, RedisKey feed, int offset, int size) =>
    [.. (await db.SortedSetRangeByRankAsync(feed, offset, offset + size - 1, Order.Descending)).Select(v => (long)v)];

// Cursor = istemcinin gördüğü son post ID'si; hariç tutulan üst sınır, yeniden eskiye
static async Task<long[]> PageByCursor(IDatabase db, RedisKey feed, long before, int size) =>
    [.. (await db.SortedSetRangeByScoreAsync(feed, double.NegativeInfinity, before, Exclude.Stop, Order.Descending, 0, size))
        .Select(v => (long)v)];
page 1 : 1030,1029,1028,1027,1026,1025,1024,1023,1022,1021
page 2 (offset): 1022,1021,1020,1019,1018,1017,1016,1015,1014,1013 duplicates: 1022,1021
page 2 (cursor): 1020,1019,1018,1017,1016,1015,1014,1013,1012,1011 duplicates: 0Offset ile ikinci sayfa, ilk sayfanın son iki paylaşımını tekrar gösteriyor: başa iki yeni kayıt eklenince her şey iki sıra kaydı. Silinen bir paylaşımda tam tersi olur ve bir paylaşım hiç görünmeden atlanır. Cursor "1021'den eski olanları ver" dediği için akışın başına ne eklendiği önemli değil. Çözüm Desenleri serisinin "Pagination Stratejileri Derinlemesine: Offset, Keyset ve Opaque Cursor Token" yazısı bunun veritabanı tarafını ve cursor'ı istemciye opak bir token olarak vermeyi ayrıntılı anlattı. Akışın en yeni kısmını almak için de aynı fikir tersten kullanılır: "1030'dan yeni olanları ver".
Deep Dive: Ranking ve Media
Buraya kadar akış kronolojikti. Çoğu ürün bir noktada sıralamaya (ranking) geçer: yeni paylaşımlar, kullanıcının sık etkileştiği hesaplar ve çok etkileşim alan paylaşımlar öne çıkar. Mimari açıdan önemli olan, ranking'in akış cache'ini değiştirmemesi: cache aday ID'leri tutmaya devam eder, Feed API birkaç yüz adayı alıp bir skorlama adımından geçirir ve ilk sayfayı döner. Skorlamayı bir model yapıyorsa bu adım ayrı bir service olur ve latency bütçesinden pay alır. Ranking'li bir akışta cursor da basit bir post ID'si olamaz, çünkü sıra zamana göre değil; ilk istekte üretilen sıralı listenin bir kimliği ve içindeki konum cursor'a yazılır.
Görseller ve videolar uygulama sunucusundan geçmemeli. İstemci, Post API'den kısa ömürlü, imzalı bir yükleme adresi (URL, Uniform Resource Locator; literatürdeki adıyla pre-signed URL) alır ve dosyayı doğrudan object storage'a yükler; paylaşım yalnız dosyanın anahtarını taşır. Küçük boyutlu kopyaların üretilmesi asenkron bir iş, okuma ise CDN (Content Delivery Network) üzerinden. Günde 1 TB'lık görsel trafiği böylece ne API sunucularına ne veritabanına dokunur.
Trade-off'lar
| Karar | Seçtiğimiz | Alternatif ve bedeli |
|---|---|---|
| Fan-out | Hibrit: push, 100 bin takipçi üstü pull | Yalnız push: ünlü paylaşımında dakikalarca gecikme; yalnız pull: her okumada yüz küsur sorgu |
| Akışta ne saklanır | Yalnız post ID | Paylaşımın kopyası: hydrate adımı yok ama düzenleme ve silme her akışa yayılmak zorunda |
| Akış uzunluğu | Son 800 | Sınırsız: bellek maliyeti; daha eskisi için pull ile veritabanından okunur |
| Pagination | Cursor | Offset: basit ama yeni kayıtlarda tekrar, silinenlerde atlama |
| Tutarlılık | Eventual, birkaç saniye | Paylaşım anında herkeste: senkron fan-out, yazma latency'si takipçi sayısına bağlı |
Sık Düşülen Tuzaklar
Ortalamaya göre tasarlamak
Ortalama 125 takipçi push'u ucuz gösterir; maliyeti dağılımın kuyruğundaki birkaç hesap belirler. Tasarımı en büyük fan-out'a göre test et.
Akışa paylaşımın kopyasını yazmak
Kopya, düzenlenen ya da silinen paylaşımın milyonlarca akışta eski hâliyle kalması demektir. Akış ID tutar, hydrate adımı silinmiş ve engellenmiş içeriği ayıklar.
Fan-out'u request içinde yapmak
Paylaşım isteği bütün takipçilere yazılana kadar beklerse yazarın "Paylaş" butonu takipçi sayısıyla yavaşlar. Fan-out bir queue işidir.
Offset ile sonsuz kaydırma
Sürekli büyüyen bir listede sayfa numarası, tekrar eden ve atlanan paylaşımlar demek. Cursor kullan.
Herkesin akışını sürekli güncel tutmak
Aylardır girmeyen kullanıcının akışına yazılan her ID boşa iş. Fan-out'u aktif kullanıcılarla sınırla, dönene akışı yeniden kur.
Küçük Bir Deneme
★☆☆ Capacity hesabını ortalama 400 takipçi ve kişi başı günde 5 paylaşımla tekrar yap. Push modelinde saniyedeki akış yazması kaç olur?
★★☆ Redis örneğine pull tarafını ekle: posts:{author} listelerinden takip edilen iki ünlünün son paylaşımlarını al, feed:{user} ile birleştir ve cursor mantığını bozmadan 10'luk bir sayfa döndür.
★★★ Simülasyona "aktif kullanıcı" kavramını ekle: kullanıcıların yalnız %40'ı son 7 günde giriş yapmışsa ve fan-out yalnız onlara yapılıyorsa push'un günlük yazma sayısı ne olur? Dönen kullanıcının akışını yeniden kurmanın maliyetini de hesapla.
Akış, kullanıcının sayfayı açtığında çektiği bir yapıydı. Bir sonraki case study'de veri sunucudan kullanıcıya anında itiliyor: chat ve notification sisteminde WebSocket bağlantılarını, mesaj sırasını ve çevrimdışı kullanıcıları konuşacağız.