

Veri Katmanını Ölçeklemek: Replication, Sharding ve SQL mi NoSQL mi?

Veri katmanını ölçeklemek access pattern'den başlar: replication okumayı ve availability'yi ölçekler ama yazmayı ölçeklemez, sharding yazmayı ölçekler ama shard key'i içermeyen sorguları scatter-gather'a çevirir. Bir milyon siparişlik denemede müşteri sorgusu tek shard'dan 0,1 ms'de dönerken son 30 gün sorgusu dört shard'ı baştan sona tarıyor; async replica yeni siparişi göstermiyor ve read-your-writes çözümü gerekiyor, hash % N ile 4'ten 5 shard'a geçmek müşterilerin %80'ini taşıyor.
Sürüm notu: Bu yazıdaki kodlar C# 14 ve .NET 10 ile derlenip denenmiştir; sharding örneği Microsoft.Data.Sqlite 10.0.14 ile, her shard ayrı bir SQLite dosyası olarak koşturuldu.
Önce Tahmin Et
Bookstore büyüdü: bir milyon sipariş, yirmi bin müşteri. Sipariş tablosu dört veritabanına bölündü ve her siparişin hangi veritabanına gideceğine customer_id karar veriyor; her veritabanının bir de okuma için replica'sı var. "Siparişlerim" sayfası her zamankinden hızlı.
İki soru. Finans ekibi "son 30 günün en büyük 20 siparişi"ni istiyor; bu sorgu kaç veritabanına gider ve uygulamaya kaç satır taşınır? İkincisi: Ada bir sipariş veriyor ve hemen "Siparişlerim" sayfasına yönlendiriliyor; sayfa replica'dan okunuyor. Ada yeni siparişini görür mü?
Önce Access Pattern, Sonra Veritabanı
Veri katmanını ölçeklemek, bir veritabanı ürünü seçmekle değil, verinin nasıl okunup yazıldığını listelemekle başlar. Kleppmann ve Riccomini'nin Designing Data-Intensive Applications kitabının (2. baskı, 2026) temel tavrı da bu: veri modeli, uygulamanın soracağı sorulara göre seçilir. Bookstore'un listesi:
- Siparişler: müşteri kendi siparişlerini okur, sipariş durumunu günceller; para ve stok var, transaction ve kısıt şart.
- Katalog: saniyede 200 arama, tam metin ve filtre; okuma ağırlıklı, birkaç saniyelik eskime kabul.
- Sepet: kullanıcı başına küçük bir belge, sık yazılır, kaybolması felaket değil.
- Görüntülenme ve beğeni sayaçları: çok sık yazılır, yaklaşık değer yeterli.
- Raporlama: büyük aralıklar üzerinde toplama, dakikalar mertebesinde gecikme kabul.
Bu listeden "SQL (Structured Query Language) mi NoSQL mi" sorusunun tek bir cevabı çıkmaz, birkaç cevabı çıkar. Siparişler ilişkisel bir veritabanında kalır, çünkü ihtiyaç duyulan şey transaction ve kısıt. Katalog araması için bir arama motoru, sepet için Redis gibi bir key-value store, sayaçlar için yazma ağırlıklı bir store ve raporlama için ayrı bir analitik kopya mantıklı olabilir. NoSQL bir ürün kategorisi değil, "ilişkisel model dışındaki her şey"in şemsiye adı; document, key-value, wide-column ve graph veritabanlarının her biri farklı bir access pattern'e iyi uyar. Bedeli, her yeni store'un bir operasyon yükü ve veriyi senkron tutma problemi olması. Bookstore gibi küçük bir ekip için doğru başlangıç, tek ilişkisel veritabanını sonuna kadar kullanmak; bu yazının geri kalanı o noktanın ötesine geçmek gerektiğinde ne olduğuna bakıyor.
Replication: Leader-Follower ve Read Replica
Replication, aynı verinin birden fazla makinede kopyasını tutmak. En yaygın biçimi leader-follower (primary-replica): bütün yazmalar leader'a gider, leader değişiklik log'unu follower'lara gönderir, follower'lar okuma isteklerini karşılayabilir. SQL Server'da Always On availability group'ların okunabilir secondary'leri, PostgreSQL'de streaming replication bunun örnekleri.
Replication iki ayrı problemi çözer. Availability: leader düşerse bir follower onun yerine geçer (failover). Okuma kapasitesi: okumalar birden fazla replica'ya dağıtılır. Yazma kapasitesini artırmaz; her yazma hâlâ tek bir leader'dan geçer ve her follower'da da uygulanmak zorunda.
Kritik seçim senkron ya da asenkron replication. Senkron modda leader, follower yazmayı aldığını onaylamadan client'a "tamam" demez; follower her zaman güncel, ama her yazma follower kadar yavaş ve follower erişilemezse yazmalar durur. Asenkron modda leader hemen onaylar ve değişikliği arkadan gönderir; yazmalar hızlı, ama follower geriden gelir ve leader o anda çökerse onaylanmış son yazmalar kaybolabilir. Pratikte çoğu sistem aynı datacenter içinde bir senkron, uzak bölgede asenkron follower kullanır. Replication'ın teorisi, quorum'lar ve leaderless modeller ilerideki Distributed Systems Temelleri serisinin "Replication: Leader-Based, Multi-Leader, Leaderless ve Quorum" yazısında.
Replication Lag ve Read-Your-Writes
Asenkron replication'ın günlük hayattaki yüzü replication lag: follower'ın leader'ın kaç milisaniye ya da saniye gerisinde olduğu. Açılıştaki ikinci soruyu küçük bir simülasyonla cevaplayalım. Gerçek bir veritabanı replikasyonu kurmak yerine, değişiklik log'unu sırayla ve 200 ms gecikmeyle uygulayan bir replica taklidi yazıyoruz:
public long Write(long orderId, string status)
{
    _leader[orderId] = status;
    long position = Interlocked.Increment(ref _leaderPosition);
    _log.Writer.TryWrite((position, orderId, status, DateTime.UtcNow));
    return position;   // client bu pozisyonu session'ında saklar
}

// replica client'ın son yazdığı pozisyona ulaştıysa replica'dan, yoksa leader'dan oku
public (string? Status, string ServedBy) ReadYourWrites(long orderId, long lastWrittenPosition) =>
    ReplicaPosition >= lastWrittenPosition
        ? (_replica.GetValueOrDefault(orderId), "replica")
        : (_leader.GetValueOrDefault(orderId), "leader");
replica, right after write: not found
read-your-writes: Placed (served by leader)
after 300 ms: Placed (served by replica), replica applied position 1İlk satır açılıştaki sorunun cevabı: Ada siparişini verdi, sayfa replica'dan okundu ve sipariş yok. Kullanıcı açısından bu bir veri kaybı gibi görünür; tekrar sipariş verir ve iki sipariş oluşur. Buna read-your-writes (read-after-write) consistency ihlali deniyor.
Çözüm, kullanıcının kendi yazdığını mutlaka görmesini garanti etmek. Örnekteki yöntem en sağlamı: leader her yazmaya artan bir log pozisyonu veriyor (SQL Server'da LSN (Log Sequence Number), PostgreSQL'de WAL (Write-Ahead Log) pozisyonu), client bu pozisyonu session'ında saklıyor ve replica o pozisyona ulaşmadıysa okuma leader'a gidiyor. İkinci satırda okuma leader'dan geldi, üçüncüde replica yetişmişti ve okuma replica'ya döndü. Daha basit alternatifler de var: kullanıcının kendi verisini her zaman leader'dan okumak, ya da son yazmadan sonraki birkaç saniye boyunca leader'dan okumak. İkisi de leader'a yük bindirir; ama "Siparişlerim" gibi kullanıcının kendi verisini gösteren sayfalar küçük bir kısım, katalog gibi herkesin okuduğu veri replica'da kalabilir.
Partitioning: Range, Hash ve Directory
Replication okumayı ölçekler, yazmayı ölçeklemez. Yazma kapasitesi ya da veri boyutu tek bir leader'ı aştığında veriyi bölmek gerekir: partitioning ya da sharding. Her shard verinin bir alt kümesini tutan bağımsız bir veritabanı, ve hangi kaydın hangi shard'da olduğuna shard key karar veriyor.
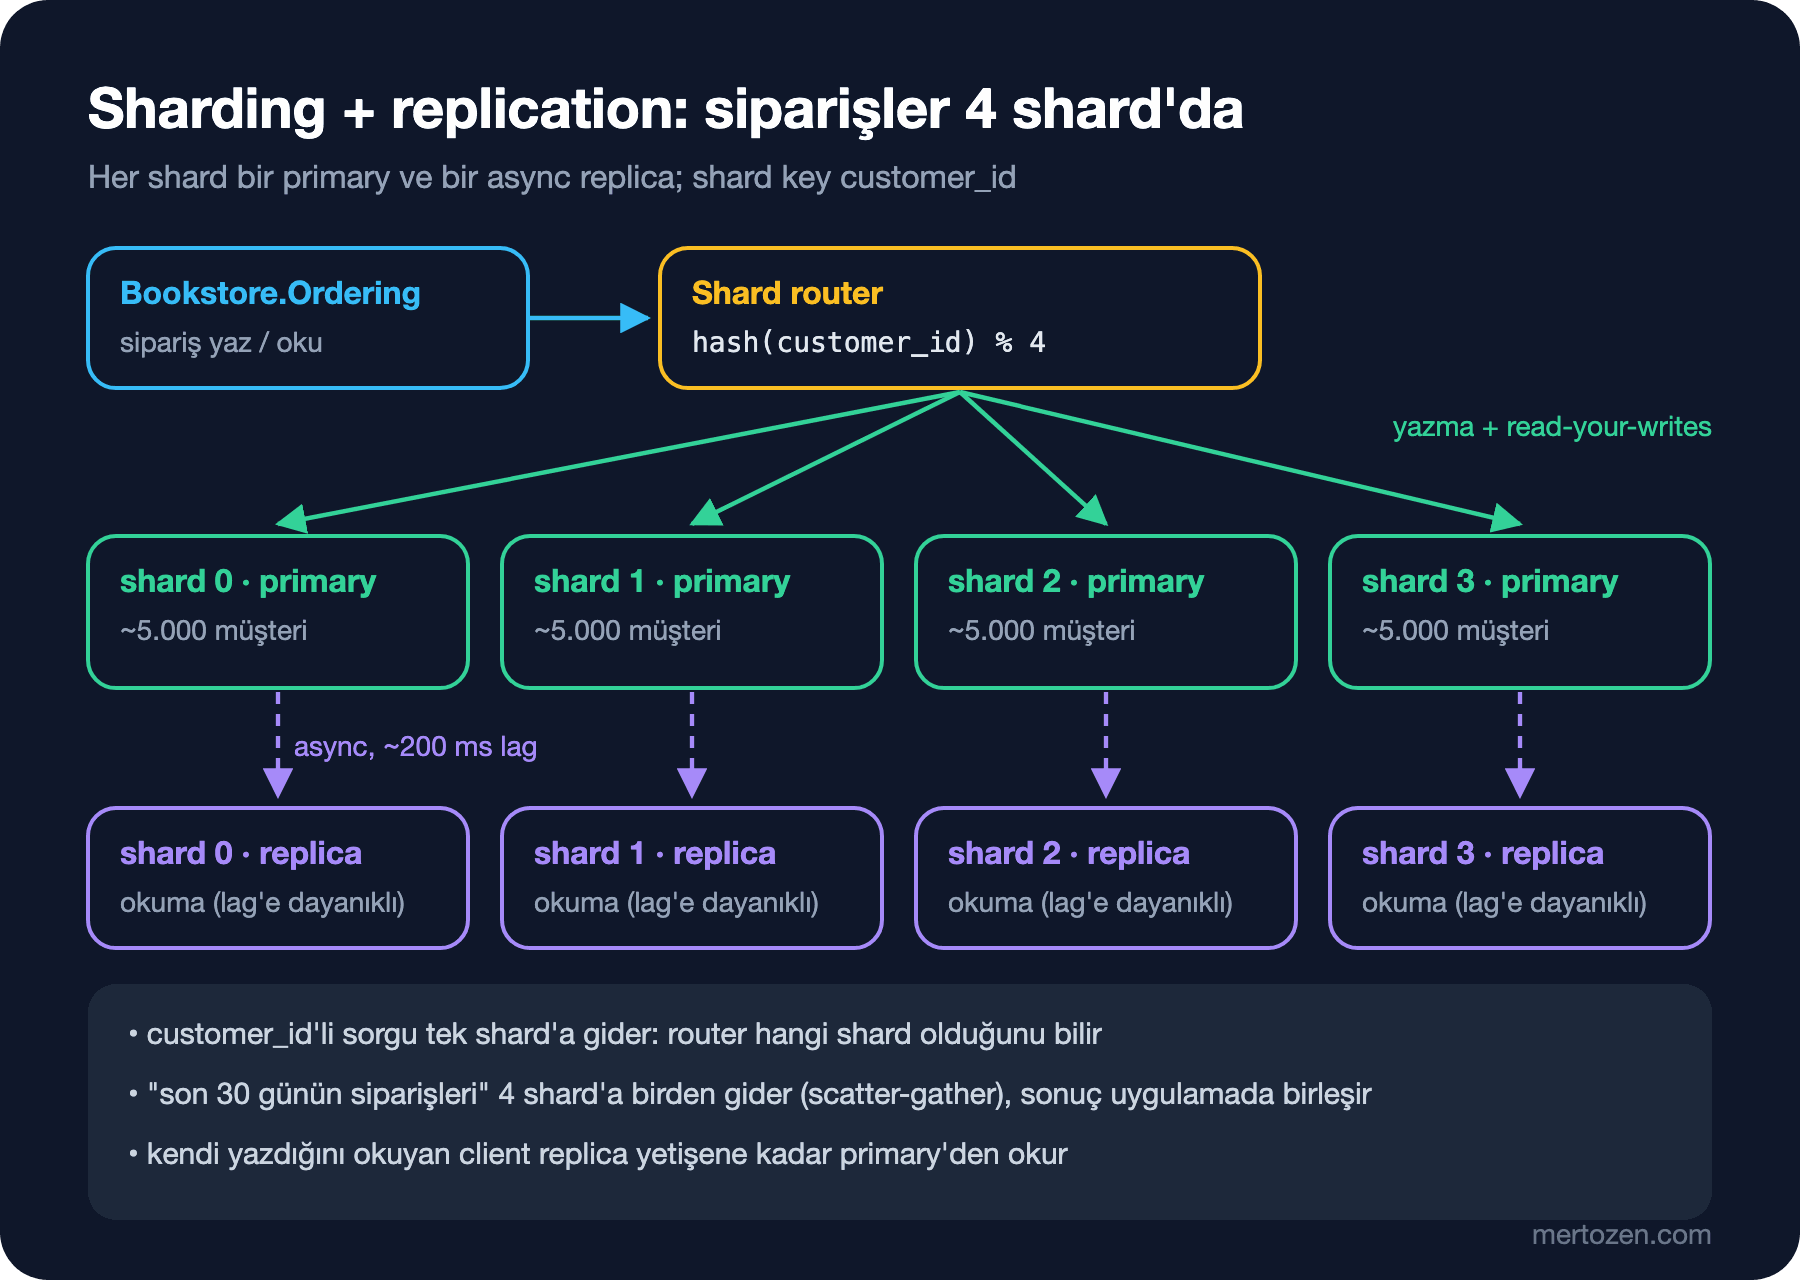
Üç temel yöntem var. Range partitioning'de key'in aralıkları shard'lara bölünür: A–F müşteriler bir shard'a, Ocak siparişleri başka bir shard'a. Aralık sorguları kolaydır, ama yük key'in dağılımına bağlıdır. Hash partitioning'de key'in hash'i alınıp shard sayısına göre bölünür; dağılım düzgündür, ama aralık sorguları bütün shard'lara gitmek zorunda kalır. Directory-based partitioning'de bir lookup tablosu her key'in hangi shard'da olduğunu tutar; en esnek yöntem, büyük bir müşteriyi tek başına bir shard'a taşımak bir satırlık değişiklik, ama lookup tablosunun kendisi her isteğin yolunda duran ve yüksek availability gerektiren bir component olur. Azure SQL'in Elastic Database client library'sinin shard map'i bu yaklaşımın bir örneği.
Deneme: Siparişleri customer_id ile Shard'lamak
Dört shard, her biri ayrı bir SQLite dosyası; bir milyon sipariş, yirmi bin müşteri. Motorun SQLite olmasının bir önemi yok, gösterdiğimiz şey sorgunun shard'lara nasıl dağıldığı. Shard key customer_id:
// shard key = customer_id; aynı müşterinin bütün siparişleri aynı shard'da
public static int ShardOf(int customerId, int shardCount) => (int)((uint)customerId * 2654435761u % (uint)shardCount);
Çarpım, ardışık id'lerin shard'lara düzgün dağılması için basit bir multiplicative hash (Knuth'un 2^32'ye göre altın oran sabiti). "Son 30 günün en büyük 20 siparişi" sorgusunda shard key yok, o yüzden sorgu dört shard'a birden gidiyor ve her shard kendi ilk 20'sini dönüyor:
// her shard kendi ilk 20'sini döner, uygulama birleştirip yeniden sıralar
public async Task<ShardResult> TopOrdersLast30DaysAsync(int take)
{
    string sql = $"SELECT id, created_on, total FROM orders WHERE created_on >= $p ORDER BY total DESC LIMIT {take}";
    string since = Today.AddDays(-30).ToString("yyyy-MM-dd");
    // Microsoft.Data.Sqlite'ın async method'ları senkron çalışır; paralellik için Task.Run
    var perShard = await Task.WhenAll(Enumerable.Range(0, shardCount).Select(s => Task.Run(() => QueryShardAsync(s, sql, since))));
    List<(long Id, double Total)> merged = [.. perShard.SelectMany(r => r.Items).OrderByDescending(o => o.Total).Take(take)];
    return new ShardResult(shardCount, merged.Count, perShard.Sum(r => r.Rows), perShard.Max(r => r.Ms), perShard.Min(r => r.Ms));
}
orders of customer 1234 shards touched: 1, rows: 47, 0.1 ms
top 20 of last 30 days shards touched: 4, rows: 20, rows moved to app: 80, 6.4 ms
slowest shard 6.3 ms, fastest shard 6.1 ms
plan, by customer: SEARCH orders USING COVERING INDEX ix_orders_customer (customer_id=?)
plan, last 30 days: SCAN orders | USE TEMP B-TREE FOR ORDER BYAçılıştaki ilk sorunun cevabı burada. Müşteri sorgusu tek shard'a gitti, index'ten 47 satırı okudu ve 0,1 ms sürdü. Son 30 gün sorgusu dört shard'a gitti, her shard kendi 250.000 satırını baştan sona taradı (SCAN orders) ve sıraladı; uygulamaya 80 satır taşındı, 20'si kaldı. Toplam süre en yavaş shard kadar: scatter-gather sorgusunun latency'si shard'ların p99'u tarafından belirlenir, ve "Back-of-the-Envelope Estimation: QPS (queries per second), Storage, Bandwidth ve Availability Hesabı"ndaki fan-out hesabı burada da geçerli. Shard sayısı 4'ten 40'a çıktığında aynı sorgu 40 shard'a gider, 800 satır taşır ve 40 shard'dan birinin yavaş olma ihtimali de 40 kat artar.
Bunu düzeltmenin yolu sorguyu hızlandırmak değil, o sorguyu bu veri modeline sormamak. Sharding'in kuralı şu: en sık ve en kritik sorgular shard key'i içermeli. "Son 30 günün siparişleri" gibi bir raporlama sorgusu, operasyonel shard'lara değil, siparişlerin aktığı ayrı bir raporlama kopyasına sorulmalı. Sayfalama da ayrı bir tuzak: OFFSET 1000 LIMIT 20 dört shard'ın her birinden 1.020 satır ister; cursor tabanlı sayfalama bu yüzden sharding'le birlikte neredeyse zorunlu.
Hot Partition ve Resharding
İyi bir shard key yalnız sorguları değil yükü de dengeler. Bugün gelen 600 siparişin hash ve ay bazlı range sharding'de nasıl dağıldığına bakalım:
today's 600 writes  hash(customer): [158, 146, 148, 148]  range(month): [0, 0, 0, 600]
4 -> 5 shards with hash % N: 16,001 of 20,000 customers move (80%)
Ay bazlı range sharding'de bugünün bütün yazmaları tek shard'a gidiyor; diğer üç shard'ın yazma kapasitesi boşta. Zamana göre artan her key (tarih, auto-increment id) bu hot partition'ı üretir. Hash'le dağılım düzgün. Ama hash da tek bir sıcak key'i bölemez: bütün siparişlerini aynı customer_id ile veren bir kurumsal müşteri, hash'in neresine düşerse orayı ısıtır. Çaresi ya bu müşteriyi directory ile kendi shard'ına almak ya da key'e bir ek (alt müşteri, şube) katmak.
İkinci satır sharding'in uzun vadeli bedeli. Dört shard beşe çıktığında hash % N ile müşterilerin %80'i başka bir shard'a taşınmak zorunda: bir milyon siparişin sekiz yüz bini canlı sistemde kopyalanacak. Resharding bu yüzden en pahalı operasyonlardan biri ve iki yaygın çaresi var: shard sayısından çok daha fazla mantıksal partition (ör. 1.024) tanımlayıp yalnız partition'ları fiziksel sunuculara taşımak ve consistent hashing. İkincisi serinin bir sonraki yazısının konusu.
Denormalization
Sharding'in sessiz bedeli join'ler. Siparişler customer_id ile, kitaplar başka bir yöntemle bölündüyse "siparişler ve kitap adları" sorgusu artık tek bir veritabanında çalışan bir JOIN değil, uygulamada birleştirilen iki ayrı sorgu. Yaygın çözüm denormalization: sipariş satırına kitap adını ve o anki fiyatı kopyalamak. Bu zaten iş açısından doğru; sipariş verildiği andaki fiyatı göstermeli, bugünkü fiyatı değil. Kopyalanan veri değiştiğinde (kitabın adı düzeltildiğinde) güncellemek bir event ile yapılır ve bir süre eski kalabilir.
Raporlama tarafında da aynı fikir: operasyonel shard'lardaki değişiklikleri CDC (Change Data Capture) ya da event'lerle ayrı bir analitik store'a akıtmak ve "son 30 gün" gibi soruları orada sormak. Bu, CQRS (Command Query Responsibility Segregation) ve Event Sourcing serisindeki read model fikrinin veri katmanındaki karşılığı.
CAP ve PACELC: Feature Bazında Karar Lensi
Replication ve sharding'in her kararında aynı soru geri dönüyor: bir replica geride kaldığında ya da bir shard'a erişilemediğinde eski veriyi mi gösteririz, yoksa hata mı veririz? CAP (Consistency, Availability, Partition tolerance) teoremi bu seçimin network bölünmesi sırasındaki hâlini, Daniel Abadi'nin PACELC (if Partition, then Availability or Consistency; Else, Latency or Consistency) formülasyonu da bölünme yokken latency ile consistency arasındaki seçimi adlandırıyor. Teorinin kesin ifadesi ve sık yapılan yanlış okumalar ilerideki Distributed Systems Temelleri serisinin "CAP ve PACELC'i Doğru Okumak" yazısında; burada yalnız karar lensi olarak kullanıyoruz.
Pratik kullanımı, kararı sistem için değil feature için vermek. Bookstore'da ödeme ve stok düşümü leader'dan okunur ve yazılır; replica gerideyse beklenir, leader erişilemiyorsa işlem reddedilir, çünkü yanlış bakiye ya da fazla satış eski bir sayfadan daha pahalı. Sipariş geçmişi read-your-writes ile replica'dan okunur. Katalog ve kitap detayı replica'dan ve cache'ten, saniyeler mertebesinde eski olabilir. Beğeni ve görüntülenme sayaçları eventual: bir sayaç birkaç saniye geriden gelirse kimse fark etmez, ama sayaç yüzünden sayfa açılmazsa herkes fark eder. Aynı veritabanı, aynı replica'lar; feature başına farklı bir okuma kuralı.
Sık Düşülen Tuzaklar
Read replica'yı yazma ölçeklemesi sanmak. Replica okumayı ölçekler; her yazma hâlâ leader'dan geçer ve her replica'da tekrar uygulanır.
Kullanıcının kendi yazdığını replica'dan okumak. Sipariş verdikten sonra siparişi görememek, kullanıcıyı ikinci siparişe iter; read-your-writes'ı açıkça tasarla.
Shard key'i sorgulara bakmadan seçmek. En sık sorgu shard key'i içermiyorsa her istek scatter-gather olur ve sharding'in kazancı kaybolur.
Zamana göre artan bir key ile range sharding yapmak. Bütün yeni yazmalar son shard'a gider; hot partition garantili.
hash % N ile başlayıp resharding'i sonraya bırakmak. Shard sayısını değiştirmek verinin çoğunu taşımak demek; mantıksal partition ya da consistent hashing'i baştan düşün.
Erken sharding. Vertical scaling, index, cache ve read replica bitmeden sharding'e geçmek, en pahalı ve geri dönüşü en zor adımı en başta atmak demek.
Küçük Bir Deneme
★☆☆ Örnekte created_on üzerine bir index ekle (CREATE INDEX ix_orders_created ON orders (created_on)) ve son 30 gün sorgusunun planına ve süresine tekrar bak. Scatter-gather ortadan kalktı mı?
★★☆ ReplicatedStore'a ikinci bir replica ekle; biri 50 ms, diğeri 2 saniye gecikmeli olsun. Okumaları iki replica arasında sırayla dağıtırsan bir kullanıcı aynı siparişi önce görüp sonra göremeyebilir mi? Bu anomaliye ne ad veriliyor ve nasıl önlersin?
★★★ ShardOf'u 1.024 mantıksal partition'a, partition'ları da bir lookup tablosuyla dört fiziksel shard'a eşleyen bir yapıya çevir. Beşinci shard eklenirken kaç partition'ın, dolayısıyla kaç siparişin taşınması gerekiyor? hash % N'nin %80'iyle karşılaştır.
Resharding'deki %80 rakamı bir sonraki yazının çıkış noktası: node sayısı değiştiğinde yalnız gerekeni taşıyan bir dağıtım yöntemi. Consistent hashing'i, hash ring ve virtual node'larla birlikte C#'ta kendimiz yazıp taşınan key oranını bir xUnit testiyle ölçeceğiz.