

GraphQL'de Performans: N+1, DataLoader, Batch Resolver ve Cursor Pagination
GraphQL'de N+1'in çözümü, resolver'ların key'lerini toplayıp tek sorguda yükleyen DataLoader'dır; 50 kitabın yazarları 51 SQL sorgusundan 2'ye iner. Hot Chocolate 16'nın DataLoader'larını, batch resolver'ını ve 16.7.5'teki takılmasını, projection'la birlikte kullanmanın sessiz tuzaklarını, offset kılıklı cursor ile gerçek keyset pagination'ı ve OpenTelemetry span'larını gerçek çıktılarla gösteriyoruz.
Sürüm notu: Bu yazıdaki kodlar .NET 10, Hot Chocolate 16.7, Entity Framework Core (EF Core) 10.0, SQL Server 2025 ve OpenTelemetry .NET 1.21 ile derlenip denenmiştir.
Önce Tahmin Et
Veritabanında 50 kitap ve 10 yazar var; her yazarın 5 kitabı. Book.author field'ı için basit bir resolver yazdın:
public static async Task<Author?> GetAuthorAsync([Parent] Book book, BookstoreContext db, CancellationToken cancellationToken) =>
    await db.Authors.AsNoTracking().FirstOrDefaultAsync(a => a.Id == book.AuthorId, cancellationToken);
Client { books(first: 50) { title author { name } } } gönderiyor. SQL Server'a kaç sorgu gider? Kitaplar için 1, yazarlar için 10, toplam 11 mi? Yoksa 51 mi? Aynı yazar beşinci kez istendiğinde EF Core onu bir yerden hatırlar mı?
Cevabı ilk bölümde, SQL logundan sayarak veriyorum. Yazının geri kalanı o sayıyı 2'ye indirmenin üç yolu ve her birinin bedeli.
N+1'i SQL Loguyla Yakalamak
Bir önceki yazıda kurduğumuz Catalog service'inde books'u düz bir listeye çevirdim ve yazarı yukarıdaki resolver'a bıraktım. EF Core'un Microsoft.EntityFrameworkCore.Database.Command logu açıkken sorguyu gönderip Executed DbCommand satırlarını saydım: 51.
Executed DbCommand (4ms) [Parameters=[@p='?' (DbType = Int32)], ...]
SELECT TOP(@p) [b].[Id], [b].[AuthorId], [b].[CostPrice], [b].[Isbn], [b].[Price], [b].[Stock], [b].[SupplierNote], [b].[Title]
FROM [Books] AS [b]
ORDER BY [b].[Id]

Executed DbCommand (3ms) [Parameters=[@book_AuthorId='?' (DbType = Int32)], ...]
SELECT TOP(1) [a].[Id], [a].[Bio], [a].[Name]
FROM [Authors] AS [a]
WHERE [a].[Id] = @book_AuthorId

Executed DbCommand (1ms) [Parameters=[@book_AuthorId='?' (DbType = Int32)], ...]
SELECT TOP(1) [a].[Id], [a].[Bio], [a].[Name]
FROM [Authors] AS [a]
WHERE [a].[Id] = @book_AuthorId
# 48 tane daha
Bir sorgu kitaplar için, sonra her kitap için bir tane: 1 + 50. Ada Byron beş kez soruldu. EF Core hatırlamadı, çünkü FirstOrDefaultAsync change tracker'a bakmaz, her seferinde veritabanına gider; AsNoTracking olmasa da sonuç aynı olurdu. Resolver'lar birbirinden habersiz: her biri yalnız kendi parent'ını görüyor ve kendi sorgusunu atıyor. Serinin GraphQL temelleri yazısında resolver ağacının bu davranışını in-memory veriyle görmüştük; burada gerçek SQL ile karşımızda.
Yerel makinede bu sorgunun maliyeti küçük görünüyor. Release build, SQL logu kapalı, 200 ardışık istekte p50 7.5 ms, p95 9.0 ms ölçtüm. Ama veritabanı aynı makinede; her gidiş-dönüş mikrosaniyeler sürüyor. Veritabanı başka bir sunucuda ve her gidiş-dönüş 1 ms olsaydı, yalnız ağ bekleme süresi 50 ms'yi geçerdi. Daha kötüsü, client listeyi 50'den 500'e çıkardığında sorgu sayısı da onunla büyür. N+1 bir performans hatasından çok, maliyeti client'ın kontrol ettiği bir tasarım hatası.
DataLoader: Batch, Group ve İstek Başına Cache
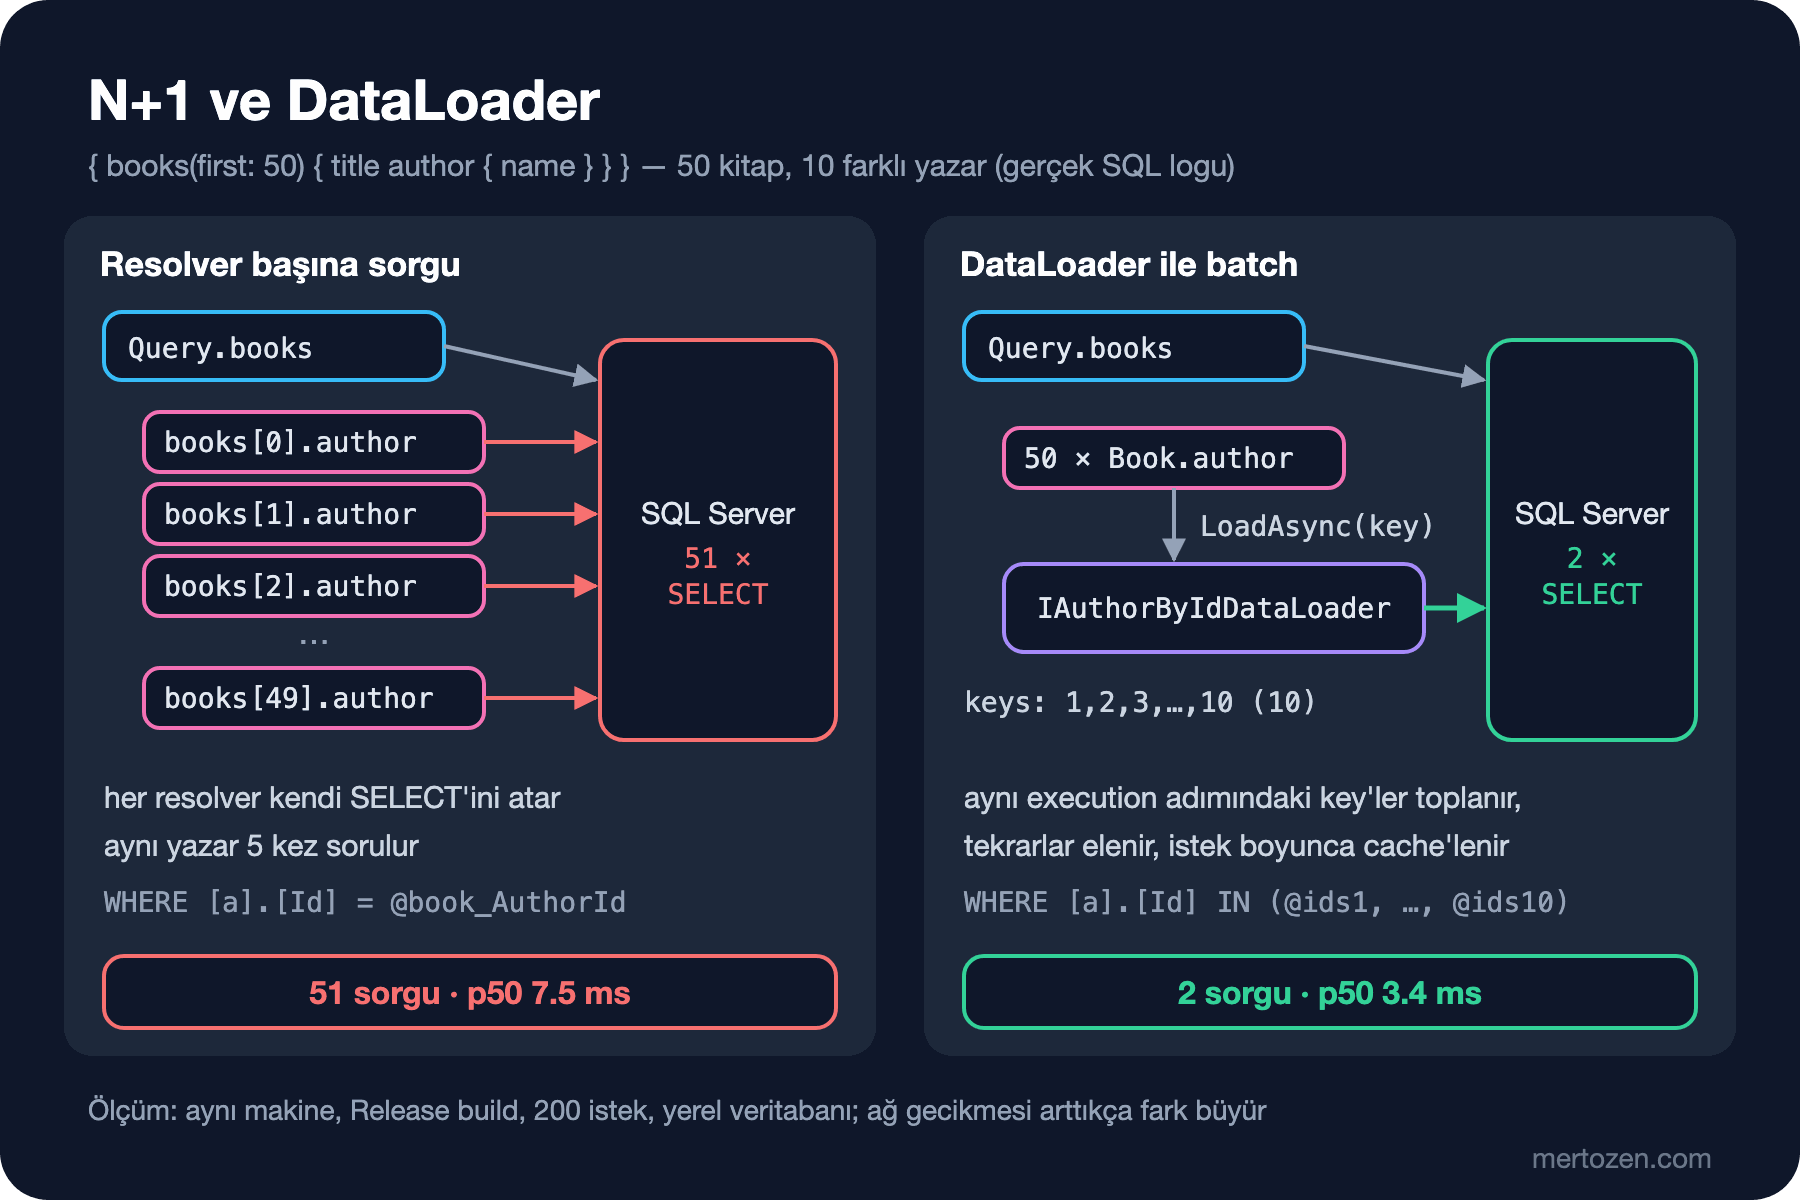
DataLoader'ın fikri basit: resolver "bu id'li yazarı ver" der ama hemen veritabanına gitmez. Aynı execution adımında başka resolver'lar da yazar ister; Hot Chocolate o adım bitince toplanan bütün key'leri tek bir çağrıyla DataLoader'a verir. Hot Chocolate 16'da DataLoader'ı bir static method ve [DataLoader] attribute'u ile yazıyorsun, class ve interface'i source generator üretiyor:
public static class AuthorDataLoaders
{
    [DataLoader]
    public static async Task<Dictionary<int, Author>> GetAuthorByIdAsync(
        IReadOnlyList<int> ids,
        BookstoreContext db,
        CancellationToken cancellationToken) =>
        await db.Authors
            .AsNoTracking()
            .Where(a => ids.Contains(a.Id))
            .ToDictionaryAsync(a => a.Id, cancellationToken);

    [DataLoader]
    public static async Task<ILookup<int, Book>> GetBooksByAuthorIdAsync(
        IReadOnlyList<int> authorIds,
        BookstoreContext db,
        CancellationToken cancellationToken)
    {
        List<Book> books = await db.Books
            .AsNoTracking()
            .Where(b => authorIds.Contains(b.AuthorId))
            .OrderBy(b => b.Id)
            .ToListAsync(cancellationToken);
        return books.ToLookup(b => b.AuthorId);
    }
}
İlki batch DataLoader: bir key'e bir değer, dönüş tipi Dictionary. İkincisi group DataLoader: bir key'e birden çok değer, dönüş tipi ILookup; "bu yazarın kitapları" gibi bire-çok ilişkiler için. Generator method adındaki Get ön ekini ve Async son ekini atıyor ve IAuthorByIdDataLoader ile IBooksByAuthorIdDataLoader interface'lerini üretiyor. Ayrıca kayıt yazmadım; AddCatalogTypes() bunları da ekledi. Resolver'lar artık veritabanını değil DataLoader'ı görüyor:
[ObjectType<Book>]
public static partial class BookNode
{
    public static async Task<Author?> GetAuthorAsync(
        [Parent] Book book,
        IAuthorByIdDataLoader authorById,
        CancellationToken cancellationToken) =>
        await authorById.LoadAsync(book.AuthorId, cancellationToken);
}

[ObjectType<Author>]
public static partial class AuthorNode
{
    public static async Task<Book[]> GetBooksAsync(
        [Parent] Author author,
        IBooksByAuthorIdDataLoader booksByAuthorId,
        CancellationToken cancellationToken) =>
        await booksByAuthorId.LoadAsync(author.Id, cancellationToken) ?? [];
}
Aynı sorgu, aynı 50 kitap:
SELECT TOP(@p) [b].[Id], [b].[AuthorId], ... FROM [Books] AS [b] ORDER BY [b].[Id]

Executed DbCommand (3ms) [Parameters=[@ids1='?' (DbType = Int32), @ids2='?' (DbType = Int32), ... @ids10='?' (DbType = Int32)], ...]
SELECT [a].[Id], [a].[Bio], [a].[Name]
FROM [Authors] AS [a]
WHERE [a].[Id] IN (@ids1, @ids2, @ids3, @ids4, @ids5, @ids6, @ids7, @ids8, @ids9, @ids10)
51 sorgu 2'ye indi. IN listesinde 50 değil 10 parametre var: DataLoader tekrar eden key'leri batch'e göndermeden önce eledi. Aynı ölçümde p50 3.4 ms, p95 5.3 ms oldu.
DataLoader'ın üçüncü işi istek başına cache. Şu sorgu kitaptan yazara, yazardan onun kitaplarına, oradan tekrar yazara gidiyor:
{ books(first: 3) { title author { name books { title author { name } } } } }SELECT TOP(@p) ... FROM [Books] AS [b] ORDER BY [b].[Id]
SELECT [a].[Id], [a].[Bio], [a].[Name] FROM [Authors] AS [a] WHERE [a].[Id] IN (@ids1, @ids2, @ids3)
SELECT [b].[Id], [b].[AuthorId], ... FROM [Books] AS [b] WHERE [b].[AuthorId] IN (@authorIds1, @authorIds2, @authorIds3) ORDER BY [b].[Id]Üç seviye derinlikte yine üç sorgu. En içteki author'lar için dördüncü bir sorgu yok; yazar 1, 2 ve 3 bu istekte zaten yüklenmişti ve DataLoader onları cache'ten verdi. Bu cache yalnız tek bir istek boyunca yaşar; istekler arası bir cache değildir ve bayat veri riski taşımaz.
Batch Resolver: Hot Chocolate 16'nın Yeni Yolu
DataLoader için iki parça yazdık: bir loader ve onu çağıran bir resolver. Hot Chocolate 16'nın [BatchResolver]'ı bunu tek method'a indiriyor; resolver tek bir parent yerine o field'ı isteyen bütün parent'ları birden alıyor:
[BatchResolver]
public static async Task<List<Author?>> GetAuthorAsync(
    [Parent(requires: nameof(Book.AuthorId))] List<Book> books,
    BookstoreContext db,
    CancellationToken cancellationToken)
{
    int[] ids = [.. books.Select(b => b.AuthorId).Distinct()];
    Dictionary<int, Author> authors = await db.Authors
        .AsNoTracking()
        .Where(a => ids.Contains(a.Id))
        .ToDictionaryAsync(a => a.Id, cancellationToken);
    return [.. books.Select(b => authors.GetValueOrDefault(b.AuthorId))];
}

[BatchResolver]
public static async Task<List<int>> GetSoldCountAsync(
    [Parent(requires: nameof(Book.Id))] List<Book> books,
    BookstoreContext db,
    CancellationToken cancellationToken)
{
    int[] ids = [.. books.Select(b => b.Id)];
    Dictionary<int, int> sold = await db.Set<OrderItem>()
        .Where(i => ids.Contains(i.BookId))
        .GroupBy(i => i.BookId)
        .Select(g => new { BookId = g.Key, Quantity = g.Sum(i => i.Quantity) })
        .ToDictionaryAsync(x => x.BookId, x => x.Quantity, cancellationToken);
    return [.. books.Select(b => sold.GetValueOrDefault(b.Id))];
}
Dönen listenin sırası parent listesinin sırasıyla aynı olmalı; eksik eleman dönersen fazla parent'lar sessizce null alır. [Parent(requires: ...)] parent'tan hangi property'nin gerektiğini söylüyor; projection devredeyken bu bilgi kritik, birazdan göreceğiz. { books(first: 50) { title soldCount author { name } } } üç sorguyla çalıştı: kitaplar, WHERE [a].[Id] IN (...) ile yazarlar ve GROUP BY [o].[BookId] ile satış toplamları. soldCount gibi bir aggregate batch resolver'ın doğal kullanım alanı: key ile yüklenen bir entity değil, field'a özgü bir hesap.
İki pratik not. Birincisi, dokümantasyon parent parametresi için IReadOnlyList<Book>'u da geçerli sayıyor, ama 16.7.5'in source generator'ı bu tiple derlenmeyen kod üretti (CS0144, interface'in instance'ı oluşturulamaz); List<Book> ile derlendi. İkincisi daha ciddi: aynı istekte ikinci bir root field olduğunda batch resolver'lı sorgular hiç dönmedi. { a: books(first: 2) { soldCount } b: books(first: 2) { title } } 70 saniye bekleyip yanıtsız kaldı; Hot Chocolate'ın 30 saniyelik varsayılan execution timeout'u bile devreye girmedi. Tek root field'lı sorgular sorunsuz çalıştı. Sorunu daraltmak için başlığın uzunluğunu dönen, senkron ve veritabanına hiç gitmeyen bir batch resolver (titleLength) yazdım; o da tek başına çalıştı, ikinci bir root field eklenince aynı biçimde takıldı. Hot Chocolate deposunda bu davranışı anlatan iki açık issue var (#9892 ve #10416). Batch resolver'ı yeni projede kullanmadan önce kendi sorgu şekillerinle dene; ben bu yazının geri kalanında DataLoader ile devam ediyorum.
İkisinin farkı tek cümlede: DataLoader key ile batch'ler ve cache'ler, farklı field'lardan, tiplerden ve derinliklerden gelen istekleri birleştirir; batch resolver field ile batch'ler ve cache'lemez. Entity'yi id'sinden yüklüyorsan DataLoader, field'a özgü bir hesap yapıyorsan batch resolver.
Projection ile DataLoader'ı Birlikte Kullanmak
DataLoader'lı hâlin bir kusuru logda duruyor: SELECT [a].[Id], [a].[Bio], [a].[Name]. Client yalnız name istedi ama Bio da geldi. Bir önceki yazıdaki [UseProjection] burada çalışmıyor, çünkü yazar artık IQueryable üzerinden değil bir DataLoader üzerinden yükleniyor. Hot Chocolate 16 bunun için QueryContext<T> getiriyor: resolver'ın seçim kümesini bir projection, filtre ve sıralama tanımına çeviriyor; With ile hem DataLoader'a hem de bir IQueryable'a uygulanabiliyor:
[DataLoader]
public static async Task<Dictionary<int, Author>> GetAuthorByIdAsync(
    IReadOnlyList<int> ids,
    QueryContext<Author> query,
    BookstoreContext db,
    CancellationToken cancellationToken) =>
    await db.Authors
        .AsNoTracking()
        .Where(a => ids.Contains(a.Id))
        .With(query)
        .ToDictionaryAsync(a => a.Id, cancellationToken);

public static async Task<Author?> GetAuthorAsync(
    [Parent] Book book,
    IAuthorByIdDataLoader authorById,
    QueryContext<Author> query,
    CancellationToken cancellationToken) =>
    await authorById.With(query).LoadAsync(book.AuthorId, cancellationToken);
Kitap listesine de aynı QueryContext<Book>'u verdim (kodu pagination bölümünde). İlk deneme sessizce yanlış sonuç verdi:
{"data":{"books":{"nodes":[{"title":"Distributed Systems Vol. 1","author":null},{"title":"Protobuf Vol. 1","author":null},{"title":"Streaming Vol. 1","author":null}]}}}

SELECT TOP(@p) [b].[Title], [b].[Id], [b].[Price] FROM [Books] AS [b] ORDER BY [b].[Price], [b].[Id]
SELECT [a].[Name] FROM [Authors] AS [a] WHERE [a].[Id] = @ids1
Hiç hata yok, bütün yazarlar null. Kitap sorgusu AuthorId'yi seçmedi: projection yalnız sorguda görünen field'ları biliyor, author'ı çözmek için resolver'ın AuthorId'ye ihtiyacı olduğunu bilemez. Bütün kitapların AuthorId'si 0 geldi, DataLoader tek bir key ile (@ids1) çağrıldı. Düzeltme, resolver'ın ihtiyacını beyan etmek: [Parent(requires: nameof(Book.AuthorId))] Book book. Bu kez kitap sorgusu [b].[AuthorId]'yi seçti ama sonuç yine düzelmedi, her author için "Unexpected Execution Error" geldi. Yazar sorgusu SELECT [a].[Name] idi; Id seçilmediği için ToDictionaryAsync(a => a.Id) bütün yazarları 0 key'ine yazmaya çalıştı. DataLoader'ın key'ini projection'a ayrıca eklemek gerekiyor:
await authorById.With(query).Include(a => a.Id).LoadAsync(book.AuthorId, cancellationToken);SELECT TOP(@p) [b].[AuthorId], [b].[Title], [b].[Id], [b].[Price] FROM [Books] AS [b] ORDER BY [b].[Price], [b].[Id]
SELECT [a].[Name], [a].[Id] FROM [Authors] AS [a] WHERE [a].[Id] IN (@ids1, @ids2, @ids3)Artık iki taraf da yalnız gerekeni seçiyor. Ama projection'ın DataLoader'a bir bedeli daha var. Aynı yazarları iki farklı seçimle isteyen bir sorgu:
{ a: books(first: 3) { nodes { author { name } } } b: books(first: 3) { nodes { author { name bio } } } }

SELECT [a].[Name], [a].[Id] FROM [Authors] AS [a] WHERE ...
SELECT [a].[Bio], [a].[Name], [a].[Id] FROM [Authors] AS [a] WHERE ...
Aynı üç yazar iki kez yüklendi. Farklı projection'lar DataLoader'ın ayrı kollarına düşüyor ve birbirinin cache'ini kullanamıyor; projection'sız DataLoader bu sorguda tek sorgu atardı. Kural olarak: geniş kolonlu (metin, JSON (JavaScript Object Notation), binary) entity'lerde projection'lı DataLoader kazandırır; dar tablolarda bütün kolonları bir kez çekip cache'i paylaşmak çoğu zaman daha ucuz. Hangisinin kazandığını tahmin etme, SQL logunda say.
Pagination: Offset, Cursor ve Keyset
books(first: 50) şu ana kadar keyfi bir sınırdı; client first: 100000 da yazabilirdi. GraphQL'de liste pagination'ının yerleşik biçimi Relay connection: edges (her biri cursor ve node), kısa yol olarak nodes ve pageInfo (hasNextPage, endCursor...). İlk deneme IQueryable üzerinde [UsePaging]:
[UsePaging(IncludeTotalCount = true)]
public static IQueryable<Book> GetBooks(BookstoreContext db) =>
    db.Books.AsNoTracking().OrderBy(b => b.Id);
{ books(first: 3) { nodes { id title } pageInfo { hasNextPage endCursor } totalCount } }
{"data":{"books":{"nodes":[{"id":1,...},{"id":2,...},{"id":3,...}],"pageInfo":{"hasNextPage":true,"endCursor":"Mg=="},"totalCount":50}}}
{ books(first: 3, after: "Mg==") { nodes { id title } } }
SELECT [b].[Id], [b].[AuthorId], ... FROM [Books] AS [b]
ORDER BY [b].[Id]
OFFSET @p ROWS FETCH NEXT @p1 ROWS ONLYCursor Mg== Base64 ile kodlanmış 2, yani sıfırdan başlayan bir satır indeksi. Bu, cursor kılığında offset pagination: sayfa ilerledikçe SQL Server atlanan satırları yine okur, araya yeni bir kitap eklenirse bir sonraki sayfada tekrar ya da kayıp olur. Varsayılanların ikisi işe yarıyor: sayfa boyutu verilmezse 10, en fazla 50. first: 500 isteyen sorgu HC0051 ile "The maximum allowed items per page were exceeded." aldı. Schema'da da @listSize(assumedSize: 50, slicingArguments: ["first", "last"]) belirdi; serinin güvenlik yazısında cost analysis bu bilgiyi kullanacak.
Gerçek keyset pagination için Hot Chocolate 16'nın PagingArguments ve ToPageAsync ikilisini kullanıyorum. ToPageAsync, HotChocolate.Data.EntityFramework ile gelen GreenDonut.Data kütüphanesinde:
[UseConnection(IncludeTotalCount = true)]
public static async Task<PageConnection<Book>> GetBooksAsync(
    PagingArguments pagingArguments,
    QueryContext<Book> query,
    BookstoreContext db,
    CancellationToken cancellationToken)
{
    Page<Book> page = await db.Books
        .AsNoTracking()
        .With(query, sort => sort.AddAscending(b => b.Price).AddAscending(b => b.Id))
        .ToPageAsync(pagingArguments, cancellationToken);
    return new PageConnection<Book>(page);
}
Schema builder'a bir de .AddPagingArguments() ekledim. Sıralama fiyata göre; fiyatlar benzersiz olmayabileceği için Id ikinci anahtar. Keyset pagination'da sıralama anahtarı benzersiz olmak zorunda, yoksa aynı fiyattaki kitaplar sayfa sınırında kaybolur.
{ books(first: 3) { nodes { id title price } pageInfo { endCursor } } }
"endCursor":"e30xNjUuMDA6Mw=="
# Base64 çözülünce: {}165.00:3

{ books(first: 3, after: "e30xNjUuMDA6Mw==") { nodes { id title price } pageInfo { hasNextPage endCursor } totalCount } }
{"data":{"books":{"nodes":[{"id":4,"title":"Compilers Vol. 1","price":170.00},{"id":5,"title":"GraphQL Vol. 1","price":175.00},{"id":6,"title":"Caching Vol. 1","price":180.00}],"pageInfo":{"hasNextPage":true,"endCursor":"e30xODAuMDA6Ng=="},"totalCount":50}}}

SELECT TOP(@p) (
    SELECT COUNT(*)
    FROM [Books] AS [b0]) AS [TotalCount], [b].[Id], [b].[AuthorId], ...
FROM [Books] AS [b]
WHERE [b].[Price] > @value OR ([b].[Price] = @value AND [b].[Id] > @value2)
ORDER BY [b].[Price], [b].[Id]
Cursor artık bir satır numarası değil, son kaydın sıralama anahtarları: fiyat 165.00 ve id 3. SQL de "bu anahtardan sonrakiler" diyor; (Price, Id) üzerinde bir index'le hangi sayfada olursan ol aynı hızda çalışır ve araya giren kayıtlar sayfaları kaydırmaz. Bedeli, istemciye "47. sayfaya atla" diyememek; keyset ileri ve geri gezinir, rastgele sayfaya atlamaz.
Son satırdaki COUNT(*)'a dikkat. totalCount istendiğinde Hot Chocolate onu aynı sorguya bir alt sorgu olarak ekledi. 50 satırda bedava; milyonlarca satırlık, filtreli bir tabloda her sayfa isteğinde tam bir sayım demek. IncludeTotalCount'ı yalnız gerçekten "toplam X sonuç" gösteren ekranlar için aç; sonsuz kaydırmalı bir liste hasNextPage ile yetinir.
Ölçmek: OpenTelemetry ve SQL Sayısı
SQL logu geliştirme ortamında iş görür; production'da aynı bilgiyi trace'ten okumak gerekir. HotChocolate.Diagnostics paketini ve OpenTelemetry'yi ekledim:
builder.Services
    .AddGraphQLServer()
    // ...
    .AddInstrumentation(o => o.Scopes = ActivityScopes.All);

builder.Services
    .AddOpenTelemetry()
    .WithTracing(tracing => tracing
        .AddAspNetCoreInstrumentation()
        .AddHotChocolateInstrumentation()
        .AddConsoleExporter());
İlk denemede yalnız AddHotChocolateInstrumentation() vardı ve konsola tek bir span düşmedi. ASP.NET Core instrumentation'ını ekleyince geldiler: Hot Chocolate'ın span'ları HTTP isteğinin span'ına bağlanıyor. query BookList { books(first: 5) { nodes { title author { name } } } } için ısınmış bir istekte span'lar ve süreleri:
Parse HTTP Request                            00:00:00.0000320
GraphQL Document Validation                   00:00:00.0000430
GraphQL Complexity Analysis                   00:00:00.0000100
Query.books                                   00:00:00.0032150
GraphQL DataLoader Batch QueryDataLoader`2    00:00:00.0027640
          graphql.dataloader.batch.size: 5
Book.author                                   00:00:00.0030930
          graphql.field.path: books.nodes[4].author
Book.author                                   00:00:00.0031260
          graphql.field.path: books.nodes[1].author
...
GraphQL Operation Execution                   00:00:00.0074060
query                                         00:00:00.0076680
GraphQL HTTP POST                             00:00:00.0083450
POST /graphql/{**slug}                        00:00:00.0084740
Hot Chocolate 16 span'ları GraphQL semantic convention'larına göre adlandırıyor. Resolver span'ının adı schema coordinate (Query.books, Book.author), attribute'ları graphql.field.path ve graphql.field.schema_coordinate. Root span yalnız operation tipini taşıyor (query), operation adı (BookList) graphql.operation.name attribute'unda; böylece span adlarının kardinalitesi düşük kalıyor. DataLoader batch'i ayrı bir span ve graphql.dataloader.batch.size ile kaç key'in tek seferde gittiğini gösteriyor. İlk (soğuk) istekte GraphQL Complexity Analysis span'ı ayrıca graphql.operation.fieldCost: 61 taşıyordu; bu sayıya güvenlik yazısında döneceğiz. N+1'i trace'te tanımak kolay: tek bir Query.books altında onlarca Book.author span'ı ve hiç DataLoader batch span'ı yoksa, her biri kendi sorgusunu atıyordur.
Bir not: ActivityScopes.All her resolver için span üretir; 50 kitaplık bir listede 50 Book.author span'ı demek. Production'da bunu sampling ile sınırla ya da yalnız istek, operation ve DataLoader scope'larını aç.
Üretimde Dikkat
Performans iddialarını gerçek istek ve sorgu sayısıyla ölç. Burada BenchmarkDotNet kullanmadım; bir resolver'ın mikro benchmark'ı, ağ ve veritabanıyla birlikte çalışan GraphQL execution'ı hakkında pek bir şey söylemez. Aynı sorguyu Release build'de yüzlerce kez gönderip p50/p95 ve Executed DbCommand sayısına bakmak hem basit hem dürüst.
DataLoader'ın IN listesine dikkat et. 50 key 50 SQL parametresi demek; varsayılan batch boyutu 1024 ve SQL Server bir isteğe en fazla 2100 parametre kabul ediyor. Çok büyük listeler için MaxBatchSize'ı düşür.
Her DataLoader kendi DbContext'ini kullansın. Bir önceki yazıdaki kural burada da geçerli: DataLoader batch'leri resolver'larla aynı anda çalışabilir, DbContext paylaşılamaz. Bu yazıdaki kurulumda (pooled factory ve RegisterDbContextFactory) source-generated DataLoader'a parametre olarak verdiğim BookstoreContext sorunsuz çalıştı. Elle yazdığın DataLoader class'larında ise constructor'dan IDbContextFactory<BookstoreContext> al ve her batch'te yeni bir context oluşturup dispose et.
Pagination'ı varsayılan yap. MaxPageSize ve RequirePagingBoundaries ile client'ı sınırla, listesi sınırsız büyüyebilen her field'ı connection olarak tasarla. Sonradan düz listeyi connection'a çevirmek kırıcı bir schema değişikliğidir.
Sık Düşülen Tuzaklar
Change tracker'ın N+1'i önleyeceğini sanmak. FirstOrDefaultAsync her çağrıda veritabanına gider. FindAsync önce change tracker'a bakar, ama yalnız aynı DbContext'in daha önce yüklediği entity'leri bilir; resolver başına ayrı DbContext kullanan bir GraphQL server'ında bu neredeyse hiç işe yaramaz.
Projection'lı sorguda resolver'ın ihtiyacını beyan etmemek. [Parent(requires: ...)] olmadan foreign key seçilmez ve ilişkili field hatasız biçimde null gelir.
DataLoader'ın key kolonunu projection'dan düşürmek. Include(a => a.Id) olmadan sözlük yanlış key'lerle dolar.
Benzersiz olmayan bir anahtarla keyset pagination. Sadece fiyata göre sıralarsan aynı fiyattaki kayıtlar sayfa sınırında kaybolur; her zaman benzersiz bir kolonu son anahtar olarak ekle.
[UsePaging]'in cursor'ını keyset sanmak. IQueryable üzerinde ürettiği cursor bir satır indeksi ve SQL'de OFFSET'e dönüşüyor.
Küçük Bir Deneme
★☆☆ BooksByAuthorId DataLoader'ını kullanan Author.books field'ı için, 10 yazarı ve kitaplarını getiren bir sorgu yaz ve SQL logunda kaç sorgu gittiğini say. Sonra aynı sorguya her kitabın yazarını da ekle; sayı değişti mi?
★★☆ totalCount'u açık ve kapalı iki sorgunun SQL'ini karşılaştır. Books tablosuna 200.000 satır ekleyip (Price, Id) index'i varken ve yokken keyset sayfasının ve COUNT(*)'ın sürelerini SQL Server'ın execution plan'ıyla ölç.
★★★ Author.books'u group DataLoader yerine her yazarın ilk 3 kitabını dönen sayfalı bir field'a çevir. Hot Chocolate 16'da DataLoader'a PagingArguments geçirmenin yolunu dokümantasyondan bul ve üretilen SQL'in her yazar için ayrı sorgu mu yoksa tek bir sorgu mu olduğunu kontrol et.
Sorgular artık hızlı ve sayfalı, ama bir client hâlâ yazardan kitaba, kitaptan yazara on seviye inen bir sorgu yazabilir ya da aynı field'ı yüz alias ile çoğaltabilir. Bir sonraki yazıda GraphQL'i güvenli işletmeyi konuşuyoruz: cost analysis, persisted operation'lar, authorization ve schema evolution.