

Terraform'da Sorun Giderme: Plan'ı Okumak, TF_LOG, Provider Hataları, State Kilidi, "Already Exists" ve Drift

Terraform'da sorun gidermenin ilk adımı hatanın hangi aşamada (init, plan ya da apply) çıktığına bakmak ve plan'daki notları okumaktır. Plan'ı metin ve JSON olarak okuyor, TF_LOG ile provider'ın içine bakıyor, lock file uyumsuzluğunu, "already exists" hatasını, kilitli state'i, provider'ın göremediği drift'i, cycle hatasını ve -target'ı gerçek çıktılarla inceliyor; Azure'da soft-delete'te bekleyen Key Vault vakasını çözüyoruz.
Sürüm notu: Bu yazıdaki örnekler Terraform 1.17.2, kreuzwerker/docker provider 4.7.0, hashicorp/http provider 3.6.3, pg backend için PostgreSQL 18, jq 1.7 ve Docker Engine 29 ile denenmiştir. Azure'a özgü hatalar AzureRM 5.14.0'ın dokümanı ve kaynak koduna göre anlatılmıştır.
Önce Tahmin Et
13. yazıda Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) Docker network'üne bir subnet verdik. Plan temizdi: tek bir kaynak, -/+, sebebi de açık. Apply ise şöyle bitti:
module.bookstore.docker_network.bookstore: Destroying... [id=<network-id>]
module.bookstore.docker_network.bookstore: Still destroying... [id=<network-id>, 00m10s elapsed]
module.bookstore.docker_network.bookstore: Still destroying... [id=<network-id>, 00m20s elapsed]
module.bookstore.docker_network.bookstore: Still destroying... [id=<network-id>, 00m30s elapsed]

Error: timeout while waiting for state to become 'removed' (last state: 'pending', timeout: 30s)
Hatanın sebebi nerede: Terraform'da mı, provider'da mı, Docker'da mı? Ve plan bu sorunu önceden gösterebilir miydi? Bu yazıda Terraform hatalarını hangi aşamada çıktıklarına göre ayırıp her birinde ilk bakılacak yeri buluyoruz; bu vaka da bunlardan biri.
Plan'ı Okumak: İşaretler, Notlar ve JSON
2. yazıda +, ~, -/+ ve - işaretlerini görmüştük. Sorun giderirken işaretlerden çok, resource başlığının altındaki notlar ve satır sonundaki yorumlar işe yarıyor. Bu seride karşılaştığımız notlar:
  # module.bookstore.docker_network.bookstore must be replaced
      + ipam_config { # forces replacement

  # module.bookstore.module.api.docker_container.this will be replaced, as requested

  # terraform_data.image will be updated in-place
  # (moved from terraform_data.api_image)

  # terraform_data.by_index["4"] will be destroyed
  # (because key ["4"] is not in for_each map)

  # module.bookstore.data.http.health will be read during apply
  # (config will be reloaded to verify a check block)

      ~ env                                         = (sensitive value) # forces replacement
      ~ id                                          = "..." -> (known after apply)
# forces replacement, replace'i hangi attribute'un tetiklediğini söyler. will be replaced, as requested, -replace flag'iyle istenen replace'tir. # (moved from ...), kaynağın bir moved block'u ile yeni adrese geldiğini ve üstüne bir değişiklik daha olduğunu gösterir; adres taşıması yeniden oluşturma demek değil. (because key ... is not in for_each map) çoğu zaman bir key'in değiştiğini, yani 13. yazıdaki index tuzağını işaret eder. will be read during apply, 5. yazıdaki check block'unun her plan'da tekrar okunmasıdır ve bir değişiklik sayılmaz. (known after apply) ise değerin apply'dan önce bilinmediğini söyler; replace olan bir kaynakta id'nin böyle görünmesi normal, ama bir değişikliğin sebebi bu satırdaysa değer başka bir kaynağın yeniden oluşmasına bağlıdır.
En zor olanı (sensitive value). 13. yazıda YAML (insanın kolay okuyup yazabildiği configuration formatı) dosyasındaki bir ayarı değiştirince plan yalnız "env değişti" dedi. Uzun plan'larda hangi kaynağın neden değiştiğini bir bakışta görmek için repo'ya küçük bir script ekledim, scripts/plan-changes.sh:
#!/usr/bin/env bash
# Kaydedilmiş bir plan'ın değiştirdiği her kaynağı ve replace'e zorlayan attribute'ları listeler.
# Kullanım: scripts/plan-changes.sh tfplan   (plan'ı üreten root module klasöründe çalıştır)
set -euo pipefail

plan=${1:-tfplan}

# JSON plan sensitive olanlar dahil her değeri düz metin tutar: asla kaydetme ya da yükleme
terraform show -json "$plan" | jq -r '
  .resource_changes[]?
  | select(.change.actions != ["no-op"] and .change.actions != ["read"])
  | [
      (.change.actions | join("+")),
      .address,
      (.change.replace_paths // [] | map(map(tostring) | join(".")) | join(", "))
    ]
  | @tsv'
$ terraform plan -out=tfplan
$ ../../../../scripts/plan-changes.sh tfplan
delete+create module.bookstore.docker_network.bookstore ipam_config
delete+create module.bookstore.module.api.docker_container.this networks_advanced, envreplace_paths alanı, metin çıktısındaki # forces replacement yorumlarının makine tarafından okunabilir karşılığı. delete+create sırası da önemli: create_before_destroy olan bir kaynakta create+delete görürsün. JSON'da sensitive değerler gizlenmiyor, yalnız after_sensitive alanında işaretleniyor. Bu yüzden hangi ayarın değiştiğini doğrudan karşılaştırabiliyorsun:
$ terraform show -json tfplan | jq -r '.resource_changes[]
    | select(.address | endswith("docker_container.this"))
    | (.change.before.env - .change.after.env | map("- " + .))[],
      (.change.after.env - .change.before.env | map("+ " + .))[]'
- Bookstore__Catalog__PageSize=20
+ Bookstore__Catalog__PageSize=25
Aynı sebepten JSON plan'ı bir CI artifact'ı olarak yüklemek ya da log'a basmak, 9. yazıda kaçındığımız secret sızıntısının ta kendisi. jq'nun bu tür sorgularını sitedeki JSON, YAML ve Configuration Formatları serisinin "jq ve yq" yazısında ayrıntılı bulabilirsin.
TF_LOG ile İçeriye Bakmak
Hata mesajı yetmediğinde Terraform'un log'u açılıyor. TF_LOG seviyeyi (TRACE, DEBUG, INFO, WARN, ERROR), TF_LOG_PATH dosyayı belirliyor. TF_LOG_CORE ve TF_LOG_PROVIDER ile yalnız Terraform'un ya da yalnız provider'ların log'unu açabiliyorsun; provider hatalarında ikincisi gereksiz satırların çoğunu eliyor. Değişkenleri yalnız o komut için ver; PowerShell'de aynısını $env:TF_LOG_PROVIDER = "DEBUG" ile yapıp iş bitince Remove-Item Env:TF_LOG_PROVIDER ile kaldırırsın:
TF_LOG_PROVIDER=DEBUG TF_LOG_PATH=terraform.log terraform apply tfplanTahmin sorusundaki apply'ı bu ayarla tekrar çalıştırdım. Log'da provider'ın ne yaptığı açıkça görünüyor:
[INFO] Waiting for network: '<network-id>' to be removed: max '30s seconds'
[DEBUG] Waiting for state to become: [removed]
[TRACE] Waiting 5s before next try
[TRACE] Waiting 10s before next try
[TRACE] Waiting 10s before next try
[TRACE] Waiting 10s before next try
[WARN] WaitForState timeout after 30s
Provider network'ü silme isteğini gönderip silinmesini bekliyor ve 30 saniye sonra vazgeçiyor; Docker'ın neden silmediğini ise log'a yazmıyor. Sebebi bulmak için aynı işlemi aracın kendisiyle yaptım:
$ docker network rm tfseries-dev
Error response from daemon: error while removing network: network tfseries-dev has active endpoints (name:"tfseries-dev-api" id:"<id>")
Bu, provider hatalarında işe yarayan genel bir yöntem: provider'ın yaptığı API çağrısını cloud'un kendi CLI'ıyla (Azure'da az) tekrarlamak çoğu zaman gerçek hata mesajını verir. Tahmin sorusunun cevabı da burada. Sorun ne Terraform'da ne Docker'da; kodda. Container network'e adıyla bağlıydı, network'ün adı değişmediği için plan container'a dokunmadı, ama Docker bağlı bir container varken network'ü silmiyor. Plan bunu gösteremezdi, çünkü bu kısıt Docker API'sinde, provider'ın şemasında değil. 13. yazıdaki çözüm, container'a network'ün ID'sini vermekti: ID değişince plan iki kaynağı da replace ediyor ve Terraform önce container'ı siliyor.
Log'da iki şeye dikkat. Birincisi, her plan'da şu uyarıyı göreceksin:
[WARN] Provider "registry.terraform.io/kreuzwerker/docker" produced an invalid plan for module.bookstore.module.api.docker_volume.data["covers"], but we are tolerating it because it is using the legacy plugin SDK.Bu, eski plugin SDK'sıyla yazılmış provider'larda normal; hatanın sebebi o değil, aramaya devam et. İkincisi daha önemli: DEBUG log'u provider'ın gördüğü her değeri içeriyor. TF_LOG=DEBUG ile aldığım log'da Bookstore__Payments__ApiKey'in değeri düz metin olarak geçiyordu; sensitive yalnız Terraform'un kendi ekran çıktısını gizliyor. Log dosyasını bir issue'ya eklemeden önce temizle, iş bitince de sil. Repo'nun .gitignore'una terraform.log'u bu yüzden ekledim.
Init ve Import Hataları: Lock File ve "Already Exists"
Provider sürüm kısıtını değiştirip init'i atlarsan plan hiç başlamıyor:
$ terraform plan
Error: Inconsistent dependency lock file

The following dependency selections recorded in the lock file are
inconsistent with the current configuration:
  - provider registry.terraform.io/kreuzwerker/docker: locked version selection 4.7.0 doesn't match the updated version constraints "~> 3.6"

To update the locked dependency selections to match a changed configuration,
run:
  terraform init -upgrade
Düz terraform init de aynı sebeple duruyor ve init -upgrade'i öneriyor. Burada durup düşün: mesaj komutu söylüyor, ama kısıtı ~> 4.7'den ~> 3.6'ya indiren değişiklik bilinçli mi? Bir pull request'te lock file ile kısıt arasında böyle bir fark görürsen, önce kimin neden değiştirdiğini sor. -upgrade lock file'ı yeni seçimle yeniden yazar, yani provider'ın bütün ortamlardaki sürümünü değiştirir.
"Already exists" hatası ise kaynağın bulutta olduğu ama state'te olmadığı anlamına gelir. Elle oluşturulmuş bir network'ü Terraform'la oluşturmaya çalıştım:
docker_network.reports: Creating...

Error: Unable to create network: Error response from daemon: network with name tfseries-reports already exists

  with docker_network.reports,
  on main.tf line 12, in resource "docker_network" "reports":
  12: resource "docker_network" "reports" {
Çözüm silmek değil, 8. yazıdaki import block'u:
import {
  to = docker_network.reports
  id = "tfseries-reports"
}
# docker_network.reports will be imported
Plan: 1 to import, 0 to add, 0 to change, 0 to destroy.
...
Apply complete! Resources: 1 imported, 0 added, 0 changed, 0 destroyed.Import'tan sonraki plan "No changes" dedi. Bu hatanın sık görülen sebeplerinden biri yarıda kalmış bir apply'dır: provider kaynağı oluşturur, ama Terraform state'e yazamadan süreç ölür. Böyle bir durumda önce kaynağın gerçekten Terraform'un yarıda bıraktığı kaynak olduğundan emin ol, sonra import et.
Kilitli State ve force-unlock
4. yazıda kilidi görmüştük. Bu kez onay ekranında bekleyen bir apply varken ikinci bir plan aldım:
Error: Error acquiring the state lock

Error message: Workspace is already locked: default
Lock Info:
  ID:        83cf26d1-dc0a-de24-b954-fc940a11bf38
  Path:
  Operation: OperationTypePlan
  Who:       user@my-pc
  Version:   1.17.2
  Created:   2026-11-15 08:12:48.5891 +0000 UTC
  Info:
-lock-timeout=5s ile aynı komut beş saniye bekleyip aynı hatayla döndü. Sonra 4. yazının uyarısını bilerek force-unlock'u uydurma bir ID ile denedim:
$ terraform force-unlock -force 12345
Terraform state has been successfully unlocked!

The state has been unlocked, and Terraform commands should now be able to
obtain a new lock on the remote state.
$ terraform plan
Error: Error acquiring the state lock
Komut başarılı olduğunu söyledi, ama kilit yerinde duruyordu. pg backend'in dokümanı force-unlock'un desteklenmediğini, advisory lock'un bağlantı kopunca kendiliğinden açıldığını söylüyor; CLI ise bunu hata olarak göstermiyor. Buradan çıkan ders genel: bir komutun "başarılı" demesi, sorunun çözüldüğünü göstermez, aynı işlemi tekrar dene. Gerçek çözüm, kilidi tutan süreci bulmaktı; o süreç bitince kilit açıldı.
Azure Storage backend'inde ise kilit blob lease'idir ve çöken süreç onu bırakmaz; orada force-unlock <ID> gerçekten gerekir. Güvenli olduğu tek durum, Lock Info'daki Who ve Created değerlerinden sürecin sahibini bulup bittiğinden emin olduğun durum. 11. yazıdaki pipeline'da bu, ilgili workflow çalışmasının iptal edilmiş ya da bitmiş olduğunu GitHub'da görmek demek.
Drift, Cycle ve -target
Drift'i 4. ve 12. yazıda gördük; bu kez provider'ın göremediği bir drift'e rastladım. API container'ını paylaşılan network'ten elle çıkardım (docker network disconnect). Normal plan:
Plan: 0 to add, 0 to change, 0 to destroy.terraform plan -refresh-only ise değişikliği yalnız hesaplanan network_data listesinde gösterdi; networks_advanced hâlâ iki network'ü listeliyordu. Provider bu attribute'u container'ın gerçek bağlantılarıyla karşılaştırmıyor, bu yüzden plan "her şey yolunda" diyor. "No changes" demek, provider'ın okuduğu her şeyin kodla eşleştiği demek; gerçek dünyanın tamamı değil. Bir kaynağın bozulduğundan eminsen ve plan bunu göremiyorsa, kaynağı Terraform'la yeniden oluştur:
$ terraform apply -replace=module.bookstore.module.api.docker_container.this
  # module.bookstore.module.api.docker_container.this will be replaced, as requested
Plan: 1 to add, 0 to change, 1 to destroy.
Cycle hatası ise iki kaynağın birbirine referans vermesinden çıkar:
resource "terraform_data" "api" {
  input = { worker_url = "http://${terraform_data.worker.output.name}:8080" }
}

resource "terraform_data" "worker" {
  input = { name = "worker", api_url = terraform_data.api.output.worker_url }
}
$ terraform validate
Error: Cycle:
terraform_data.api
terraform_data.workerHata, dependency graph'ın bir döngü içerdiğini ve döngüdeki kaynakları söylüyor. Çözüm hep aynı: döngüyü kuran değerlerden birini kaynağın output'undan değil, bir local ya da variable'dan almak. Burada worker'ın adı zaten sabit; local.worker_name olarak tanımlayıp iki tarafta da kullanınca döngü kalkar. 5. yazıdaki gereksiz depends_on'lar da aynı hatayı üretebilir.
-target ise plan'ı yalnız seçilen adreslere ve onların bağımlılıklarına daraltır. Terraform bunu kendisi uyarıyor:
$ terraform plan -target=module.bookstore.module.api

Warning: Resource targeting is in effect

You are creating a plan with the -target option, which means that the result
of this plan may not represent all of the changes requested by the current
configuration.

The -target option is not for routine use, and is provided only for
exceptional situations such as recovering from errors or mistakes, or when
Terraform specifically suggests to use it as part of an error message.
Yarıda kalmış bir apply'dan sonra tek bir kaynağı düzeltmek için meşru bir araç. Ama alışkanlık hâline gelirse state ile kod arasında hiç apply edilmemiş değişiklikler birikir; -target'lı her apply'dan sonra hedefsiz bir plan alıp "No changes" görene kadar devam et.
Azure'a Özgü Hatalar ve Soft-Delete'te Bekleyen Key Vault
Bu bölümde resmî belgelerden yararlanılmıştır.
Azure'da apply sırasında gelen hatalar çoğunlukla Azure Resource Manager'ın HTTP durum kodlarıyla gelir. 403'te hata kodu genellikle AuthorizationFailed'dır ve mesaj hangi identity'nin hangi action'ı hangi scope'ta yapamadığını söyler; 11. yazıdaki en az yetkili role bu yüzden hatayla birlikte genişletilir, tahminle değil. 429 throttling demektir: AzureRM'in kullandığı Azure SDK'sı 429'u geçici hata sayıyor ve Retry-After header'ına uyarak yeniden deniyor; bu hata bir apply'ı durdurduysa, aynı anda çalışan çok sayıda apply'ı azaltmak gerekir. 409 ise bir çakışma: aynı kaynak üzerinde süren başka bir işlem ya da zaten var olan bir kaynak.
Var olan kaynak için AzureRM, oluşturmadan önce kendisi bakıyor. Provider'ın kaynak kodundaki mesaj, kaynağın ID'siyle birlikte "a resource with the ID ... already exists - to be managed via Terraform this resource needs to be imported into the State" diyor. Çözüm Docker örneğindeki gibi bir import block'u.
Bookstore'da bunun en can sıkıcı biçimi Key Vault'ta görülür. Diyelim ki dev ortamının kendi vault'u var (kv-bookstore-dev-weu) ve ortamı destroy edip ertesi gün yeniden kuruyorsun. Key Vault'ta soft-delete her zaman açıktır: silinen vault 7 ile 90 gün arasında bir süre "deleted" durumunda bekler ve vault adları Azure genelinde tektir. AzureRM'in features block'unda iki ayar bu davranışı yönetir:
provider "azurerm" {
  features {
    key_vault {
      purge_soft_delete_on_destroy    = true
      recover_soft_deleted_key_vaults = true
    }
  }
}
İkisinin de varsayılanı true. Destroy'da provider vault'u kalıcı olarak siler (purge), ama purge protection açıksa bu mümkün değildir ve vault saklama süresi boyunca bekler. Yeniden oluştururken provider önce aynı adla silinmiş bir vault arar ve bulursa geri getirir; yani "yeni" vault, eskisinin secret'larıyla gelir. recover_soft_deleted_key_vaults = false ise provider "An existing soft-deleted Key Vault exists with the Name ..." diye başlayan bir hatayla durur ve vault'u elle geri getirip import etmeni ya da başka bir ad seçmeni önerir. Kaynak kodda bir ayrıntı daha var: identity'nin subscription seviyesinde silinmiş vault'ları okuma yetkisi yoksa bu kontrol 403 alıp atlanıyor ve oluşturma isteği doğrudan Azure'un ad çakışmasına takılıyor. Durumu görmek ve çözmek için:
az keyvault list-deleted --resource-type vault
az keyvault recover --name kv-bookstore-dev-weu
az keyvault purge --name kv-bookstore-dev-weurecover'dan sonra vault'u import ile state'e al; purge protection yoksa ve içindeki secret'lara ihtiyacın yoksa purge ile adı serbest bırak. Sık kurulup yıkılan ortamlarda vault adına random_string ile kısa bir son ek eklemek bu sorunu baştan önler.
Üretimde Dikkat
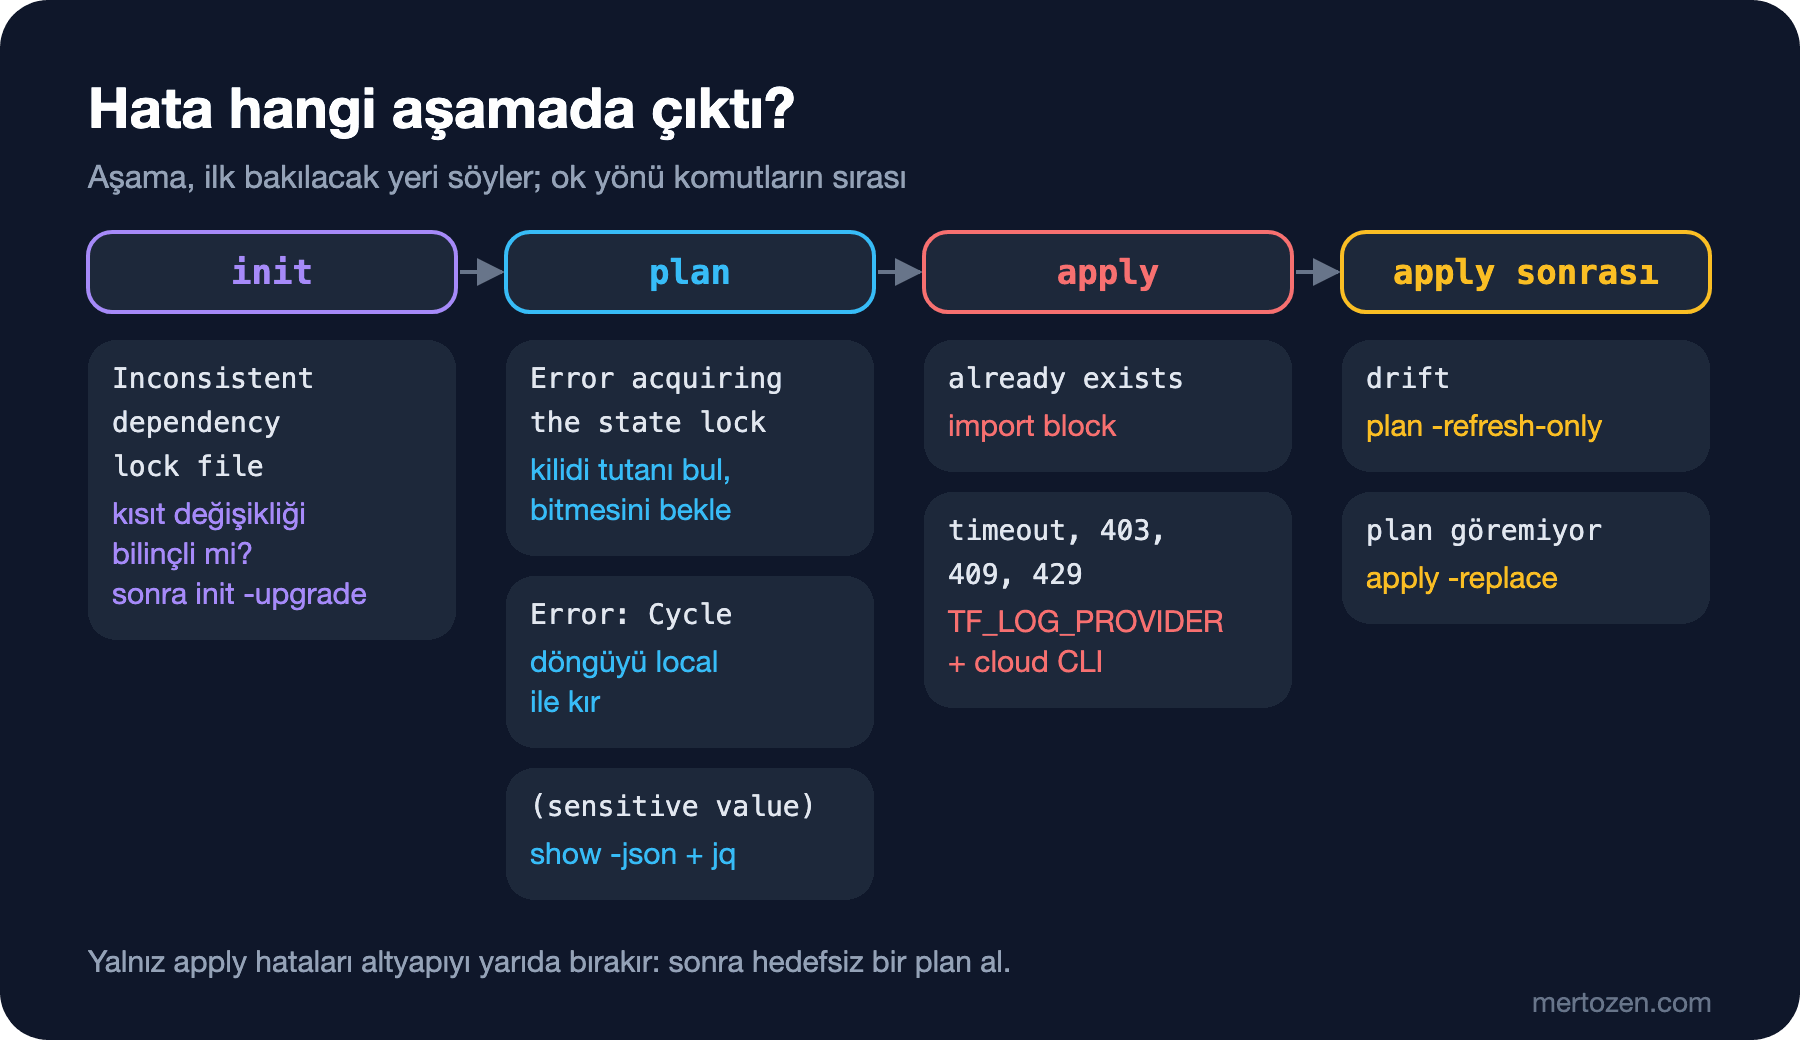
Hata mesajını hangi aşamada aldığına bak: init'te çıkan hata provider indirme ve lock file'la, plan'da çıkan hata kod, state ve kilitle, apply'da çıkan hata ise provider'ın ve cloud API'nin davranışıyla ilgilidir. Yalnız apply hataları altyapıyı yarıda bırakabilir; ondan sonraki ilk iş, hedefsiz bir plan alıp state'in neyi bildiğini görmek.
Yarıda kalmış bir apply'dan sonra paniğe kapılıp state'i elle düzenleme. Hata ile biten bir apply'da bile tamamlanan kaynaklar state'e yazılır; çoğu zaman bir sonraki plan neyin tamamlandığını doğru gösterir. Kalan sorunlar için 4. ve 8. yazıdaki araçlar (import, state rm, moved) yeterli.
CI'da log ve plan çıktısını sınırla. TF_LOG'u pipeline'da kalıcı olarak açma, JSON plan'ı artifact olarak yükleme; ikisi de secret içerir. Hata ayıklaman gerekiyorsa log'u lokal bir koşuda al.
Sık Düşülen Tuzaklar
Plan'ı okumadan apply etmek. Bu yazıdaki vakaların çoğunda ipucu plan'daydı: (because key ... is not in for_each map), # forces replacement, (sensitive value). Uzun bir plan'ı scripts/plan-changes.sh ile özetini çıkar, sonra özetteki her satırın sebebini bul.
-auto-approve'u lokal alışkanlık yapmak. CI'da saved plan'la apply ediyoruz (11. yazı), çünkü onaylanan plan ile uygulanan plan aynı. Lokalde -auto-approve, plan'ı hiç görmeden apply etmek demek; bir gün yanlış ortamın klasöründe çalıştırırsın.
Hata mesajındaki komutu düşünmeden çalıştırmak. init -upgrade, force-unlock, -target ve -lock=false hatayı ortadan kaldırır, ama sebebini değil. Her birinden önce, mesajın neden çıktığını bir cümleyle söyleyebiliyor olmalısın.
Küçük Bir Deneme
★☆☆ infra/local/envs/dev'de appsettings.yaml'daki bir değeri değiştir, terraform plan -out=tfplan al ve scripts/plan-changes.sh tfplan ile özetini çıkar. Sonra terraform show tfplan çıktısıyla karşılaştır: özet neyi gösteriyor, metin çıktısı neyi gizliyor?
★★☆ Container'ın restart policy'sini docker update ile elle değiştir. Normal plan ve -refresh-only plan bu değişikliği görüyor mu? Görmüyorsa, bu attribute için drift'i nasıl yakalardın?
★★★ Bu yazıdaki hataların her biri için (lock file, already exists, kilit, cycle, zaman aşımı) scripts/check-infra.sh'a ya da 11. yazıdaki pull request workflow'una hatayı erken yakalayacak bir kontrol ekle. Hangileri plan'dan önce yakalanabiliyor, hangileri ancak apply sırasında ortaya çıkıyor?
Serinin sonuna geldik. Bookstore'un altyapısı artık kodda: ortam başına state, module'ler, secret'ları state'e yazmayan kaynaklar, testler, onaylı apply yapan bir pipeline ve bir şey ters gittiğinde nereye bakacağını bilen bir ekip. Bu altyapının üzerinde uygulamayı yayına almak, deployment stratejileri ve Kubernetes tarafı, sitedeki CI/CD ve Kubernetes serilerinin konusu.