

Terraform Built-in Function'ları ve Expression Kalıpları: String, Collection, Encoding, Filesystem ve Network Fonksiyonları, for, Splat ve terraform console

Terraform expression'larını rahat yazmanın yolu, 119 built-in fonksiyonu aileleriyle tanımak ve her ifadeyi önce terraform console'da denemektir. String, collection, encoding, filesystem ve network fonksiyonlarını, for ve splat'i, optional() varsayılanlarını ve AzureRM'in provider function'larını deniyor; Bookstore'da ortam başına subnet'i cidrsubnet ile, API ayarlarını da YAML'dan kuruyoruz.
Sürüm notu: Bu yazıdaki örnekler Terraform 1.17.2, OpenTofu 1.13.9, kreuzwerker/docker provider 4.7.0, hashicorp/azurerm provider 5.14.0 ve Docker Engine 29 ile denenmiştir. AzureRM kodu validate ve mock'lu terraform test ile doğrulandı.
Önce Tahmin Et
Bookstore'un (sitedeki serilerin ortak örnek uygulaması, bir online kitapçı) API ayarlarını tfvars'taki uzun bir map yerine bir YAML (insanın kolay okuyup yazabildiği bir configuration formatı) dosyasında tutmak istiyoruz:
Bookstore:
  Catalog__PageSize: 20
  Features__Recommendations: false
Terraform bu dosyayı yamldecode ile okuyup container'a environment variable olarak verecek. İki sorum var. Container'ın içinde bu iki değer hangi adla ve hangi tipte görünür? Ve bu değişikliği yapınca plan, hangi ayarın değiştiğini sana söyler mi? Cevaplar yazının Bookstore bölümünde.
terraform console ve Fonksiyon Listesi
3. yazıda merge, lookup, try ve convert'i görmüştük. Terraform 1.17'de kaç built-in fonksiyon olduğunu binary'nin kendisine sorabilirsin:
$ terraform metadata functions -json | jq '.function_signatures | keys | map(select(contains("::") | not)) | length'
119
Listede her fonksiyon bir de core:: önekiyle geçiyor (core::merge). Bu, 1.8 ile gelen provider-defined function'larla ad çakışması olursa built-in olanı açıkça seçmenin yolu. 119 fonksiyonun hepsini ezberlemek gerekmiyor; aileleri bilmek ve emin olmadığın her ifadeyi önce terraform console'da denemek yeterli.
Bunun için repo'ya provider'sız, state'siz küçük bir klasör ekledim: infra/examples/functions. Burada terraform init bile gerekmiyor; terraform console açıp yazmaya başlıyorsun. Console'a ifadeyi pipe ile de verebilirsin: echo 'local.retention' | terraform console. Bu, bir ifadenin çıktısını script'te kontrol etmek için kullanışlı.
# Built-in fonksiyonlar için deneme alanı: provider yok, state yok; terraform console'u burada çalıştır
terraform {
  required_version = "~> 1.17"
}

variable "environment" {
  type    = string
  default = "dev"
}

variable "image" {
  type    = string
  default = "bookstore-api:1.1.0"
}

locals {
  environments = ["dev", "staging", "prod"]
  data_sets    = ["covers", "exports"]

  # Veri setine göre blob'ların saklanacağı gün sayısı
  retention = zipmap(local.data_sets, [365, 30])

  settings = yamldecode(file("${path.module}/appsettings.yaml"))
}
Aşağıdaki console çıktılarının hepsi bu klasörden.
String Fonksiyonları
> format("%s-bookstore-%s-%s", "app", var.environment, "weu")
"app-bookstore-dev-weu"
> join(",", local.data_sets)
"covers,exports"
> split("/", "bookstore/dev.tfstate")
tolist([
  "bookstore",
  "dev.tfstate",
])
> replace("bookstore-dev-weu", "-", "")
"bookstoredevweu"
> regex("^(?P<name>[^:]+):(?P<tag>.+)$", var.image)
{
  "name" = "bookstore-api"
  "tag" = "1.1.0"
}
> regex("^(?P<name>[^:]+):(?P<tag>.+)$", "bookstore-api")

Error: Error in function call

Call to function "regex" failed: pattern did not match any part of the
given string.

> trimprefix("refs/tags/v1.1.0", "refs/tags/v")
"1.1.0"
> lower("Bookstore-API")
"bookstore-api"format, naming convention'ı tek satırda kurmanın en okunur yolu; birden fazla parçayı birleştirirken iç içe interpolation'dan daha temiz duruyor. replace, storage account adındaki tireleri siliyor: Azure storage account adı yalnız küçük harf ve rakam kabul ettiği için 3. yazıdaki compact_suffix tam olarak bunu yapıyordu. regex'te isimli grup kullanırsan sonuç bir object oluyor ve .tag ile alanına erişebiliyorsun. Eşleşme yoksa ise hata veriyor; bu önemli, çünkü aşağıda can ile bu hatayı bir doğrulamaya çeviriyoruz. trimprefix, CI'da Git tag'inden (refs/tags/v1.1.0) image tag'i çıkarmak için yeterli; regex'e gerek yok.
Collection Fonksiyonları ve Tip Dönüşümü
> flatten([["covers", "exports"], ["reports"], []])
[
  "covers",
  "exports",
  "reports",
]
> setproduct(local.environments, local.data_sets)
tolist([
  [
    "dev",
    "covers",
  ],
  [
    "dev",
    "exports",
  ],
  ...
])
> local.retention
{
  "covers" = 365
  "exports" = 30
}
> coalesce("", null, "B1")
"B1"
> one([])
null
> one(["westeurope", "northeurope"])

Error: Invalid function argument

Invalid value for "list" parameter: must be a list, set, or tuple value with
either zero or one elements.

> can(regex("^97[89][0-9]{10}$", "9780441013593"))
true
> can(regex("^97[89][0-9]{10}$", "978-0441013593"))
false
> try(local.settings.Bookstore.Search__PageSize, 50)
50
flatten iç içe listeleri tek seviyeye indiriyor; boş liste sonuca bir şey eklemiyor. setproduct iki listenin bütün kombinasyonlarını veriyor: üç ortam ve iki veri seti için altı çift (çıktıyı kısalttım). zipmap iki listeyi key ve value olarak eşleştirip map kuruyor. coalesce null ve boş string olmayan ilk argümanı dönüyor; hepsi boşsa hata veriyor. one ise "en fazla bir eleman bekliyorum" demenin yolu: boş listede null, iki elemanda hata. count = var.enabled ? 1 : 0 ile oluşturulmuş bir kaynağın değerini almak için one(azurerm_key_vault.bookstore[*].id) yazmak, [0]'ın boş listede patlamasından daha güvenli.
can, bir ifade hata veriyorsa false dönüyor. Bu yüzden en çok variable validation'ında işe yarıyor: 13 haneli ISBN (kitapların uluslararası standart numarası) doğrulaması gibi bir kuralı tek satırla yazabiliyorsun. try ise hata yerine bir varsayılan dönüyor. İkisinin de sınırı var, tuzaklar bölümünde göreceğiz.
Tip dönüşümü fonksiyonları da bu aileye yakın:
> toset(["covers", "exports", "covers"])
toset([
  "covers",
  "exports",
])
> tomap({ dev = 1, staging = "2" })
tomap({
  "dev" = "1"
  "staging" = "2"
})
> tonumber("18480")
18480
> tostring(true)
"true"
toset tekrarları siliyor ve sırayı garanti etmiyor; for_each'e liste verilemediği için listeyi set'e çevirmenin standart yolu. tomap'teki davranışa dikkat: map'in bütün value'ları aynı tipte olmak zorunda, bu yüzden Terraform 1'i de string'e çevirdi. Aynı dönüşüm variable tiplerinde de oluyor ve Bookstore bölümünde tam bu davranışa güveneceğiz.
Encoding, Filesystem ve Network Fonksiyonları
> local.settings
{
  "Bookstore" = {
    "Catalog__PageSize" = 20
    "Features__Recommendations" = false
  }
  "Logging" = {
    "LogLevel__Default" = "Information"
  }
}
> jsonencode({ environment = var.environment, data_sets = local.data_sets })
"{\"data_sets\":[\"covers\",\"exports\"],\"environment\":\"dev\"}"
> base64encode("Bookstore__Environment=dev")
"Qm9va3N0b3JlX19FbnZpcm9ubWVudD1kZXY="
> fileset(path.module, "templates/*.tftpl")
toset([
  "templates/appsettings.json.tftpl",
])
yamldecode(file(...)) dosyayı okuyup Terraform değerine çeviriyor; YAML'daki 20 number, false bool olarak geliyor. jsonencode key'leri alfabetik sıraya diziyor; aynı girdi her zaman aynı string'i verdiği için plan'da sahte fark çıkmıyor. path.module, ifadenin yazıldığı module'ün klasörü; dosya yollarını hep buna göre kur, yoksa yol terraform'u çalıştırdığın klasöre göre çözülür.
templatefile bir dosyayı template olarak işliyor. Çıktı JSON ya da YAML olacaksa dokümanın önerisi, template'i elle JSON gibi yazmak yerine içinde tek bir jsonencode çağrısı kullanmak; tırnak ve virgül hatalarını böyle hiç yaşamazsın:
${jsonencode({
  Bookstore = {
    Environment = environment
    Catalog     = { PageSize = page_size }
  }
  AllowedHosts = join(";", hosts)
})}
> templatefile("${path.module}/templates/appsettings.json.tftpl", { environment = "dev", page_size = 20, hosts = ["localhost", "bookstore.example.com"] })
<<EOT
{"AllowedHosts":"localhost;bookstore.example.com","Bookstore":{"Catalog":{"PageSize":20},"Environment":"dev"}}
EOTSondaki boş satır, template dosyasının son satır sonu. Bir dosyaya yazacaksan sorun değil; bir attribute'la karşılaştıracaksan chomp ile kes. file ve templatefile, plan başlamadan diskte duran dosyaları okur. Dokümanın vurguladığı gibi fonksiyonlar dependency graph'a katılmadığı için apply sırasında oluşturulan bir dosyayı okuyamazlar.
Network fonksiyonları IP aralıklarını hesaplıyor. cidrsubnet(prefix, newbits, netnum), CIDR (bir IP aralığını adres ve önek uzunluğuyla yazma biçimi, ör. /16) olarak verilen aralığa newbits kadar bit ekleyip netnum'uncu alt ağı veriyor:
> cidrsubnet("10.80.0.0/16", 8, 1)
"10.80.1.0/24"
> cidrhost(cidrsubnet("10.80.0.0/16", 8, 1), 1)
"10.80.1.1"
> cidrsubnets("10.40.0.0/16", 8, 8, 4)
tolist([
  "10.40.0.0/24",
  "10.40.1.0/24",
  "10.40.16.0/20",
])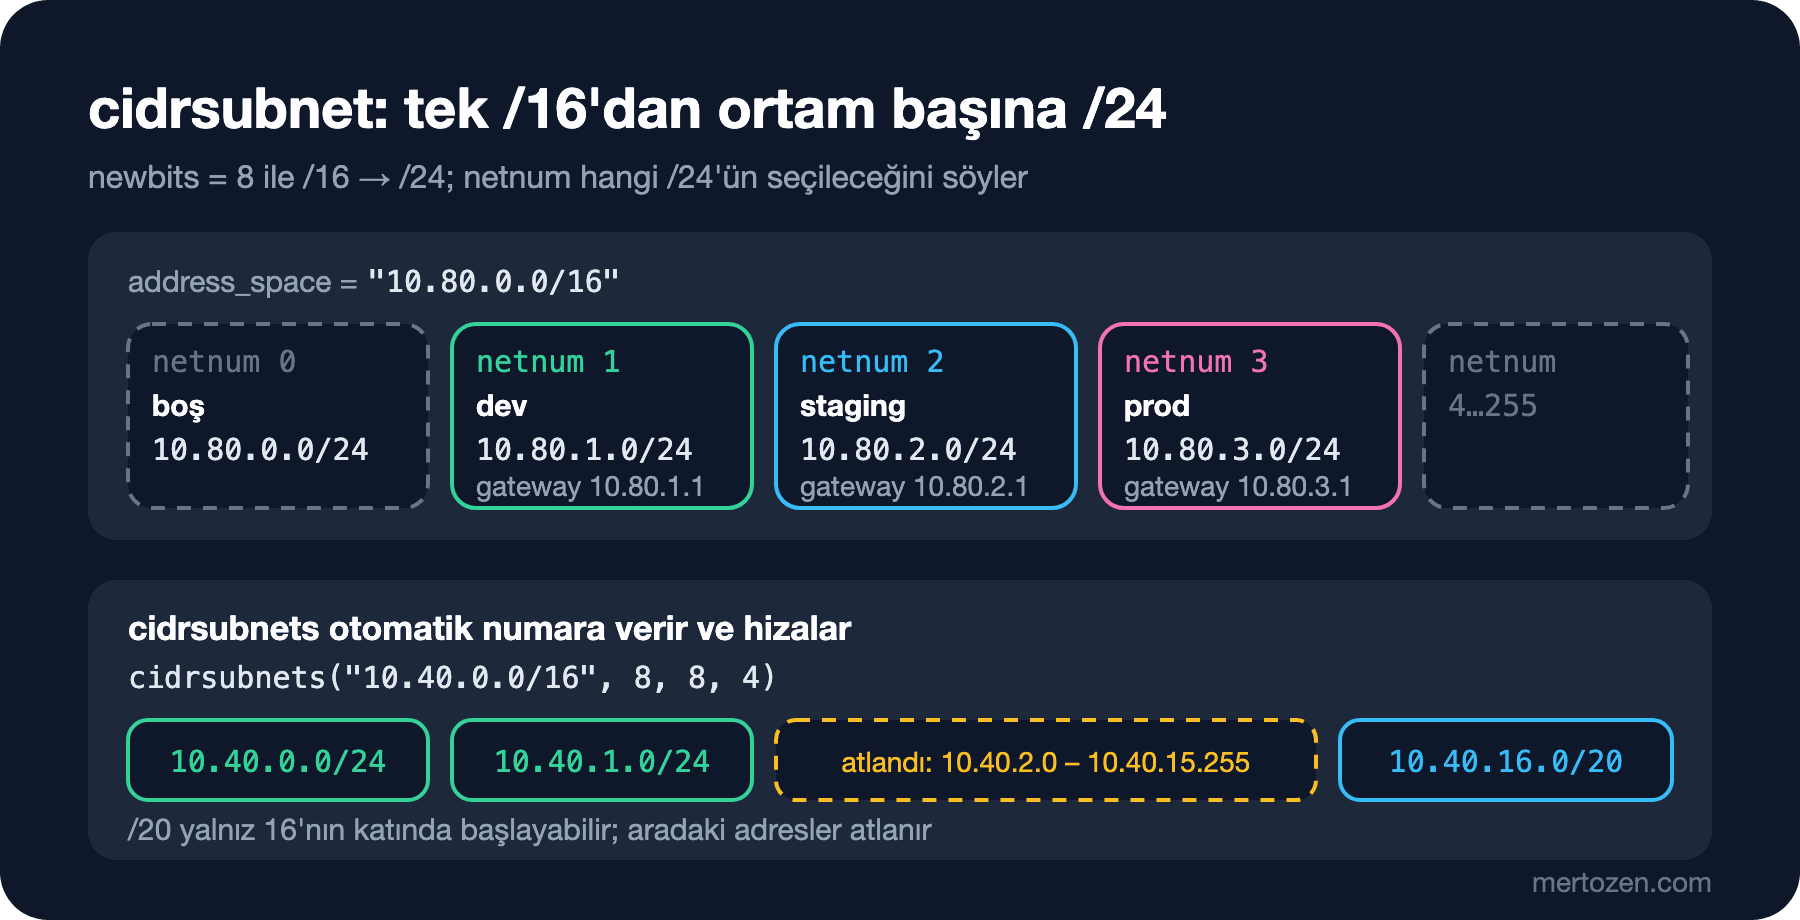
/16'ya 8 bit eklenince /24 çıkıyor; 1 numaralı alt ağ 10.80.1.0/24, onun ilk host adresi de cidrhost ile 10.80.1.1. cidrsubnets ise numaraları kendisi veriyor ve bir sürpriz yapıyor: üçüncü alt ağ 10.40.2.0/20 değil, 10.40.16.0/20. Bir /20 ancak 16'nın katlarından başlayabilir, fonksiyon aradaki adresleri atlıyor. Bu, Azure'da bir VNet'i (Azure'daki sanal ağ) uygulama ve veritabanı subnet'lerine bölerken önemli: sıralamayı değiştirmek bütün aralıkları kaydırır.
for, Splat ve optional()
for expression'ı 3. yazıda görmüştük. Üç kullanımı daha var. İlki, key'i kendin kurup map üretmek:
> { for pair in setproduct(local.environments, local.data_sets) : "${pair[0]}-${pair[1]}" => { environment = pair[0], data_set = pair[1] } }
{
  "dev-covers" = {
    "data_set" = "covers"
    "environment" = "dev"
  }
  "dev-exports" = {
    "data_set" = "exports"
    "environment" = "dev"
  }
  ...
}
Bu kalıp for_each'e verilecek map'i kurmanın standart yolu ve key'in neden veriden gelmesi gerektiğini tuzaklarda göreceğiz. İkincisi, value'dan sonra ... koyunca aynı key'e düşen value'lar bir listede toplanıyor (grouping mode):
> { for name, days in merge(local.retention, { reports = 30 }) : days => name... }
{
  "30" = [
    "exports",
    "reports",
  ]
  "365" = [
    "covers",
  ]
}
Üçüncüsü, ...'ın fonksiyon çağrısındaki anlamı: bir listeyi argümanlara açmak. merge birden fazla map alıyor, elimizde ise map'lerden oluşan bir liste var:
> merge([for section, values in local.settings : { for key, value in values : "${section}__${key}" => value }]...)
{
  "Bookstore__Catalog__PageSize" = 20
  "Bookstore__Features__Recommendations" = false
  "Logging__LogLevel__Default" = "Information"
}
İç içe iki for, YAML'daki iki seviyeyi Section__Key biçiminde tek seviyeye indiriyor. Bu satır birazdan Bookstore'un kodunda.
Splat ([*]), bir listedeki her elemanın aynı attribute'unu almak için kısa yol. Yalnız list ve tuple'da çalışıyor; for_each ile oluşmuş kaynaklar map olduğu için önce values gerekiyor:
> [{ name = "covers" }, { name = "exports" }][*].name
[
  "covers",
  "exports",
]
> { covers = { name = "c" }, exports = { name = "e" } }[*].name

Error: Unsupported attribute

This object does not have an attribute named "name".

> values({ covers = { name = "c" }, exports = { name = "e" } })[*].name
[
  "c",
  "e",
]
> null[*]
[]
> "westeurope"[*]
[
  "westeurope",
]
Son iki satır splat'in az bilinen davranışı: tek bir değere uygulanınca onu tek elemanlı bir listeye, null'a uygulanınca boş listeye çeviriyor. Opsiyonel bir block'u dynamic ile üretirken for_each = var.backup[*] yazmak bu yüzden çalışıyor.
Son olarak optional(). 3. yazıda optional(map(string), {}) kullanmıştık; iç içe object'lerde varsayılanlar katman katman uygulanıyor:
variable "api" {
  type = object({
    image_tag = string
    sku_name  = optional(string, "B1")
    scaling = optional(object({
      min = optional(number, 1)
      max = optional(number, 3)
    }), {})
    app_settings = optional(map(string))
  })
}
$ terraform console -var 'api={ image_tag = "1.1.0", scaling = { max = 10 } }'
> var.api
{
"app_settings" = tomap(null) /* of string */
"image_tag" = "1.1.0"
"scaling" = {
"max" = 10
"min" = 1
}
"sku_name" = "B1"
}scaling içinden yalnız max verildi, min varsayılandan geldi. Varsayılanı olmayan optional ise null bırakıyor; bu attribute'u kullanan her yerde null durumunu düşünmen gerekiyor.
Provider-defined Function'lar
Terraform 1.8'den beri provider'lar kendi fonksiyonlarını getirebiliyor; çağrı biçimi provider::<ad>::<fonksiyon>. Bir provider'ın hangi fonksiyonları sunduğu terraform providers schema -json çıktısında. AzureRM 5.14'te iki tane var, docker provider'ında hiç yok:
$ terraform providers schema -json | jq -r '.provider_schemas | to_entries[] | "\(.key): \((.value.functions // {}) | keys | join(", "))"'
registry.terraform.io/hashicorp/azurerm: normalise_resource_id, parse_resource_id
registry.terraform.io/kreuzwerker/docker:
> provider::azurerm::parse_resource_id("/subscriptions/00000000-0000-0000-0000-000000000000/resourceGroups/rg-bookstore-dev-weu/providers/Microsoft.Web/sites/app-bookstore-dev-weu")
{
"full_resource_type" = "Microsoft.Web/sites"
"parent_resources" = tomap({})
"resource_group_name" = "rg-bookstore-dev-weu"
"resource_name" = "app-bookstore-dev-weu"
"resource_provider" = "Microsoft.Web"
"resource_scope" = ""
"resource_type" = "sites"
"subscription_id" = "00000000-0000-0000-0000-000000000000"
}
> provider::azurerm::normalise_resource_id("/Subscriptions/00000000-0000-0000-0000-000000000000/resourcegroups/rg-bookstore-dev-weu/providers/microsoft.web/sites/app-bookstore-dev-weu")
"/subscriptions/00000000-0000-0000-0000-000000000000/resourceGroups/rg-bookstore-dev-weu/providers/Microsoft.Web/sites/app-bookstore-dev-weu"Bu fonksiyonlar Azure'a bağlanmıyor; terraform init yeterli, hesap gerekmiyor. parse_resource_id, bir data source'tan gelen ID'nin içinden resource group adını almak için split("/", ...)[4] gibi kırılgan index'lerin yerini alıyor. normalise_resource_id ise büyük-küçük harf farkı yüzünden plan'da çıkan sahte değişiklikleri önlemek için.
OpenTofu'ya kısa bir not: 1.13.9'da Terraform'un 119 fonksiyonunun hepsi var, üstüne 15 tane daha (cidrcontains, urldecode, base64gunzip ve assume... ailesi). cidrcontains("10.80.0.0/16", "10.80.1.0/24") OpenTofu'da true dönüyor, Terraform'da "There is no function named" hatası veriyor. 12. yazıdaki gibi, iki aracı birlikte destekleyen bir repo'da bu fonksiyonları yalnız .tofu dosyalarında kullan.
Bookstore'da: Ortam Başına Subnet ve YAML'dan App Settings
Şimdi bu fonksiyonları Bookstore'un yerel altyapısına uyguluyoruz. İlk iş, API ayarlarını YAML dosyasına taşımak. infra/local/envs/dev/appsettings.yaml:
# API'nin secret olmayan ayarları; Section: { Key: value } → Section__Key=value
Logging:
  LogLevel__Default: Information
Bookstore:
  Catalog__PageSize: 20
  Features__Recommendations: false
api variable'ına settings = optional(map(map(string)), {}) ekledim, ortam klasöründe de settings = yamldecode(file("${path.module}/appsettings.yaml")) ile veriyorum. Module'ün locals.tf'i:
locals {
  # Liste sırası değil sabit numara: yeni bir ortam eklemek başka bir ortamın subnet'ini kaydırmaz
  subnet_numbers = {
    dev     = 1
    staging = 2
    prod    = 3
  }
  subnet = cidrsubnet(var.address_space, 8, local.subnet_numbers[var.environment])

  # { Logging = { LogLevel__Default = "Information" } } => { Logging__LogLevel__Default = "Information" }
  file_settings = merge([
    for section, values in var.api.settings : {
      for key, value in values : "${section}__${key}" => value
    }
  ]...)

  app_settings = merge(
    { Bookstore__Environment = var.environment },
    local.file_settings,
    var.api.app_settings,
  )
}merge'ün sırası bilinçli: sağdaki kazanıyor, yani tfvars'tan gelen app_settings YAML'ı ezebiliyor. Önce YAML'a yalnız eski Logging satırını koyup plan aldım: Plan: 0 to add, 0 to change, 0 to destroy. Refactor davranışı değiştirmedi. Sonra Bookstore bölümünü ekledim ve tahmin sorusunun cevabı geldi:
  # module.bookstore.module.api.docker_container.this must be replaced
-/+ resource "docker_container" "this" {
      ~ env                                         = (sensitive value) # forces replacement
      ...
Plan: 1 to add, 0 to change, 1 to destroy.
$ terraform console
> module.bookstore.app_settings
{
"Bookstore__Catalog__PageSize" = "20"
"Bookstore__Environment" = "dev"
"Bookstore__Features__Recommendations" = "false"
"Logging__LogLevel__Default" = "Information"
}Değerler string oldu: map(map(string)) tip kısıtı, tomap'te gördüğümüz dönüşümü YAML'daki number ve bool'a uyguladı. Environment variable zaten string olduğu için istediğimiz de bu. ASP.NET Core __'yi configuration'da : olarak okuyor, yani uygulama Bookstore:Catalog:PageSize görüyor. Plan ise hangi ayarın değiştiğini söylemedi: module'deki secret_env sensitive olduğu için bütün env listesi gizleniyor. Bunu görmenin yolunu 14. yazıda, plan'ın JSON çıktısıyla bulacağız.
Azure tarafında aynı iki satırı infra/azure/bookstore/locals.tf'e koydum; Linux App Service de app setting adlarındaki __'yi aynı biçimde okuyor. Module testine YAML'ın düzleştirildiğini ve tfvars'ın onu ezdiğini kontrol eden bir run ekledim:
$ terraform test
tests/bookstore.tftest.hcl... in progress
  run "dev_uses_small_tiers"... pass
  run "settings_file_is_flattened"... pass
  run "prod_rejects_b1"... pass
  run "prod_uses_zone_redundancy"... pass
tests/bookstore.tftest.hcl... tearing down
tests/bookstore.tftest.hcl... pass

Success! 4 passed, 0 failed.
İkinci iş, ortamları ayrı IP aralıklarına koymak. Module'e varsayılanı 10.80.0.0/16 olan bir address_space variable'ı ekledim. Validation'ı can(cidrhost(...)) ile yazdım: geçersiz bir CIDR verilirse cidrhost hata verir, can da bunu false'a çevirir. Docker network'üne de ipam_config ekledim:
resource "docker_network" "bookstore" {
  name = local.name_prefix

  ipam_config {
    subnet  = local.subnet
    gateway = cidrhost(local.subnet, 1)
  }

  # labels ...
}
# module.bookstore.docker_network.bookstore must be replaced
-/+ resource "docker_network" "bookstore" {
- ipam_config { # forces replacement
...
}
+ ipam_config { # forces replacement
+ gateway = "10.80.1.1"
+ subnet = "10.80.1.0/24"
}
}
Plan: 1 to add, 0 to change, 1 to destroy.
Changes to Outputs:
+ subnet = "10.80.1.0/24"dev 10.80.1.0/24'i, staging'in plan'ı da 10.80.2.0/24'ü aldı. Bu plan'ı apply ettiğimde ise Terraform network'ü silmeye çalışırken 30 saniye bekleyip zaman aşımına düştü: container hâlâ o network'e bağlıydı ve plan onu replace listesine koymamıştı. Çözüm, module'e network'ün adını değil ID'sini vermek oldu (networks = [docker_network.bookstore.id, ...]). Network yeniden oluşunca ID değişiyor, container da onunla birlikte replace ediliyor. Hatayı nasıl okuduğumu 14. yazıda adım adım anlatacağım. Düzeltmeden sonra apply iki kaynağı da sırayla yeniledi ve sonraki plan "0 to change" dedi.
Üretimde Dikkat
Network aralıklarını koddan hesaplamak, onları değişmez kılmaz. cidrsubnet'in netnum'unu bir listenin index'inden almak, listeye ortadan bir eleman eklendiğinde bütün subnet'leri kaydırır; Azure'da bu, içinde kaynak olan subnet'lerin replace edilmeye çalışılması demek. Bu yüzden numaraları subnet_numbers gibi açık bir map'te tut ve bir numarayı asla yeniden kullanma.
Uzun expression'ları local'lere böl ve her local'e ne ürettiğini gösteren bir örnek yorum yaz (file_settings'teki gibi). Üç seviye iç içe for ve merge(...)... içeren bir satırı altı ay sonra okuyan kişi, console açmadan ne çıktığını bilmeli.
Dosya okuyan fonksiyonlar repo'daki dosyaya bağlı: appsettings.yaml'daki her değişiklik bir altyapı değişikliği ve pull request'te plan'ıyla birlikte review edilmeli. Secret'ları bu dosyalara koyma; file ile okunan değer sensitive değildir ve plan çıktısında görünür. Secret'lar için 9. yazıdaki ephemeral değerler ve Key Vault yolu geçerli.
Sık Düşülen Tuzaklar
flatten ile kurduğun listeyi for_each'e index'le vermek. Ortam ve veri seti çiftlerini iki şekilde key'ledim: { for i, b in local.buckets : i => b } ve { for b in local.buckets : "${b.environment}-${b.data_set}" => b }. Listeden dev'i çıkarınca:
  # terraform_data.by_index["0"] will be updated in-place
  # terraform_data.by_index["1"] will be updated in-place
  # terraform_data.by_index["2"] will be updated in-place
  # terraform_data.by_index["3"] will be updated in-place
  # terraform_data.by_index["4"] will be destroyed
  # terraform_data.by_index["5"] will be destroyed
  # terraform_data.by_name["dev-covers"] will be destroyed
  # terraform_data.by_name["dev-exports"] will be destroyed
Plan: 0 to add, 4 to change, 4 to destroy.
Index'li sürümde bütün elemanlar bir sıra kaydı ve silinen kaynaklar prod'unkiler oldu; bunlar volume ya da storage container olsaydı veri giderdi. İsimli key'lerde yalnız gerçekten çıkan iki kaynak siliniyor. 3. yazıdaki count problemi, for_each kullandığın hâlde key'i index'ten üretirsen aynen geri gelir.
try ile hatayı sessizce yutmak. try(local.settings.Bookstore.Catalog__PageSise, 50) yazım hatasına rağmen 50 dönüyor ve kimse fark etmiyor. try, tanımlanmamış bir local'e referans gibi statik hataları yakalamıyor (local.setings için "Reference to undeclared local value" hatası alırsın), ama olmayan bir attribute'u yakalıyor. Varsayılanı olan bir key için lookup(map, key, default) niyeti daha açık söyler; tip ve yapı kontrolü için de optional() ve validation daha doğru yer.
Template ile JSON'u elle kurmak. {"PageSize": ${page_size}} gibi bir template, değer string olunca tırnaksız, liste olunca bozuk JSON üretir. Template'in içinde jsonencode kullan ya da template'e hiç gerek yoksa doğrudan jsonencode çağır.
Küçük Bir Deneme
★☆☆ infra/examples/functions'ta terraform console aç ve cidrsubnets("10.40.0.0/16", 4, 8, 8)'in sonucunu tahmin et. Sıralamayı 8, 8, 4 yapınca neden farklı aralıklar çıkıyor?
★★☆ appsettings.yaml'a üçüncü bir seviye ekle (Bookstore: { Catalog: { PageSize: 20 } }). plan hangi hatayı veriyor ve bu hata, tip kısıtının neyi koruduğu hakkında ne söylüyor? Üç seviyeyi destekleyen bir file_settings yaz; Terraform'da recursive fonksiyon olmadığını unutma.
★★★ address_space için, verilen aralığın şirketin ayırdığı 10.0.0.0/8 içinde olduğunu kontrol eden bir validation yaz. Terraform'da cidrcontains yok; cidrhost ve cidrnetmask ile aynı kontrolü kurabilir misin?
Bu yazıda plan'ın bir değişikliği gizlediğini ve doğru görünen bir apply'ın zaman aşımına düştüğünü gördük. Sonraki yazıda bu tür durumların hepsine sistemli bakıyoruz: plan'ı satır satır okumak, TF_LOG, provider hataları, kilitli state, "already exists" ve drift.