

Rollback mı Roll Forward mı? Geri Alma Planı, Kill Switch ve Otomatik Geri Dönüş Kriterleri
Geri dönüşün dört yolu var: kill switch, artifact rollback, roll forward ve etkiyi sınırlamak; seçim flag'e, önceki artifact'ın hazırlığına ve şemanın uyumuna bağlı. Atomik symlink switch, Down migration'ın kolonu geri getirip 300.004 ismi getirememesi, merge commit'in git revert'ü, %20 hatalı sürümü 10 sn'de geri alan otomatik tetikleyici (85 istekten 18'i hata), runbook template'i ve DORA ile ölçüm.
Sürüm notu: Bu yazıdaki örnekler .NET 10 (SDK 10.0.402), EF (Entity Framework) Core 10.0.14, PostgreSQL 18.6, Nginx 1.30, Docker 29 ve Git 2.54 ile denenmiştir.
Önce Tahmin Et
Serinin altıncı yazısında Customers.FullName kolonunu sildik. Şimdi bir hata yüzünden geri dönmek istiyorsun ve EF Core'un Down() metodunu çalıştırıyorsun. Kolon geri gelir mi? Peki içindeki 300.000 isim?
İkinci soru: Yeni sürümü blue-green ile canlıya aldın ve isteklerin %20'si hata veriyor. Bir script hata oranını her beş saniyede ölçüp eşiği aşınca geri dönüyor. Kaç kullanıcı hata görür?
Geri Dönmenin Dört Yolu
Bir deploy'dan sonra bir şeyler ters gittiğinde dört seçeneğin var. Rollback, önceki çalışan sürüme dönmektir. Roll forward, hatayı düzelten yeni bir sürümü hızla çıkarmaktır. Kill switch, kodu değiştirmeden davranışı kapatmaktır. Etkiyi sınırlamak ise trafiği azaltmak, özelliği belli kullanıcılara kısmak ya da bakım moduna geçmektir; sorunu çözmez, zaman kazandırır. Doğru seçim; hatanın nerede olduğuna, önceki sürümün hâlâ hazır olup olmadığına ve verinin değişip değişmediğine bağlı. Aşağıdaki karar ağacı bu soruları sırayla soruyor:
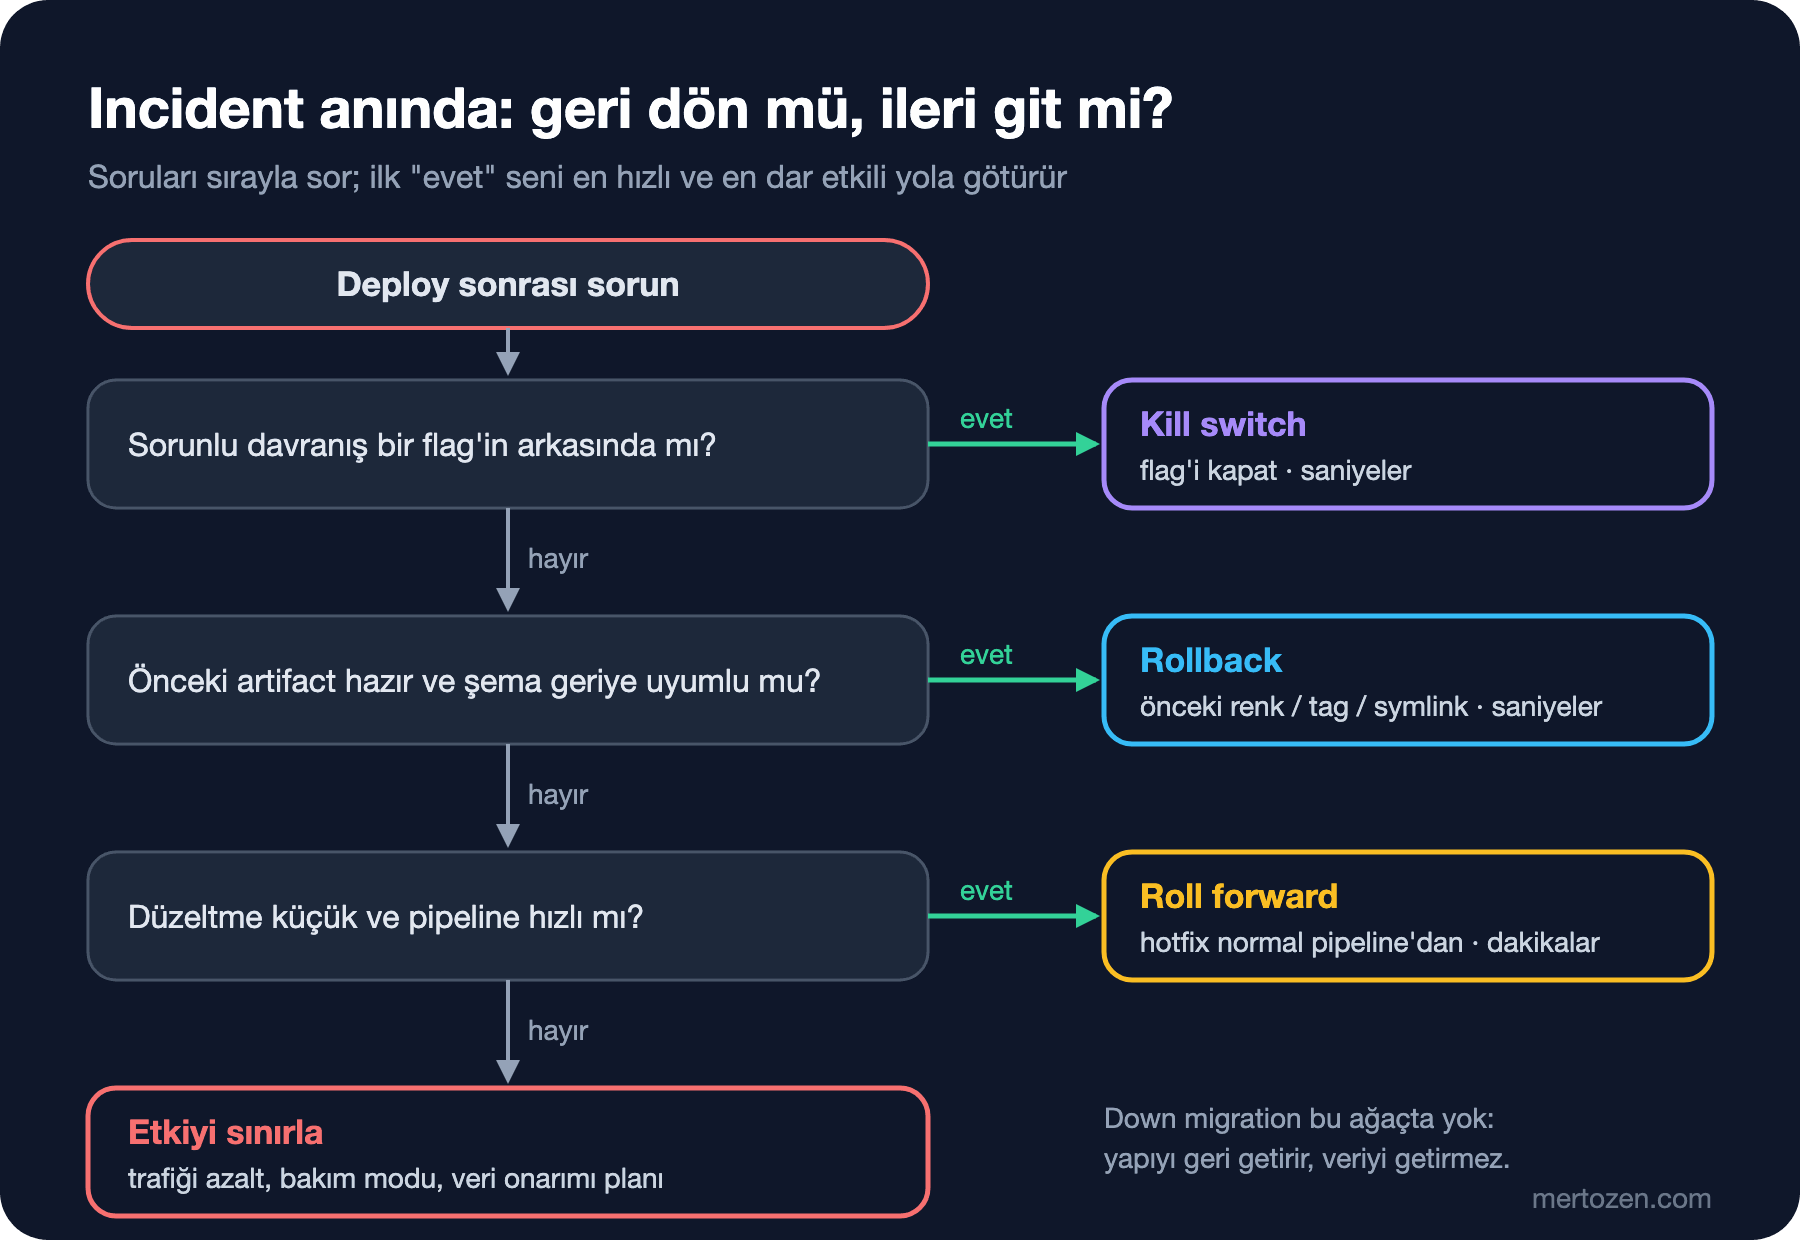
Ağacın ilk sorusu bilinçli olarak "flag var mı?". Kill switch hem en hızlısı hem de en dar etkilisi: yalnız sorunlu davranışı kapatır, aynı deploy'daki diğer düzeltmeleri geri almaz. Serinin yedinci yazısında Bookstore'un öneri flag'i, config değişikliğinden 0,4 saniye sonra etkili olmuştu.
Artifact Rollback: Önceki Sürüm Hazır mı?
Rollback'in hızı tek bir şeye bağlı: önceki sürümün artifact'ı ne kadar hazır? ilerideki Continuous Integration ve Continuous Delivery (CI/CD) Temelleri serisinin "Build Once, Deploy Many" yazısındaki immutable artifact fikri tam burada değer kazanıyor. Dört yaygın biçim var.
VM (Virtual Machine) ya da bare metal sunucuda her sürüm ayrı bir klasöre açılır ve current symlink'i aktif olanı gösterir. Geri dönmek, symlink'i önceki klasöre çevirmektir:
#!/usr/bin/env bash
# activate.sh VERSION: current'ı tek bir atomik rename ile releases/VERSION'a çevirir
set -euo pipefail
root=/srv/bookstore
test -d "$root/releases/$1"
ln -sfn "$root/releases/$1" "$root/current.tmp"
mv -Tf "$root/current.tmp" "$root/current"
echo "current -> $(readlink "$root/current")"
activate.sh 1.4.0
activate.sh 1.5.0
activate.sh 1.4.0
activate.sh 1.3.9 || echo "exit=$?"current -> /srv/bookstore/releases/1.4.0
current -> /srv/bookstore/releases/1.5.0
current -> /srv/bookstore/releases/1.4.0
exit=1ln -sfn tek başına atomik değil: önce eski link'i siler, sonra yenisini yaratır ve arada current bir anlığına yoktur. Önce geçici bir link oluşturup mv -T ile üzerine taşımak tek bir rename(2) çağrısı yapar ve bu işlem atomiktir. Var olmayan bir sürüme geçmeye çalışınca test -d script'i durduruyor. Symlink değiştikten sonra uygulama sürecini yeniden başlatmayı unutma, çünkü çalışan process eski klasörden yüklendi.
Container dünyasında artifact image'dır ve rollback önceki tag'e dönmektir. Bu yüzden latest gibi değişen tag'lerle deploy yapılmaz. Hangi tag'in production'da olduğunu her zaman bilmelisin. Kubernetes'te Deployment'ın rollout geçmişinden önceki ReplicaSet'e dönmek kubectl rollout undo ile yapılır; mekaniği ilerideki Kubernetes serisinin Deployment yazısında. Blue-green'de ise rollback, serinin dördüncü yazısındaki gibi tek bir switch'tir, yeter ki eski ortam hâlâ ayakta olsun.
Veritabanı Rollback'i Neden Neredeyse Hiç Down Migration Değildir?
EF Core her migration için bir Down() üretir ve bundle'a hedef migration adı verilince o noktaya kadar geri sarar. Altıncı yazının son halinden, FullName'i silen migration'ı geri aldım:
./artifacts/efbundle-r4 MakeNamePartsRequired --connection "$DB_CONNECTION"Acquiring an exclusive lock for migration application. See https://aka.ms/efcore-docs-migrations-lock for more information if this takes too long.
Reverting migration '20261108034901_DropCustomerFullName'.
Done.Kolon geri geldi. İçine bakalım:
 Id | FullName | FirstName | LastName
----+----------+-----------+----------
  1 |          | Alan      | Lovelace
  2 |          | Grace     | Lovelace
(2 rows)

 fullname_null | total
---------------+--------
        300004 | 300004
(1 row)
300.004 satırın hepsinde FullName boş. Down() yapıyı geri getirir, veriyi getiremez; silinen kolondaki veri sadece yedeklerde vardır. Daha kötüsü, bu "geri dönmüş" şemada eski kod (v2) hâlâ çalışmıyor. Kolon var ama v2 onu required string olarak okuyor ve boş değeri kaldıramıyor:
System.InvalidCastException: Column 'FullName' is null.
   at Npgsql.ThrowHelper.ThrowInvalidCastException_NoValue(FieldDescription field)
Baştaki ilk sorunun cevabı: kolon geri gelir, isimler gelmez. EF Core'un dokümanı da rollback'in daha yeni bütün migration'ların Down adımlarını çalıştırdığını ve veri kaybına yol açabileceğini açıkça yazıyor. Pratikteki kural şu: veritabanını geri sarmazsın, geri dönüşü gerektirmeyecek şekilde ileri gidersin. Serinin altıncı yazısındaki expand-contract tam bunu sağlıyor. Expand adımları geriye uyumlu olduğu için onları geri almana gerek yok, eski kod onlarla çalışır. Contract adımı ise yalnız geri dönüş ihtiyacı kalmadığında çalışır. Veri gerçekten bozulduysa çözüm migration değil; yedekten ya da point-in-time recovery ile ayrı bir yere geri yükleyip ilgili satırları düzelten bir veri onarımı.
Roll Forward: Ne Zaman Daha Güvenli?
Roll forward, hatayı yeni bir sürümle düzeltmek demek. Bazı durumlarda rollback'ten daha güvenli. Yeni sürüm bir veri formatını değiştirdiyse ve eski sürüm o veriyi okuyamıyorsa, geri dönmek ikinci bir incident başlatır. Aynı deploy'da başka kritik düzeltmeler de varsa rollback onları da geri alır. Önceki sürümün artifact'ı kaybolduysa ya da kendi güvenlik açıkları varsa da geri dönüş bir seçenek olmaktan çıkar.
Roll forward'ın ön koşulu hızlı ve güvenilir bir pipeline. Hotfix'in normal pipeline'dan geçmesi gerekir, çünkü stres altında atlanan testler ikinci hatayı getirir. Pipeline 45 dakika sürüyorsa roll forward, 45 dakikalık bir kesinti demektir. O durumda önce etkiyi sınırla (kill switch, trafiği eski ortama al), sonra düzeltmeyi sakin bir şekilde çıkar.
Kodu geri almanın en temiz yolu git revert'tür; history'yi yeniden yazmadan, değişikliği tersine çeviren yeni bir commit üretir. Git & GitHub serisinin "Git ile Değişiklikleri Geri Almak 2: git revert" yazısında ayrıntılı anlattık. Burada deploy açısından tek bir not: merge edilmiş bir pull request'i geri alırken -m 1 ile ana hattı seçmen gerekir:
git log --oneline --graph
git revert -m 1 --no-edit HEAD
* 8f1610d Merge pull request #42 from feature/discounts
|\
| * 67282f4 Apply 10% discount at checkout
|/
* 87c4173 Add pricing
[main 0056d49] Revert "Merge pull request #42 from feature/discounts"
Date: Sun Nov 8 07:02:38 2026 +0300
1 file changed, 1 deletion(-)Revert de bir commit olduğu için normal pipeline'dan geçer ve yeni bir sürüm olarak deploy edilir. Yani git revert, teknik olarak bir roll forward'dur.
Otomatik Geri Dönüş Tetikleyicileri
İnsanın hatayı görüp karar vermesi dakikalar sürer, script'in ise saniyeler. Serinin dördüncü yazısındaki blue-green ortamına bir izleyici ekledim: switch'ten sonra canlı trafiğin 5xx oranını her beş saniyede ölçüyor ve eşiği aşarsa önceki renge dönüyor:
#!/usr/bin/env bash
# auto-rollback.sh PREVIOUS_COLOR SECONDS: switch'ten sonra canlı 5xx'i izler, fazlaysa önceki renge döner
set -euo pipefail
previous=$1
end=$((SECONDS + $2))
min_requests=50
max_error_pct=2
docker exec depwork-nginx sh -c ': > /var/log/nginx/bookstore.log'
while [ $SECONDS -lt $end ]; do
    sleep 5
    read -r total errors < <(docker exec depwork-nginx cat /var/log/nginx/bookstore.log |
        awk '{ n++; if ($2 >= 500) e++ } END { print n + 0, e + 0 }')
    echo "$(date +%T) requests=$total 5xx=$errors"
    if [ "$total" -ge "$min_requests" ] && [ $((errors * 100)) -gt $((total * max_error_pct)) ]; then
        echo "$(date +%T) error rate above ${max_error_pct}%, rolling back to $previous"
        ./switch.sh "$previous"
        exit 1
    fi
done
echo "$(date +%T) watch window passed, keeping the release"
Green'e isteklerin %20'sinde hata veren bir sürüm koydum (BUG_FAIL_RATE=0.2), arka planda saniyede on istek atan probe'u başlattım ve switch yaptım:
./switch.sh green
./auto-rollback.sh blue 60
07:02:07 live=green preview=blue
07:02:12 requests=40 5xx=9
07:02:17 requests=81 5xx=17
07:02:17 error rate above 2%, rolling back to blue
07:02:17 live=blue preview=greenProbe'un toplamı:
200 1.1.0 67
500  18
200 1.0.0 121
Switch'ten on saniye sonra trafik eski sürüme dönmüştü. Bu sürede 85 istek yeni sürüme gitti ve 18'i hata aldı. Baştaki ikinci sorunun cevabı bu ve iki ayrıntı içeriyor. İlk ölçümde 40 istek vardı ve min_requests=50 kuralı yüzünden script karar vermedi. Az veriyle karar vermemek doğru, ama ilk beş saniyede de hatalar oldu. Kontrol aralığını kısaltmak ya da eşiği trafiğe göre ayarlamak bu süreyi kısaltır. İkinci ayrıntı: bu hesap blue-green'in tamamı için. Aynı hata %10'luk bir canary'de olsaydı aynı on saniyede hata alan istek sayısı onda birine inerdi; serinin ilk yazısındaki blast radius × tespit süresi çarpımı burada somutlaşıyor.
Gerçek bir sistemde tetikleyiciyi tek bir metriğe bağlamazsın. Yaygın tetikleyiciler şunlar: readiness'e hiç geçemeyen yeni instance'lar (Kubernetes'in progressDeadlineSeconds'ı), bir pencere içindeki 5xx oranı, p95 gecikmesinin kontrol grubuna göre artması ve ödeme tamamlama oranı gibi bir iş metriğinin düşmesi. Hepsinde aynı iki parametre var: minimum örnek sayısı ve pencere süresi. Argo Rollouts'un analysis'i ve Flagger bunları deklaratif olarak tanımlamanı sağlar. Serinin beşinci yazısında Argo Rollouts'un hatalı bir canary'yi otomatik olarak durdurduğunu görmüştük.
Runbook Template'i
Otomatik tetikleyici her şeyi yakalamaz. İnsanın devreye girdiği anda da kararın bir kâğıtta yazılı olması gerekir. Her servis için tek sayfalık bir runbook şu soruları önceden cevaplar:
- Önceki sürüm nerede ve ona dönmek için hangi komut çalıştırılır? (
./switch.sh blue,activate.sh 1.4.0, image tag'i) - Bu release'te hangi migration'lar var ve geriye uyumlu mu? Değilse rollback seçenek değil, roll forward planı nedir?
- Hangi flag'ler bu release'le geldi, kill switch'leri hangileri ve nereden kapatılır?
- Hangi metrik hangi eşikte "geri dön" demek? Kim karar verir, kime haber verilir?
- Geri dönüşten sonra neyi doğrularız? (smoke test, hata oranı, veri tutarlılığı sorguları)
Runbook'u deploy'dan önce yaz ve geri dönüş komutunu en az bir kez gerçekten çalıştır. Incident yönetiminin kendisi ilerideki SRE (Site Reliability Engineering) ve Production Incident'ları serisinin konusu; buradaki amaç yalnız teknik geri dönüş yolunun önceden hazır olması.
DORA ile Ölçmek
Geri dönüş stratejinin işe yarayıp yaramadığını iki DORA (DevOps Research and Assessment) metriği gösterir. dora.dev'deki güncel tanımlarıyla: change fail rate, deploy'dan sonra acil müdahale gerektiren (rollback ya da hotfix) deploy'ların oranı; failed deployment recovery time ise böyle bir deploy'dan kurtulmanın süresi. DORA bu ikincisine eskiden MTTR (Mean Time to Recovery) diyordu ve bugün beş metrikli modelde ona bir de deployment rework rate eşlik ediyor: incident yüzünden yapılan plansız deploy'ların oranı.
Bu metrikleri hesaplamak için deploy kayıtlarına iki alan eklemek yetiyor: "bu deploy acil müdahale gerektirdi mi?" ve "gerektirdiyse ne zaman düzeldi?". Yukarıdaki otomatik geri dönüş örneği DORA açısından bir change failure'dır ve recovery time'ı on saniyedir. Kill switch ile kapatılan bir özellik de aynı şekilde sayılır. Metriği güzelleştirmek için başarısız deploy'ları kayıttan saklamak, onu anlamsız kılar.
Sık Düşülen Tuzaklar
- Down migration'ı geri dönüş planı saymak. Yapı geri gelir, veri gelmez; altıncı yazının kolonu bunun kanıtı.
- Eski artifact'ı ya da eski ortamı hemen silmek. Geri dönüş yolu deploy'dan sonraki ilk saatlerde en değerli halindedir.
latesttag'iyle deploy etmek. "Önceki sürüm" belirsizleşir ve rollback bir tahmine dönüşür.- Otomatik rollback'i minimum örneksiz kurmak. Gece düşük trafikte tek bir 500, sağlıklı bir sürümü geri aldırır.
- Hotfix'i pipeline dışından çıkarmak. Stres altında atlanan testler ikinci incident'ın en yaygın sebebi.
Küçük Bir Deneme
★☆☆ activate.sh'yi mv -T yerine ln -sfn ile doğrudan current'a yazacak şekilde değiştir ve bir döngüde readlink current'ı çağırırken sürümleri hızla değiştir. Hiç "No such file" görüyor musun?
★★☆ auto-rollback.sh'nin kontrol aralığını 1 saniyeye, min_requests'i 10'a indir ve aynı hatalı sürümle tekrar dene. Hata alan istek sayısı ne kadar düşüyor? Aynı ayarlarla sağlıklı bir sürüm yanlışlıkla geri alınıyor mu?
★★★ Son on deploy'unu bir CSV (Comma-Separated Values) dosyasına yaz (tarih, sürüm, acil müdahale gerekti mi, düzelme zamanı) ve change fail rate ile failed deployment recovery time'ı hesaplayan küçük bir script yaz.
Rolling, blue-green, canary, migration'lar, flag'ler ve geri dönüş artık ayrı ayrı elimizde. Son yazıda hepsini tek bir yerde birleştiriyoruz: Bookstore'u GitHub Actions ile build eden, expand migration'ı uygulayan, green'e deploy edip smoke test yapan, canary adımlarıyla trafiği açan ve gerektiğinde geri dönen bir pipeline.