

Deploy ve Release Farkı: Downtime Neden Olur ve Deployment Stratejileri Haritası
Deploy kodun ortama kurulması, release kullanıcının yeni davranışı görmesidir; ikisini ayırabilen ekip riski böler. Nginx arkasındaki tek container'lı recreate deploy'unda 12 istek 2,5 saniye içinde hata aldı. Downtime'ın beş kaynağı, recreate, rolling, blue-green, canary, shadow, A/B ve feature flag'in haritası, karar tablosu ve risk = blast radius × tespit süresi hesabı.
Sürüm notu: Bu yazıdaki örnekler .NET 10 (SDK 10.0.402), Nginx 1.30 ve Docker 29 ile denenmiştir.
Önce Tahmin Et
Bookstore API'si (Application Programming Interface) tek bir container olarak Nginx'in arkasında çalışıyor. Yeni sürümü en basit yolla çıkarıyorsun: eski container'ı durdur, sil, yenisini başlat. Uygulama .NET 10 ile yazılmış küçük bir minimal API, açılışı bir saniyeden kısa. Bu deploy sırasında saniyede on istek gelirse kullanıcılar kaç saniye hata görür? Sıfır mı, bir mi, beş mi?
İkinci soru daha kavramsal. Yeni "tek tıkla ödeme" özelliğinin kodu bugün production'a gitti ama özellik bir flag ile kapalı. Bu özelliği "deploy ettik" mi diyeceksin, "release ettik" mi? İki cevabı da not et. Birincisini birazdan ölçeceğiz, ikincisi bütün serinin ana fikri.
Deploy ile Release Aynı Şey Değil
Günlük konuşmada ikisi aynı anlamda kullanılıyor, ama ayırınca birçok şey netleşiyor. Deploy, yeni kodun bir ortama kurulup çalışır hale gelmesi: yeni image'ın container'a dönüşmesi, yeni dosyaların sunucuya kopyalanması, migration'ın çalışması. Release ise kullanıcının yeni davranışı görmeye başlaması. Çoğu ekipte ikisi aynı anda olur, çünkü yeni kodun çalıştığı an kullanıcı trafiği de ona gider. Ama bu bir zorunluluk değil, bir tercih.
Deploy ile release'i ayırabildiğinde risk iki parçaya bölünür. Deploy'un riski teknik: process ayağa kalkıyor mu, config doğru mu, veritabanına bağlanıyor mu. Release'in riski davranışsal: yeni özellik doğru hesaplıyor mu, kullanıcı onu anlıyor mu, yük altında ne oluyor. Blue-green deploy'u release'ten birkaç dakika önce yapar ve arada smoke test koşturur. Canary release'i kullanıcıların küçük bir kısmıyla sınırlar. Feature flag ise deploy'u günler önce yapıp release'i bir config değişikliğine indirger. Baştaki ikinci sorunun cevabı da bu: flag'i kapalı özellik deploy edilmiştir ama release edilmemiştir.
Recreate'in Bedelini Ölçmek
En basit strateji olan recreate ile başlayalım: eski sürümü kapat, yenisini aç. Nginx'in arkasında tek bir API container'ı var:
events {}

http {
    resolver 127.0.0.11 valid=1s ipv6=off;

    upstream bookstore_api {
        zone bookstore_api 64k;
        server depwork-api:8080 resolve;
    }

    server {
        listen 80;
        location / {
            proxy_pass http://bookstore_api;
        }
    }
}
resolve parametresi, yeniden yaratılan container'ın yeni IP (Internet Protocol) adresini Nginx'in bir saniye içinde öğrenmesini sağlıyor. Deploy script'i şu kadar:
#!/usr/bin/env bash
# recreate.sh VERSION: önce eskiyi durdurur, sonra yenisini başlatır
set -euo pipefail
docker stop depwork-api >/dev/null
docker rm depwork-api >/dev/null
docker run -d --name depwork-api --network depwork-net "depwork-bookstore-api:$1" >/dev/null
echo "$(date +%H:%M:%S) deployed $1"
Deploy sırasında ne olduğunu görmek için her 100 milisaniyede bir istek atan ve sonuçları saniye saniye gruplayan bir probe kullanıyoruz. Serinin geri kalanında da bu script'i kullanacağız:
#!/usr/bin/env bash
# probe.sh URL SECONDS [METHOD]: her 100 ms'de bir istek atar, sonuçları saniye saniye gruplar
url=$1
end=$((SECONDS + $2))
method=${3:-GET}
while [ $SECONDS -lt $end ]; do
    printf '%s ' "$(date +%H:%M:%S)"
    curl -s -o /dev/null -m 1 -X "$method" -w '%{http_code} %header{x-app-version}\n' "$url"
    sleep 0.1
done | sort | uniq -c
curl'ün -m 1 ayarı bir saniyede cevap gelmezse isteği kesiyor ve kodu 000 yazıyor. %header{x-app-version} ise uygulamanın her cevaba eklediği sürüm header'ını okuyor. Probe çalışırken deploy'u başlatıyoruz:
(./tools/probe.sh http://localhost:18604/api/books 8 > recreate.txt) &
sleep 2.5; ./lab01/recreate.sh 1.1.0; wait; cat recreate.txt
07:25:15 deployed 1.1.0
2 07:25:11 200 1.0.0
8 07:25:12 200 1.0.0
8 07:25:13 200 1.0.0
1 07:25:14 000
3 07:25:14 200 1.0.0
1 07:25:14 502
3 07:25:15 502
1 07:25:16 200 1.1.0
7 07:25:16 502
8 07:25:17 200 1.1.0
8 07:25:18 200 1.1.0Satırları okumak kolay: her satırda o saniyede kaç isteğin hangi kodla ve hangi sürümden döndüğü yazıyor. 07:25:14'te bir istek bir saniye içinde cevap alamadı, ardından Nginx 502 Bad Gateway dönmeye başladı. 07:25:16'da yeni sürüm ilk cevabını verdi. Yaklaşık iki buçuk saniye boyunca gelen isteklerin çoğu hata aldı. Toplamda 12 istek.
İki buçuk saniye az görünebilir, ama bu makinede bir saniyeden kısa sürede açılan, veritabanına bile bağlanmayan bir uygulama için ölçüldü. Gerçek bir Bookstore'da açılışta migration kontrolü, connection pool'un ısınması, cache'in dolması ve JIT (Just-In-Time) derlemesi var. Bunlar pencereyi 10 ile 60 saniye arasına kolayca çıkarır. Saniyede on istek alan bir sistemde bu 100 ile 600 arası hatalı istek demek ve her biri ödeme, sepete ekleme ya da login olabilir.
Downtime Nereden Gelir?
Recreate'teki kesintinin kaynağı açık: bir süre boyunca hiç çalışan instance yok. Ama zero-downtime stratejilerinde de kesinti olur, çünkü kaynakları daha incedir. Beş tanesini bilmek, sonraki yazılarda neyi neden yaptığımızı anlamayı kolaylaştırır.
1. Process Restart
Eski process kapanırken elindeki istekleri bitirmezse ya da load balancer kapanan instance'a istek göndermeye devam ederse kullanıcı bağlantı kopması görür. Çözümü graceful shutdown ve connection draining; ikisini de serinin ikinci yazısında ölçüyoruz.
2. Cold Start
Yeni process ayağa kalktığında henüz hazır değildir. Aynı container'ın ilk üç isteği:
for i in 1 2 3; do
    curl -s -o /dev/null -w "books #$i %{http_code} %{time_total}s\n" localhost:18600/api/books
done
books #1 200 0.015302s
books #2 200 0.001436s
books #3 200 0.000845sİlk istek ikinciden on kat, üçüncüden on sekiz kat yavaş. Bu farkın kaynağı JIT derlemesi, ilk kez yüklenen assembly'ler ve ilk bağlantılar. Bu örnekte milisaniyeler konuşuyoruz, ama büyük bir uygulamada ilk istekler saniyeler sürer ve trafiğin tamamı açılır açılmaz yeni instance'a yönlendirilirse timeout'lar başlar. Çözüm readiness: instance hazır olduğunu kendisi söyleyene kadar trafik almamalı.
3. Şema Uyumsuzluğu
Yeni sürüm bir kolonu yeniden adlandırdıysa, migration çalıştığı an eski sürümün sorguları patlar. Yeni sürüm henüz çalışmıyorsa ya da geri döndüysen de durum aynı. Bu, stratejinin değil veri değişikliğinin problemi; hiçbir trafik yönetimi onu çözmez. Serinin altıncı yazısı tamamen bunun üzerine: expand-contract.
4. Cache ve Session Kaybı
Instance'ın belleğinde tutulan session, sepet ya da ASP.NET Core Data Protection anahtarları, instance değiştiğinde kaybolur. Kullanıcı hata sayfası görmez ama logout olur, sepeti boşalır ya da formu "antiforgery token" hatasıyla reddedilir. Bunlar log'larda 500 olarak görünmediği için en geç fark edilen kesintilerdir.
5. Yarım Deploy
Beş sunucudan üçü güncellendi, dördüncüde disk doldu ve script durdu. Ya da migration'ın ilk adımı uygulandı, ikincisi hata verdi. Sistem artık ne eski sürümde ne yeni sürümde ve kimse hangi kombinasyonun test edildiğini bilmiyor. Yarım deploy'un çaresi, her adımı geri alınabilir ya da tekrar çalıştırılabilir (idempotent) yapmak ve deploy'un nerede kaldığını açıkça raporlamak.
Strateji Haritası
Kesintiyi önlemenin ya da küçültmenin farklı yolları var. Aşağıdaki şekil, en yaygın stratejilerde trafiğin eski ve yeni sürüm arasında zamanla nasıl paylaşıldığını gösteriyor.
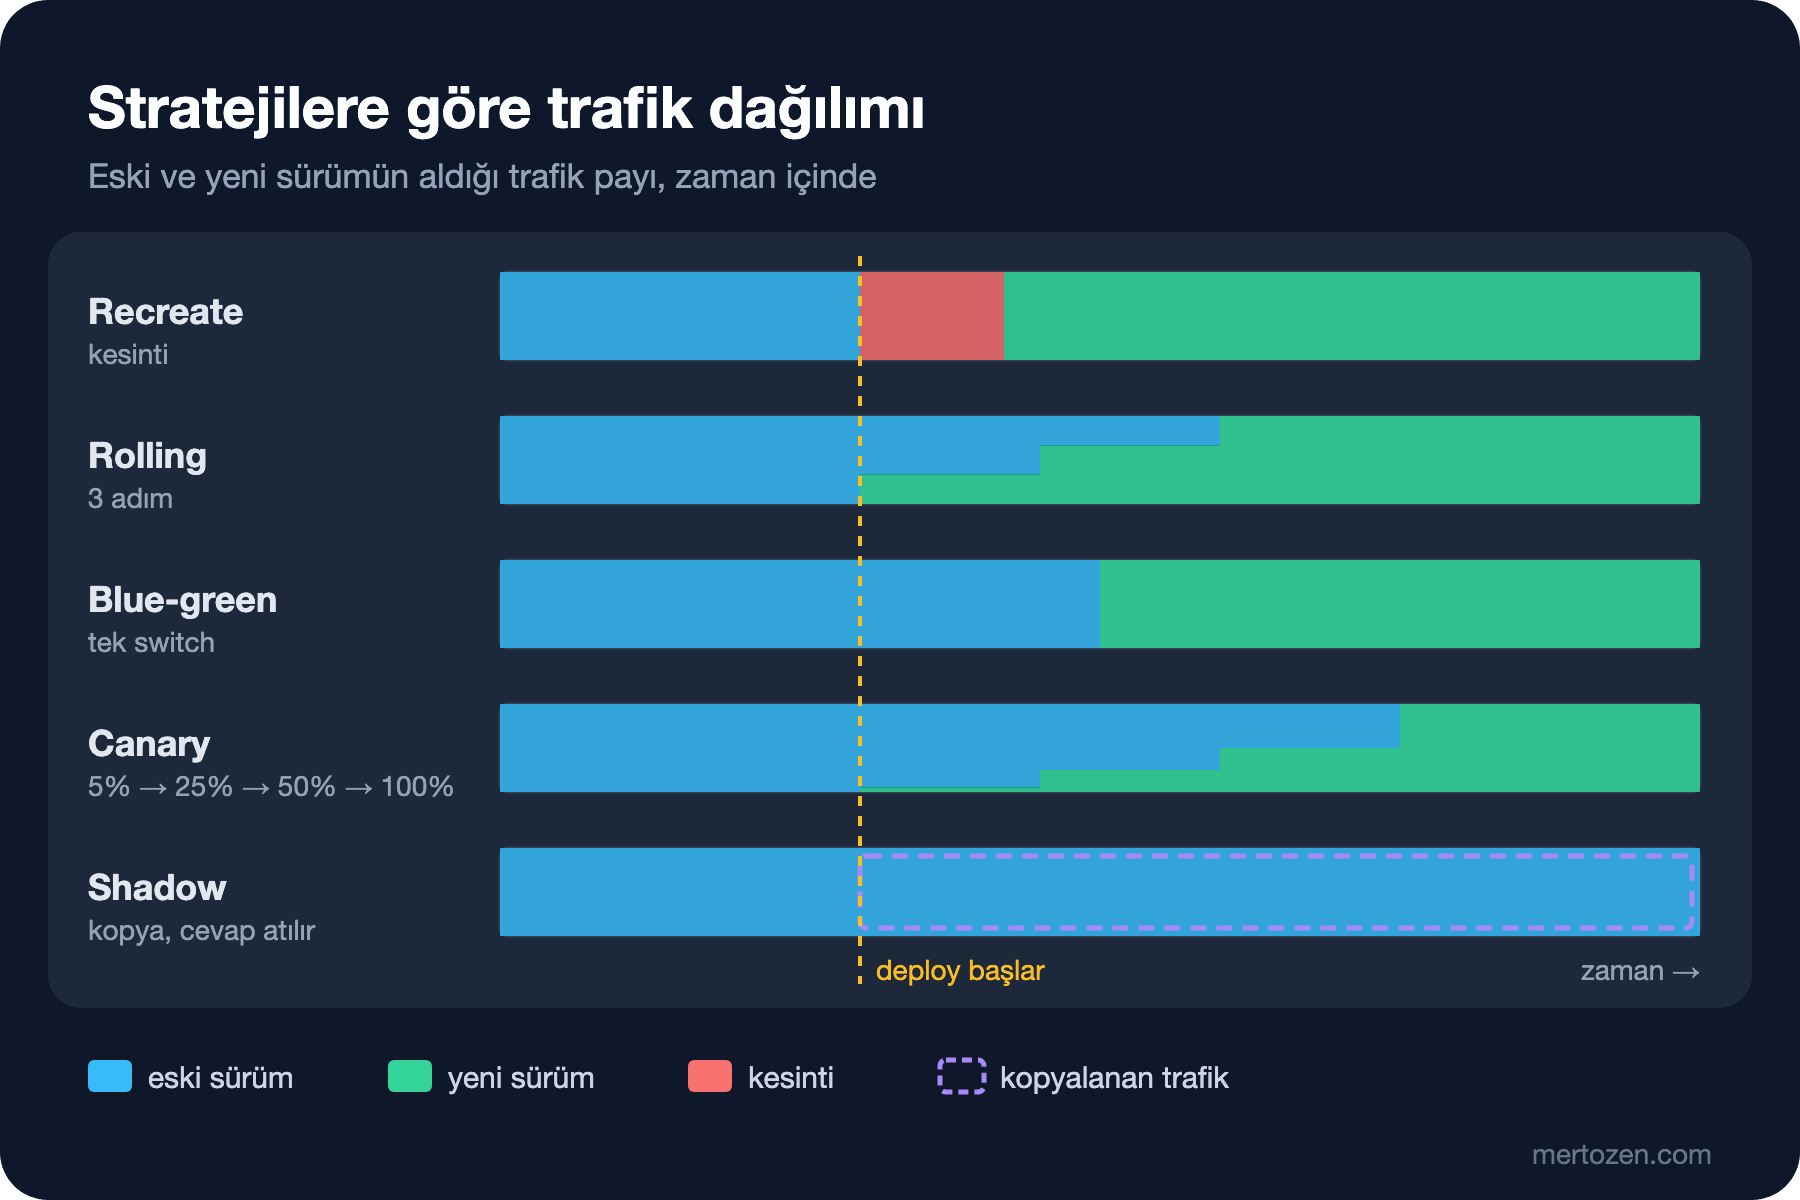
Recreate eskiyi kapatır, yeniyi açar. Arada kesinti olur ama sistem hiçbir an iki sürümü birlikte çalıştırmaz. Tek instance'lık iç araçlar, gece bakım penceresinde deploy edilen sistemler ve iki sürümün yan yana yaşayamadığı durumlar için hâlâ geçerli bir seçim.
Rolling instance'ları sırayla günceller. Ek altyapı gerektirmez, ama deploy boyunca iki sürüm birlikte çalışır ve geri dönüş de aynı yavaşlıktadır. Kubernetes'in varsayılanı budur. Üçüncü yazının konusu.
Blue-green yeni sürümü ayrı bir ortamda tamamen ayağa kaldırır, test eder ve trafiği tek hamlede çevirir. Geri dönüş de tek hamledir. Bedeli, bir süreliğine iki kat kapasite ve iki ortamın aynı veritabanını paylaşması. Martin Fowler 2010'daki "BlueGreenDeployment" yazısında bu adı yaygınlaştırdı. Dördüncü yazının konusu.
Canary trafiğin küçük bir yüzdesini yeni sürüme verir, metriklere bakar, sorun yoksa yüzdeyi artırır. Riski kullanıcı sayısıyla sınırlar ama karar vermek için metrik ve sabır ister. Beşinci yazının konusu.
Shadow (dark launch) gerçek trafiğin bir kopyasını yeni sürüme gönderir ama cevabını kullanıcıya göstermez. Performansı ve hataları gerçek yükle görürsün, kullanıcı etkilenmez. Yazma işlemleri olan endpoint'lerde dikkat ister, çünkü kopyalanan bir sipariş isteği iki kez sipariş oluşturabilir.
A/B testing teknik değil, ürün deneyidir. İki davranışı kullanıcı gruplarına dağıtıp hangisinin iş metriğini (dönüşüm, sepet tutarı) daha iyi etkilediğini ölçer. Altyapısı canary'ye benzer ama amacı farklıdır: canary "yeni sürüm bozuk mu?" diye sorar, A/B testing "hangisi daha iyi?" diye.
Feature flag ise trafiği değil davranışı yönetir. Kod deploy edilir, davranış bir flag ile açılıp kapanır. Deploy ile release'i en net ayıran araçtır ve diğer stratejilerle birlikte kullanılır. Yedinci yazının konusu.
Karar Tablosu
Strateji seçerken dört soru sorulur: ne kadar ek altyapı gerekiyor, sorun çıkınca ne kadar hızlı geri dönebiliyorum, iki sürüm ne kadar süre yan yana çalışıyor ve veritabanı değişikliklerinin geriye uyumlu olması şart mı?
| Strateji | Ek altyapı | Geri dönüş hızı | Karışık sürüm süresi | Geriye uyumlu şema şart mı? |
|---|---|---|---|---|
| Recreate | Yok | Yeniden deploy kadar yavaş, yine kesintili | Yok | Hayır, ama kesinti kabul edilir |
| Rolling | Yok ya da bir instance | Yavaş, ters yönde rolling | Deploy süresi boyunca | Evet |
| Blue-green | İkinci tam ortam | Saniyeler, tek switch | Yalnız switch anı ve uzun bağlantılar | Evet, ortamlar aynı veritabanını kullanır |
| Canary | Trafiği bölebilen load balancer, metrik | Hızlı, canary'yi sıfıra indir | Saatler ya da günler | Evet |
| Shadow | Trafik kopyalama, ayrı kaynak | Gerekmez, kullanıcı görmüyor | Yok, kullanıcı tek sürüm görür | Yazma işlemlerinde ayrı veri gerekir |
| Feature flag | Flag altyapısı | Saniyeler, flag'i kapat | Kod hep aynı sürüm | Flag şemayı saklayamaz, yine evet |
Tablodaki en önemli sütun son sütun. Recreate dışındaki bütün stratejiler, eski ve yeni kodun aynı veritabanıyla bir süre birlikte çalışmasını gerektirir. Bu yüzden migration disiplini olmayan bir ekip hangi stratejiyi seçerse seçsin, deploy anında kesinti yaşamaya devam eder.
Risk = Blast Radius × Tespit Süresi
Stratejileri karşılaştırmanın en işe yarar yolu, bir hatanın kaç kullanıcıya ne kadar süre dokunduğunu düşünmek. Blast radius, hatalı sürümün gördüğü trafiğin payı; tespit süresi, hatayı fark edip trafiği geri çevirene kadar geçen süre. İkisinin çarpımı etkilenen istek sayısını verir.
Basit bir hesap yapalım: dakikada 10.000 istek alan bir sistemde, isteklerin %5'ini bozan bir hata çıkıyor ve ekip onu beş dakikada fark edip geri alıyor. Recreate ya da tam switch ile yeni sürüm bütün trafiği alır: 5 dakika × 10.000 × %5 = 2.500 hatalı istek. Aynı hata %5'lik bir canary'de çıkarsa yeni sürüm trafiğin yalnız yirmide birini görür ve sonuç 125 hatalı istek olur. Otomatik metrik analizi tespit süresini bir dakikaya indirirse bu sayı 25'e düşer.
Bu hesap iki şey öğretiyor. Birincisi, blast radius'u küçültmek (canary, feature flag ile kullanıcı hedefleme) ile tespit süresini kısaltmak (metrik, alarm, otomatik rollback) birbirinin yerine geçmez, çarpılırlar. İkisine de yatırım gerekir. İkincisi, geri dönüş hızı da tespit süresinin bir parçası: hatayı bir dakikada görüp geri dönüşü on dakikada yapabiliyorsan, tespit süren aslında on bir dakikadır. Blue-green'in değeri tam burada.
Üretimde Dikkat
Deploy'u bir olay olarak ölç. Her deploy için başlangıç ve bitiş zamanını, deploy penceresindeki 5xx sayısını, yeni sürümün ilk 15 dakikasındaki hata oranını ve geri dönüş yapılıp yapılmadığını kaydet. Bunlar DORA'nın (DevOps Research and Assessment) beş metriğinden ikisinin, change fail rate ile failed deployment recovery time'ın ham verisi. Serinin sekizinci yazısında bunları rollback kararıyla birlikte ele alacağız.
Deploy'ları sıkıcı hale getirmeye çalış. Seyrek ve büyük deploy'lar her seferinde daha riskli olur, çünkü değişiklik büyüdükçe hem blast radius hem de hatayı bulma süresi uzar. Küçük ve sık deploy'larda strateji seçimi de kolaylaşır.
Sık Düşülen Tuzaklar
- Deploy ile release'i aynı şey sanmak. Bu durumda her deploy bir release olur ve risk tek bir ana yığılır.
- "Kubernetes kullanıyoruz, kesinti olmaz" demek. Kubernetes rolling yapar, ama uygulama graceful shutdown ve readiness'i doğru uygulamıyorsa rolling de kesinti üretir.
- Strateji seçip veritabanını unutmak. Blue-green ile trafiği bir saniyede çeviren ekip, aynı deploy'da kolon silen bir migration çalıştırırsa geri dönüş yolunu kendi eliyle kapatır.
- Geri dönüşü hiç denememek. Kâğıt üstünde "blue'ya döneriz" denen birçok planda blue ortam çoktan kapatılmış ya da eski sürümün config'i silinmiş olur.
- Staging'de denendi diye production'ı aynı kabul etmek. Trafik, veri hacmi ve uzun süren bağlantılar staging'de yoktur; stratejinin değeri tam bu farkta ortaya çıkar.
Küçük Bir Deneme
★☆☆ Yukarıdaki recreate denemesini, container'ı -e WARMUP_SECONDS=5 ile başlatarak tekrar et. Bu ayar Bookstore'un readiness'ini beş saniye geciktiriyor, ama Nginx readiness'e bakmıyor. Hata penceresi değişir mi, neden?
★★☆ probe.sh'yi bir GET ve bir POST endpoint'i için aynı anda çalıştır ve recreate sırasında ikisinin hata sayılarını karşılaştır. Fark varsa sebebini Nginx'in proxy_next_upstream dokümanında ara.
★★★ Kendi sisteminden son üç ayın deploy'larını çıkar ve her biri için "blast radius × tespit süresi" hesabını yap. En pahalı olayda hangi strateji bu çarpımı en çok küçültürdü?
Hangi stratejiyi seçersen seç, altında aynı ön koşullar yatıyor: kapanırken işini bitiren, hazır olduğunu doğru söyleyen ve hangi instance'ta çalıştığından bağımsız davranan bir uygulama. Bir sonraki yazıda bu ön koşulları tek tek ölçüyoruz: graceful shutdown, readiness, stateless olmak, geriye uyumluluk ve Angular'ın eski chunk'ları.