

Request Dışında İş Yapmak: Fire-and-Forget, BackgroundService, Hangfire ve Quartz.NET Arasında Seçim
Controller içinde Task.Run ile başlatılan iş, request scope'u kapanınca DbContext'i kaybeder, exception'ı sessizce yutar ve deploy'da yarıda kalır; işi host'un yönettiği bir yere devretmek gerekir. Seçimi beş soru belirler: iş restart'ta kaybolabilir mi, zamanlı mı, retry ve dashboard gerekir mi, kaç instance var; cevaplara göre BackgroundService, Hangfire, Quartz.NET ya da platform scheduler.
Sürüm notu: Bu yazıdaki kodlar .NET 10 ve Entity Framework Core (EF Core) 10.0.14 (SQLite provider'ı) ile derlenip denenmiştir.
Önce Tahmin Et
Bookstore'da sipariş onaylanınca müşteriye e-posta gidiyor. E-posta servisi yavaş olduğu için bir geliştirici endpoint'i şöyle "hızlandırmış": işi Task.Run ile arka plana atıp hemen 202 Accepted dönüyor. Kod derleniyor, testte e-posta da gidiyor gibi görünüyor. Production'da ise bazı müşteriler hiç e-posta almıyor ve log'larda tek bir hata satırı yok.
Aşağıdaki endpoint'e istek attığında ne olur? E-posta gider mi, gitmezse log'a bir şey düşer mi? Bir de şunu düşün: bu sırada uygulama yeni sürüme deploy edilirse, yolda olan e-postaya ne olur?
app.MapPost("/v1/orders/{id:int}/confirm", (int id, BookstoreDbContext db, IEmailSender email) =>
{
    _ = Task.Run(async () =>
    {
        await Task.Delay(200);
        Order order = await db.Orders.SingleAsync(o => o.Id == id);
        await email.SendAsync(order.CustomerEmail, $"Order #{order.Id} confirmed");
    });
    return Results.Accepted();
});
Controller'daki Task.Run Neden Kaybolur?
Endpoint'in parametresindeki BookstoreDbContext request scope'una ait. ASP.NET Core her request için bir DI (Dependency Injection) scope'u açar, response yazılınca scope'u ve içindeki scoped service'leri dispose eder. Task.Run içindeki lambda ise 200 ms sonra çalışıyor; o anda request çoktan bitmiş, DbContext dispose edilmiş durumda. Bu, ASP.NET Core Web API (Application Programming Interface) serisinin "ASP.NET Core'da Dependency Injection: Lifetime'lar ve Captive Dependency Tuzağı" yazısında anlattığımız lifetime kuralının arka plandaki yüzü: scoped bir nesneyi scope'undan daha uzun yaşayan bir koda vermek.
Asıl sinsi kısım ikincisi. _ = Task.Run(...) ile dönen Task'ı kimse beklemiyor. İçeride fırlayan exception Task'ın içinde kalır; kimse await etmediği için hiçbir yere loglanmaz. Gerçek koşuda /v1 endpoint'ine attığım isteğin log'u şuydu:
04:56:29.660 info: Microsoft.AspNetCore.Hosting.Diagnostics[1] Request starting HTTP/1.1 POST http://127.0.0.1:17111/v1/orders/42/confirm - - -
04:56:29.697 info: Microsoft.AspNetCore.Http.Result.AcceptedResult[1] Setting HTTP status code 202.
04:56:29.700 info: Microsoft.AspNetCore.Hosting.Diagnostics[2] Request finished HTTP/1.1 POST http://127.0.0.1:17111/v1/orders/42/confirm - 202 0 - 39.9260ms
202 döndü ve bitti. Ne e-posta var ne de hata. Aynı kodu bir try/catch içine alıp exception'ı loglayan /v2 endpoint'i, perde arkasında ne olduğunu gösteriyor:
04:56:30.734 info: Microsoft.AspNetCore.Hosting.Diagnostics[2] Request finished HTTP/1.1 POST http://127.0.0.1:17111/v2/orders/42/confirm - 202 0 - 3.4767ms
04:56:30.946 fail: Program[0] Confirmation email for order 42 failed System.ObjectDisposedException: Cannot access a disposed context instance. A common cause of this error is disposing a context instance that was resolved from dependency injection and then later trying to use the same context instance elsewhere in your application. [...] Object name: 'BookstoreDbContext'.
C# Asenkron serisinin "C# async void ve Fire-and-Forget: Kaybolan Exception'lar" yazısında bu davranışın mekaniğini görmüştük: gözlenmeyen bir Task'ın exception'ı en fazla TaskScheduler.UnobservedTaskException event'ine düşer, o da ancak Task garbage collector tarafından toplanırken. Production'da "e-posta neden gitmedi" sorusunun cevabını log'da bulamamanın sebebi bu.
Scope sorununu IServiceScopeFactory ile yeni bir scope açarak çözebilirsin; exception'ı da try/catch ile görünür kılabilirsin. Ama üçüncü sorun kodla çözülmüyor.
Deploy Sırasında Yarıda Kalan İş
/v3 endpoint'i fatura PDF'ini (Portable Document Format) üretip göndermeyi taklit ediyor: iş 10 saniye sürüyor. İsteği attıktan bir saniye sonra process'e, Kubernetes'in pod'u kapatırken gönderdiği sinyalin aynısı olan SIGTERM'ü (terminate signal) gönderdim:
04:56:32.791 info: Microsoft.AspNetCore.Hosting.Diagnostics[2] Request finished HTTP/1.1 POST http://127.0.0.1:17111/v3/orders/42/confirm - 202 0 - 0.2445ms
04:56:32.791 info: Program[0] Generating invoice PDF for order 42
04:56:33.804 info: Microsoft.Hosting.Lifetime[0] Application is shutting down...
"Invoice for order 42 sent" satırı hiç gelmedi. Host kapanırken yalnız kendi bildiği işleri bekler: hosted service'leri durdurur, Kestrel'in açık request'lerini bitirmesine izin verir. Task.Run ile başlatılmış bir iş host'un listesinde yok; process kapanınca thread pool'daki iş de onunla birlikte gider. Günde on deploy yapan bir ekip için bu, günde on kez "yolda" olan her işi kaybetmek demek.
Üç sorun aynı kökten çıkıyor: iş, onu kimin sahiplendiği belli olmadan başlatılıyor. Çözüm de aynı yönde: işi, yaşam döngüsü host tarafından yönetilen bir yere devretmek.
İşi Host'a Devretmek: Channel ve BackgroundService
En küçük doğru adım, endpoint'in yalnızca "bu iş yapılacak" bilgisini bir queue'ya yazması ve işi host'un başlatıp durdurduğu bir BackgroundService'in yapması:
builder.Services.AddDbContext<BookstoreDbContext>(o => o.UseSqlite("Data Source=bookstore.db"));
builder.Services.AddScoped<IEmailSender, LogEmailSender>();
builder.Services.AddSingleton(Channel.CreateBounded<OrderConfirmed>(100));
builder.Services.AddHostedService<OrderEmailWorker>();

// ...

app.MapPost("/v4/orders/{id:int}/confirm", async (int id, Channel<OrderConfirmed> queue, CancellationToken ct) =>
{
    await queue.Writer.WriteAsync(new OrderConfirmed(id), ct);
    return Results.Accepted();
});
public sealed record OrderConfirmed(int OrderId);
public sealed class OrderEmailWorker(
Channel<OrderConfirmed> queue,
IServiceScopeFactory scopeFactory,
ILogger<OrderEmailWorker> logger) : BackgroundService
{
protected override async Task ExecuteAsync(CancellationToken stoppingToken)
{
await foreach (OrderConfirmed message in queue.Reader.ReadAllAsync(stoppingToken))
{
try
{
// her iş kendi scope'unda: DbContext request'e değil bu işe ait
await using AsyncServiceScope scope = scopeFactory.CreateAsyncScope();
var db = scope.ServiceProvider.GetRequiredService<BookstoreDbContext>();
var email = scope.ServiceProvider.GetRequiredService<IEmailSender>();
Order order = await db.Orders.SingleAsync(o => o.Id == message.OrderId, stoppingToken);
await email.SendAsync(order.CustomerEmail, $"Order #{order.Id} confirmed", stoppingToken);
}
catch (Exception ex) when (ex is not OperationCanceledException)
{
logger.LogError(ex, "Confirmation email for order {OrderId} failed", message.OrderId);
}
}
}
}/v4 endpoint'ine istek attığımda log şuydu:
04:56:31.766 info: Microsoft.AspNetCore.Hosting.Diagnostics[2] Request finished HTTP/1.1 POST http://127.0.0.1:17111/v4/orders/42/confirm - 202 0 - 0.6945ms
04:56:32.039 info: Bookstore.Api.LogEmailSender[0] Email to ada@example.com: Order #42 confirmed
Farklar küçük görünüyor ama her biri bir sorunu kapatıyor. Worker her iş için kendi scope'unu açıyor; DbContext artık request'e değil işe ait. Exception yakalanıp loglanıyor ve worker'ı düşürmüyor. Host kapanırken stoppingToken iptal ediliyor; worker o an yaptığı işi bitirip çıkma şansı buluyor. BackgroundService'in yaşam döngüsünü ve kapanış süresini serinin ikinci yazısında, bounded queue ile backpressure'ı da üçüncü yazıda ayrıntılı kuracağız.
Ama bir şey değişmedi: queue hâlâ process'in belleğinde. Process çökerse ya da deploy edilirse queue'daki e-postalar yine kaybolur. Bu bazen kabul edilebilir, bazen değil. Hangi aracı seçeceğini belirleyen ilk soru da tam olarak bu.
Karar Ekseni: Beş Soru
"Hangfire mı Quartz mı" sorusu genellikle yanlış yerden başlar. Önce işin kendisine beş soru sor:
Kalıcılık: iş restart'ta ya da deploy'da kaybolursa ne olur? "Sepete eklendi" analitik event'i kaybolabilir; sipariş onay e-postası ya da tedarikçiye giden stok siparişi kaybolamaz. Kaybolamayan iş, process'in belleğinde değil bir veritabanında ya da broker'da durmalı.
Zamanlama: iş bir olayla mı tetikleniyor (sipariş onaylandı), yoksa saatle mi (her gece 03:00, her 5 dakikada bir)? Saatle tetiklenen işlerde cron ifadesi, time zone ve "uygulama kapalıyken kaçırılan çalışma ne olacak" soruları gelir.
Retry: iş geçici bir hatada (tedarikçi API'si 503 döndü) tekrar denenmeli mi, kaç kez, ne aralıkla? Retry'ı kendin yazabilirsin, ama denemelerin process restart'ından sonra da sürmesi gerekiyorsa deneme sayısının da bir yerde saklanması gerekir.
Çok instance: API üç replica ile çalışıyorsa, her replica'daki BackgroundService gece raporunu üç kez üretir. Zamanlı işlerin cluster genelinde bir kez çalışması gerekiyorsa koordinasyon şart.
Görünürlük: başarısız job'ları görmek, elle yeniden tetiklemek, kuyruğun ne kadar büyüdüğünü izlemek isteyen biri var mı? Varsa bir dashboard ve job geçmişi gerekir.
Bu sorulara göre seçenekler şöyle ayrışıyor:
| Seçenek | Kalıcılık | Zamanlama | Retry | Çok instance | Dashboard |
|---|---|---|---|---|---|
Task.Run (fire-and-forget) | Yok | Yok | Yok | Yok | Yok |
BackgroundService + Channel | Yok (bellekte) | Kendin yazarsın (PeriodicTimer, Cronos) | Kendin yazarsın | Distributed lock'la kendin | Yok |
| Hangfire | Var (SQL Server, PostgreSQL…) | Cron, delayed job | Var (varsayılan 10 deneme) | Storage üzerinden | Var |
| Quartz.NET 4 | Var (ADO.NET JobStore) | Cron, takvim, RFC (Request for Comments) 5545 kuralları | Var (retry policy, 4.0+) | Clustering | Var (4.x) |
| Platform scheduler | Platform tutar | Cron | Platform ayarı | Tek çalışma garantisi platformda | Platformun araçları |
Seçenekler: BackgroundService, Hangfire, Quartz.NET, TickerQ ve Coravel
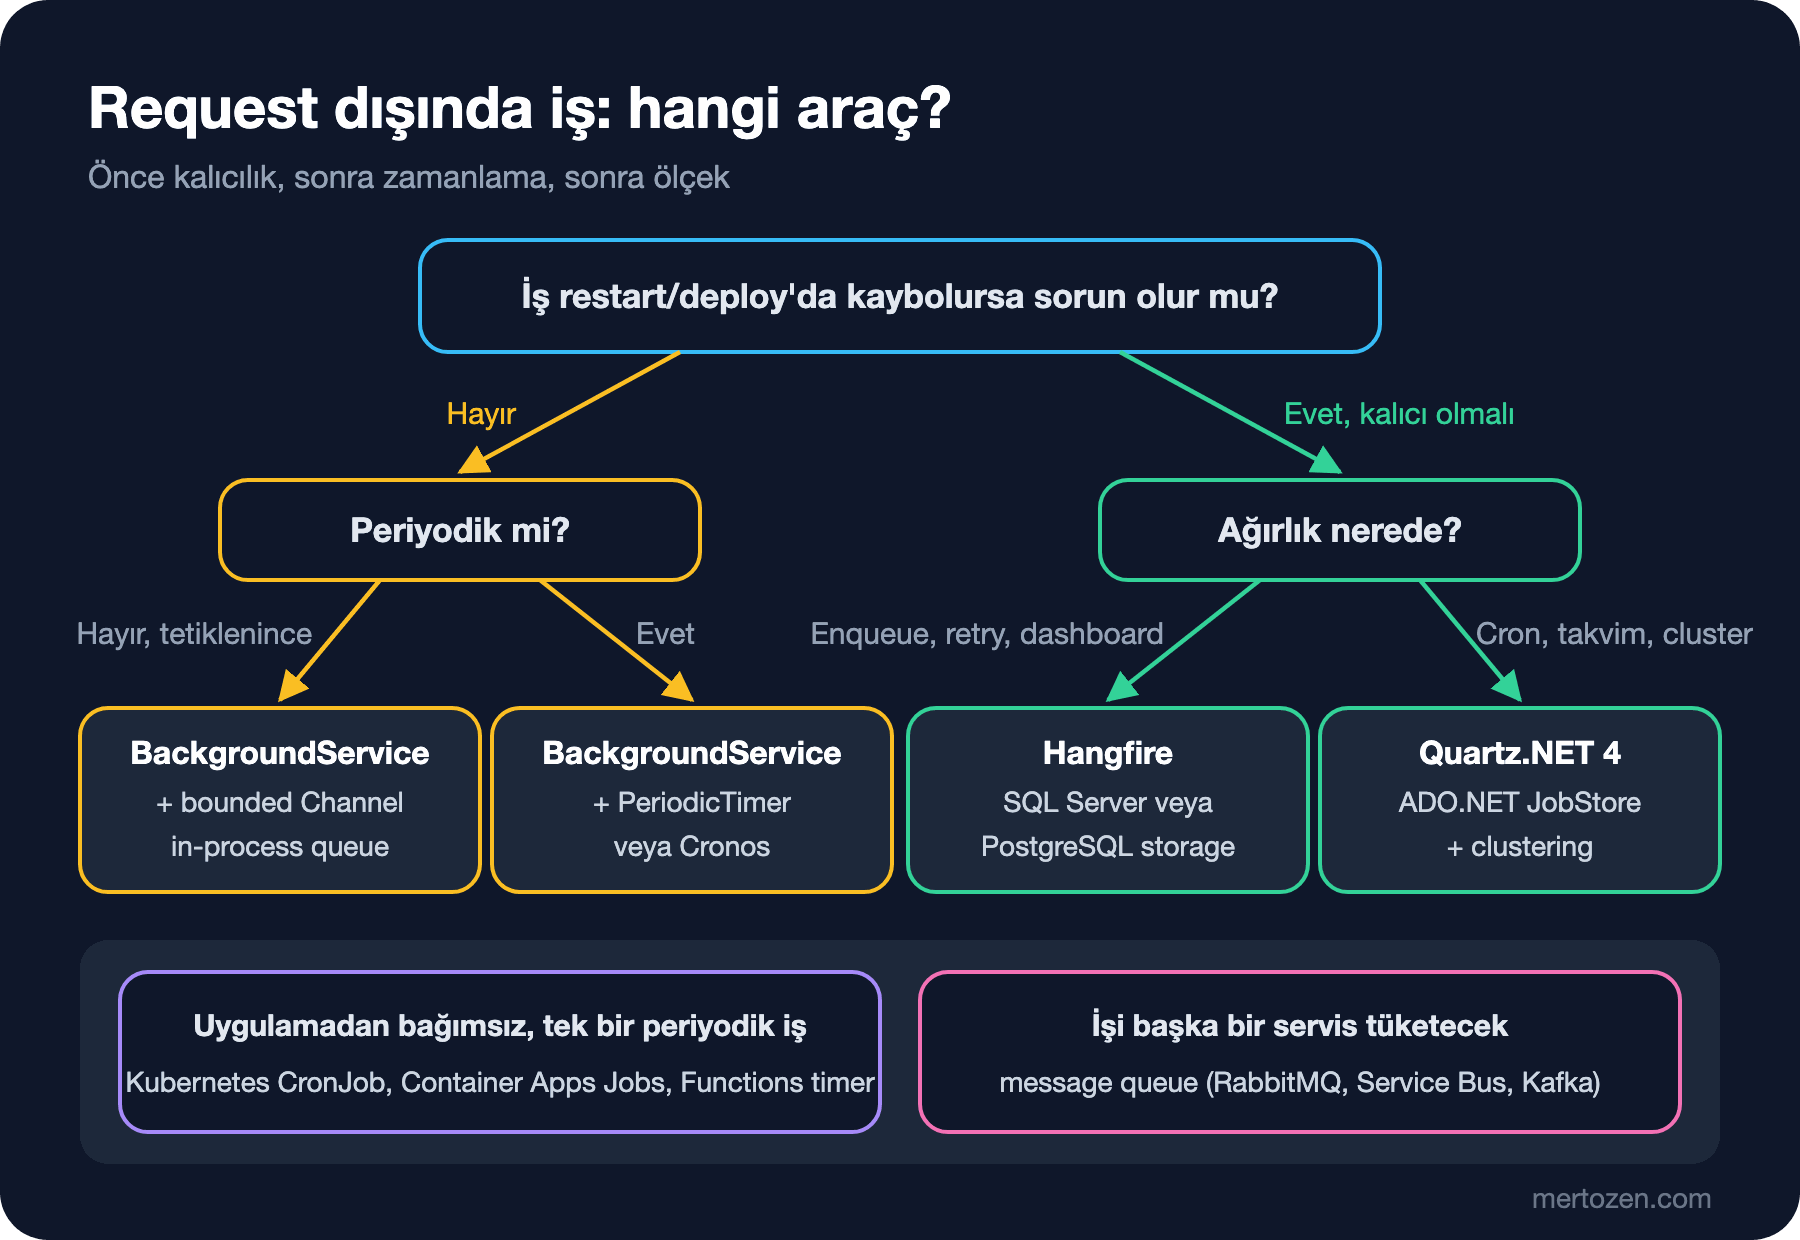
BackgroundService, .NET'in kendi hosting altyapısının parçası; ek paket yok. İş kaybolabiliyorsa ya da kalıcılığı başka bir yer (bir message queue, bir outbox tablosu) zaten sağlıyorsa doğru başlangıç noktası bu. Tetiklenen işler için Channel, periyodik işler için PeriodicTimer ya da cron gerekiyorsa Cronos kütüphanesi yeterli. Seriyi de bu yüzden buradan başlatıyoruz: Hangfire ve Quartz.NET de sonuçta birer hosted service olarak çalışıyor.
Hangfire'ın merkezinde "bu method'u şu argümanlarla çalıştır" kaydı var. BackgroundJob.Enqueue(() => ...) ile bir method çağrısını storage'a yazarsın, Hangfire server'ı onu alıp çalıştırır, hata olursa artan aralıklarla tekrar dener ve her şeyi dashboard'da gösterir. Fire-and-forget, delayed, recurring ve continuation job'ların hepsi aynı modelin varyasyonları. Core paketi LGPL (GNU Lesser General Public License) 3.0 lisanslı ve ticari kullanımda ücretsiz; Redis storage ve batch gibi özellikler ücretli Pro paketinde. Ayrıntılar beşinci yazıda.
Quartz.NET'in merkezinde ise zamanlama var: job (ne yapılacak) ile trigger (ne zaman) ayrı nesneler; bir job'a birden fazla trigger bağlanabilir, takvimlerle tatil günleri dışlanabilir, misfire (kaçırılan çalışma) davranışı trigger başına seçilebilir. Eylül 2026'da çıkan 4.0 büyük bir sürüm: yalnız net10.0 hedefliyor, DI ve hosting desteği çekirdek pakete taşındı, dashboard ve HTTP (Hypertext Transfer Protocol) API'si geldi. Yazının yazıldığı tarihteki son sürüm 4.7.2. Altıncı yazıda kuracağız.
Kaba bir kural: işlerin çoğu "şunu arka planda yap, olmazsa tekrar dene" ise Hangfire'ın enqueue modeli daha az kodla daha çok iş görür. İşlerin çoğu karmaşık zamanlama kuralları, takvimler ve cluster'da tam bir kez çalışma ise Quartz.NET'in modeli daha doğal oturur.
İki küçük alternatif daha var. Coravel (6.0.2) kodda akıcı bir syntax ile zamanlama ve in-memory bir queue sunuyor; tek instance'lı, kalıcılık gerektirmeyen küçük uygulamalar için pratik. TickerQ (NuGet'te 11.5.x) EF Core, MongoDB ya da Redis ile kalıcılık, job zincirleri ve dashboard sunuyor; lisansı source-available ve README'sine göre yıllık geliri 5 milyon doların altındaki şirketler Community planını ücretsiz kullanabiliyor. Bu seride ikisine ayrı yazı ayırmıyoruz.
Platform Scheduler'lar: Job'u Uygulamanın Dışına Çıkarmak
Bazen en iyi background job, uygulamanın içinde hiç olmayanıdır. Gecede bir çalışan, API'yle ortak hiçbir state'i olmayan bir iş (örneğin eski sepetleri temizleyen bir SQL (Structured Query Language) script'i) için Kubernetes CronJob, Azure Container Apps Jobs ya da Azure Functions timer trigger daha basit olabilir: platform zamanlamayı, tek seferlik çalışmayı ve log'ları üstlenir, sen yalnız işi yapan bir console uygulaması yazarsın.
Bunun bedeli de var: job'un kodu ayrı bir artifact olarak deploy edilir, uygulamanın DI container'ını ve configuration'ını paylaşmaz, saniyeler mertebesindeki işlerde container başlatma maliyeti işin kendisinden pahalıya gelir. Kubernetes CronJob'un ayrıntıları ilerideki Kubernetes ve Cloud Temelleri serilerinin konusu; burada yalnız karar kriterini koyalım: iş uygulamanın domain kodunu ve DI'ını yoğun kullanıyorsa uygulama içinde tut; bağımsız ve seyrekse platforma ver.
Bir de işin aslında bir job değil, bir mesaj olduğu durum var. Sipariş onaylandığında e-posta servisi, fatura servisi ve analitik servisi ayrı ayrı tepki verecekse, bu bir "OrderConfirmed" event'idir ve yeri bir message queue'dur. Messaging ve Event-Driven Architecture serisinde bu ayrımı kavram olarak, ilerideki Message Queue'larla Çalışmak serisinde de .NET kodu olarak işliyoruz.
Üretimde Dikkat
Seçtiğin araç ne olursa olsun, production'da şu üç şeyi ölç. Birincisi kuyruk derinliği: queue'ya yazılan iş sayısı işlenenden hızlı artıyorsa worker sayısı yetmiyor demektir. İkincisi job süresi: p95 süresi recurring job'un aralığına yaklaşıyorsa çalışmalar üst üste binmeye başlar. Üçüncüsü son başarılı çalışmanın zamanı: hiç hata vermeyen ama hiç çalışmayan bir job, hata veren job'dan daha tehlikelidir, çünkü alarm üretmez. Bu üçünü serinin onuncu yazısında health check ve OpenTelemetry ile kuracağız.
Deploy stratejin de seçimini etkiler. Rolling update sırasında eski ve yeni sürüm birkaç dakika yan yana çalışır. Kalıcı bir job store'unda eski sürümün kuyruğa yazdığı job'u yeni sürüm işleyebilir; method imzasını değiştirdiysen bu bir sorun olur. Beşinci yazıda Hangfire üzerinde bunun gerçek hata mesajını göreceğiz.
Sık Düşülen Tuzaklar
Request'teki scoped service'i arka plandaki koda vermek. DbContext, HttpContext ve request'e bağlı her şey response yazılınca geçersizdir; arka plandaki iş kendi scope'unu açmalı ve yalnız id gibi basit değerleri almalı.
Dönen Task'ı yok saymak. _ = Task.Run(...) exception'ı sessizce yutar; ne log, ne metrik, ne alarm. Fire-and-forget yazacaksan en azından try/catch ile logla, ama asıl çözüm işi bir sahibi olan yere devretmek.
In-memory queue'yu kalıcı sanmak. Channel ile kurulan queue restart'ta boşalır. "Kaybolursa sorun olur mu" sorusunun cevabı "evet" ise in-memory çözüm yetmez.
Çok instance'ı unutmak. Tek makinede geliştirip üç replica'ya deploy edilen zamanlı bir BackgroundService, işini üç kez yapar. Bunu sekizinci yazıda distributed lock ile çözeceğiz.
Aracı işe göre değil alışkanlığa göre seçmek. Her periyodik iş için Quartz cluster'ı kurmak da, kaybolmaması gereken her iş için Task.Run yazmak da yanlış; beş soruyu her yeni iş için yeniden sor.
Küçük Bir Deneme
★☆☆ /v1 endpoint'ini çalıştır ve Program.cs'in başına TaskScheduler.UnobservedTaskException += (_, e) => Console.WriteLine(e.Exception.Message); ekle. Mesaj ne zaman görünüyor? Birkaç istekten sonra GC.Collect() ve GC.WaitForPendingFinalizers() çağıran bir endpoint ekleyip tekrar dene.
★★☆ OrderEmailWorker'a e-posta gönderimi için 3 saniyelik bir gecikme ekle, beş istek at ve hemen ardından process'e SIGTERM gönder. Kaç e-posta gidiyor, queue'da kalanlara ne oluyor?
★★★ Kendi projendeki üç arka plan işini beş soruya göre tabloya dök: kalıcılık, zamanlama, retry, çok instance, görünürlük. Hangileri bugünkü çözümüyle yanlış yerde duruyor?
Bir sonraki yazıda bu yazının temelindeki yapıyı söküp inceliyoruz: IHostedService ve BackgroundService'in yaşam döngüsü, graceful shutdown, ShutdownTimeout ve .NET 10'da ExecuteAsync'in davranışını değiştiren breaking change.