

Çok Instance'lı Ortamda Job'lar: Distributed Lock, Leader Election ve Aynı İşin İki Kez Çalışması
Üç replica'daki BackgroundService gece raporunu üç kez üretir; DistributedLock ile SQL Server sp_getapplock, PostgreSQL advisory lock ya da Redis üzerinden alınan bir lock bunu bire indirir. Lock'un sahibi kill -9 ile ölünce Redis'te lock 30 saniyelik lease bitene kadar kimsede kalmaz; PostgreSQL'de ise sunucu bağlantının koptuğunu fark edene kadar, denememde yaklaşık bir dakika, ölü process'te kaldı. Lock bir garanti değil, bir lease'tir.
Sürüm notu: Bu yazıdaki kodlar .NET 10, DistributedLock.Postgres 1.3.1, DistributedLock.SqlServer 1.0.7, DistributedLock.Redis 1.1.1, Cronos 0.13.0 ve Hangfire 1.8.25 ile derlenip denenmiştir; lock'lar PostgreSQL 17, SQL (Structured Query Language) Server 2025 ve Redis 7.4 üzerinde koşturuldu.
Önce Tahmin Et
Bookstore'un API'si (Application Programming Interface) tek pod'la çalışırken gece satış raporunu bir BackgroundService üretiyordu. Kampanya için API 3 replica'ya çıkarıldı. Ertesi sabah muhasebe aynı raporu kaç kez aldı? Bunu bir distributed lock ile çözüyorsun ve lock'u tutan pod tam o sırada kill -9 ile ölüyor. Diğer iki pod lock'u ne zaman alabilir: hemen mi, birkaç saniye sonra mı, yoksa çok daha sonra mı? Cevap lock'u Redis'te mi PostgreSQL'de mi tuttuğuna bağlı mı?
Üç Replica, Üç Rapor
Denemeyi kısaltmak için "her gece 03:00" yerine her 5 saniyede bir rapor üreten, Cronos ile saat sınırına hizalanmış bir service yazdım:
public static class Schedule
{
    // demoda "her gece 03:00" yerine her 5 saniyede bir
    public static readonly CronExpression Report = CronExpression.Parse("*/5 * * * * *", CronFormat.IncludeSeconds);

    public static async Task<DateTime> WaitForNextAsync(CancellationToken ct)
    {
        DateTime now = DateTime.UtcNow;
        DateTime next = Report.GetNextOccurrence(now)!.Value;
        await Task.Delay(next - now, ct);
        return next;
    }
}

public sealed class NaiveNightlyReportService(IConfiguration config, ILogger<NaiveNightlyReportService> logger) : BackgroundService
{
    protected override async Task ExecuteAsync(CancellationToken stoppingToken)
    {
        while (!stoppingToken.IsCancellationRequested)
        {
            DateTime slot = await Schedule.WaitForNextAsync(stoppingToken);
            logger.LogInformation("[{Replica}] generating sales report for {Slot:HH:mm:ss}", config["Replica"], slot);
            await Task.Delay(2000, stoppingToken);
        }
    }
}
Aynı binary'yi üç process olarak başlattım (--Replica api-1, api-2, api-3):
05:15:45.006 info: Bookstore.Reports.NaiveNightlyReportService[0] [api-1] generating sales report for 02:15:45
05:15:45.006 info: Bookstore.Reports.NaiveNightlyReportService[0] [api-2] generating sales report for 02:15:45
05:15:45.006 info: Bookstore.Reports.NaiveNightlyReportService[0] [api-3] generating sales report for 02:15:45
05:15:50.001 info: Bookstore.Reports.NaiveNightlyReportService[0] [api-1] generating sales report for 02:15:50
05:15:50.001 info: Bookstore.Reports.NaiveNightlyReportService[0] [api-2] generating sales report for 02:15:50
05:15:50.001 info: Bookstore.Reports.NaiveNightlyReportService[0] [api-3] generating sales report for 02:15:50
Her slot üç kez. Gerçek bir gece raporunda bu, üç e-posta, üç dosya ya da veritabanında üç satır demek. Sorun kodda değil, varsayımda: BackgroundService process başınadır, uygulama başına değil. Kubernetes'te HPA (Horizontal Pod Autoscaler) replica sayısını otomatik artırdığında bu sayı gün içinde de değişir.
DistributedLock: Tek API, Üç Backend
Çözüm, replica'ların ortak gördüğü bir yerde "bu işi şu an ben yapıyorum" kaydı tutmak. Bunu her veritabanı için elle yazmak yerine madelson'un DistributedLock kütüphanesini kullandım; aynı IDistributedLockProvider interface'inin arkasında üç farklı mekanizma var:
string provider = builder.Configuration["LockProvider"] ?? "postgres";
builder.Services.AddSingleton<IDistributedLockProvider>(_ => provider switch
{
    "postgres" => new PostgresDistributedSynchronizationProvider(builder.Configuration.GetConnectionString("Postgres")!),
    "sqlserver" => new SqlDistributedSynchronizationProvider(builder.Configuration.GetConnectionString("SqlServer")!),
    "redis" => new RedisDistributedSynchronizationProvider(
        ConnectionMultiplexer.Connect(builder.Configuration.GetConnectionString("Redis")!).GetDatabase()),
    _ => throw new InvalidOperationException($"Unknown lock provider {provider}")
});
SQL Server sağlayıcısı, kütüphanenin dokümantasyonuna göre SQL Server'ın application lock'larını (sp_getapplock) kullanıyor. PostgreSQL sağlayıcısı advisory lock kullanıyor; lock'u tutarken pg_locks'a baktım:
select locktype, classid, objid, granted, pid from pg_locks where locktype='advisory';

 locktype |  classid  |   objid    | granted | pid
----------+-----------+------------+---------+-----
 advisory | 209205062 | 1137612306 | t       | 153
Redis sağlayıcısı ise Redis'in dokümante ettiği RedLock algoritmasını uyguluyor: bir anahtarı süreli olarak yazıyor ve arka planda süresini uzatıyor. Lock tutulurken anahtarın kendisi:
$ redis-cli --scan
bookstore:scheduler-leader
$ redis-cli pttl bookstore:scheduler-leader
22037
$ redis-cli get bookstore:scheduler-leader
Mac_26269_6c6b21936f6a4008b024b6140463cd07
Bir uyarı: bu paketler transitive olarak kendi sürücü sürümlerini getiriyor. Benim projemde Npgsql 8.0.6, Microsoft.Data.SqlClient 6.1.4 ve StackExchange.Redis 2.7.33 geldi; SqlClient'ın getirdiği System.Security.Cryptography.Pkcs yine NU1903 uyarısı verdi ve beşinci yazıdaki gibi açık bir referansla güncelledim. Uygulamanın geri kalanı daha yeni bir sürücü kullanıyorsa NuGet en yüksek sürümü seçer; sürümleri dotnet list package --include-transitive ile kontrol et.
Lock ile Tek Çalışma
public sealed class LockedNightlyReportService(
    IDistributedLockProvider locks,
    IConfiguration config,
    ILogger<LockedNightlyReportService> logger) : BackgroundService
{
    protected override async Task ExecuteAsync(CancellationToken stoppingToken)
    {
        while (!stoppingToken.IsCancellationRequested)
        {
            DateTime slot = await Schedule.WaitForNextAsync(stoppingToken);

            // timeout 0: lock'u başkası tutuyorsa beklemeden vazgeç
            await using IDistributedSynchronizationHandle? handle =
                await locks.TryAcquireLockAsync("bookstore:nightly-sales-report", TimeSpan.Zero, stoppingToken);
            if (handle is null)
            {
                logger.LogInformation("[{Replica}] lock held elsewhere, skipping {Slot:HH:mm:ss}", config["Replica"], slot);
                continue;
            }

            // lock kaybedilirse (bağlantı koptu, lease doldu) iş de iptal olsun
            using var linked = CancellationTokenSource.CreateLinkedTokenSource(stoppingToken, handle.HandleLostToken);
            logger.LogInformation("[{Replica}] generating sales report for {Slot:HH:mm:ss}", config["Replica"], slot);
            await Task.Delay(2000, linked.Token);
        }
    }
}TryAcquireLockAsync'e TimeSpan.Zero vermek "bekleme, lock başkasındaysa vazgeç" demek. Üç backend'le de aynı sonucu aldım:
# LockProvider=postgres
05:15:55.119 info: Bookstore.Reports.LockedNightlyReportService[0] [api-2] generating sales report for 02:15:55
05:15:55.119 info: Bookstore.Reports.LockedNightlyReportService[0] [api-3] lock held elsewhere, skipping 02:15:55
05:15:55.120 info: Bookstore.Reports.LockedNightlyReportService[0] [api-1] lock held elsewhere, skipping 02:15:55
# LockProvider=sqlserver
05:16:15.003 info: Bookstore.Reports.LockedNightlyReportService[0] [api-1] lock held elsewhere, skipping 02:16:15
05:16:15.003 info: Bookstore.Reports.LockedNightlyReportService[0] [api-2] generating sales report for 02:16:15
05:16:15.005 info: Bookstore.Reports.LockedNightlyReportService[0] [api-3] lock held elsewhere, skipping 02:16:15
# LockProvider=redis
05:16:20.015 info: Bookstore.Reports.LockedNightlyReportService[0] [api-1] generating sales report for 02:16:20
05:16:20.015 info: Bookstore.Reports.LockedNightlyReportService[0] [api-2] lock held elsewhere, skipping 02:16:20
05:16:20.019 info: Bookstore.Reports.LockedNightlyReportService[0] [api-3] lock held elsewhere, skipping 02:16:20
Her slotta tek rapor. Ama burada dikkatli olmak gerek: lock "aynı anda tek" garantisi veriyor, "slot başına tek" değil. Rapor 2 saniye sürdüğü için diğer replica'lar lock'u hep dolu buldu. Rapor 50 ms sürseydi ve replica'ların saatleri arasında 100 ms fark olsaydı, geç uyanan replica lock'u boş bulup aynı slot için raporu ikinci kez üretebilirdi. Slot başına tek çalışmayı lock'un içinde bir kayıtla sağla: önceki yazıdaki "önce sahiplen" yaklaşımıyla sales-report:2026-11-08 gibi bir anahtarı unique bir tabloya yaz; lock eşzamanlılığı, kayıt tekrarı engeller.
Leader Election: Lock'u Process Boyunca Tutmak
Her iş için ayrı lock almak yerine, bir replica'yı lider seçip zamanlı işlerin hepsini ona yaptırmak da mümkün. Lider, lock'u process yaşadığı sürece tutar; diğerleri AcquireLockAsync'te bekler:
public sealed class LeaderElectedScheduler(
    IDistributedLockProvider locks,
    IConfiguration config,
    ILogger<LeaderElectedScheduler> logger) : BackgroundService
{
    protected override async Task ExecuteAsync(CancellationToken stoppingToken)
    {
        while (!stoppingToken.IsCancellationRequested)
        {
            // lider olana kadar bekle; lock process yaşadığı sürece tutulur
            await using IDistributedSynchronizationHandle handle =
                await locks.AcquireLockAsync("bookstore:scheduler-leader", cancellationToken: stoppingToken);
            logger.LogInformation("[{Replica}] became leader", config["Replica"]);

            using var leadership = CancellationTokenSource.CreateLinkedTokenSource(stoppingToken, handle.HandleLostToken);
            try
            {
                while (!leadership.IsCancellationRequested)
                {
                    DateTime slot = await Schedule.WaitForNextAsync(leadership.Token);
                    logger.LogInformation("[{Replica}] generating sales report for {Slot:HH:mm:ss}", config["Replica"], slot);
                }
            }
            catch (OperationCanceledException) when (!stoppingToken.IsCancellationRequested)
            {
                logger.LogWarning("[{Replica}] lost leadership", config["Replica"]);
            }
        }
    }
}
Üç replica'yı başlattıktan sonra PostgreSQL'de bir lock verilmiş, ikisi bekliyor:
 locktype |  classid  |   objid    | granted | pid
----------+-----------+------------+---------+-----
 advisory | 209205062 | 1137612306 | f       | 173
 advisory | 209205062 | 1137612306 | t       | 171
 advisory | 209205062 | 1137612306 | f       | 172
Bu yaklaşımın güzelliği basitliği: zamanlı işler tek bir yerde, tek replica'da çalışır ve her iş için ayrı koordinasyon gerekmez. Bedeli de basit: liderin ölümü fark edilene kadar hiçbir zamanlı iş çalışmaz. Ne kadar sürdüğü bir sonraki bölümün konusu.
Lock'un Sahibi Ölünce: Ne Kadar Beklenir?
Lideri kill -9 ile öldürdüm; graceful shutdown yok, lock serbest bırakılmıyor. Önce Redis:
05:21:16.407 info: Bookstore.Reports.LeaderElectedScheduler[0] [api-2] became leader
05:21:20.004 info: Bookstore.Reports.LeaderElectedScheduler[0] [api-2] generating sales report for 02:21:20
05:21:24 kill -9 api-2
05:21:46.599 info: Bookstore.Reports.LeaderElectedScheduler[0] [api-1] became leader
05:21:50.004 info: Bookstore.Reports.LeaderElectedScheduler[0] [api-1] generating sales report for 02:21:50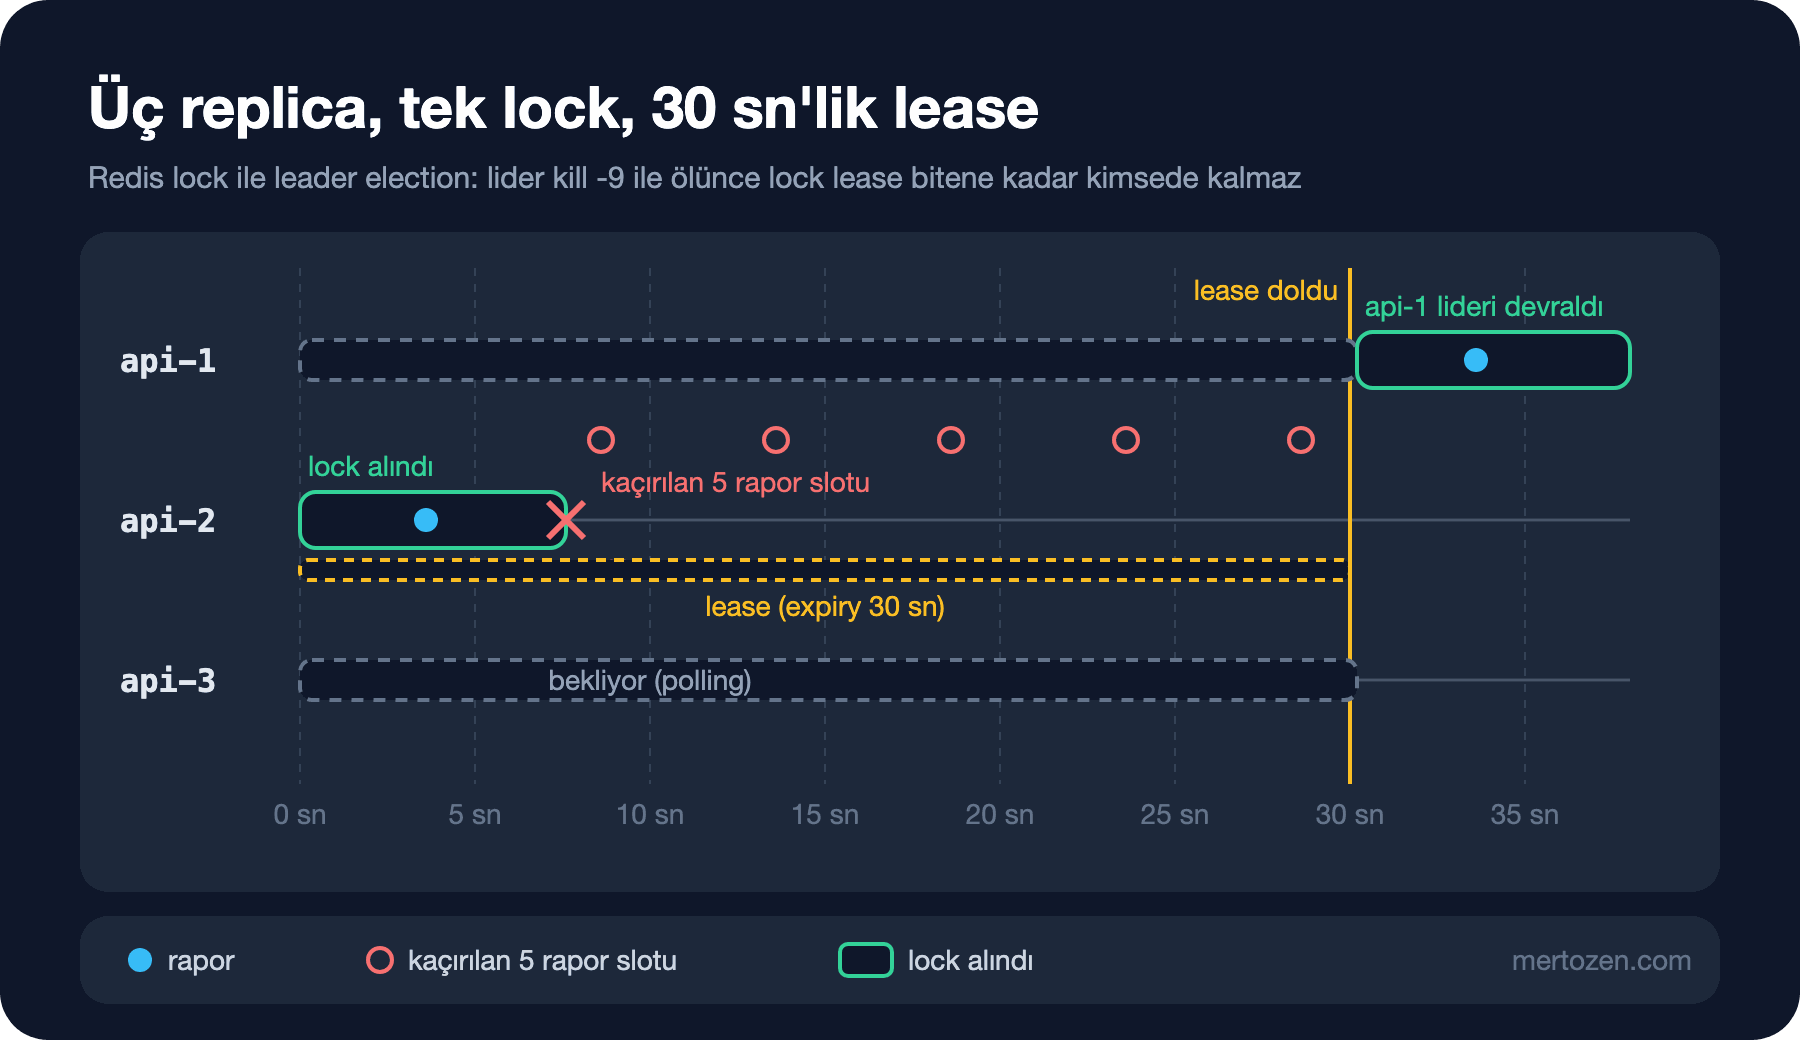
api-2 16.4'te lider oldu, 24'te öldü, api-1 ancak 46.6'da lider olabildi: lock'u aldıktan tam 30 saniye sonra. DistributedLock'un Redis sağlayıcısının kaynak kodundaki varsayılanlar bunu açıklıyor: lock 30 saniyelik bir expiry ile yazılıyor ve lider yaşadığı sürece süresi düzenli aralıklarla (varsayılan olarak 9 saniyede bir) uzatılıyor. Lider ilk uzatmadan önce öldüğü için lock, ilk yazıldığı andan 30 saniye sonra düştü. Arada 5 rapor slotu kaybedildi. Expiry'yi kısaltmak bu boşluğu daraltır ama bir bedeli var: lider bir GC (garbage collection) duraklaması ya da ağ kesintisi yüzünden uzatmayı geciktirirse lock elinden gider.
Sonra PostgreSQL. Beklentim, advisory lock'un oturuma bağlı olduğu için process ölünce hemen serbest kalmasıydı:
05:18:56.084 info: Bookstore.Reports.LeaderElectedScheduler[0] [api-1] became leader
05:19:00.003 info: Bookstore.Reports.LeaderElectedScheduler[0] [api-1] generating sales report for 02:19:00
05:19:03 kill -9 api-1
12 saniye bekledim, kimse lider olamadı. Veritabanında ölü process'in bağlantısı hâlâ aktifti:
select now()::time(0), pid, state, query from pg_stat_activity where datname='bookstore08' and pid<>pg_backend_pid();

02:19:31|171|active|SELECT pg_catalog.pg_sleep($1)
02:19:41|171|active|SELECT pg_catalog.pg_sleep($1)
02:19:51|171|active|SELECT pg_catalog.pg_sleep($1)
Ölü liderin bağlantısı pg_sleep çalıştırıyor. Kütüphanenin kaynak kodunda sebebi açık: HandleLostToken'a erişildiğinde bağlantıyı izlemek için 1 dakikalık bir pg_sleep sorgusu çalıştırıyor. PostgreSQL bir sorgu çalışırken istemcinin hâlâ orada olup olmadığına varsayılan olarak bakmıyor; process ölse de backend sorgu bitene kadar yaşıyor ve advisory lock'u tutuyor. Bağlantının izlendiği durumda lock'un sahibi öldükten sonra yaklaşık bir dakika daha tutulmuş oldu: 02:19:51 ile 02:20:01 arasında bir yerde serbest kaldı.
PostgreSQL 14 ile gelen client_connection_check_interval ayarı tam bu durum için var: sorgu sürerken istemci bağlantısını belirli aralıklarla kontrol ediyor ve varsayılanı 0, yani kapalı. Kendi container'ımda 2 saniyeye ayarlayıp denemeyi tekrarladım:
ALTER SYSTEM SET client_connection_check_interval = '2s';
SELECT pg_reload_conf();

05:20:45.765 info: Bookstore.Reports.LeaderElectedScheduler[0] [api-2] became leader
05:20:50.005 info: Bookstore.Reports.LeaderElectedScheduler[0] [api-2] generating sales report for 02:20:50
05:20:53 kill -9 api-2
05:20:53.750 info: Bookstore.Reports.LeaderElectedScheduler[0] [api-3] became leader
05:20:55.003 info: Bookstore.Reports.LeaderElectedScheduler[0] [api-3] generating sales report for 02:20:55
Liderin öldüğü saniyede (20:53) api-3 lider oldu. Bu sonuç bir kütüphanenin değil, bir ayarın sonucu; aynı kod, aynı sürücü. Ders genel: distributed lock'un "sahip ölünce serbest kalır" vaadi, altyapının sahibin öldüğünü ne kadar hızlı fark ettiğine bağlı ve bu süreyi ölçmeden bilemezsin. SQL Server'ın sp_getapplock'u da oturuma bağlı; sunucunun bağlantı kopmasını fark etme süresi orada da TCP (Transmission Control Protocol) katmanına bağlı. Bu yazı için SQL Server'da kill -9 senaryosunu ölçmedim.
Lease, Yenileme ve Fencing Token
Redis örneğinde lock aslında bir lease: süreli bir sahiplik. Lease'in tehlikesi ters yönde de var. Lider yaşıyor ama 40 saniyelik bir GC duraklamasına giriyor ya da ağdan kopuyor; lease bitiyor, başka bir replica lider oluyor. Eski lider uyandığında hâlâ lider olduğunu sanıyorsa iki lider aynı anda iş yapar.
Kütüphanenin HandleLostToken'ı bunun ilk savunması: lock kaybedildiği anlaşıldığında iptal ediliyor. Kodda bu token'ı stoppingToken ile birleştirip işe veriyoruz; lock gidince iş de duruyor. Ama "anlaşıldığında" kelimesi önemli: GC duraklamasındaki bir process hiçbir şeyi anlayamaz, uyanıp bir sonraki satırı çalıştırana kadar.
Kesin çözüm, korunan kaynağın kendisinin eski lideri reddetmesi: her lock alımında artan bir sayı (fencing token) üretilir ve iş yazdığı her yere bu sayıyı ekler; kaynak, gördüğü en büyük sayıdan küçük bir token taşıyan yazmayı reddeder. Bu, kilit kütüphanesinin tek başına sağlayabileceği bir şey değil; yazılan kaynağın token'ı kontrol etmesi gerekiyor. Distributed Systems Temelleri serisinin "Distributed Lock, Lease ve Fencing Token: Kilit Neden Yetmez?" yazısı bunun teorisini anlatıyor. Pratikte çoğu background job için daha ucuz bir yol yeterli: yedinci yazıdaki idempotency, iki liderin aynı işi yapmasını zararsız kılar.
Hangfire ve Quartz'ın Kendi Çözümleri
Hangfire ya da Quartz kullanıyorsan bu sorunun bir kısmı zaten çözülmüş. Quartz'ın clustering'ini altıncı yazıda gördük: trigger'ı veritabanı lock'uyla tek bir node alıyor. Hangfire'da recurring job, storage'da tek bir kayıt; üç ayrı Hangfire server'ı aynı veritabanına bağlayıp dakikada bir çalışan bir recurring job tanımladım:
app.Services.GetRequiredService<IRecurringJobManager>()
    .AddOrUpdate<MinuteReportJob>("minute-report", j => j.RunAsync(), Cron.Minutely());

// üç process, aynı SQL Server storage, 150 saniye
05:59:13.902 info: Bookstore.Jobs.MinuteReportJob[0] Minute report generated by pid 38931
06:00:13.999 info: Bookstore.Jobs.MinuteReportJob[0] Minute report generated by pid 38930
Üç server'a rağmen her dakika için tek job; iki dakikayı iki farklı process çalıştırdı. Aynı method'un iki çalışmasının aynı anda koşmasını engellemek için Hangfire'ın bir de DisableConcurrentExecution filtresi var; arama indeksini yeniden kuran job'u iki kez kuyruğa yazdım:
public sealed class SearchIndexJobs(ILogger<SearchIndexJobs> logger)
{
    // aynı method'un iki çalışması aynı anda koşmasın; lock'u en fazla 10 sn bekle
    [DisableConcurrentExecution(timeoutInSeconds: 10)]
    public async Task RebuildAsync(string reason)
    {
        logger.LogInformation("Rebuilding book search index ({Reason})", reason);
        await Task.Delay(3000);
        logger.LogInformation("Search index rebuilt ({Reason})", reason);
    }
}

jobs.Enqueue<SearchIndexJobs>(j => j.RebuildAsync("price import"));
jobs.Enqueue<SearchIndexJobs>(j => j.RebuildAsync("new books"));
05:22:22.304 info: Bookstore.Jobs.SearchIndexJobs[0] Rebuilding book search index (price import)
05:22:25.306 info: Bookstore.Jobs.SearchIndexJobs[0] Search index rebuilt (price import)
05:22:25.316 info: Bookstore.Jobs.SearchIndexJobs[0] Rebuilding book search index (new books)
05:22:28.317 info: Bookstore.Jobs.SearchIndexJobs[0] Search index rebuilt (new books)5 worker'lı server iki job'u aynı anda alabilirdi, ama ikincisi birincinin bitmesini bekledi. Filtre storage üzerinde bir distributed lock alıyor; timeoutInSeconds içinde alamazsa job hata verip retry'a giriyor. Dikkat: bu "aynı anda tek" demek, "bir kez" değil; ikinci job yine de çalıştı.
Üretimde Dikkat
Lider kaybı süresini ölç. Kendi altyapında liderin process'ini öldürüp yeni liderin ne kadar sürede seçildiğini ölçmeden, "lider ölünce iş devam eder" varsayımına güvenme. Yukarıdaki iki denemede bu süre 1 saniye ile 60 saniye arasında değişti.
Lock'u veritabanı bağlantı havuzunun bir parçası olarak düşün. PostgreSQL ve SQL Server lock'ları, lock tutulduğu sürece bir bağlantıyı meşgul ediyor. Leader election'da bu bir bağlantı demek; her job için ayrı lock alan yoğun bir sistemde havuzu tüketebilir.
Lock'a isim verirken kapsamı düşün. bookstore:nightly-sales-report bütün ortamlar için aynıysa ve staging ile production aynı Redis'i paylaşıyorsa, staging'deki pod production'ın raporunu engeller. Ortam adını anahtara ekle.
Sık Düşülen Tuzaklar
Lock'u using/await using olmadan almak. Exception fırlatan bir iş lock'u serbest bırakmaz; Redis'te lease bitene kadar, veritabanında bağlantı kapanana kadar herkes bekler.
Lock timeout'unu iş süresinden kısa tutmak. Redis expiry'si işten kısaysa ve yenileme bir sebeple aksarsa, iş sürerken lock başkasına geçer. DistributedLock yenilemeyi otomatik yapıyor; kendi lock'unu yazıyorsan yenilemeyi unutma.
Lock'u "bir kez çalışır" garantisi sanmak. Lock eşzamanlılığı engeller; aynı slot için ardışık iki çalışmayı engellemez. Slot başına tekliği idempotency kaydıyla sağla.
HandleLostToken'ı yok saymak. Lock kaybedildiğinde işi durdurmayan bir kod, iki liderin aynı anda çalıştığı pencereyi uzatır.
Lock'un sahibinin ölümünün anında fark edileceğini varsaymak. PostgreSQL denemesinde ölü bir process lock'u yaklaşık bir dakika tuttu.
Küçük Bir Deneme
★☆☆ LockedNightlyReportService'teki Task.Delay(2000)'i 20 ms'ye indir ve replica'lardan birinin saatine yapay bir gecikme ekle (WaitForNextAsync'ten sonra 100 ms bekle). Aynı slot için kaç rapor üretiliyor?
★★☆ Redis sağlayıcısını 5 saniyelik expiry ile kur (RedisDistributedSynchronizationProvider'ın options parametresi) ve leader election denemesini tekrarla. Kaç slot kaybediliyor? Lideri öldürmek yerine 8 saniyeliğine durdur (kill -STOP, sonra kill -CONT); iki lider aynı anda rapor üretiyor mu?
★★★ Rapor tablosuna bir fencing token kolonu ekle: lider olan replica, PostgreSQL'de bir sequence'tan token alsın ve her rapor yazımında WHERE token >= (SELECT MAX(token) ...) kontrolü yapsın. kill -STOP senaryosunda eski liderin yazması reddediliyor mu?
Bir sonraki yazıda uzun süren işlere geçiyoruz: 2 milyon satırlık bir fiyat güncellemesini tek transaction yerine chunk'lara bölmek, kaldığı yeri saklayan bir checkpoint tablosu, deploy sırasında kesilip kaldığı yerden devam etmek ve Hangfire'ın uzun job'ları nasıl "görünmez" tuttuğu.