

Replication: Leader-Based, Multi-Leader, Leaderless ve Quorum
Replication üç topolojide yapılır: tek leader (basit, failover'da split brain riski), multi-leader (her bölgede yazma, conflict kaçınılmaz) ve leaderless quorum (R + W > N ise okuma son yazmayı görür). N=3 quorum simülasyonunda R=W=1 eski stok değerini döndürüyor, iki node düşünce sistem yazmayı reddediyor, ama "başarısız" yazma bir replica'da kalıp node'lar dönünce okunuyor.
Sürüm notu: Bu yazıdaki kodlar C# 14 ve .NET 10 ile derlenip denenmiştir.
Önce Tahmin Et
Bookstore'un stok bilgisi üç replica'da (A, B, C) tutuluyor. Bir yazma en az iki replica onaylayınca başarılı sayılıyor (W=2), bir okuma da iki replica'ya soruyor ve en yeni versiyonu alıyor (R=2). A düşmüş durumda. Bir kitabın stoğu 12 olarak yazılıyor ve başarılı oluyor. Sonra B de düşüyor. Stoğu 11'e indiren yazma yalnız C'ye ulaşıyor; bir onay, iki gerekiyor, sistem client'a "başarısız" diyor.
Client bir hata aldı ve 11'in yazılmadığını düşünüyor. Birkaç dakika sonra A ve B geri geliyor ve biri stoğu okuyor. 12 mi görür, 11 mi?
Neden Replike Ederiz, Sync mi Async mi?
Replication, aynı verinin birden fazla makinede kopyasını tutmaktır. Sebepleri ilk yazıdaki dağıtma sebepleriyle örtüşür: bir makine çöktüğünde veriyi kaybetmemek ve hizmete devam etmek, okuma yükünü birden fazla makineye dağıtmak, veriyi kullanıcıya yakın tutmak. Veri hiç değişmeseydi replication kolay olurdu; bütün zorluk değişiklikleri kopyalara taşımakta.
İlk karar, yazmanın ne zaman "tamam" sayılacağı. Synchronous replication'da leader, yazmayı replica'lar da aldığını onaylayana kadar client'a cevap vermez: replica'da veri kaybolmaz ama en yavaş replica bütün yazmaları yavaşlatır, biri düşerse yazmalar durur. Asynchronous replication'da leader yazmayı kendine yazar ve hemen cevap verir: hızlıdır, replica'nın düşmesi yazmaları etkilemez, ama leader o sırada çökerse henüz kopyalanmamış yazmalar kaybolur. Pratikteki ara çözüm semi-synchronous: replica'lardan biri synchronous, diğerleri asynchronous. SQL (Structured Query Language) Server'ın Always On availability group'larındaki synchronous-commit ve asynchronous-commit modları, PostgreSQL'deki synchronous_standby_names ayarı ve MySQL'in semi-synchronous replication eklentisi aynı kararın farklı interface'leri.
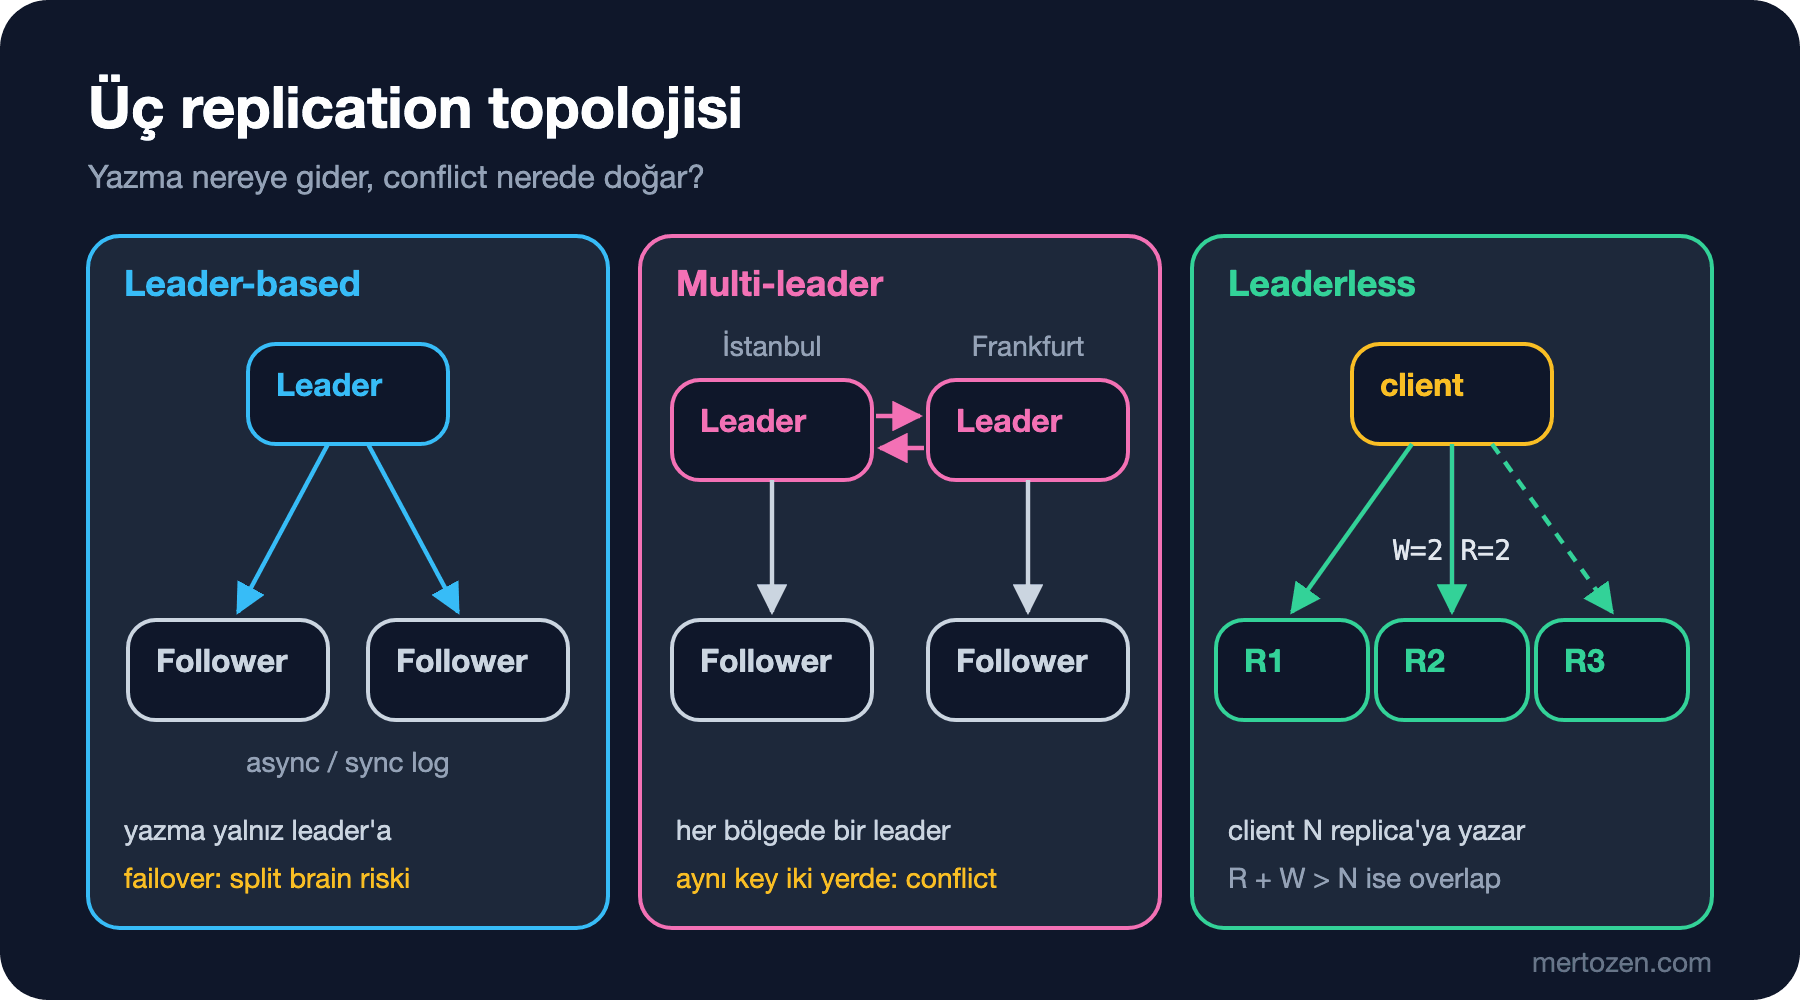
İkinci karar, kimin yazma kabul ettiği. Buna göre üç topoloji var:
Leader-Based Replication ve Failover
En yaygın model: bütün yazmalar tek bir leader'a gider, leader değişiklikleri bir replication log'u ile follower'lara gönderir, follower'lar okumaya hizmet edebilir. Yazmalar tek bir yerde sıralandığı için conflict yoktur; sorun leader'ın çöktüğü anda başlar.
Failover üç adımdır: leader'ın çöktüğüne karar vermek, yeni bir leader seçmek ve client'ları ona route etmek. Her adım bir önceki yazıların bir sorununu taşır. Karar bir timeout'a dayanır ve ikinci yazıda gördüğümüz gibi yanlış alarm verebilir. Asynchronous replication kullanıyorsan yeni leader eski leader'ın son yazmalarını almamış olabilir ve o yazmalar kaybolur. Eski leader ölmemiş, yalnız yavaşlamışsa ve geri dönüp kendini hâlâ leader sanırsa, iki leader iki farklı yazma kabul eder: split brain.
Kleppmann DDIA (Designing Data-Intensive Applications) kitabında bu riskin gerçek bir örneğini anlatır: GitHub'da 2012'de güncel olmayan bir MySQL follower'ı leader'a yükseltildi. Eski leader'ın verdiği auto-increment id'ler yeni leader'da yeniden kullanıldı ve aynı id'ler Redis'te de tutulduğu için, bazı kullanıcılara başka kullanıcıların özel verileri gösterildi. Kaybolan birkaç yazma kendi başına küçük bir sorundu; o veriye dışarıdan referans veren başka bir sistem olunca güvenlik olayına dönüştü. Bu yüzden iyi bir failover mekanizması eski leader'ı "çit dışına" çıkarır (fencing): yeni leader seçilince eskisinin yazmaları reddedilir. Onuncu yazıda fencing token'ı ayrıntılı göreceğiz; sekizinci yazıda Raft'ın leader seçimini split brain'siz nasıl yaptığını.
Multi-Leader: Her Bölgede Yazma, Kaçınılmaz Conflict
Bookstore'un İstanbul ve Frankfurt'ta iki data center'ı olsun. Tek leader Frankfurt'taysa İstanbul'daki her yazma bölgeler arası gecikmeyi öder ve iki bölge arasındaki bağlantı koparsa İstanbul yazamaz. Multi-leader replication her bölgeye kendi leader'ını verir; leader'lar yazmaları birbirine asynchronous gönderir. Aynı fikri telefonundaki offline çalışabilen bir uygulama da kullanır: cihaz da bir leader'dır.
Bedeli conflict'tir. İstanbul'daki editör bir kitabın fiyatını 450, Frankfurt'taki editör aynı anda 399 yaptığında iki leader da yazmayı kabul etti; hangisinin kazanacağına replication sırasında karar verilmesi gerekir. Seçenekler bildik: last-write-wins (LWW) saat kaymasıyla veri kaybettirir (üçüncü yazı), version vector conflict'i görünür kılıp uygulamaya bırakır (dördüncü yazı), CRDT (Conflict-free Replicated Data Type) veri tipini conflict üretmeyecek şekilde tasarlar (on birinci yazı). En güvenli seçenek ise conflict'i önlemek: aynı kaydın yazmalarını hep aynı leader'a route etmek, örneğin bir müşterinin sepetini müşterinin bölgesine bağlamak.
Leaderless Replication ve Quorum
Amazon'un Dynamo makalesiyle (2007) yaygınlaşan, Cassandra ve Riak'ın kullandığı modelde leader yoktur. Client (ya da onun adına çalışan bir coordinator) yazmayı N replica'nın hepsine gönderir ve W tanesinin onayını bekler. Okurken R replica'ya sorar ve aralarındaki en yeni versiyonu alır. R + W > N ise yazmayı onaylayan replica'lar ile okumanın sorduğu replica'lar en az bir node'da kesişir, dolayısıyla okuma en az bir güncel kopya görür. N=3 için tipik seçim W=2, R=2: bir node düşse de hem yazma hem okuma çalışır.
Bunu küçük bir simülasyonla görelim. Her replica her key için bir değer ve bir versiyon tutuyor; bir replica'ya bir sonraki yazmayı kaçırması söylenebiliyor. Simülasyonda versiyonu tek bir sayaç üretiyor; gerçek sistemlerde bu bir timestamp ya da version vector'dür:
namespace Bookstore.Replication;

public record Stored(string Value, long Version);

public sealed class Replica(string name)
{
    private readonly Dictionary<string, Stored> _data = [];

    public string Name { get; } = name;
    public bool IsUp { get; set; } = true;
    public bool DropsNextWrite { get; set; } // kaybolan ya da geciken bir replication message'ını simüle eder

    public bool TryWrite(string key, Stored value)
    {
        if (!IsUp) return false;
        if (DropsNextWrite)
        {
            DropsNextWrite = false;
            return false;
        }
        if (!_data.TryGetValue(key, out Stored? current) || value.Version > current.Version)
        {
            _data[key] = value;
        }
        return true;
    }

    public Stored? Read(string key) => IsUp ? _data.GetValueOrDefault(key) : null;
}

public sealed class QuorumStore(IReadOnlyList<Replica> replicas, int w, int r)
{
    private long _version;

    public bool Write(string key, string value)
    {
        Stored stored = new(value, ++_version);
        int acks = replicas.Count(replica => replica.TryWrite(key, stored));
        Console.WriteLine($"  write {key}={value} v{stored.Version}: acks={acks}/{replicas.Count} need W={w} -> {(acks >= w ? "OK" : "FAILED")}");
        return acks >= w;
    }

    // Coordinator yalnız R replica'ya sorar; hangileri olduğunu çağıran seçer (ör. en hızlı cevap verenler)
    public string? Read(string key, params string[] askFirst)
    {
        int Rank(Replica x) => Array.IndexOf(askFirst, x.Name) is >= 0 and var i ? i : int.MaxValue;
        List<Replica> asked = [.. replicas.Where(x => x.IsUp).OrderBy(Rank).Take(r)];
        if (asked.Count < r)
        {
            Console.WriteLine($"  read {key}: only {asked.Count} replicas up, need R={r} -> UNAVAILABLE");
            return null;
        }
        List<(Replica Replica, Stored? Value)> answers = [.. asked.Select(x => (x, x.Read(key)))];
        Stored? newest = answers.Select(a => a.Value).Where(v => v is not null).MaxBy(v => v!.Version);
        foreach ((Replica replica, Stored? value) in answers.Where(a => newest is not null && (a.Value is null || a.Value.Version < newest.Version)))
        {
            replica.TryWrite(key, newest!); // read repair: eski replica'yı düzelt
            Console.WriteLine($"  read repair: {replica.Name} v{value?.Version ?? 0} -> v{newest!.Version}");
        }
        string seen = string.Join(", ", answers.Select(a => $"{a.Replica.Name}:v{a.Value?.Version ?? 0}"));
        Console.WriteLine($"  read {key} from [{seen}] -> {newest?.Value ?? "(none)"}");
        return newest?.Value;
    }
}
Üç senaryo: quorum kesişiyor, quorum kesişmiyor, node'lar düşüyor:
using Bookstore.Replication;

static Replica[] Cluster() => [new("A"), new("B"), new("C")];

Console.WriteLine("N=3, W=2, R=2 (R + W > N)");
Replica[] nodes = Cluster();
QuorumStore store = new(nodes, w: 2, r: 2);
store.Write("stock:978-0134494166", "12");
nodes[2].DropsNextWrite = true;                 // C bir sonraki güncellemeyi kaçırır
store.Write("stock:978-0134494166", "11");
store.Read("stock:978-0134494166", "C", "B");   // C önce cevap verir, ama B yazma quorum'uyla kesişir

Console.WriteLine("N=3, W=1, R=1 (R + W <= N)");
nodes = Cluster();
store = new(nodes, w: 1, r: 1);
store.Write("stock:978-0134494166", "12");
nodes[1].DropsNextWrite = true;
nodes[2].DropsNextWrite = true;                 // güncellemeyi yalnız A alır
store.Write("stock:978-0134494166", "11");
store.Read("stock:978-0134494166", "C");

Console.WriteLine("N=3, W=2, R=2, one node down, then two");
nodes = Cluster();
store = new(nodes, w: 2, r: 2);
nodes[0].IsUp = false;
store.Write("stock:978-0134494166", "12");
store.Read("stock:978-0134494166", "B", "C");
nodes[1].IsUp = false;
store.Write("stock:978-0134494166", "11");
store.Read("stock:978-0134494166", "C");
nodes[0].IsUp = true;
nodes[1].IsUp = true;                            // "başarısız" yazma hâlâ C'de duruyor
store.Read("stock:978-0134494166", "C", "A");
N=3, W=2, R=2 (R + W > N)
write stock:978-0134494166=12 v1: acks=3/3 need W=2 -> OK
write stock:978-0134494166=11 v2: acks=2/3 need W=2 -> OK
read repair: C v1 -> v2
read stock:978-0134494166 from [C:v1, B:v2] -> 11
N=3, W=1, R=1 (R + W <= N)
write stock:978-0134494166=12 v1: acks=3/3 need W=1 -> OK
write stock:978-0134494166=11 v2: acks=1/3 need W=1 -> OK
read stock:978-0134494166 from [C:v1] -> 12
N=3, W=2, R=2, one node down, then two
write stock:978-0134494166=12 v1: acks=2/3 need W=2 -> OK
read stock:978-0134494166 from [B:v1, C:v1] -> 12
write stock:978-0134494166=11 v2: acks=1/3 need W=2 -> FAILED
read stock:978-0134494166: only 1 replicas up, need R=2 -> UNAVAILABLE
read repair: A v0 -> v2
read stock:978-0134494166 from [C:v2, A:v0] -> 11İlk senaryoda C güncellemeyi kaçırdı ve okumada ilk cevap veren o oldu, ama okuma B'ye de sorduğu için en yeni versiyonu buldu ve C'yi yerinde düzeltti. Buna read repair denir; Dynamo tarzı sistemler buna ek olarak arka planda replica'ları karşılaştıran bir anti-entropy süreci çalıştırır. İkinci senaryoda R + W = 2 ≤ 3: yazma tek replica'ya gitti, okuma başka bir replica'ya sordu ve 11 yerine 12 döndü. Hızlı ama eski bir cevap; bazı iş yükleri için kabul edilebilir, stok için değil.
Quorum'un Sınırları: Başarısız Yazma Kaybolmaz
Üçüncü senaryo açılıştaki soru. A düşükken W=2 hâlâ sağlanıyor. B de düşünce yazma tek onay aldı ve client'a FAILED döndü; okuma da yetersiz replica yüzünden reddedildi. Sistem tutarlı kalmak için availability'den vazgeçti. Ama son satıra bak: A ve B dönünce okuma, "başarısız" yazmanın değeri olan 11'i döndürdü ve read repair onu A'ya da yaydı. Yazma, ulaştığı tek replica'da kaldı ve geri alınmadı. Client hata aldığı bir değişikliğin sonradan gerçekleştiğini görüyor.
Bu, simülasyonun bir hatası değil; quorum'un ne garanti ettiğinin doğrudan sonucu. "W onay alamadım" demek "yazma hiçbir yerde yok" demek değildir, ilk yazıdaki timeout gibi "bilmiyorum" demektir. Leaderless sistemlerde quorum'un sınırları burada bitmez: concurrent iki yazmanın hangisinin kazanacağı yine versiyonlamaya (çoğu zaman LWW'ye) kalır; bazı sistemler yeterli replica'ya ulaşamayınca yazmayı geçici olarak başka bir node'a yazar ve sonra asıl sahibine devreder (Dynamo'nun sloppy quorum ve hinted handoff'u), bu da R + W > N kesişimini geçici olarak bozar; okuma bir yazmayla yarışırsa yazmanın bir kısmını görebilir. Bu yüzden R + W > N, bir sonraki yazıda tanımlayacağımız linearizability'yi tek başına sağlamaz.
Replication Lag ve Kullanıcının Gördüğü Anomaliler
Asynchronous replication'da follower'lar leader'ın birkaç milisaniye, yük altında birkaç saniye ya da dakika gerisinde kalabilir. Bu gecikme, kullanıcının gözünde üç tipik anomaliye dönüşür.
Read-your-writes ihlali: kullanıcı yorumunu gönderiyor, sayfa yenileniyor, okuma henüz güncellenmemiş bir follower'a gidiyor ve yorum yok. Çözüm, kullanıcının kendi yazdığı veriyi bir süre leader'dan okumak ya da yazmadan dönen versiyonu (PostgreSQL'de bir LSN (Log Sequence Number)) client'a verip okumada "en az bu versiyonu görmüş bir replica" şartı koymak.
Monotonic reads ihlali: kullanıcı sayfayı iki kez yeniliyor, ilk okuma güncel bir follower'a, ikincisi geride kalan bir follower'a gidiyor; yorum önce görünüyor, sonra kayboluyor. Çözüm, bir kullanıcının okumalarını hep aynı replica'ya route etmek (örneğin kullanıcı id'sinin hash'i ile).
Consistent prefix ihlali: sıralı iki yazma (soru ve cevabı) farklı partition'lara düşüp farklı gecikmelerle kopyalanınca, okuyan biri cevabı sorudan önce görür. Çözüm, causal olarak bağlı yazmaları aynı partition'a koymak ya da causal sıralamayı açıkça taşımak.
Bu garantilerin adı session guarantee'dir; Terry ve arkadaşları 1994'te Bayou sistemi için tanımladı. Bir sonraki yazıda onları consistency model haritasına yerleştireceğiz.
Broadcast Türleri ve Replication
Replication'ı başka bir açıdan da görebilirsin: her yazma bir message, her replica bir alıcı. Soru, message'ların hangi sırayla teslim edildiği. FIFO (First In, First Out) broadcast aynı göndericinin mesajlarını gönderildiği sırada teslim eder. Causal broadcast, happens-before ilişkisine uyar: bir message'ı görüp ona cevap olarak gönderilen message, her yerde ondan sonra teslim edilir (consistent prefix sorununun çözümü). Total order broadcast ise bütün node'lara bütün message'ları aynı sırada teslim eder.
Total order broadcast replication'ın en güçlü aracıdır: her replica aynı başlangıç durumundan, aynı yazmaları aynı sırayla uygularsa hepsi aynı duruma ulaşır (state machine replication). Leader-based replication bunu tek bir leader'ın sıralamasıyla yapar; leader çöktüğünde sıralamayı fault-tolerant biçimde sürdürmek ise consensus problemine denktir. Sekizinci yazıda Raft'ı tam olarak bu gözle okuyacağız.
Sık Düşülen Tuzaklar
Follower'dan okuyup "kendi yazdığımı göreceğim" sanmak. Okuma yükünü replica'lara dağıtan bir DbContext konfigürasyonu ya da read-only connection string, kullanıcının az önce yaptığı değişikliği göstermeyebilir. Hangi sorgunun replica'ya gidebileceğine bilinçli karar ver.
Quorum hatasını "yazma olmadı" diye yorumlamak. Yukarıda gördüğün gibi başarısız yazma kısmen uygulanmış olabilir. Retry edeceksen yazma idempotent olmalı.
Otomatik failover'ı fencing'siz kurmak. Eski leader'ı durduramayan ya da yazmalarını reddedemeyen bir failover, split brain'i yalnız zamanlamaya bırakır.
Multi-leader'ı "daha hızlı yazma" için seçip conflict çözümünü sonraya bırakmak. Conflict çözümü veri modelinin bir parçasıdır; sonradan eklenemez.
Replication lag'ı izlememek. Follower'ın leader'dan ne kadar geride olduğu (saniye ya da log pozisyonu olarak) bir metrik olmalı; lag'ın sessizce saatlere çıkması, failover anında kaybedilecek verinin miktarıdır.
Küçük Bir Deneme
★☆☆ İlk senaryoda okumanın sorduğu replica'ları "C", "B" yerine yalnız "C" yap ve r: 1 ile çalıştır. Okuma ne döndürüyor? Read repair çalışıyor mu?
★★☆ QuorumStore.Write'a, yeterli onay alamayınca onay veren replica'lardaki değişikliği geri alan bir "rollback" ekle. Bu yaklaşım neden gerçek bir sistemde güvenilir değil? Rollback mesajı da kaybolursa ne olur?
★★★ Simülasyona iki client'ın aynı key'e aynı anda farklı değer yazdığı bir senaryo ekle: biri A ve B'ye, diğeri B ve C'ye ulaşsın, ikisi de aynı versiyon numarasını alsın. Okuma hangi değeri döndürüyor? Versiyonu bir version vector ile değiştirip conflict'i sibling olarak saklayacak şekilde kodu düzenle.
Bu yazıda replica'ların "en yeni değer" konusunda anlaşamadığı durumları gördük. Bir sonraki yazıda "doğru davranış"ın ne olduğunu kesin bir dille tanımlıyoruz: linearizability, sequential, causal ve eventual consistency, session guarantee'leri ve bir okuma/yazma geçmişinin hangi modelde geçerli olduğunu kontrol eden küçük bir C# checker'ı.