

Consensus ve Raft: Leader Election, Log Replication ve FLP Sonucu
Consensus, node'ların bir değer (ya da bir log sırası) üzerinde anlaşmasıdır; FLP sonucu asynchronous network'te tek bir çökmeye bile dayanıp her zaman sonlanan deterministik bir algoritma olmadığını söyler, Raft ise safety'yi term ve çoğunluk oylarıyla, liveness'ı rastgele timeout'larla sağlar. C# simülasyonunda leader çökünce 254 ms içinde yeni leader seçiliyor; sabit timeout'larda ise 2 saniyede term 13'e çıkıp hiç leader seçilemiyor.
Sürüm notu: Bu yazıdaki kodlar C# 14 ve .NET 10 ile derlenip denenmiştir.
Önce Tahmin Et
Beş node'luk bir cluster leader seçecek. Kural basit: bir node 150 milisaniye boyunca leader'dan haber almazsa kendini aday ilan eder, kendine oy verir ve diğerlerinden oy ister. Her node bir term'de yalnız bir kez oy verir. Beş oydan üçünü alan leader olur.
Ekip "deterministik olsun, test etmesi kolay olur" diye bütün node'ların timeout'unu tam 150 milisaniyeye sabitliyor ve network gecikmesi de her mesaj için aynı. Cluster açıldığında kim leader olur? Ne kadar sürede?
Consensus Problemi
Önceki yazılarda birkaç kez aynı soruya çarptık: leader çöktüğünde yenisini kim seçecek ve iki node aynı anda kendini leader sanmasın diye ne yapacağız (beşinci yazı)? Partition sırasında hangi taraf çoğunluk (yedinci yazı)? Bu soruların ortak adı consensus: birkaç node'un, bazıları çökebilirken, tek bir değer üzerinde anlaşması.
Problemin klasik tanımı üç property ister. Agreement: hiçbir iki node farklı değere karar vermez. Validity: karar verilen değer, bir node'un önerdiği değerlerden biridir. Termination: çökmeyen her node sonunda bir karara varır. İlk ikisi safety, sonuncusu liveness özelliğidir.
Consensus'un pratikteki karşılığı tek bir değerden fazlası: bir log. Beşinci yazıda gördüğümüz total order broadcast, bütün node'lara bütün mesajları aynı sırada teslim eder; bunu fault-tolerant yapmak, log'un her pozisyonu için consensus yapmaya denktir. Bu sırayla her node aynı komutları aynı sırada uygularsa aynı duruma varır (state machine replication). Kilit servisleri, leader seçimi, cluster konfigürasyonu ve tutarlı replication bu tek mekanizmanın üzerine kurulur.
FLP: Asynchronous Network'te İmkânsızlık
Fischer, Lynch ve Paterson 1985'te yayımladıkları "Impossibility of Distributed Consensus with One Faulty Process" makalesinde, dağıtık sistemlerin en ünlü sonucunu ispatladı. Asynchronous bir system model'de (ikinci yazıdaki gibi mesaj gecikmesinin ve process hızının üst sınırı yok), tek bir process'in çökebildiği durumda bile, her zaman sonlanan deterministik bir consensus algoritması yoktur. Sezgisi ikinci yazıdaki failure detector sorunuyla aynı: yavaş bir node ile çökmüş bir node ayırt edilemiyorsa, algoritma ya o node'u beklemeye devam eder (ve sonsuza kadar bekleyebilir) ya da beklemeden karar verir (ve node yaşıyorsa farklı bir karara varmış olabilir).
FLP (Fischer, Lynch, Paterson) sonucu consensus'un imkânsız olduğunu söylemez; asynchronous modelde safety ve liveness'ın birlikte garanti edilemeyeceğini söyler. Pratikteki algoritmalar bunu üç yolla aşar. Safety'yi her koşulda korurlar, liveness'ı ise network'ün partially synchronous olduğu dönemlere bırakırlar. Timeout'ları failure detector olarak kullanırlar, ama yanlış alarm safety'yi bozmaz, yalnız ilerlemeyi yavaşlatır. Ve rastgelelik kullanırlar, ki açılıştaki sorunun cevabı tam olarak bununla ilgili.
Paxos'a Kısa Bakış
Leslie Lamport'un Paxos'u, crash-recovery modelinde consensus'un ilk pratik çözümü kabul edilir; makale 1989'da yazıldı ama "The Part-Time Parliament" adıyla ancak 1998'de yayımlandı, ardından Lamport 2001'de "Paxos Made Simple" ile sade bir anlatım yazdı. Paxos tek bir değer için anlaşmayı iki fazda yapar: bir proposer önce çoğunluktan bir ballot numarası için söz alır (prepare/promise), sonra o numarayla bir değer önerir (accept). Bir log için her pozisyonda Paxos çalıştırmak (Multi-Paxos) ve bunu sabit bir leader ile optimize etmek gerekir; makalenin bu kısmı ayrıntı bırakmadığı için gerçek implementasyonlar birbirinden epey farklılaştı. Google'ın Chubby kilit servisi Paxos kullanır.
Diego Ongaro ve John Ousterhout 2014'te USENIX'in (Advanced Computing Systems Association) ATC (Annual Technical Conference) konferansında yayımlanan "In Search of an Understandable Consensus Algorithm" makalesinde Raft'ı tam olarak bu yüzden önerdi: aynı garantileri veren, ama problemi leader election, log replication ve safety diye ayrı parçalara bölen, anlaşılır olmayı tasarım hedefi yapan bir algoritma. Makalede bunu bir kullanıcı çalışmasıyla da ölçtüler.
Raft: Term ve Leader Election
Raft'ta her node üç rolden birindedir: follower, candidate ya da leader. Zaman term'lere bölünür; her term bir seçimle başlar ve en fazla bir leader'ı olur. Term numarası mantıksal bir saat gibi çalışır: bir node kendinden yüksek term gördüğü anda term'ini günceller ve follower'a döner; düşük term'li mesajları reddeder.
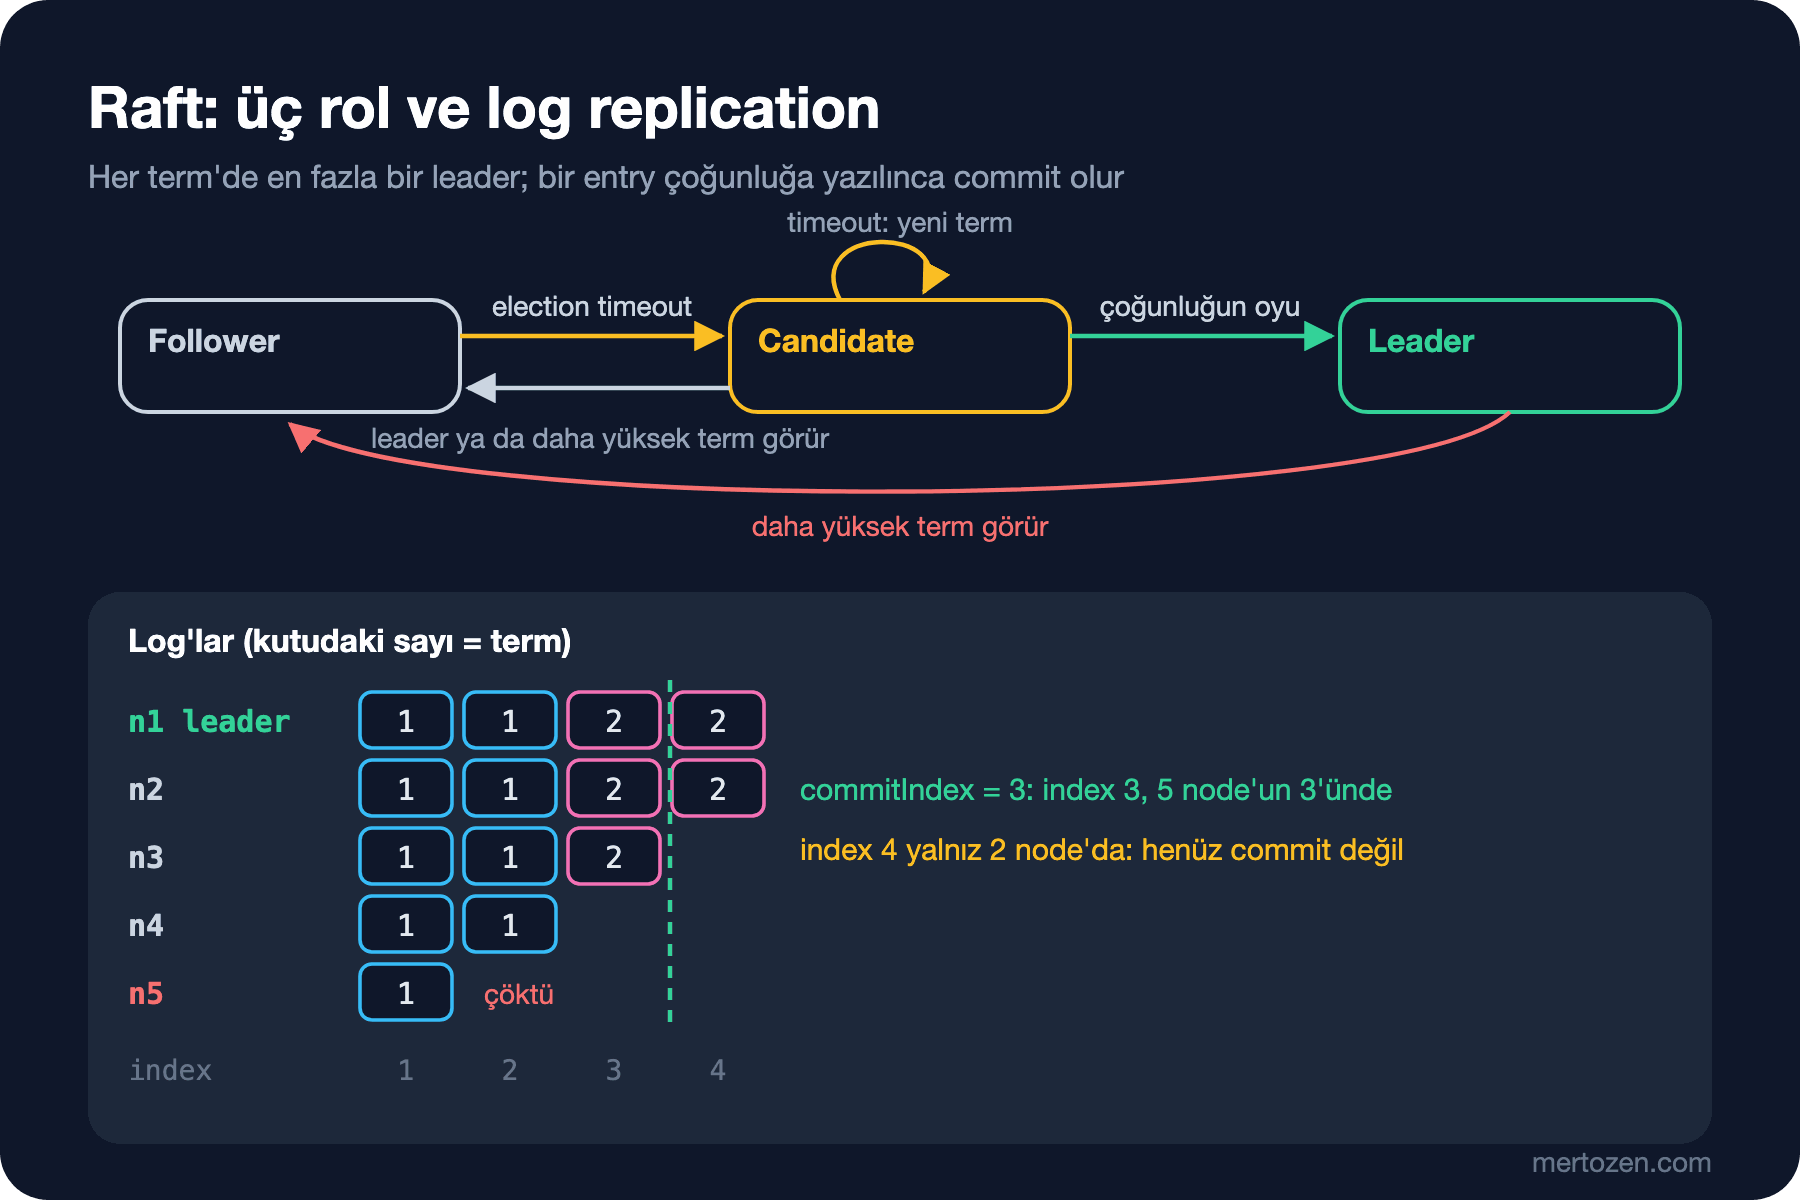
Follower, leader'dan belirli bir süre heartbeat almazsa (election timeout) term'ini artırır, candidate olur, kendine oy verir ve diğer node'lara RequestVote gönderir. Her node bir term'de yalnız bir oy verir ve bu oyu (ve current term'i) cevap vermeden önce diske yazar; ikinci yazıda gördüğümüz gibi, yeniden başlayan bir node aynı term'de ikinci kez oy verirse iki leader seçilebilir. Çoğunluğun oyunu alan candidate leader olur ve hemen heartbeat göndermeye başlar. Bir de seçim kısıtı var: node, log'u kendisininkinden daha geride olan bir candidate'e oy vermez. Bu kural, commit edilmiş her entry'nin yeni leader'ın log'unda bulunmasını garanti eder.
Açılıştaki soruyu bir discrete-event simülasyonuyla cevaplayalım. Gerçek zaman yerine bir event queue'su kullanıyoruz; her event simüle edilmiş bir milisaniyede çalışıyor, böylece sonuç her koşuda aynı. Log ve disk yok, yalnız seçim var:
namespace Bookstore.Raft;

public enum Role { Follower, Candidate, Leader }

public abstract record Msg(int From, int Term);
public sealed record RequestVote(int From, int Term) : Msg(From, Term);
public sealed record Vote(int From, int Term, bool Granted) : Msg(From, Term);
public sealed record Heartbeat(int From, int Term) : Msg(From, Term);

public sealed class RaftNode(int id)
{
    public int Id { get; } = id;
    public Role Role { get; set; } = Role.Follower;
    public int Term { get; set; }
    public int? VotedFor { get; set; }
    public int Votes { get; set; }
    public bool Crashed { get; set; }
    public long TimerVersion { get; set; } // eski election timer'larını geçersiz kılar
}

// Raft leader election'ının discrete-event simülasyonu (log yok, disk yok)
public sealed class Simulation(int nodes, Func<Random, int> electionTimeout, int seed)
{
    private const int HeartbeatMs = 50, DelayMs = 5;
    private readonly PriorityQueue<Action, (int Time, long Seq)> _events = new();
    private readonly Random _random = new(seed);
    private long _seq;
    private int _now;

    public List<RaftNode> Nodes { get; } = [.. Enumerable.Range(1, nodes).Select(i => new RaftNode(i))];
    public bool Verbose { get; init; } = true;

    private void At(int time, Action action) => _events.Enqueue(action, (time, _seq++));
    private void Log(string text) { if (Verbose) Console.WriteLine($"{_now,5} ms  {text}"); }

    private void ResetTimer(RaftNode node)
    {
        long version = ++node.TimerVersion;
        At(_now + electionTimeout(_random), () =>
        {
            if (!node.Crashed && node.Role != Role.Leader && node.TimerVersion == version) StartElection(node);
        });
    }

    private void Send(RaftNode from, Msg msg, RaftNode to) =>
        At(_now + DelayMs, () => { if (!to.Crashed && !from.Crashed) Receive(to, msg); });

    private void Broadcast(RaftNode from, Msg msg) =>
        Nodes.Where(n => n != from).ToList().ForEach(n => Send(from, msg, n));

    private void StartElection(RaftNode node)
    {
        node.Role = Role.Candidate;
        node.Term++;
        node.VotedFor = node.Id;
        node.Votes = 1;
        Log($"n{node.Id} times out, becomes candidate for term {node.Term}");
        ResetTimer(node);
        Broadcast(node, new RequestVote(node.Id, node.Term));
    }

    private void Receive(RaftNode node, Msg msg)
    {
        if (msg.Term > node.Term) // daha yeni term her zaman kazanır
        {
            node.Term = msg.Term;
            node.Role = Role.Follower;
            node.VotedFor = null;
        }
        RaftNode sender = Nodes[msg.From - 1];
        switch (msg)
        {
            case RequestVote rv:
                bool grant = rv.Term == node.Term && (node.VotedFor is null || node.VotedFor == rv.From);
                if (grant)
                {
                    node.VotedFor = rv.From;
                    ResetTimer(node);
                }
                Send(node, new Vote(node.Id, node.Term, grant), sender);
                break;
            case Vote { Granted: true } v when node.Role == Role.Candidate && v.Term == node.Term:
                if (++node.Votes == Nodes.Count / 2 + 1) BecomeLeader(node);
                break;
            case Heartbeat hb when hb.Term >= node.Term:
                node.Role = Role.Follower;
                ResetTimer(node);
                break;
        }
    }

    private void BecomeLeader(RaftNode node)
    {
        node.Role = Role.Leader;
        Log($"n{node.Id} wins term {node.Term} with {node.Votes}/{Nodes.Count} votes");
        void Beat()
        {
            if (node.Crashed || node.Role != Role.Leader) return;
            Broadcast(node, new Heartbeat(node.Id, node.Term));
            At(_now + HeartbeatMs, Beat);
        }
        Beat();
    }

    public void CrashLeaderAt(int time) => At(time, () =>
    {
        RaftNode? leader = Nodes.FirstOrDefault(n => n.Role == Role.Leader && !n.Crashed);
        if (leader is null) return;
        leader.Crashed = true;
        Log($"n{leader.Id} (leader of term {leader.Term}) crashes");
    });

    public RaftNode? Run(int until)
    {
        Nodes.ForEach(ResetTimer);
        while (_events.TryDequeue(out Action? action, out (int Time, long Seq) key) && key.Time <= until)
        {
            _now = key.Time;
            action();
        }
        return Nodes.SingleOrDefault(n => n is { Role: Role.Leader, Crashed: false });
    }
}
İki senaryo: makalede örnek verilen 150 ile 300 milisaniye arası rastgele timeout'lar ve 1000. milisaniyede leader'ın çökmesi; sonra bütün node'lar için sabit 150 milisaniye:
using Bookstore.Raft;

Console.WriteLine("--- randomized timeouts 150-300 ms, leader crashes at 1000 ms ---");
Simulation raft = new(5, r => r.Next(150, 301), seed: 3);
raft.CrashLeaderAt(1000);
RaftNode? leader = raft.Run(until: 2000);
Console.WriteLine($"leader at 2000 ms: n{leader?.Id}, term {leader?.Term}");

Console.WriteLine("--- fixed timeout 150 ms for every node ---");
Simulation fixedTimeouts = new(5, _ => 150, seed: 3) { Verbose = false };
RaftNode? none = fixedTimeouts.Run(until: 2000);
Console.WriteLine($"leader at 2000 ms: {(none is null ? "none" : $"n{none.Id}")}, " +
                  $"terms reached: {string.Join(",", fixedTimeouts.Nodes.Select(n => n.Term))}");
--- randomized timeouts 150-300 ms, leader crashes at 1000 ms ---
179 ms n4 times out, becomes candidate for term 1
189 ms n4 wins term 1 with 3/5 votes
1000 ms n4 (leader of term 1) crashes
1244 ms n1 times out, becomes candidate for term 2
1244 ms n2 times out, becomes candidate for term 2
1254 ms n1 wins term 2 with 3/5 votes
leader at 2000 ms: n1, term 2
--- fixed timeout 150 ms for every node ---
leader at 2000 ms: none, terms reached: 13,13,13,13,13Rastgele timeout'larla ilk seçim 189. milisaniyede bitti. Leader çöktükten sonra n1 ve n2 aynı milisaniyede aday oldu; n1 üç oyu önce topladı ve kazandı, n2 aynı term'in leader'ından heartbeat alınca follower'a döndü. Yeni leader çöküşten 254 milisaniye sonra hazırdı. Sabit timeout'ta ise beş node da her seferinde aynı anda aday oluyor, herkes kendine oy veriyor, kimse çoğunluk alamıyor ve 2 saniyede term 13'e çıkmasına rağmen hiç leader seçilmiyor. Safety bozulmadı (iki leader yok), ama liveness yok. Açılıştaki "deterministik olsun" isteği, FLP'nin tarif ettiği sonsuz döngüyü elle kurmak demek. Raft'ın rastgele timeout'ları, aynı anda aday olma ihtimalini düşük tutarak bu döngüyü kırar.
Log Replication ve Commit Index
Leader client'lardan gelen komutları log'una ekler ve AppendEntries mesajıyla follower'lara gönderir. Her AppendEntries, yeni entry'lerden hemen önceki entry'nin index'ini ve term'ini de taşır. Follower kendi log'unda o pozisyonda aynı term'li bir entry yoksa mesajı reddeder; leader bir adım geri gidip tekrar dener. Bu tutarlılık kontrolü Log Matching özelliğini sağlar: iki log'da aynı index ve aynı term'e sahip entry varsa, o noktaya kadar iki log birebir aynıdır.
Bir entry, leader onu node'ların çoğunluğuna yazdırdığında commit edilir. Yukarıdaki figürde index 3, beş node'un üçünde var; leader commit index'ini 3'e ilerletir, entry'yi kendi state machine'ine uygular ve client'a cevap verir. Index 4 yalnız iki node'da; leader çökerse kaybolabilir, ve client'a henüz "tamam" denmediği için bu bir sorun değil. Burada ince bir kural var: leader yalnız kendi term'indeki entry'leri replica sayarak commit eder; önceki term'lerden kalan entry'ler, kendi term'inden bir entry commit olunca dolaylı olarak commit edilmiş sayılır. Makalenin Figure 8'i bu kural olmasaydı çoğunluğa yazılmış bir entry'nin bile nasıl ezilebileceğini adım adım gösterir.
Okumaların da bir tuzağı var. Leader kendi state'inden okuyup cevap verirse, haberi olmadan yeni bir leader seçilmiş olabilir ve eski bir değer döndürür. Raft makalesi bu yüzden linearizable okumalar için leader'ın, cevap vermeden önce çoğunlukla bir heartbeat turu yaparak hâlâ leader olduğunu doğrulamasını ister. Etcd'nin ReadIndex mekanizması bunu yapar; bazı sistemler bunun yerine saat sınırlarına güvenen lease tabanlı okumalar kullanır, ki bu da onuncu yazının konusu olan riskleri taşır.
Consensus'u Nerede Kullanırız, Neden Kendimiz Yazmayız?
Kubernetes'in bütün cluster durumu etcd'de, etcd ise Raft ile replike ediliyor. HashiCorp Consul Raft kullanıyor. Apache ZooKeeper Raft'a benzeyen Zab protokolünü kullanıyor. Kafka, ZooKeeper bağımlılığını KIP (Kafka Improvement Proposal) 500 ile Raft tabanlı KRaft'a taşıdı ve 4.0 sürümüyle ZooKeeper desteğini tamamen kaldırdı. CockroachDB ve TiKV gibi dağıtık veritabanları her veri aralığı için ayrı bir Raft grubu çalıştırıyor.
Bir .NET geliştiricisi olarak sen bu algoritmayı neredeyse hiç yazmazsın, kullanırsın. Leader election gerekiyorsa Kubernetes'in Lease object'i ya da etcd'nin election API'si (Application Programming Interface) var; tutarlı bir sayaç ya da kilit gerekiyorsa çoğu zaman zaten Raft ya da Paxos üzerinde çalışan bir veritabanının transaction'ı yeterli. Yukarıdaki simülasyon, Raft'ın neden böyle tasarlandığını anlamak içindir; production'da kullanılacak bir implementasyon değildir. Gerçek bir Raft implementasyonu snapshot'lar, log compaction, membership değişiklikleri, disk hataları ve yıllarca süren Jepsen tarzı testler gerektirir. raft.github.io'daki RaftScope görselleştirmesinde bir node'u durdurup başka bir term'de geri getirerek bu yazıdaki senaryoları tarayıcında oynatabilirsin.
Sık Düşülen Tuzaklar
Çift sayıda node çalıştırmak. Dört node'luk bir cluster'da çoğunluk üçtür ve yalnız bir node kaybına dayanır; üç node'luk cluster da bir node kaybına dayanır. Dördüncü node yalnız maliyet ekler. 2f + 1 node, f çökmeye dayanır.
Election timeout'u network gecikmesine göre seçmemek. Raft makalesi timeout'un, broadcast süresinden bir mertebe büyük, ortalama arıza aralığından birkaç mertebe küçük olmasını önerir. Bölgeler arası bir cluster'da 150 milisaniyelik timeout sürekli seçim demektir.
Leader'dan okumayı otomatik olarak linearizable sanmak. Yukarıda gördüğün gibi, leader'ın hâlâ leader olduğunu doğrulamadan verdiği cevap eski olabilir.
Consensus'u her şeye koymak. Her yazma için çoğunluk onayı, yedinci yazıdaki PACELC'in (if Partition: Availability or Consistency, Else: Latency or Consistency) E kolundaki latency bedelini öder. Consensus'u gerçekten tek bir sıraya ihtiyaç duyan şeyler (konfigürasyon, kilitler, leader, sıra numaraları) için kullan.
Kendi consensus algoritmanı yazmak. Bu, kendi şifreleme algoritmanı yazmaya benzer: çalışıyor gibi görünür, ama hatalar yalnız nadir failure kombinasyonlarında ortaya çıkar.
Küçük Bir Deneme
★☆☆ Simülasyonda node sayısını 5'ten 3'e ve 7'ye değiştir. Leader çöktükten sonra yeni leader'ın seçilmesi ne kadar sürüyor? Seed'i değiştirerek birkaç koşu dene.
★★☆ Timeout aralığını 150–300 yerine 150–160 milisaniye yap. Split vote (kimsenin çoğunluk alamadığı seçim) sayısı nasıl değişiyor? StartElection'a bir sayaç ekleyerek ölç.
★★★ Simülasyona bir partition ekle: leader ve bir follower bir tarafta, diğer üç node öbür tarafta kalsın. Eski leader ne yapıyor, diğer taraf ne yapıyor? Partition bitince eski leader'ın term'i ve rolü ne oluyor? Eski leader partition sırasında client'tan yazma kabul etseydi o yazmaya ne olurdu?
Consensus, bir grup node'un tek bir sıra üzerinde anlaşmasını sağlıyor. Peki birden fazla bağımsız sistemin (iki ayrı veritabanının, ya da bir veritabanı ile bir message broker'ın) aynı transaction'ı birlikte commit etmesi? Bir sonraki yazının konusu bu: atomic commit, two-phase commit (2PC), coordinator çökünce neden her şeyin kilitli kaldığı ve microservice'lerde neden kullanılmadığı.