

Distributed System Nedir ve Neden Zordur? Partial Failure ve Fallacies of Distributed Computing
Distributed system, ortak bir işi network üzerinden mesajlaşarak yapan birden fazla bilgisayardır ve zorluğu partial failure'dan gelir: bir parça bozulurken diğerleri çalışır, timeout ise isteğin işlenip işlenmediğini söylemez. Örnekte 1 saniyelik timeout ve körlemesine retry aynı siparişi iki kez tahsil ediyor; idempotency key ile tahsilat bire iniyor. Sekiz fallacy'nin .NET'teki karşılıkları da yazıda.
Sürüm notu: Bu yazıdaki kodlar C# 14 ve .NET 10 ile derlenip denenmiştir.
Önce Tahmin Et
Bookstore'un OrderService'i ödeme almak için dış bir ödeme sağlayıcısına HTTP (Hypertext Transfer Protocol) isteği atıyor. Ekipteki biri, kullanıcı checkout ekranında takılı kalmasın diye HttpClient.Timeout'u 1 saniyeye çekmiş ve timeout olursa isteği bir kez daha deneyen basit bir döngü yazmış. Sağlayıcı o gün yavaş: kartı çekiyor, sonra cevabı 2 saniyede dönüyor.
for (int attempt = 1; attempt <= 2; attempt++)
{
    try
    {
        HttpResponseMessage response = await client.PostAsJsonAsync("/charges", order);
        Console.WriteLine($"attempt {attempt}: {(int)response.StatusCode}");
        break;
    }
    catch (TaskCanceledException ex) when (ex.InnerException is TimeoutException)
    {
        Console.WriteLine($"attempt {attempt}: timeout ({ex.GetType().Name} -> {ex.InnerException.GetType().Name})");
    }
}
Kullanıcı ekranda ne görür? Daha önemlisi: müşterinin kartından kaç kez 349,90 TL çekilir? Cevabı düşün, sonra aşağıdaki gerçek koşuya bak.
Distributed System Nedir, Neden Dağıtırız?
Martin Kleppmann'ın Cambridge'deki ders notlarındaki tanım yeterince sade: distributed system, network üzerinden mesajlaşarak ortak bir işi yapmaya çalışan birden fazla bilgisayardır (node). Leslie Lamport'un 1987'de bir e-postasında yaptığı ve sonra çok alıntılanan tanım ise işin acı tarafını anlatır: varlığından haberin bile olmayan bir bilgisayarın çökmesi, senin bilgisayarını kullanılamaz hale getirebiliyorsa, distributed bir sistemdesin.
Bu tanıma göre sen zaten distributed bir sistem yazıyorsun. Bir ASP.NET Core API'si (Application Programming Interface), veritabanı sunucusu, Redis cache'i ve bir ödeme sağlayıcısı: dört ayrı process, aralarında network. Microservice olması gerekmiyor; tek bir monolith'in veritabanına bağlanması bile bu sınıfa girer. Dağıtmanın sebepleri de tanıdık:
- Scale: tek makinenin CPU (Central Processing Unit), bellek ya da disk sınırını aşan iş yükü.
- Fault tolerance: bir makine çöktüğünde diğerinin işi devralması; replication'ın ana gerekçesi.
- Latency: kullanıcıya coğrafi olarak yakın bir kopyadan cevap vermek (İstanbul'daki kullanıcıya Frankfurt'taki sunucu).
- Doğası gereği dağıtık iş: ödeme sağlayıcısı, kargo firması, e-posta servisi başkasının bilgisayarında çalışıyor.
Bedeli de bu serinin konusu. Tek bir process içinde bir method çağrısı ya başarılı olur ya exception fırlatır; arada üçüncü bir ihtimal yoktur. Network'e çıktığın anda üçüncü ihtimal gelir: hiçbir şey olmaz. Cevap gelmez ve sen neyin olmadığını bilemezsin.
Partial Failure: Sistem Ne Tam Çalışıyor Ne Tam Çöküyor
Tek bir bilgisayar genelde ya çalışır ya çalışmaz. Donanım arızası olunca işletim sistemi kernel panic verir, process ölür; yarım yamalak bir durum yerine bütünüyle duran bir sistem tercih edilir. Distributed sistemde bu lüks yok: bir node çalışırken diğeri çökebilir, network'ün bir kısmı paket düşürürken diğer kısmı sağlam kalabilir, bir sunucu çalışıyor ama saniyeler süren bir garbage collector (GC) duraklamasında olabilir. Buna partial failure denir ve dağıtık sistemleri zorlaştıran şey tam olarak budur.
Partial failure'ın asıl acıtan yanı nondeterminism: aynı isteği iki kez atınca biri başarılı olur, biri timeout olur. Daha kötüsü, timeout olan istek için şu dört durumu birbirinden ayırt edemezsin:
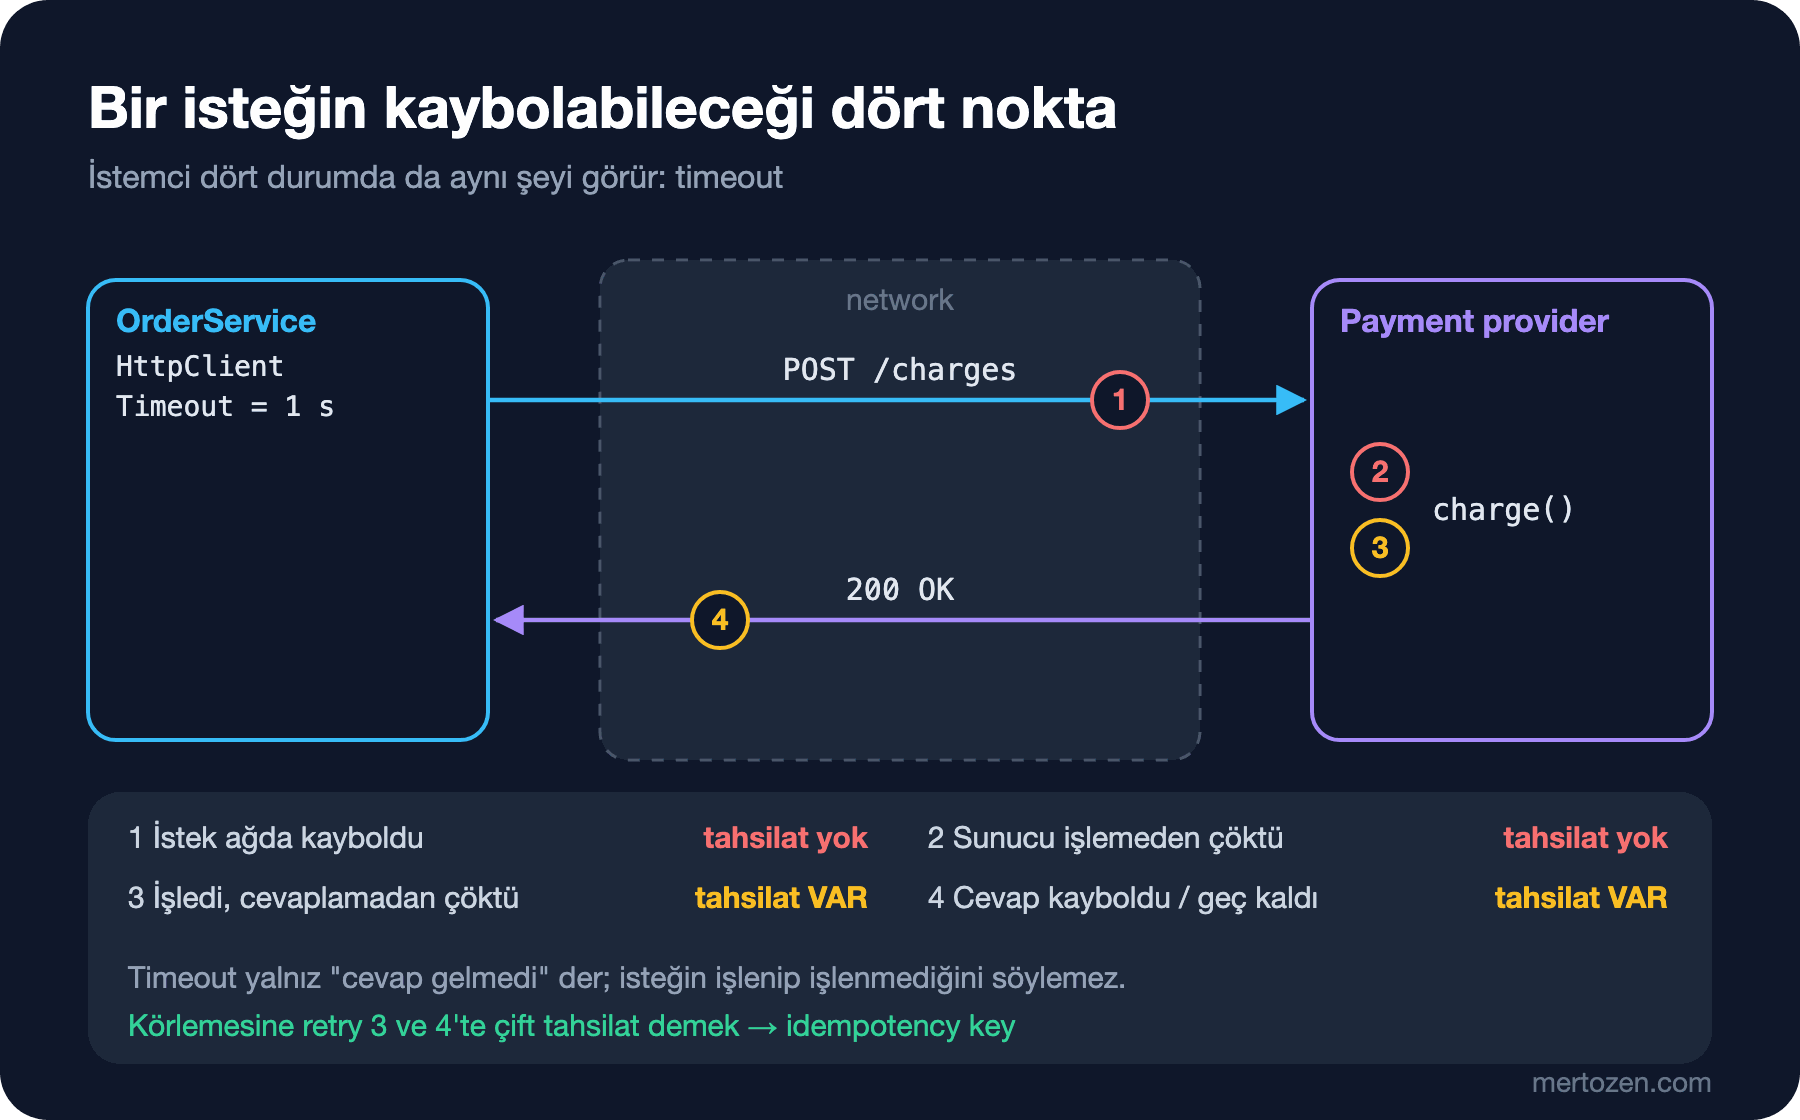
İstek network'te kaybolmuş olabilir (1), sunucu isteği işlemeden çökmüş olabilir (2), isteği işleyip cevap vermeden çökmüş olabilir (3), ya da cevap yolda kaybolmuş veya senin beklediğinden geç gelmiş olabilir (4). İlk ikisinde para çekilmedi, son ikisinde çekildi. İstemcinin elinde dördü için de aynı bilgi var: TaskCanceledException.
Timeout Bir Cevap Değildir
Açılıştaki senaryoyu tek bir console uygulamasında kuralım. Aynı process içinde minimal API ile sahte bir ödeme sağlayıcısı başlatıyoruz; kartı çekip ledger'a yazıyor, sonra 2 saniye bekleyip cevap dönüyor. İstemci tarafında 1 saniyelik timeout ve iki deneme:
using System.Collections.Concurrent;
using System.Net.Http.Json;

namespace Bookstore.Payments;

public record ChargeRequest(string OrderId, decimal Amount);
public record ChargeResult(string ChargeId, string OrderId, decimal Amount);

public static class Program
{
    public static async Task Main()
    {
        ConcurrentBag<ChargeResult> ledger = [];
        ConcurrentDictionary<string, ChargeResult> processed = new();

        WebApplicationBuilder builder = WebApplication.CreateSlimBuilder();
        builder.Logging.ClearProviders();
        builder.WebHost.UseUrls("http://127.0.0.1:5077");
        WebApplication app = builder.Build();

        // Ödeme sağlayıcı: kartı çeker, sonra yavaş cevap verir (2 sn)
        app.MapPost("/charges", async (ChargeRequest request) =>
        {
            ChargeResult result = new($"ch_{ledger.Count + 1}", request.OrderId, request.Amount);
            ledger.Add(result);
            await Task.Delay(TimeSpan.FromSeconds(2));
            return Results.Ok(result);
        });

        // Aynı sağlayıcı, ama Idempotency-Key'i hatırlıyor
        app.MapPost("/v2/charges", async (HttpRequest http, ChargeRequest request) =>
        {
            string key = http.Headers["Idempotency-Key"].ToString();
            ChargeResult result = processed.GetOrAdd(key, _ =>
            {
                ChargeResult created = new($"ch_{ledger.Count + 1}", request.OrderId, request.Amount);
                ledger.Add(created);
                return created;
            });
            await Task.Delay(TimeSpan.FromSeconds(2));
            return Results.Ok(result);
        });

        await app.StartAsync();

        Uri provider = new("http://127.0.0.1:5077");
        using HttpClient client = new() { BaseAddress = provider, Timeout = TimeSpan.FromSeconds(1) };
        using HttpClient patient = new() { BaseAddress = provider, Timeout = Timeout.InfiniteTimeSpan };
        ChargeRequest order = new("order-1042", 349.90m);
Açılıştaki döngü bu kurulumun hemen altında çalışıyor. Döngüden sonra sağlayıcının yarım kalan işlerini bitirmesi için biraz bekleyip ledger'ı sayıyoruz:
await Task.Delay(TimeSpan.FromSeconds(2.5));
Console.WriteLine($"charges for order-1042: {ledger.Count(c => c.OrderId == order.OrderId)}");
Gerçek çıktı:
--- naive retry ---
attempt 1: timeout (TaskCanceledException -> TimeoutException)
attempt 2: timeout (TaskCanceledException -> TimeoutException)
charges for order-1042: 2
İki deneme de timeout oldu ve müşteri iki kez ödedi. Kullanıcı ekranda hata görür, büyük ihtimalle bir kez daha "Öde"ye basar ve sayı üçe çıkar. Burada kimse hatalı kod yazmadı: HttpClient doğru davrandı (.NET 5'ten beri Timeout dolunca iç exception'ı TimeoutException olan bir TaskCanceledException fırlatır), sağlayıcı da doğru davrandı. Hata, timeout'u "işlem olmadı" diye yorumlamakta. Timeout'un tek söylediği şey, belirlediğin süre içinde cevap gelmediği.
Peki retry'ı kaldırsak? Bu sefer (1) ve (2) durumlarında müşteri sipariş verdiğini sanıp parasız sipariş bırakır ya da ekranda hata görür ama ödeme aslında alınmıştır. Retry etmemek de, körlemesine retry etmek de yanlış. Doğru soru şu: aynı isteği güvenle tekrar gönderebilmek için ne gerekir?
Idempotency Key: Belirsizliği Retry Edilebilir Hale Getirmek
Bir işlem idempotent ise, onu bir kez de yapsan beş kez de yapsan sonuç aynıdır. "Siparişin durumunu Paid yap" idempotenttir; "karttan 349,90 TL çek" değildir. İdempotent olmayan bir işlemi idempotent yapmanın yaygın yolu, istemcinin her mantıksal işlem için benzersiz bir anahtar üretip her denemede aynı anahtarı göndermesi; sunucunun da bu anahtarla işlenmiş sonucu saklayıp tekrar gelirse aynı sonucu dönmesidir. Stripe gibi ödeme API'leri bunu Idempotency-Key header'ıyla yapar; header'ın standardı IETF'te (Internet Engineering Task Force) taslak (Internet-Draft) aşamasında.
ledger.Clear();
Console.WriteLine("--- retry with idempotency key ---");
string idempotencyKey = Guid.CreateVersion7().ToString();
for (int attempt = 1; attempt <= 3; attempt++)
{
    using HttpRequestMessage message = new(HttpMethod.Post, "/v2/charges") { Content = JsonContent.Create(order) };
    message.Headers.Add("Idempotency-Key", idempotencyKey);
    using CancellationTokenSource cts = new(attempt < 3 ? TimeSpan.FromSeconds(1) : TimeSpan.FromSeconds(5));
    try
    {
        HttpResponseMessage response = await patient.SendAsync(message, cts.Token);
        ChargeResult? charge = await response.Content.ReadFromJsonAsync<ChargeResult>();
        Console.WriteLine($"attempt {attempt}: {(int)response.StatusCode} {charge?.ChargeId}");
        break;
    }
    catch (TaskCanceledException)
    {
        Console.WriteLine($"attempt {attempt}: timeout");
    }
}
Console.WriteLine($"charges for order-1042: {ledger.Count(c => c.OrderId == order.OrderId)}");
Sağlayıcı tarafında /v2/charges endpoint'i anahtarı ConcurrentDictionary'de tutuyor. Çıktı:
--- retry with idempotency key ---
attempt 1: timeout
attempt 2: timeout
attempt 3: 200 ch_1
Üç deneme, tek tahsilat ve üçüncü denemede istemci ilk denemenin ürettiği ch_1'i geri alıyor. Örnekteki ConcurrentDictionary yalnız fikri göstermek için; gerçekte anahtar, sonuçla birlikte aynı veritabanı transaction'ında ve unique constraint ile saklanır, aynı anahtarla farklı bir payload gelirse reddedilir, işlemi hâlâ süren bir anahtar için ikinci istek bekletilir. Bunların ayrıntısı Messaging ve Event-Driven Architecture serisinin "Idempotent Consumer: Aynı Message İki Kez Gelirse Ne Olur?" yazısında. Bu yazıdan çıkarman gereken ders daha temel: belirsizlik ortadan kalkmaz, onu tolere edecek şekilde tasarlarsın.
RPC Local Call Değildir
RPC (Remote Procedure Call) fikri 1980'lerden beri aynı vaadi verir: uzaktaki bir fonksiyonu yereldeki gibi çağır. gRPC, WCF (Windows Communication Foundation), typed HttpClient'lar ve Refit gibi kütüphaneler bu illüzyonu çok iyi kurar; await paymentClient.ChargeAsync(order) satırı await repository.SaveAsync(order) ile aynı görünür. Ama ikisi temelden farklı davranır:
Local call ya döner ya exception fırlatır; remote call bir de "bilinmiyor" sonucu üretir. Local call'ın süresi nanosaniyelerle mikrosaniyeler arasındadır ve öngörülebilirdir; remote call milisaniyelerle dakikalar arasında değişir. Local call'a referans geçirirsin; remote call'a her şey serialize edilerek kopyalanır, DateTime'ın Kind'ı ya da decimal'ın hassasiyeti yolda değişebilir. Local call'ı tekrarlamak güvenlidir ya da değildir ama bunu kod belirler; remote call'ı tekrarlamak network'ün kararıdır, çünkü retry'ı senin kodun değil, bir HTTP handler'ı, load balancer ya da service mesh yapıyor olabilir.
Bu yüzden iyi bir client kütüphanesi remote olduğunu saklamaz: method imzasında CancellationToken ister, exception'ları "geçici" ve "kalıcı" diye ayırır, timeout'u açıkça configure etmeye zorlar. C# Asenkron serisinin "C# CancellationToken: İptal, Timeout ve Linked Token" yazısında timeout'u iptal mekanizmasıyla nasıl taşıdığımızı görmüştük; burada eklenen şey, iptalin uzaktaki işi geri almadığı gerçeği.
Fallacies of Distributed Computing ve .NET'teki Karşılıkları
1990'larda Sun Microsystems'te L Peter Deutsch ve meslektaşları, network'le ilk kez uğraşan programcıların sessizce yaptığı varsayımları bir listede topladı; sekizinci maddeyi James Gosling ekledi. Liste otuz yıldır geçerli, çünkü her maddesi bugün de bir production incident'ına karşılık geliyor:
| Yanlış varsayım | .NET'te nerede patlar |
|---|---|
| Network güvenilirdir | HttpRequestException, SocketException; retry yoksa geçici hata kullanıcıya gider, varsa yukarıdaki çift tahsilat |
| Latency sıfırdır | Döngü içinde servis çağrısı (N+1); HttpClient.Timeout'un varsayılanı 100 saniye |
| Bandwidth sonsuzdur | Sayfalanmamış büyük JSON (JavaScript Object Notation) cevapları, compression açılmamış endpoint'ler |
| Network güvenlidir | Sertifika doğrulamasını kapatan ServerCertificateCustomValidationCallback, iç network'te düz HTTP |
| Topoloji değişmez | Singleton HttpClient'ın DNS (Domain Name System) değişikliğini görmemesi; çözüm SocketsHttpHandler.PooledConnectionLifetime |
| Tek bir yönetici vardır | Başka ekibin firewall, rate limit ya da sertifika değişikliği senin servisini bozar |
| Transport maliyeti sıfırdır | Serialization'ın CPU maliyeti, cloud'da bölgeler arası veri transfer ücreti |
| Network homojendir | Farklı runtime'lar, JSON'da farklı casing ve tarih formatları, HTTP/2 desteklemeyen bir proxy |
Listenin ilk iki maddesi bu yazının konusuydu. Diğerlerine serinin ilerleyen yazılarında tek tek döneceğiz: network'ün mesaj kaybetmesini bir sonraki yazıda system model olarak tanımlayacağız, saatlerin güvenilmezliği üçüncü yazının konusu.
Sık Düşülen Tuzaklar
Timeout'u başarısızlık saymak. Timeout "bilmiyorum" demektir. Bir ödeme, rezervasyon ya da stok düşme işleminde timeout sonrası doğru tepki, sonucu sorgulamak (sağlayıcıda GET /charges?orderId=...) ya da aynı idempotency key ile tekrar denemektir.
Retry'ı katman katman eklemek. Microsoft.Extensions.Http.Resilience ile HttpClient'a retry, üstüne Polly ile servis seviyesinde retry, üstüne API gateway'de retry: tek bir kullanıcı isteği 27 denemeye dönüşebilir. Retry tek bir katmanda, jitter'lı backoff ile ve yalnız idempotent işlemlerde yapılır. Microservices serisinin "Production'da Microservice: Distributed Tracing, Resilience ve Independent Deployment" yazısında bu katmanları ayrıntılı ele almıştık.
Idempotency key'i her denemede yeniden üretmek. Anahtar mantıksal işlemi temsil eder, denemeyi değil. Döngünün içinde Guid.NewGuid() çağırırsan anahtar hiçbir işe yaramaz.
İptal edilen CancellationToken'ın uzaktaki işi durdurduğunu sanmak. Token yalnız senin beklemeni keser; sunucuya giden istek çoktan yola çıkmıştır.
"Bizde network sorunu olmaz, hepsi aynı data center'da." Aynı rack'teki iki makine arasında bile switch yeniden başlar, NIC (Network Interface Card) sürücüsü takılır, GC duraklaması saniyeler sürer. Network'ün güvenilir olduğu varsayımı genelde ilk ciddi trafikte çöker.
Ne Zaman Dağıtma
Dağıtmamak mümkünse dağıtma. Tek bir güçlü sunucu ve tek bir veritabanı, çoğu iş uygulamasının yükünü yıllarca taşır ve bu yazıdaki sorunların çoğunu (veritabanı bağlantısı hariç) ortadan kaldırır. Bir işi ikinci bir process'e taşımadan önce şunu sor: bu sınır bana scale, fault tolerance ya da bağımsız deployment olarak ne kazandırıyor ve karşılığında her çağrıya hangi belirsizliği ekliyor? Microservices serisinin "Microservice'lerin Bedeli: Ne Zaman Gereksiz, Ne Zaman Kaçınılmaz?" yazısı bu kararı mimari açıdan tartışıyor; bu seri ise karar verildikten sonra karşına çıkacak teoriyi anlatıyor.
Küçük Bir Deneme
★☆☆ Örnekte sağlayıcının gecikmesini 2 saniyeden 900 milisaniyeye indir ve yeniden çalıştır. Tahsilat sayısı ne oluyor? Gecikmeyi 1000 milisaniye yaptığında sonuç her koşuda aynı mı?
★★☆ /v2/charges'a aynı anahtarla farklı bir tutar (Amount = 1.00m) gönder. Sağlayıcı ne dönüyor? Bu davranış neden tehlikeli ve endpoint'i nasıl değiştirirdin?
★★★ Sağlayıcıya bir GET /charges/{orderId} endpoint'i ekle ve retry yerine "timeout olursa önce sorgula, tahsilat yoksa tekrar dene" stratejisini yaz. İki istek arasında sağlayıcı ilk isteği hâlâ işliyorsa bu strateji ne zaman yanlış karar verir?
Bu yazıda belirsizliği bir HTTP çağrısı üzerinden yaşadık. Bir sonraki yazıda aynı belirsizliği resmi bir dille tanımlıyoruz: synchronous ve asynchronous network modelleri, crash-stop, crash-recovery ve Byzantine failure'lar, Two Generals problemi ve exactly-once delivery'nin neden imkânsız olduğu.